LoongCollector を使用して、ECS インスタンスから Nginx ログを Simple Log Service (SLS) に収集します。30 分以内に、ログ収集の設定、SQL によるデータ分析、ダッシュボードの表示、アラートの設定、リソースのクリーンアップを行い、料金の発生を防ぐことができます。

前提条件
SLS の有効化とアカウントの準備
SLS の有効化: 初めてご利用になる場合は、Simple Log Service コンソールにログオンし、画面の指示に従ってサービスを有効化してください。
アカウントの準備:
Alibaba Cloud アカウント: デフォルトですべての権限を持ちます。
RAM ユーザー: RAM ユーザーを使用する場合は、必要な権限ポリシーを付与する必要があります。
AliyunLogFullAccess: プロジェクトや Logstore などの SLS リソースを作成および管理する権限を付与します。AliyunECSFullAccess: ECS インスタンスに収集エージェントをインストールする権限を付与します。AliyunOOSFullAccess: Operation Orchestration Service (OOS) を通じて、ECS インスタンスに収集エージェントを自動的にインストールする権限を付与します。
本番環境では、RAM ユーザーの権限をより細かく制御するために、カスタム権限ポリシーを作成できます。
ECS インスタンスの準備
ECS インスタンスのセキュリティグループで、ポート 80 (HTTP) とポート 443 (HTTPS) のアウトバウンドトラフィックが許可されていることを確認してください。
モックログの生成
ECS インスタンスにログオンします。
generate_nginx_logs.shという名前のスクリプトファイルを作成し、以下の内容を貼り付けます。このスクリプトは、5 秒ごとに標準的な Nginx アクセスログエントリを/var/log/nginx/access.logに書き込みます。実行権限を付与します:
chmod +x generate_nginx_logs.shスクリプトをバックグラウンドで実行します:
nohup ./generate_nginx_logs.sh &
プロジェクトと Logstore の作成
プロジェクトは SLS 内でデータを分離して管理します。Logstore はプロジェクト内のログデータを保持します。
Simple Log Service コンソールにログオンします。
プロジェクトの作成 をクリックします:
リージョン: ログを内部ネットワーク経由で収集するため、ECS インスタンスと同じリージョンを選択します。
プロジェクト名: グローバルに一意の名前を入力します (例:
nginx-quickstart-abc)。
その他の設定はデフォルト設定のままにし、作成 をクリックします。
プロジェクトの作成後、Logstore の作成 をクリックします。
Logstore 名(例:
nginx-access-log) を入力し、その他の設定はデフォルト設定のままにして、OK をクリックします。デフォルトでは、Standard Logstore が作成され、書き込まれたデータ量に基づいて課金されます。
LoongCollector のインストール
Logstore の作成後、確認ダイアログボックスでOK をクリックすると、データのインポート パネルが開きます。
Nginx - テキストログ カードで、今すぐ統合 をクリックします。
[サーバグループ設定]:
[使用シナリオ]: [ホストシナリオ]
[インストール環境]:ECS
マシングループの作成 をクリックします。表示されたパネルで、対象の ECS インスタンスを選択します。
マシングループとしてインストールおよび作成する をクリックします。インストールが成功したら、マシン グループの 名前 に
my-nginx-serverなどを入力して OK をクリックします。説明インストールが失敗するか保留中のままになる場合は、ECS リージョンがプロジェクトリージョンと同じであることを確認してください。
次へ をクリックして、ハートビートステータスチェックに進みます。
初めてマシン グループを作成した際に、ハートビートステータスが FAIL の場合は、自動再試行 をクリックします。ステータスは 約 2 分で OK に変わります。
収集設定の作成
ハートビートステータスが正常になったら、次へ をクリックして Logtail 設定 ページに移動します:
:
nginx-access-log-configなどの設定名を入力します。: 1つ目のボックスに
/var/log/nginx、2つ目のボックスにaccess.logを入力します。[設定の処理]:
[ログサンプル]: ログサンプルの追加 をクリックし、サンプルログを貼り付けます:
192.168.*.* - - [15/Apr/2025:16:40:00 +0800] "GET /nginx-logo.png HTTP/1.1" 0.000 514 200 368 "-" "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.*.* Safari/537.36"[処理モード]: [データ解析 (NGINX モード)] をクリックします。NGINX ログの設定 セクションで、以下の内容をコピーして貼り付け、log_format を設定します。次に、確認 をクリックします。
log_format main '$remote_addr - $remote_user [$time_local] "$request" $request_time $request_length $status $body_bytes_sent "$http_referer" "$http_user_agent"';本番環境では、ここで指定する
log_formatは、Nginx 設定ファイル (通常は/etc/nginx/nginx.conf) の定義と一致する必要があります。ログ解析の例:
生ログ
構造化ログ
192.168.*.* - - [15/Apr/2025:16:40:00 +0800] "GET /nginx-logo.png HTTP/1.1" 0.000 514 200 368 "-" "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.*.* Safari/537.36"body_bytes_sent: 368 http_referer: - http_user_agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.x.x Safari/537.36 remote_addr: 192.168.*.* remote_user: - request_length: 514 request_method: GET request_time: 0.000 request_uri: /nginx-logo.png status: 200 time_local: 15/Apr/2025:16:40:00
次へ をクリックして、クエリと分析の設定 ページに移動します。収集設定が有効になるまで約 1 分かかります。自動更新 をクリックします。プレビューデータは、設定が有効であることを示します。
ログのクエリと分析
終了 をクリックして 終了 ページに移動し、次に ログ照会 をクリックします。ターゲット Logstore のクエリ・分析ページにリダイレクトされます。SQL を使用して、構造化ログからキーメトリックを抽出します。時間範囲を 15分間内 に設定します:
エラーポップアップが表示される場合、インデックスがまだ設定されていません。それを閉じて約 1 分待つと、access.log ファイルからログコンテンツを表示できるようになります。
例 1:ページビュー (PV) の合計
指定された時間範囲内のログエントリの総数をカウントします。
* | SELECT count(*) AS pv例 2:1 分あたりのリクエスト数とエラー率
1 分ごとの総リクエスト数、エラーリクエスト数 (HTTP ステータスコード ≥ 400)、およびエラー率を計算します。
* | SELECT
  date_trunc('minute', __time__) as time,
  count(1) as total_requests,
  count_if(status >= 400) as error_requests,
  round(count_if(status >= 400) * 100.0 / count(1), 2) as error_rate
GROUP BY time
ORDER BY time DESC
LIMIT 100
例 3:リクエストメソッド別の PV (GET、POST など)
1 分単位およびリクエストメソッド (GET、POST など) ごとにページビューをグループ化してカウントします。
* |
SELECT
    date_format(minute, '%m-%d %H:%i') AS time,
    request_method,
    pv
FROM (
    SELECT
        date_trunc('minute', __time__) AS minute,
        request_method,
        count(*) AS pv
    FROM
        log
    GROUP BY
        minute,
        request_method
)
ORDER BY
    minute ASC
LIMIT 10000
ダッシュボードでのデータの可視化
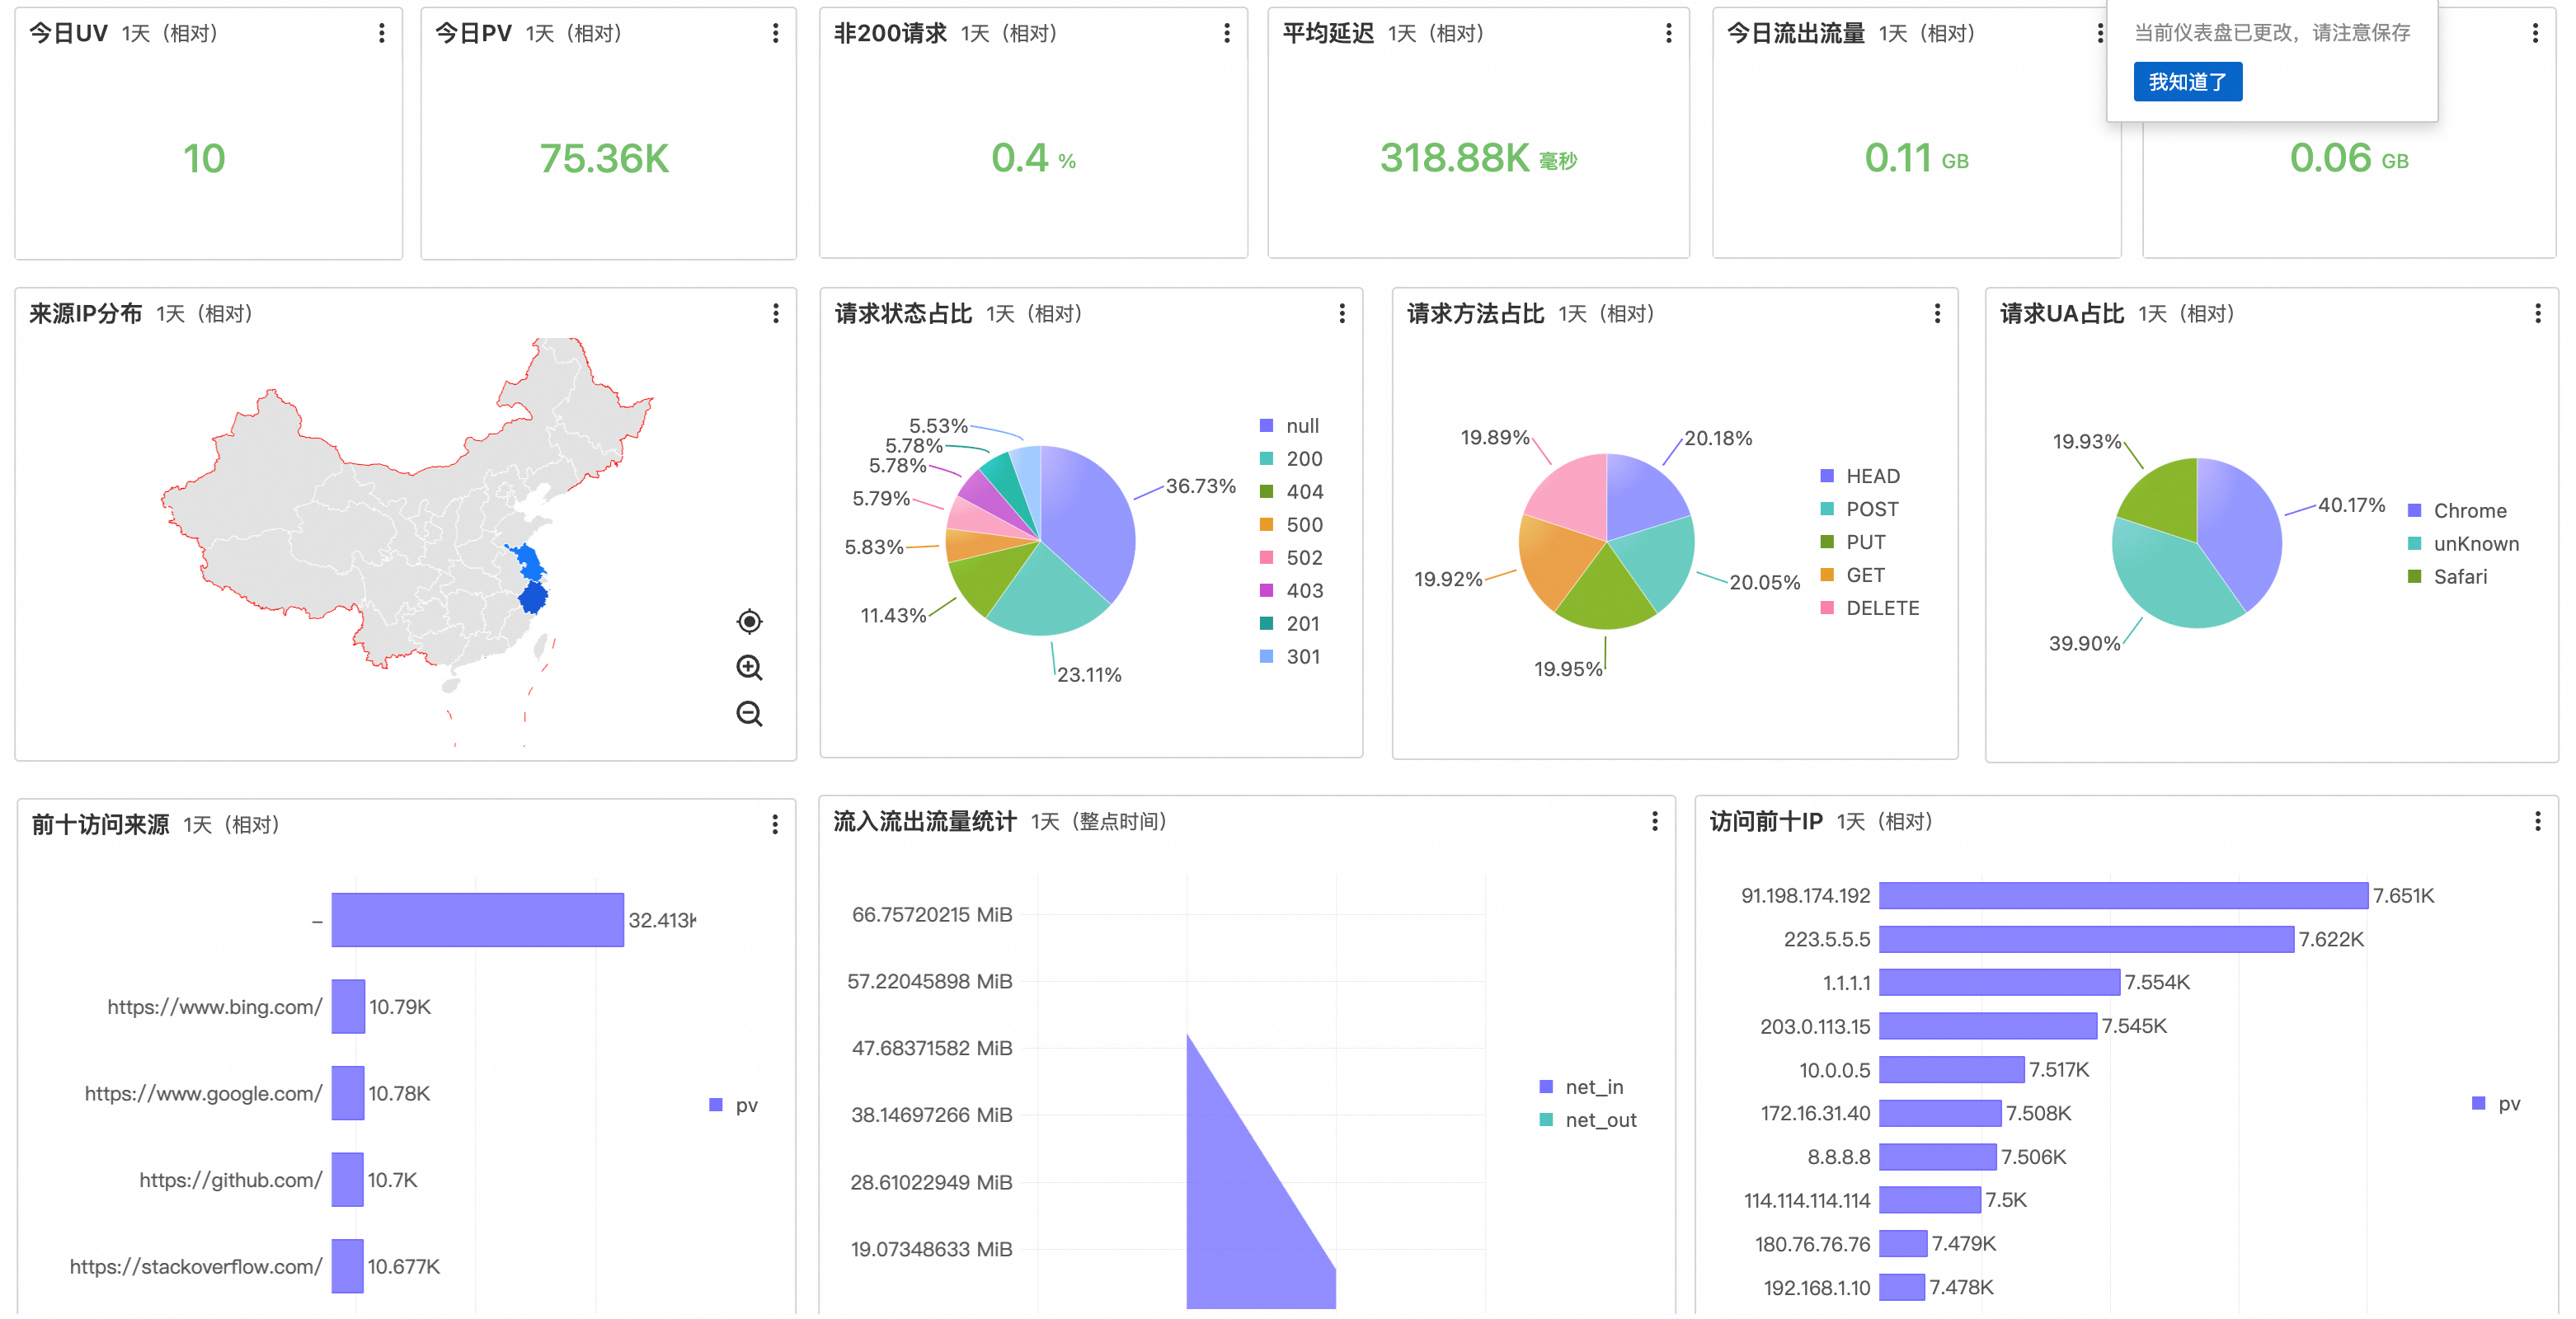
Nginx 解析プロセッサを設定すると、SLS は nginx-access-log_Nginx Access Log という名前のプリセットダッシュボードを自動的に作成します。
左側のナビゲーションペインで、
 を選択します。
ダッシュボード名をクリックして、主要な指標のグラフを表示します:PV、UV、エラー率、リクエストメソッド分布。
ビジネスニーズに基づいて、グラフをカスタマイズできます。
監視とアラートの設定
エラーの急増など、異常な動作が発生したときに通知を受け取るためのアラートルールを作成します。
左側のナビゲーションペインで、
 アラート をクリックします。
アクションポリシーを作成します。
タブで、作成 をクリックします。
ID と 名前 (例:
send-notification-to-admin) を設定します。[プライマリアクションポリシー] で、
 [アクショングループ] をクリックします。
[通知方法] (例: SMS) を選択し、[受信者] を設定して、アラートテンプレート を選択します。
確認 をクリックします。
アラートルールを作成します。
アラームルール タブに切り替えて、アラートの作成 をクリックします。
ルール名: わかりやすい名前を入力します (例:
Too many server 5xx errors)。クエリ統計: 追加 をクリックして、クエリ条件を設定します。
[ログストア]:
nginx-access-logを選択します。[検索期間]:15 分 (相対)。
:
status >= 500 | SELECT *を入力します。プレビュー をクリックしてデータをクエリできることを確認し、次に OK をクリックします。
[トリガー条件]:[特定のエントリ数] が [>100] の場合に、重大 アラートをトリガーするように設定します。
この設定では、15 分以内に 100 件を超える 5xx エラーが発生した場合にアラートがトリガーされます。
: [SLS 通知] を選択し、有効化 します。
アクションポリシー: 前の手順で作成したアクションポリシーを選択します。
[繰り返し間隔]: 繰り返し通知を防ぐため、15 分に設定します。
OK をクリックしてアラートルールを保存します。
検証: トリガー条件が満たされると、設定された通知チャネルにアラートが送信されます。[アラート履歴] ページで、トリガーされたすべてのアラートを表示できます。
リソースのクリーンアップ
このチュートリアルで作成したすべてのリソースをクリーンアップし、継続的な料金の発生を防ぎます。
ログ生成スクリプトの停止
ECS インスタンスにログオンし、次のコマンドを実行してバックグラウンドスクリプトを停止します。
kill $(ps aux | grep '[g]enerate_nginx_logs.sh' | awk '{print $2}')LoongCollector のアンインストール (オプション)
${region_id}をcn-hangzhouに置き換えるか、あるいはパフォーマンスを最適化する場合には${region_id}をお使いの ECS インスタンスの リージョン ID に置き換えます。wget https://aliyun-observability-release-${region_id}.oss-${region_id}.aliyuncs.com/loongcollector/linux64/latest/loongcollector.sh -O loongcollector.sh;アンインストールコマンドを実行します。
chmod +x loongcollector.sh; sudo ./loongcollector.sh uninstall;
プロジェクトの削除
Simple Log Service コンソールのプロジェクトリストページで、作成したプロジェクト (例:
nginx-quickstart-xxx) を見つけます。「操作」列で、削除 をクリックします。
表示されるパネルで、プロジェクト名を入力し、削除の理由を選択します。
OK をクリックします。プロジェクトを削除すると、Logstore、収集設定、ダッシュボード、アラートルールなど、関連するすべてのリソースが削除されます。
警告プロジェクトを削除すると、すべてのログデータと設定が完全に削除されます。この操作は元に戻せません。
Next steps
Now that you have collected, queried, visualized, and monitored logs, explore the following resources to learn more:
Data collection methods: choose the right method for your scenario.
Storage resource hierarchy: plan resource lifecycle and shard allocation.
FAQ
Inconsistent log time after collection
By default, the __time__ field uses the server arrival time. To use the timestamp from the original log, add a time parsing plug-in to the collection configuration.
Charges for creating a project and logstore
Creating a logstore reserves shard resources by default, which may incur active shard lease fees. Why am I charged for active shard lease fees?
Troubleshooting log collection failures
Log collection with Logtail may fail due to abnormal Logtail heartbeats, collection errors, or incorrect Logtail configurations. Troubleshooting Logtail log collection failures.
Failure to analyze logs
Log analysis requires field indexes with the statistics feature enabled. Verify the index configuration of your logstore.
Stopping billing
Simple Log Service cannot be disabled after it is activated. If you no longer want to use the service, you can stop billing by deleting all projects under your account.