このトピックでは、PolarDB for PostgreSQL で PostgreSQL ANN search extension (PASE) プラグインを使用して高次元ベクトル検索を実行する方法について説明します。PASE は、IVFFlat アルゴリズムと Hierarchical Navigable Small World (HNSW) アルゴリズムに基づいています。
背景情報
人工知能 (AI) の主要技術である表現学習は、近年著しく進歩しています。広告配信、顔認識決済、画像認識、音声認識などのアプリケーションで使用されています。これらのアプリケーションでは、データは高次元ベクトルに埋め込まれ、ベクトル検索技術を使用して関連アイテムを検索します。
PASE (PostgreSQL ANN search extension) は、PostgreSQL 向けの高性能なベクトル検索インデックスプラグインです。IVFFlat アルゴリズムや HNSW アルゴリズムなど、成熟し、安定し、効率的な近似最近傍 (ANN) 検索アルゴリズムを使用して、PostgreSQL データベースでの高速なベクトルクエリを可能にします。PASE は現在、特徴ベクトルの抽出と生成をサポートしていません。エンティティの特徴ベクトルを取得する必要があります。PASE は、大規模なデータセット内で類似のベクトルを検索します。
対象読者
このトピックでは、関連用語の定義は行わないため、機械学習、検索、レコメンデーション技術に関する基本的な知識があることを前提としています。
注意事項
インデックスが肥大化することがあります。
select pg_relation_size('index_name');を実行してインデックスのサイズを確認できます。インデックスサイズがデータサイズより大幅に大きく、クエリパフォーマンスが低下した場合は、インデックスを再構築する必要があります。頻繁なデータ更新は、インデックスの精度を低下させる可能性があります。絶対的な精度が必要な場合は、定期的にインデックスを再構築してください。
内部クラスタリング (`clustering_type=1`) を使用する IVFFlat インデックスを使用する場合は、インデックスを作成する前にテーブルにデータを挿入する必要があります。
このトピックの SQL 例を実行するには、特権アカウントを使用してください。
制限事項
クロスノード並列クエリは、高次元ベクトルのシーケンシャル検索のみをサポートします。
PASE アルゴリズム
IVFFlat アルゴリズム
IVFFlat アルゴリズムは、IVFADC アルゴリズムの簡易版です。高い再現率が求められるが、クエリレイテンシー (100 ms レベル) には敏感でないシナリオに適しています。他のアルゴリズムと比較して、IVFFlat アルゴリズムには次の利点があります:
クエリベクトルが候補データセットのメンバーである場合、IVFFlat アルゴリズムは 100% の再現率を達成できます。
アルゴリズムが単純であるため、インデックス構築が高速で、ストレージフットプリントが小さくなります。
簡単なパラメーターを調整することで、重心を指定し、再現率を制御できます。
アルゴリズムのパラメーターは解釈性が高く、アルゴリズムの精度を完全に制御できます。
次の図は、IVFFlat アルゴリズムの仕組みを示しています。
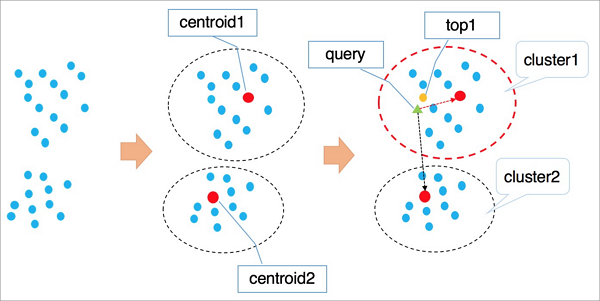
アルゴリズムの仕組みは以下の通りです:
このアルゴリズムは、k-means などのアルゴリズムを使用して、高次元空間のポイントをその暗黙的なプロパティに基づいてクラスターにグループ化します。各クラスターには重心があります。
ベクトルを見つけるために、アルゴリズムはまずすべてのクラスターの重心を反復処理して、ターゲットに最も近い n 個の重心を特定します。
次に、それらのクラスター内のすべての要素を反復処理し、グローバルソートを実行して、最も近い k 個のベクトルを返します。
説明クラスターの重心を検索する際、アルゴリズムは遠いクラスターを自動的に除外してプロセスを高速化します。ただし、これにより、最適な上位 k 個のベクトルすべてがこれらの n 個のクラスター内に含まれる保証がなくなり、精度の低下につながる可能性があります。クラスターの数 (n) を調整することで、IVFFlat アルゴリズムの精度を制御できます。n の値を大きくすると精度は向上しますが、計算ワークロードが増加します。
IVFFlat アルゴリズムと IVFADC アルゴリズムの第 1 段階は同じです。主な違いは、計算の第 2 段階にあります。IVFADC はプロダクト量子化を使用して徹底的な検索を回避しますが、これにより精度の低下が発生します。対照的に、IVFFlat アルゴリズムは、計算量を管理しやすく保ちながら、精度の低下を避けるために力まかせ探索を実行します。
HNSW アルゴリズム
Hierarchical Navigable Small World (HNSW) アルゴリズムは、非常に大規模なベクトルデータセット (数千万以上) で、厳しいクエリレイテンシー要件 (10 ms レベル) があるシナリオに適しています。
HNSW は、グラフ上を高速に反復することで、最近傍の可能性が高いものを見つける近接グラフベースのアルゴリズムです。大規模なデータセットでは、HNSW アルゴリズムのパフォーマンス向上は他のアルゴリズムよりも顕著です。ただし、近傍ポイントを格納すると追加のストレージ容量を消費し、パラメーターを調整するだけでは特定のポイントを超えて再現率を向上させることが困難になる場合があります。
次の図は、HNSW アルゴリズムの仕組みを示しています。
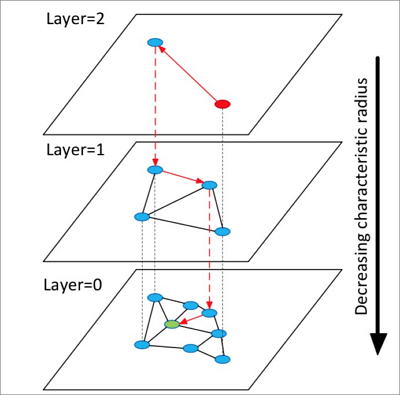
アルゴリズムの仕組みは以下の通りです:
多層グラフを構築します。各レイヤーは下のレイヤーの要約であり、高速道路のように下のレイヤーに対するスキップリストを形成します。
最上位レイヤーのポイントをランダムに選択して検索を開始します。
その近傍を検索し、ターゲットまでの距離でソートされた固定長の動的リストに格納します。後続の各検索ステップで、リストからポイントを取得し、その近傍を探索し、新しく見つかった近傍をリストに挿入します。挿入のたびに再ソートがトリガーされ、上位 k 個のポイントのみが保持されます。リストが変更された場合、収束するまで反復を続けます。その後、リストの最初のポイントを次のレイヤーのエントリーポイントとして使用し、下に移動します。
最下層に到達するまでステップ 3 を繰り返します。
説明HNSW アルゴリズムは、単層の Navigable Small World (NSW) グラフを多層グラフに拡張し、グラフ上で最近傍検索を実行します。これにより、クラスタリングベースのアルゴリズムよりも高いクエリ高速化率を達成できます。
どちらのアルゴリズムも特定のビジネスシナリオに適しています。たとえば、IVFFlat アルゴリズムは高精度の画像比較に最適であり、HNSW アルゴリズムは検索およびレコメンデーションシステムにおける再現率に適しています。将来的には、さらに多くの業界をリードするアルゴリズムが PASE に統合される予定です。
PASE の使用
PASE プラグインを作成します。次のコマンドを実行します:
CREATE EXTENSION pase;次の 2 つのメソッドのいずれかを使用して、ベクトル類似度を計算できます:
PASE データ型コンストラクターを使用する
例
SELECT ARRAY[2, 1, 1]::float4[] <?> pase(ARRAY[3, 1, 1]::float4[]) AS distance; SELECT ARRAY[2, 1, 1]::float4[] <?> pase(ARRAY[3, 1, 1]::float4[], 0) AS distance; SELECT ARRAY[2, 1, 1]::float4[] <?> pase(ARRAY[3, 1, 1]::float4[], 0, 1) AS distance;説明<?>演算子は、2 つのベクトルの類似度を計算します。左のベクトルはfloat4[]データ型、右のベクトルはpaseデータ型である必要があります。pase型はプラグイン内で定義されたデータ型で、最大 3 つのコンストラクターを持つことができます。3 番目の例のfloat4[], 0, 1部分は説明用です。最初のパラメーターはfloat4[]で、右のベクトルのデータ型を表します。2 番目のパラメーターはこのコンテキストでは特別な機能はなく、0 に設定できます。3 番目のパラメーターは類似度計算メソッドを示します。値 0 はユークリッド距離を示し、値 1 はドット積 (内積) を示します。左と右のベクトルのディメンションが異なる場合、計算は失敗します。
文字列コンストラクターを使用する
例
SELECT ARRAY[2, 1, 1]::float4[] <?> '3,1,1'::pase AS distance; SELECT ARRAY[2, 1, 1]::float4[] <?> '3,1,1:0'::pase AS distance; SELECT ARRAY[2, 1, 1]::float4[] <?> '3,1,1:0:1'::pase AS distance;説明文字列構築メソッドと PASE データ型構築メソッドは、どちらも 2 つのベクトルの類似度を計算するために使用されます。文字列構築メソッドでは、区切り文字としてコロン (:) を使用します。3 番目の例の
3,1,1:0:1部分は次のように説明されます:最初のパラメーターは右のベクトルを表します。2 番目のパラメーターはこのコンテキストでは特別な機能はなく、0 に設定できます。3 番目のパラメーターは類似度計算メソッドを指定し、0 はユークリッド距離、1 はドット積 (内積) を示します。
インデックスを作成します。次の 2 つのアルゴリズムのいずれかを使用してインデックスを作成できます:
説明PASE ベクトルインデックスを使用する場合、類似度メトリックとしてユークリッド距離を使用する際には、元のベクトルの前処理は必要ありません。ただし、類似度メトリックとしてドット積 (内積) またはコサインを使用する場合は、ベクトルを正規化する必要があります。元のベクトルが
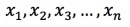 の場合、
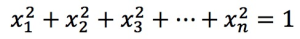 の条件を満たす必要があります。この場合、ドット積とコサイン値は同じになります。
IVFFlat アルゴリズムを使用してインデックスを作成する
例
CREATE INDEX ivfflat_idx ON vectors_table
USING
  pase_ivfflat(vector)
WITH
  (clustering_type = 1, distance_type = 0, dimension = 256, base64_encoded = 0, clustering_params = "10,100");
次の表にパラメーターを説明します。
パラメーター
説明
clustering_type
IVFFlat アルゴリズムがベクトルデータに対して実行するクラスタリング操作のタイプ。このパラメーターは必須です。有効値:
0:外部クラスタリング。clustering_params パラメーターで指定された、外部から提供された重心ファイルをロードします。1:内部クラスタリング。インデックス構築プロセス中に、K-Means アルゴリズムを使用して内部クラスタリング操作が実行されます。これは clustering_params パラメーターによって制御されます。
新規ユーザーには内部クラスタリングを推奨します。
distance_type
類似度計算メソッド。デフォルト値は
0です。有効値:0:ユークリッド距離。1:ドット積 (内積)。このメソッドにはベクトル正規化が必要です。この場合、ドット積 (内積) の値の順序は、ユークリッド距離の値の順序とは逆になります。
現在、ユークリッド距離のみが直接サポートされています。ドット積 (内積) を使用するには、ベクトルを正規化し、付録で説明されているメソッドを使用する必要があります。
dimension
ベクトルディメンション。このパラメーターは必須です。最大値は 512 です。
base64_encoded
データが Base64 エンコーディングを使用しているかどうかを指定します。デフォルト値は
0です。有効値:0:ベクトル型はfloat4[]で表されます。1:ベクトル型はfloat[]の Base64 エンコードされた文字列で表されます。
clustering_params
外部クラスタリングの場合、このパラメーターは重心ファイルのパスを指定します。内部クラスタリングの場合、このパラメーターは
clustering_sample_ratio,kの形式でクラスタリングパラメーターを指定します。このパラメーターは必須です。clustering_sample_ratio:クラスタリングのサンプリング率で、分母は 1000 です。値は (0, 1000] の範囲の整数である必要があります。たとえば、値1は、テーブルデータの 1/1,000 のサンプルに対して k-means クラスタリングが実行されることを意味します。値を大きくするとクエリの精度が向上しますが、インデックスの作成時間が長くなります。サンプリングされたデータの合計量が 100,000 行を超えないようにすることを推奨します。k:重心の数。値を大きくするとクエリの精度が向上しますが、インデックスの作成時間が長くなります。[100, 1000] の範囲の値を指定することを推奨します。
HNSW アルゴリズムを使用してインデックスを作成する
例
CREATE INDEX hnsw_idx ON vectors_table
USING
  pase_hnsw(vector)
WITH
  (dim = 256, base_nb_num = 16, ef_build = 40, ef_search = 200, base64_encoded = 0);
次の表にパラメーターを説明します。
パラメーター
説明
dim
ベクトルディメンション。このパラメーターは必須です。最大値は 512 です。
base_nb_num
グラフ内の各ノードの近傍数。このパラメーターは必須です。値を大きくするとクエリの精度が向上しますが、インデックスの構築時間とインデックスサイズが増加します。[16, 128] の範囲の値を推奨します。
ef_build
インデックス作成時に使用されるヒープ長。このパラメーターは必須です。値を大きくすると結果が向上しますが、作成プロセスが遅くなります。[40, 400] の範囲の値を推奨します。
ef_search
検索時のデフォルトのヒープ長。このパラメーターは必須です。値を大きくすると結果が向上しますが、クエリパフォーマンスが低下します。この値はクエリ時に指定できます。ここでのデフォルト値は 200 です。
base64_encoded
データが Base64 エンコーディングを使用しているかどうかを指定します。デフォルト値は
0です。有効値:0:ベクトル型はfloat4[]で表されます。1:ベクトル型はfloat[]の Base64 エンコードされた文字列で表されます。
クエリを実行します。次の 2 種類のインデックスのいずれかを使用してクエリを実行できます:
IVFFlat インデックスを使用したクエリ
例
SELECT id, vector <#> '1,1,1'::pase as distance FROM vectors_ivfflat ORDER BY vector <#> '1,1,1:10:0'::pase ASC LIMIT 10;説明<#>は IVFFlat アルゴリズムインデックスの演算子です。ORDER BY句はベクトルインデックスをアクティブにします。昇順ソート (ASC) のみがサポートされています。PASE データ型は、コロン (:) で区切られた 3 つの部分からなる形式です。例の
1,1,1:10:0では、最初の部分はクエリベクトルです。2 番目の部分は IVFFlat のクエリパラメーターで、値の範囲は (0, 1000] です。値を大きくするとクエリの精度は高くなりますが、クエリのパフォーマンスは低下します。実際のデータに基づいてこのパラメーターを調整することを推奨します。3 番目の部分はクエリの類似度計算メソッドを指定します:0 はユークリッド距離、1 はドット積 (内積) を示します。ドット積 (内積) メソッドを使用する場合は、ベクトル正規化が必要です。この場合、ドット積 (内積) の値の順序は、ユークリッド距離の値の順序とは逆になります。
HNSW インデックスを使用したクエリ
例
SELECT id, vector <?> '1,1,1'::pase as distance FROM vectors_ivfflat ORDER BY vector <?> '1,1,1:100:0'::pase ASC LIMIT 10;説明<?>は HNSW アルゴリズムインデックスの演算子です。ORDER BY句はベクトルインデックスをアクティブにします。昇順ソート (ASC) のみがサポートされています。PASE データ型は、各部分がコロン (:) で区切られた 3 つの部分からなる形式です。以下の説明では、例として
1,1,1:10:0を使用します。最初の部分はクエリベクトルです。2 番目の部分は HNSW 検索パラメーターで、値の範囲は (0, ∞) です。値を大きくするとクエリの精度が向上しますが、クエリのパフォーマンスは低下します。実際のデータに基づいてこのパラメーターを調整する必要があります。推奨される初期値は 40 です。3 番目の部分は類似度計算メソッドを指定し、0 はユークリッド距離、1 はドット積 (内積) を示します。ドット積 (内積) を使用する場合は、ベクトル正規化が必要です。この場合、ドット積 (内積) の値の順序は、ユークリッド距離の値の順序とは逆になります。
付録
ドット積 (内積) 計算の例
この例では、HNSW アルゴリズムインデックスを使用します。以下は
FUNCTIONを作成する例です:CREATE OR REPLACE FUNCTION inner_product_search(query_vector text, ef integer, k integer, table_name text) RETURNS TABLE (id integer, uid text, distance float4) AS $$ BEGIN RETURN QUERY EXECUTE format(' select a.id, a.vector <?> pase(ARRAY[%s], %s, 1) AS distance from (SELECT id, vector FROM %s ORDER BY vector <?> pase(ARRAY[%s], %s, 0) ASC LIMIT %s) a ORDER BY distance DESC;', query_vector, ef, table_name, query_vector, ef, k); END $$ LANGUAGE plpgsql;説明正規化されたベクトルでは、ドット積はコサイン値と等しくなります。したがって、上記の方法を使用してコサイン類似度も計算できます。
IVFFlat インデックス用のカスタム重心ファイル
これは高度な機能であり、重心ファイルを指定されたサーバーパスにアップロードし、そのパスをインデックスパラメーターとして提供する必要があります。パラメーターの詳細な説明については、「IVFFlat インデックスのパラメーター」をご参照ください。ファイル形式は次のとおりです:
dimension|number_of_centroids|set_of_centroid_vectors例
3|2|1,1,1,2,2,2
参考文献
Product Quantization for Nearest Neighbor Search
Hervé Jégou, Matthijs Douze, and Cordelia Schmid, "Product Quantization for Nearest Neighbor Search."
Yu. A. Malkov and D. A. Yashunin, "Efficient and Robust Approximate Nearest Neighbor Search Using Hierarchical Navigable Small World Graphs."