PolarDB for MySQL は、インメモリー列指向インデックス (IMCI) に基づくネイティブのカラムストア全文検索を提供します。既存のテーブルに直接全文検索インデックスを作成し、MATCH 関数と最適化された LIKE 高速化機能により、ミリ秒レベルのあいまい検索を実現できます。Elasticsearch などの外部検索エンジンソリューションと比較して、IMCI はデータとインデックス間のトランザクションの一貫性を確保し、データ同期のレイテンシーを回避し、アーキテクチャ全体の複雑さを軽減します。
主な概念
PolarDB IMCI の全文検索を理解するには、次の主要な概念を理解する必要があります:
|
概念 |
説明 |
|
ドキュメント |
インデックス化される未加工データの単位です。PolarDB IMCI では、ドキュメントは列ストア内のデータ行を指します。 |
|
ターム |
トークナイザーによる処理の後、ドキュメントから抽出される基本的な言語単位です。インデックス作成およびクエリの最小単位です。 |
|
トークナイザー |
未加工のテキストをタームのシーケンスに分割するコンポーネントです。PolarDB IMCI は、さまざまな言語やビジネスシナリオに合わせて、複数のトークナイザー ( |
|
転置インデックス |
全文検索の中核となるデータ構造であり、各タームと、それを含むドキュメントのリストとの対応関係を記録します。ターム辞書とポスティングリストで構成され、テキストクエリを高速化します。 |
|
ターム辞書 |
すべてのタームの集合を格納し、高速な検索を可能にします。PolarDB IMCI は、FST (Finite State Transducer) アルゴリズムを使用して辞書を構築します。クエリの時間計算量は O(len(term)) で、領域使用量が少ない点が特長です。 |
|
ポスティングリスト |
特定のタームを含むすべてのドキュメント ID (IMCI における 64 ビットの行番号) のリストを記録します。PolarDB IMCI は、RBM (Roaring Bitmap) アルゴリズムを使用してポスティングリストを圧縮・計算します。疎なデータと密なデータのどちらのシナリオでも高い性能を発揮します。 |
次の表では、組み込みの PolarDB IMCI ソリューションと、外部の「database + Elasticsearch」ソリューションを比較します:
|
比較軸 |
PolarDB IMCI 全文検索 |
「Database + Elasticsearch」ソリューション |
|
データ整合性 |
強い整合性。インデックス更新とデータ書き込みは同一トランザクション内で完了し、ACID 原則に従います。そのため、データの遅延や不整合のリスクはありません。 |
結果整合性。データベースから Elasticsearch へデータを同期する必要があり、同期のレイテンシーが発生します。データの鮮度とトランザクションの原子性は保証できません。 |
|
アーキテクチャの複雑さ |
シンプル。この機能はデータベースに組み込まれています。新しいコンポーネントは不要で、アーキテクチャをシンプルに保てます。 |
複雑。別途 Elasticsearch クラスターとデータ同期パイプラインをデプロイして維持する必要があり、システムの異種性が増します。 |
|
クエリ方法 |
統一。構造化データと非構造化データのいずれも、標準 SQL でクエリできます。 |
分断。クエリには SQL と Elasticsearch DSL の両方を使用する必要があります。その結果、まず Elasticsearch にクエリしてからデータベースにクエリする 2 段階クエリになりやすく、レイテンシーとコードの複雑さが増します。 |
|
O&M コスト |
低い。PolarDB の O&M および高可用性の仕組みを再利用できます。専門の O&M スキルや追加のサーバーリソースは不要です。 |
高い。専用のサーバーリソースと、Elasticsearch の専門的な O&M 能力が必要です。また、データを 2 重に保存するため、ストレージコストも増加します。 |
仕組み
PolarDB のインメモリー列指向インデックス (IMCI) の全文検索は、転置インデックス技術を基盤としています。非構造化テキストデータを構造化されたインデックスに変換することで、キーワードクエリのパフォーマンスを大幅に向上させます。中核となるプロセスを次の図に示します:
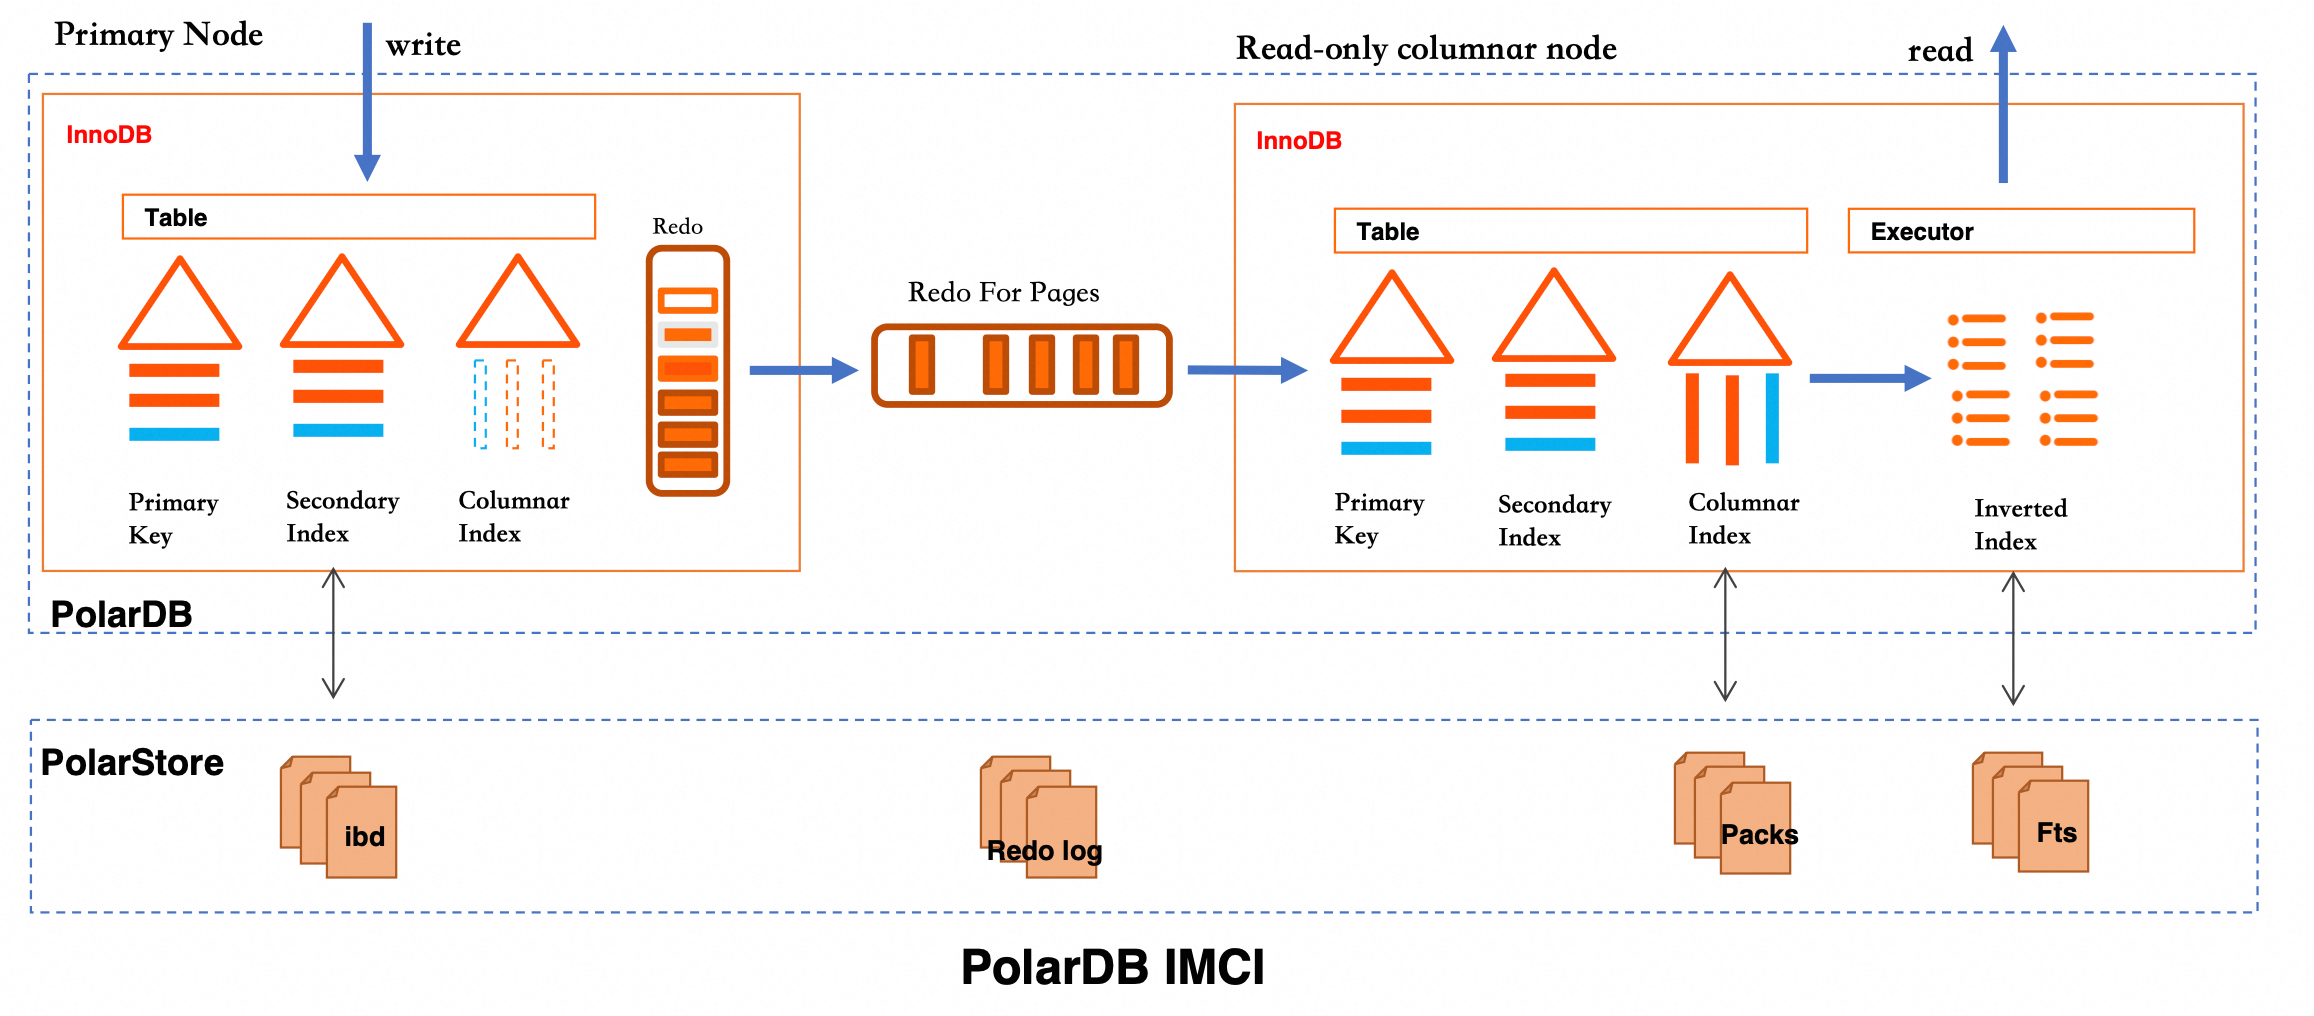
データが書き込まれると、InnoDB テーブルの内容は列ストアインデックスを通じて PolarStore の Pack ファイルに同期されます。クエリフェーズでは、Executor が列ストアデータ上に転置インデックスを構築し、Fts ファイルを使用して全文マッチングを効率的に完了します。このアーキテクチャにより、行ストアと列ストアが連携して動作し、書き込みパフォーマンスと複雑なクエリ能力のバランスを取ることができます。
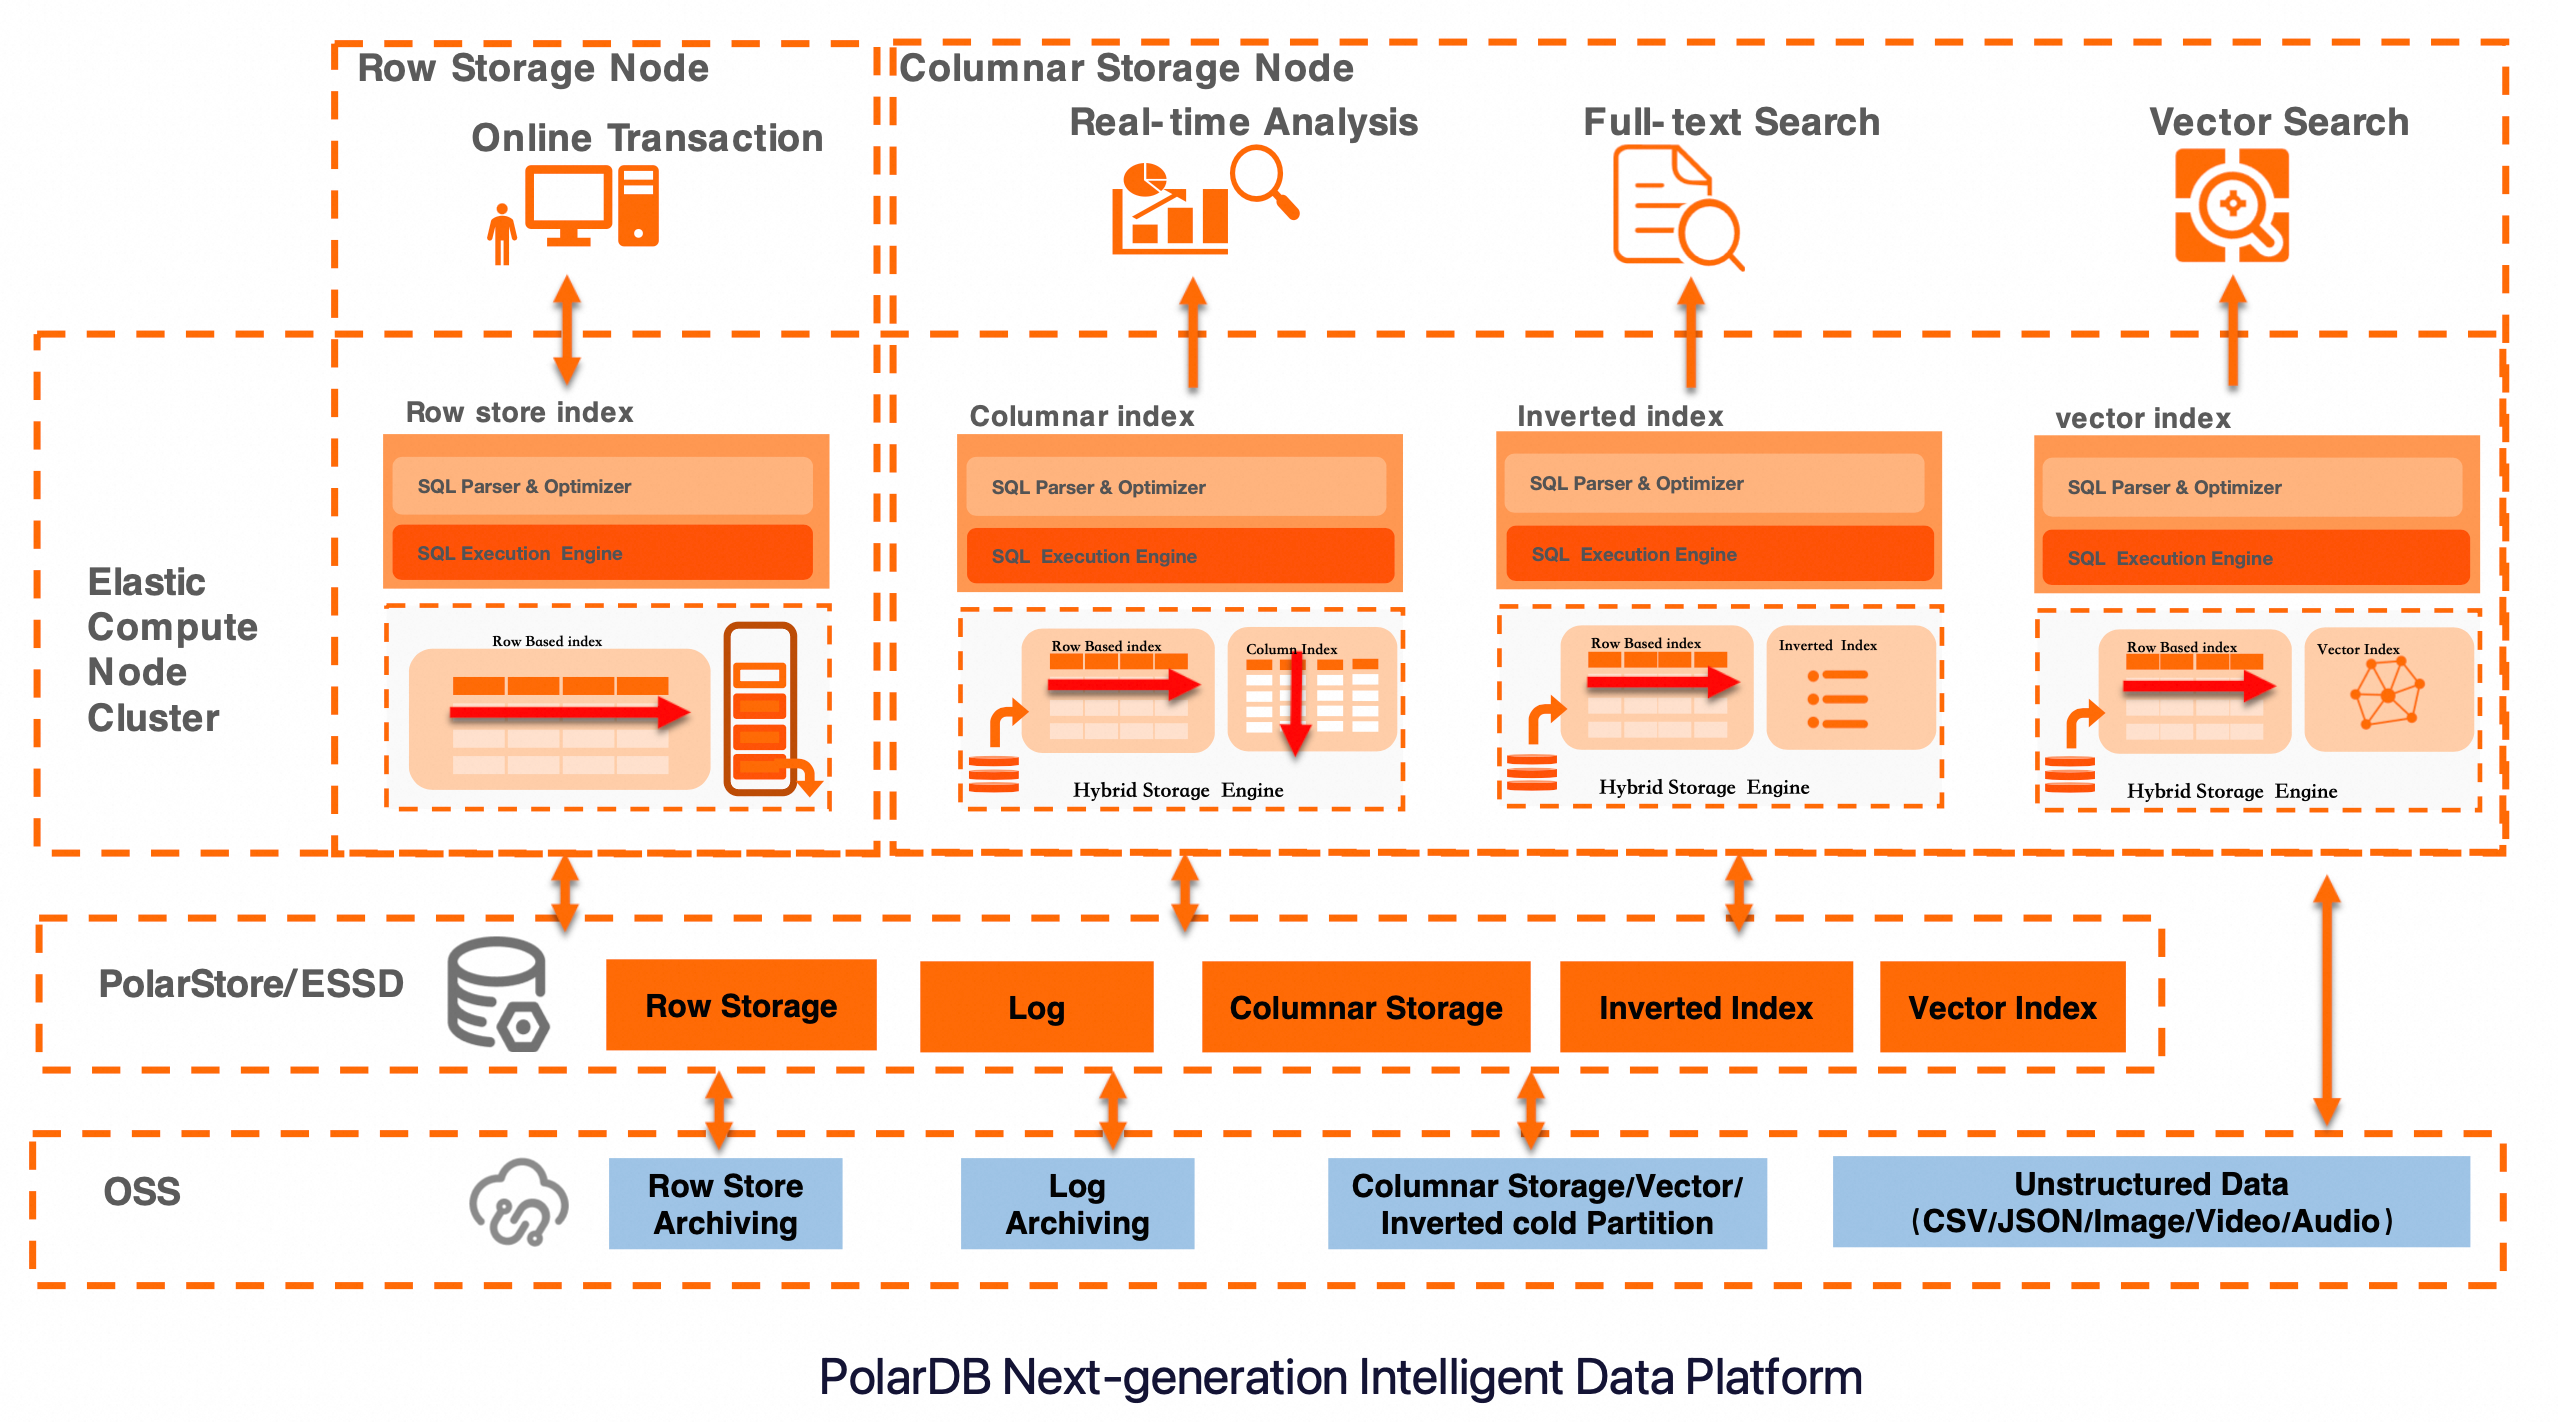
PolarDB のインメモリー列指向インデックスは、複数のクエリモードをサポートする統合ハイブリッドストレージアーキテクチャを採用しています。図に示すように、全文検索はハイブリッドストレージエンジンに依存して転置インデックスを構築・維持し、効率的なテキスト検索を実現します。また、弾性コンピューティングノードと階層化ストレージを組み合わせることで、高スループットの書き込みと低レイテンシーのクエリを両立させます。これを基盤に、組み込みのベクトルインデックス機能が、テキストとベクトルの組み合わせによるマルチモーダル検索をさらにサポートします。このアーキテクチャは、E コマースの商品検索、ログ分析、ナレッジベース検索などのシナリオに適用でき、OLTP、リアルタイム分析、全文検索、ベクトル検索を統合したワンストップのデータサービスプラットフォームをユーザーに提供します。
トークナイザー
トークン化はテキストをタームに分割するプロセスであり、全文検索の基盤です。適切なトークナイザーを選択することは、検索の精度とパフォーマンスにとって極めて重要です。インメモリー列指向インデックスは以下のトークナイザーをサポートしています:
|
トークナイザー |
説明 |
|
token |
スペースや句読点などの非英数字でテキストを分割します。スペースを区切り文字として使用する英語やその他の言語に適しています。 |
|
ngram |
テキストを、あらかじめ設定された文字数 (n) の連続したタームに分割します。 |
|
jieba |
|
|
ik |
Elasticsearch などの検索エンジンで一般的に使用されている、もう一つの広く使われている中国語トークン化ツールである |
|
json |
JSONPath 式を使用して、JSON オブジェクトから特定のキー値や配列要素をタームとして抽出します。JSON データに対する詳細な検索に使用されます。 |
さらに、PolarDB のインメモリー列指向インデックスはトークン化の結果をテストするためのユーティリティ関数 dbms_imci.fts_tokenize を提供します。この関数は、すべてのトークナイザーとそれに対応するプロパティをサポートします。トークン化の結果が異なると、全文検索インデックスのクエリ結果が期待と異なる場合や、MATCH と LIKE が矛盾した結果を返す場合があります。このような場合、このトークン化ユーティリティ関数を使用してトークン化の結果を検証できます。
ポスティングリスト
直感的に言えば、ポスティングリストはドキュメント ID の集合です。その主要な技術的ポイントは、高効率な圧縮ストレージと高性能な計算 (積集合など) にあります。
PolarDB のインメモリー列指向インデックスの全文検索インデックスでは、ポスティングリストは特定のタームを含むすべての列ストアインデックス行の行番号の集合を、対応するターム頻度 (オプション) およびドキュメント頻度 (オプション) と共に格納します。各タームは 1 つのポスティングリストに対応します。
インメモリー列指向インデックスは、RBM (Roaring Bitmaps) アルゴリズムを使用してポスティングリスト (つまり、ドキュメント ID のセット) を圧縮および計算します。
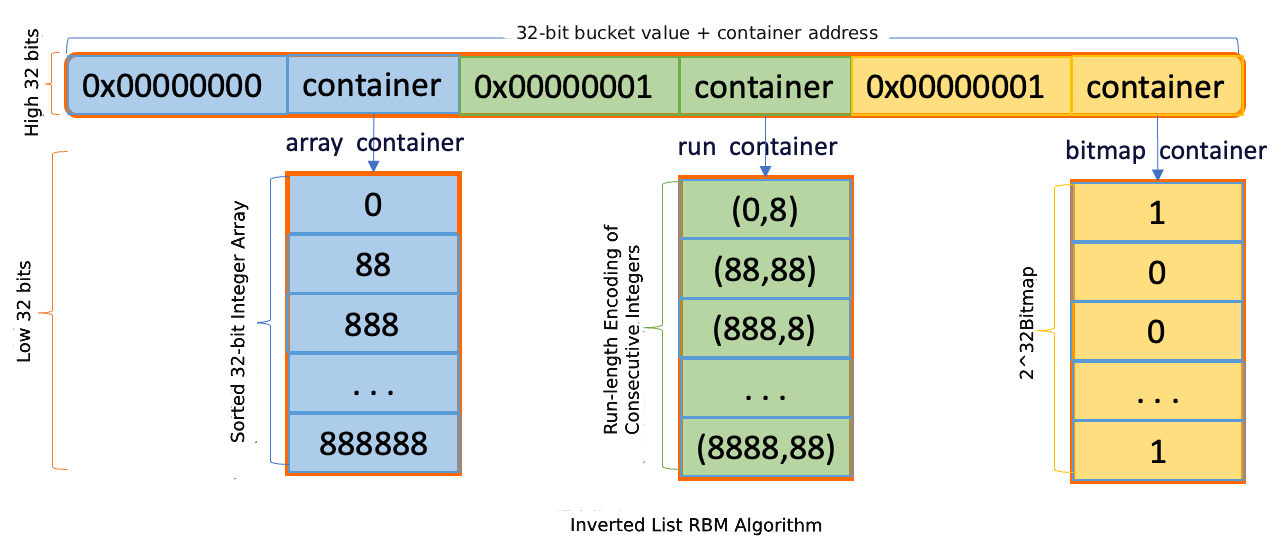
RBM の実装は CRoaring ライブラリに基づいており、データ密度に応じてストレージ戦略を動的に選択します:
-
ポスティングリスト内のドキュメント ID の数が所定のしきい値より小さい場合、ストレージには
std::arrayが使用されます。 -
数がしきい値を超えると、ストレージは
roaring::Roaring64Map型に切り替わり、高い圧縮率を維持しながら大規模なスパースまたは密なデータを処理します。
パフォーマンス特性:
-
インデックス構築中に O(logN) の計算量での検索をサポートします。
-
積集合や和集合などの集合演算に対する SIMD 命令アクセラレーションをサポートします。
-
データがディスクに書き込まれる際の領域再編成をサポートし、断片化を削減します。
-
クエリ中の高速フィルタリングとイテレータ最適化のために、
minimum/maximum値の使用をサポートします。
ターム辞書
転置インデックスの中核的なアイデアは、辞書を使用してタームに対応するポスティングリストを高速に見つけることです。そのため、タームからポスティングリストへの辞書の設計は特に重要です。一般的な設計には、トライ木、B+ 木、FST などがあります。
インメモリー列指向インデックスは、時間効率と空間効率のバランスを取るために、有限状態トランスデューサー (FST) アルゴリズムを使用してターム辞書を構築します。
-
空間効率:タームの共通のプレフィックスとサフィックスを共有することで、ストレージ領域を効果的に圧縮します。
-
時間効率:ターム検索の時間計算量は O(L) です。ここで L はタームの長さです。
たとえば、ターム China、Chinese、love がこの順序で挿入され、それらのポスティングリストのアドレスオフセットが 5、10、15 であると仮定します。構築される辞書は次の図のようになります。この図は、FST が共通のプレフィックスとサフィックスを共有して領域を節約するだけでなく、各遷移に一意の関連値が保証されることを示しています。クエリは初期状態 0 から始まり、タームの各文字について、その文字の出力エッジがあるかを確認します。エッジが存在する場合、クエリは関連値を累積します。そうでない場合、クエリは現在の状態が最終状態であるかを確認します。たとえば、Chinese は 15 の関連値を累積し、その最後の文字が最終状態であるため、そのタームは辞書に存在することがわかります。さらに、FST のプレフィックス計算は文字ベースではなくバイトベースであるため、UTF-8 などのエンコーディングもサポートします。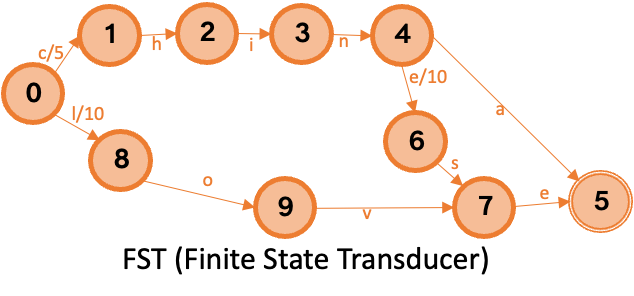
転置インデックスの構築
PolarDB のインメモリー列指向インデックスは、SPIMI アルゴリズムを使用して転置インデックスを構築します。単一のスキャン、トークン化、および辞書とポスティングリストのバッチ生成により、制御されたメモリ使用量で効率的なローカルインデックス構築をサポートします。
PolarDB のインメモリー列指向インデックスの全文検索インデックスが SPIMI で構築される際、インメモリー列指向インデックスはターゲット列の列ストアデータを継続的に読み取り、各行をトークン化してタームのセットを取得し、各タームとそれに対応する行番号をハッシュテーブルに追加しながらメモリ使用量を累積します。メモリ使用量がセグメントサイズのしきい値を超えると、インメモリー列指向インデックスはハッシュテーブル内のタームとポスティングリストから辞書を構築し、メモリをリセットして、すべての列ストアデータが処理されるまで次の行の処理に進みます。ハッシュテーブル (std::unordered_map) から辞書 (FST) を構築する主なプロセスは次のとおりです:まず、ハッシュテーブルをターム (キー) でソートします。次に、ハッシュテーブル内のすべてのポスティングリストを順にディスクにシリアライズし、ディスク上の相対オフセットアドレスを記録します。その後、各タームとそのタームのポスティングリストのオフセットアドレスを FST アルゴリズムに順に追加して辞書を構築します。最後に、辞書を圧縮してディスクに書き込み、現在のセグメント情報 (辞書サイズ、辞書開始アドレス、ポスティングリスト開始アドレス、行番号範囲など) をメタデータに記録します。PolarDB は、外部ソートを避けるためにグローバル辞書を構築しません (グローバル辞書は、その上にタームインデックスを構築するためにプレフィックスで分割する必要もあります)。代わりに、列ストアストレージは追記専用の書き込みモデルを使用するため、PolarDB はメモリしきい値に基づいて複数のローカル辞書を生成する軽量な構築方法を使用します。次の図にその例を示します。メモリが十分な場合は、メモリしきい値をできるだけ大きくします。これにより、同じタームのより多くのインスタンスが同じ転置セグメントに格納されることで、領域を節約し、クエリパフォーマンスを向上させることができます。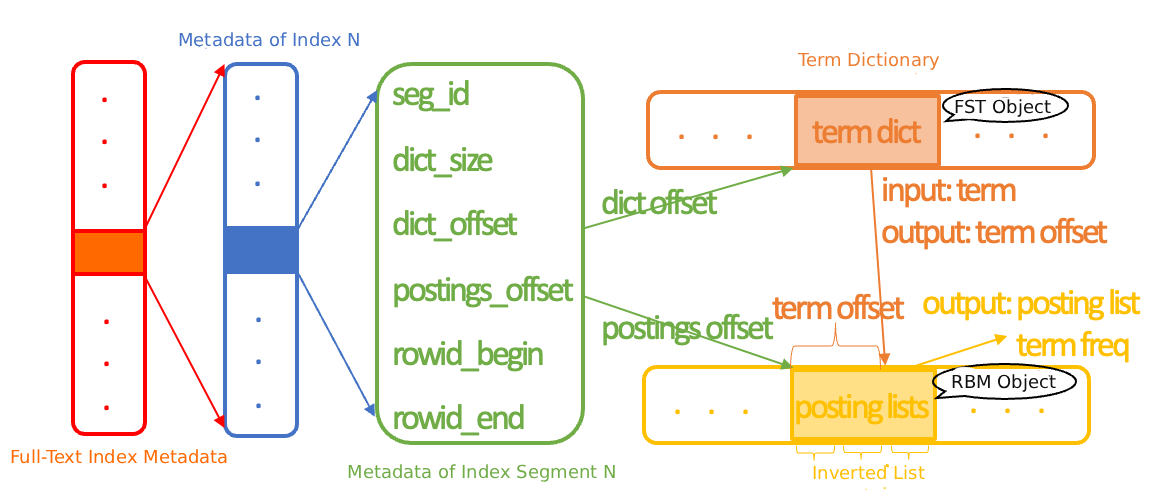
上記の通常の転置インデックス構築に加えて、PolarDB のインメモリー列指向インデックスの全文検索インデックスは、システムがバックグラウンドでアイドル状態のときに転置インデックスを非同期でマージすることもサポートします。PolarDB のインメモリー列指向インデックスの列ストアインデックスは、通常テーブルのセカンダリインデックスです。INSERT の際、データは常に挿入順に列ストアストレージエンジンに列ごとに追記されます。DELETE は削除マークを使用し、UPDATE は DELETE と INSERT に変換されます。インメモリー列指向インデックスは、配列 InsertMask を使用して可視性チェックのために列ストアデータ内の各行の挿入バージョンをマークし、lsm DeleteMask を使用して既存の行を削除済みとしてマークします。同時に、非同期の Compaction や Recycle などのバックグラウンド操作がデータを再編成し、領域を再利用します。列ストアエンジンの一部として、PolarDB のインメモリー列指向インデックスの全文検索インデックスも、バックグラウンドの非同期転置インデックス Compaction タスクを使用して、削除マークが付けられたデータを定期的にクリーンアップし、領域を節約し、クエリパフォーマンスを向上させます。転置インデックスのマージは、転置セグメントを単位として行われます。複数の転置セグメントが新しい転置セグメントにマージされ、元の転置セグメントは変更されません。これにより、クエリが使用する転置インデックスのスナップショットオブジェクトが無効になるのを防ぎます。マージが完了すると、新しい転置インデックススナップショットが生成され、新しいクエリは新しいスナップショットを使用します。ローカル構築方法と削除マークの設計により、PolarDB のインメモリー列指向インデックスの全文検索インデックスでは、一括挿入がグローバルな再構築をトリガーすることはなく、増分部分のみが構築されます。更新コストも、削除マークを付けるだけで済むため非常に低く、頻繁な更新シナリオでも書き込みパフォーマンスに影響を与えません。さらに、定期的なバックグラウンドの非同期マージにより、よりコンパクトな転置インデックスが生成され、クエリパフォーマンスが向上します。列ストアの同時クエリ機能と組み合わせることで、この仕組みは巨大なデータシナリオでもミリ秒レベルの応答要件を満たします。
転置インデックスの検索
PolarDB のインメモリー列指向インデックスの全文検索インデックスは、MySQL 公式の MATCH 関数と LIKE 演算子をサポートしています。
-
MATCH関数PolarDB のインメモリー列指向インデックスは、行ストアに全文検索インデックスが存在するかどうかにかかわらず、
MATCH関数を使用した全文検索をサポートします。行ストアインデックスが存在しない場合、クエリは直接列ストアノードにルーティングされます。行ストアインデックスが存在する場合、クエリはコスト評価に基づいてインテリジェントに分散されます。ネイティブの MySQL 全文検索インデックスが最適化フェーズでトリガーする補助テーブルの同期やキャッシュの読み込みなどの時間のかかる操作が列ストアのパフォーマンスに影響を与えないようにするため、PolarDB はクエリ分散の開始時にこれらの操作をスキップします。実行フェーズでは、インメモリー列指向インデックスは 2 つの検索方法を提供します:
FtsTableScan演算子とMATCH式です。前者は転置インデックスから直接一致する行を取得し、高いフィルター率のシナリオに適しています。後者は行番号でインデックスを検索し、先行する条件によってすでにほとんどのデータがフィルタリングされているシナリオに適しています。両方の方法の実行効率は、他の述語がデータをどれだけうまくフィルタリングするかに依存します。したがって、列ストアオプティマイザは統計からフィルター率を推定し、最適な戦略を動的に選択します。演算子方式が選択されると、システムは自動的にMATCH関数をFtsTableScan + Filter演算子に書き換えます。全文検索インデックスは非同期で構築されるため、新しいデータの可視性にわずかな遅延が生じることがあります。デフォルトでは、列ストアの Executor は、クエリ結果の完全性を保証するために、インデックス化されていないデータに対してフルテーブルスキャンを行い、クエリ結果を補完します。このステップをスキップするかどうかをパラメータで制御できるため、高い同時実行性と大規模なデータ量のシナリオで、パフォーマンスと一貫性のバランスを柔軟に取ることができます。また、インデックス構築パラメータを調整してデータ同期頻度を上げ、フルテーブルスキャンの範囲を狭めることで、クエリ効率をさらに向上させることもできます。
-
LIKE高速化特定の条件下で、PolarDB のインメモリー列指向インデックスは
LIKEとMATCHの相互変換をサポートします。LIKEからMATCHへの変換は、主にクエリの高速化のためで、フルテーブルスキャンにおける大量の文字列の行ごとの比較のオーバーヘッドを削減するためです。現在、この変換は、列ストアの全文検索インデックスが
ngramトークナイザーを使用し、ngramのトークン長がLIKEのパターン文字列の長さ以下である場合にのみ有効になります。この条件下で、オプティマイザはLIKE '%abc%'のような述語をFtsTableScan + Filter演算子に書き換え、転置インデックスを使用して候補行を迅速にフィルタリングできます。ただし、
ngramトークン化のマッチングメカニズムはLIKEのセマンティクスとは異なるため (たとえば、"abbc"はab、bb、bcにトークン化され、これらは"abc"のabとbcと重なり、誤って一致と判断されることがあります)、結果の正確性を保証するために、元のLIKE式は後続のフィルター条件として正確な検証を行うために保持されます。このメカニズムは、セマンティクスの正確さと実行効率を効果的にバランスを取りながら、クエリパフォーマンスを大幅に向上させます。
PolarDB のインメモリー列指向インデックスの転置インデックスは、複数の転置セグメントで構成されます。各転置セグメントには、独自のメタデータ、1 つのターム辞書、および一連のポスティングリストが含まれており、各タームは 1 つのポスティングリストに一意に対応します。メタデータには、辞書とポスティングリストの開始アドレスなどの情報が記録されます。メタデータは小さく、インデックスアクセスを高速化するためにデフォルトでメモリに常駐します。
転置インデックスの検索は、転置セグメントごとに行われます。主なプロセスには、辞書データの読み取り、有限状態トランスデューサー (FST) 辞書オブジェクトの構築、辞書でのターゲットタームの検索、および対応するポスティングリストを読み取って RBM (Roaring Bitmap) ポスティングリストオブジェクトを構築することが含まれます。
具体的には、クエリは 2 つのモードに分かれます:
-
演算子クエリ:すべての転置セグメントのメタデータを走査し、辞書の開始アドレスを取得し、辞書データをロードし、辞書オブジェクトを構築して、ターゲットタームを検索します。タームが見つかった場合、そのタームのポスティングリストのオフセットアドレスをセグメント内の開始アドレスと組み合わせて、完全なポスティングリストオブジェクトを読み取ります。
-
式クエリ:行番号に基づいて転置セグメントのセットを特定し、メタデータ内の行番号範囲によってさらにフィルタリングし、その後、一致する転置セグメントに対して演算子クエリと同様の辞書検索とポスティングリストの読み取りを行います。
パフォーマンスを向上させるため、インメモリー列指向インデックスはターム辞書のキャッシュをサポートします。このキャッシュは独立した LRU (Least Recently Used) キャッシュメカニズムを使用し、スケジューリングモジュールがそのキャッシュのメモリクォータを動的に調整します。単一のポスティングリストは通常小さく (ほとんどが 1 回の 4 KB の I/O のみ必要)、ポスティングリストも多数存在するため、キャッシュヒット率とキャッシュの利点は限定的です。したがって、メモリリソースの無駄を避けるため、ポスティングリストのキャッシュはデフォルトで無効になっています。
この設計は、クエリ効率を確保しながら、メモリ使用量と I/O オーバーヘッドのバランスを取ります。
ユースケース
PolarDB IMCI の全文検索機能は、テキストコンテンツの高速な検索が求められる多くのビジネスシナリオに適用できます。
-
E コマースの商品検索とサイト内クエリ
E コマースプラットフォームでは、ユーザーはキーワードで商品を検索することがよくあります。従来の
LIKEに基づくあいまい一致はパフォーマンスが低く、高い同時実行性の下ではレスポンス要件を満たせません。外部の Elasticsearch ソリューションは検索を高速化しますが、同期のレイテンシーが原因で、検索結果に販売停止、価格改定、または在庫切れの商品が含まれることが多く、ユーザーエクスペリエンスを低下させます。PolarDB IMCI は、ネイティブの全文検索を提供し、商品名、説明、属性などのテキストフィールドに効率的な転置インデックスを構築します。クエリはデータベース内でキーワードマッチングを完了するため、システム間のレイテンシーを回避し、価格や在庫といった各商品のリアルタイムな状態と検索結果との間に強い整合性を保ちます。ユーザーが見つけた商品を、実際に購入できます。
-
ログ分析と可観測性
運用保守やトラブルシューティングの際、開発者や運用保守エンジニアは、大量のログの中からエラースタックを迅速に特定したり、リクエストチェーンを追跡したり、異常な行動を分析したりする必要があります。従来の ELK アーキテクチャは強力ですが、コンポーネントが多く、デプロイが複雑で、維持コストも高くなります。また、データが書き込まれてからクエリ可能になるまでに、顕著な遅延が生じます。
PolarDB IMCI を使用すると、ログテーブルの
messageまたはcontentフィールドに直接全文インデックスを作成し、標準 SQL を使用してミリ秒レベルのログ検索を実行できます。 別のログ分析プラットフォームを構築することなく、インタラクティブなクエリを実行し、コンテキストを追跡できます。 これにより、テクノロジースタックが大幅に簡素化され、ストレージと O&M のオーバーヘッドが削減され、問題の特定がより効率的になります。 -
ドキュメントとナレッジベースの検索
社内のナレッジベース、製品マニュアル、よくある質問 (FAQ)、ヘルプセンターなどでは、ユーザーが必要な情報を迅速に見つけられるようにすることが中核的な要件です。外部の検索エンジンに依存すると、二重書き込みロジックを維持する必要があり、更新後にコンテンツの同期がとれなくなりがちです。
PolarDB IMCI を使用してドキュメント本文に全文インデックスを構築し、
jiebaやikなどの中国語トークナイザーを使用してトークン化の精度を向上させます。これにより、同じデータベースでコンテンツを保存および取得できます。コンテンツは更新後すぐに検索可能になり、権限モデルは既存のシステムを再利用し、追加の同期メカニズムは不要です。公開されたコンテンツはすぐに表示され、編集はすぐに反映されます。 -
ユーザープロファイリングと行動分析
精度の高いユーザー施策には、ユーザーのコメント、タグ、投稿から興味や好みを抽出するなど、非構造化テキストの詳細なマイニングが不可欠です。従来のアプローチでは、データをデータウェアハウスや分析システムにエクスポートしますが、これは複雑なプロセスであるうえ、適時性に欠けます。
PolarDB IMCI は、JSON フィールドでは
jsonトークナイザーを、ロングテキストフィールドではjiebaトークナイザーを使用してインデックスを構築することをサポートしています。これにより、単一の SQL ステートメントで、年齢や地域などの構造化属性と、「アウトドアスポーツを楽しむ」や「費用対効果を重視する」などのテキストセマンティクスを組み合わせて共同分析を行うことができます。データ移行を行うことなく、ユーザーセグメンテーションや行動インサイトをリアルタイムで完了させ、きめ細かな運用とパーソナライズされたレコメンデーションをサポートします。
パフォーマンスベンチマーク
ESRally は、Elastic 社が提供する Elasticsearch の公式ベンチマークツールです。このトピックでは、組み込みの http_logs データセットを使用して、PolarDB IMCI 列ストアフルテキストインデックスの検索パフォーマンスを評価します。
データセットの準備
-
データセットを取得します。
データセットの詳細については、Elasticsearch Rally Hub をご参照ください。次の方法でデータセットを取得できます。圧縮パッケージ
rally-track-data-http_logs.tarは約 1.7 GB です。展開後のデータセットは約 32 GB で、合計 2 億 4,700 万行が含まれます。git clone https://github.com/elastic/rally-tracks.git cd rally-tracks ./download.sh http_logs -
テーブルを作成します。
データセット内の少数の行には MySQL の JSON 型と互換性のない JSON データが含まれているため、JSON データの保存には
varchar(4096)を使用します。データをインポートした後、仮想カラムを使用して JSON からrequestフィールドを解析します。CREATE TABLE http_logs( logs varchar(4096) ); -
データをインポートします。
LOAD DATAを使用して、データセットをデータベースにインポートします。LOAD DATA INFILE '/home/xxx/http_logs/documents-181998.json' INTO TABLE http_logs COLUMNS TERMINATED BY '\n'; ... ... -
カラムを追加します。
仮想カラムを使用して、フルテキストインデックスのテスト用に JSON から
requestフィールドを解析します。ALTER TABLE http_logs ADD COLUMN request varchar(1024) AS (CASE WHEN json_valid(logs) THEN (json_unquote(json_extract(logs, '$.request'))) ELSE NULL END); -
列ストアインデックスを作成します。
列ストアの転置インデックスは列ストアインデックスの一部であるため、まず列ストアインデックスを作成する必要があります。
ALTER TABLE http_logs comment 'columnar=1'; -
転置インデックスを作成します。
列ストアの転置インデックスは、DDL でカラムのコメントを変更することで作成されます。DDL 文は数秒で完了し、転置インデックスはバックグラウンドで非同期に構築されます。
ALTER TABLE http_logs modify COLUMN request varchar(1024) AS (CASE WHEN json_valid(logs) THEN (json_unquote(json_extract(logs, '$.request'))) ELSE NULL END) comment 'imci_fts(type=2 mode=1)'; -
転置インデックスを参照します。
インデックスの作成後、次の文を実行して
NUM_PACKSとNEXT_PACK_IDをそれぞれ参照できます。NUM_PACKSは列ストアのデータブロックの数を示し、NEXT_PACK_IDは転置インデックスが構築されたデータブロックの番号を示します。この 2 つの値が近い場合、転置インデックスが構築されています。SHOW imci indexes; SHOW imci indexes fulltext;
パフォーマンスベンチマーク
転置インデックスが構築された後、MATCH 関数を使用して、高頻度から低頻度までのタームの検索パフォーマンスをテストできます。以下に、同じデータセットでの LIKE、MATCH、および Doris の MATCH_ANY のクエリパフォーマンスの比較を示します。
ホットデータでのシングルスレッドテストの結果は次のとおりです。
|
クエリ |
高頻度ターム |
比較的高頻度のターム |
比較的低頻度のターム |
低頻度ターム |
|
|
1分21.96秒 |
1分18.44秒 |
1分24.59秒 |
1分31.19秒 |
|
|
25.46秒 |
22.80秒 |
21.98秒 |
21.60秒 |
|
(独自の FTS ライブラリ) |
2.43秒 |
0.25秒 |
0.01秒 |
0.00秒 |
|
Doris (CLucene ライブラリ) |
3.49秒 |
0.24秒 |
0.03秒 |
0.03秒 |
前の表に示すように、MATCH は LIKE よりも大幅なパフォーマンスの向上を実現し、データがホットかコールドかにはほとんど影響されません。
よくある質問
Q1:PolarDB のインメモリー列指向インデックス (IMCI) による全文検索は、MySQL InnoDB のような従来のデータベースに組み込まれているフルテキストインデックスと比較して、どのようなメリットがありますか?
PolarDB の IMCI は、パフォーマンス、機能、スケーラビリティの点でメリットがあります。
-
パフォーマンス:列ストアとベクトル化実行エンジンに基づき、FST や RBM などのアルゴリズムと組み合わせることで、従来の行ストアインデックスよりも優れたクエリパフォーマンスを実現し、高い同時実行性と大規模なデータ量が求められるシナリオでも高速なレスポンスが可能です。
-
機能:
jiebaやikなどの組み込み中国語トークナイザー、およびjsonトークナイザーは、複雑なビジネスシナリオの要件を満たします。 -
書き込みパフォーマンスへの影響:最適化されたインデックスの構築・更新メカニズムにより、高頻度の書き込み (INSERT/UPDATE) シナリオにおけるパフォーマンスへの影響は、従来のデータベースのフルテキストインデックスよりもはるかに小さくなっています。
-
水平スケーラビリティ:PolarDB のストレージとコンピューティングの分離アーキテクチャにより、優れた水平スケーラビリティを備えています。
Q2:自社のビジネスデータに適したトークナイザーを選択するには、どうすればよいですか?
データタイプとクエリ要件に基づいてトークナイザーを選択してください。
-
中国語テキスト:
jiebaまたはikトークナイザーを使用します。どちらも意味的なトークン化を実行するため、中国語検索の精度が向上します。 -
英語または記号で区切られたテキストには、
tokenトークナイザーを使用します。このトークナイザーは、スペースと句読点でテキストを分割します。 -
あいまい一致や任意の部分文字列検索には、
ngramトークナイザーを使用します。このトークナイザーは、テキストを固定長のフレーズ (バイグラムやトライグラムなど) に分割するため、非効率なLIKE '%keyword%'クエリの優れた代替手段となります。 -
JSON フィールド内の特定のコンテンツには、
jsonトークナイザーを使用します。これは現在、JSON 配列の値または JSON オブジェクトのキーに対する転置インデックスの構築をサポートしています。
どのトークナイザーが最適かわからない場合は、dbms_imci.fts_tokenize 関数を使用して、さまざまなトークナイザーがサンプルテキストをどのように処理するかをプレビューし、ビジネス要件に最も一致するトークン化戦略を選択してください。