MySQL Community Edition 8.0 で導入されたハッシュ結合メソッドは、分析クエリのパフォーマンスを大幅に向上させます。PolarDB for MySQL 8.0 は、ハッシュ結合の並列実行をサポートしており、その戦略は拡充し続けています。このトピックでは、PolarDB でパラレルクエリのハッシュ結合機能を使用する方法について説明します。
シンプルな並列ハッシュ結合
前提条件
クラスターは、リビジョンバージョン 8.0.2.1.0 以降を実行するPolarDB for MySQL 8.0 Cluster Edition である必要があります。バージョンを確認するには、「エンジンバージョンの照会」をご参照ください。
並列戦略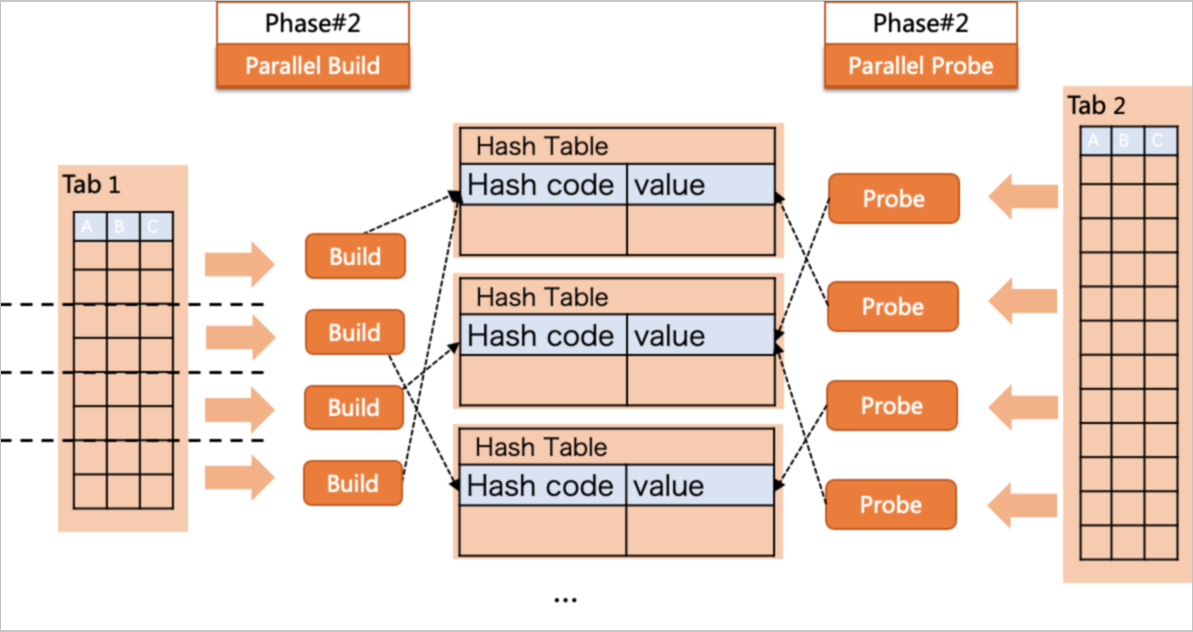
この図は、並列度 (DOP) が 4 のパラレルクエリの実行計画を示しています。これは、PolarDB が 4 つのワーカーを使用して、テーブル t1 のさまざまな部分を同時にスキャンすることを示します。各ワーカーは、t1 のデータから自身が担当する部分を使用して、独自のハッシュテーブルを構築します。これらのハッシュテーブルは、テーブル t2 全体と結合されます。最後に、リーダーがすべてのワーカーから結果を収集します。
使用方法
-
構文:
PolarDB では、
EXPLAIN FORMAT=TREEステートメントを使用して、実行計画内のハッシュ結合操作を確認します。 -
例:
次の例では、2 つの
テーブルを作成し、サンプルデータを挿入します。CREATE TABLE t1 (c1 INT, c2 INT); CREATE TABLE t2 (c1 INT, c2 INT); INSERT t1(c1, c2) WITH RECURSIVE seq AS ( SELECT 1 AS a, 1 AS b UNION ALL SELECT a + 1, b + 1 FROM seq WHERE a < 1000 ) SELECT a,b FROM seq; INSERT INTO t2 SELECT * FROM t1;SQL ステートメントの
実行計画を表示します。EXPLAIN FORMAT=TREE SELECT /*+ PQ_DISTRIBUTE(t1 PQ_NONE) PQ_DISTRIBUTE(t2 PQ_NONE) */ * FROM t1 JOIN t2 ON t1.c1 = t2.c2;EXPLAIN FORMAT=TREE EXPLAIN -> Gather (slice: 1; workers: 4) (cost=10.82 rows=4) -> Parallel inner hash join (t2.c2 = t1.c1) (cost=0.57 rows=1) -> Parallel table scan on t2, with parallel partitions: 1 (cost=0.03 rows=1) -> Parallel hash -> Parallel table scan on t1, with parallel partitions: 1 (cost=0.16 rows=1)上記の例は、並列度 (DOP) が 4 の並列実行計画を示しています。これは、PolarDB がクエリを実行するために 4 つのワーカーを起動することを示します。この計画では、
t1テーブルで並列スキャンが実行されます。4 つのワーカーは、このテーブルの異なる部分をスキャンします。各ワーカーはt1のデータから自身が担当する部分を使用してハッシュテーブルを構築し、t2テーブル全体と JOIN 操作を実行します。最後に、リーダーがすべてのワーカーから結果を収集し、最終的なクエリ結果を生成します。
シャッフルハッシュ結合
前提条件
クラスターは、リビジョンバージョン 8.0.2.2.0 以降を実行するPolarDB for MySQL 8.0 Cluster Edition である必要があります。バージョンを確認するには、「エンジンバージョンの照会」をご参照ください。
並列戦略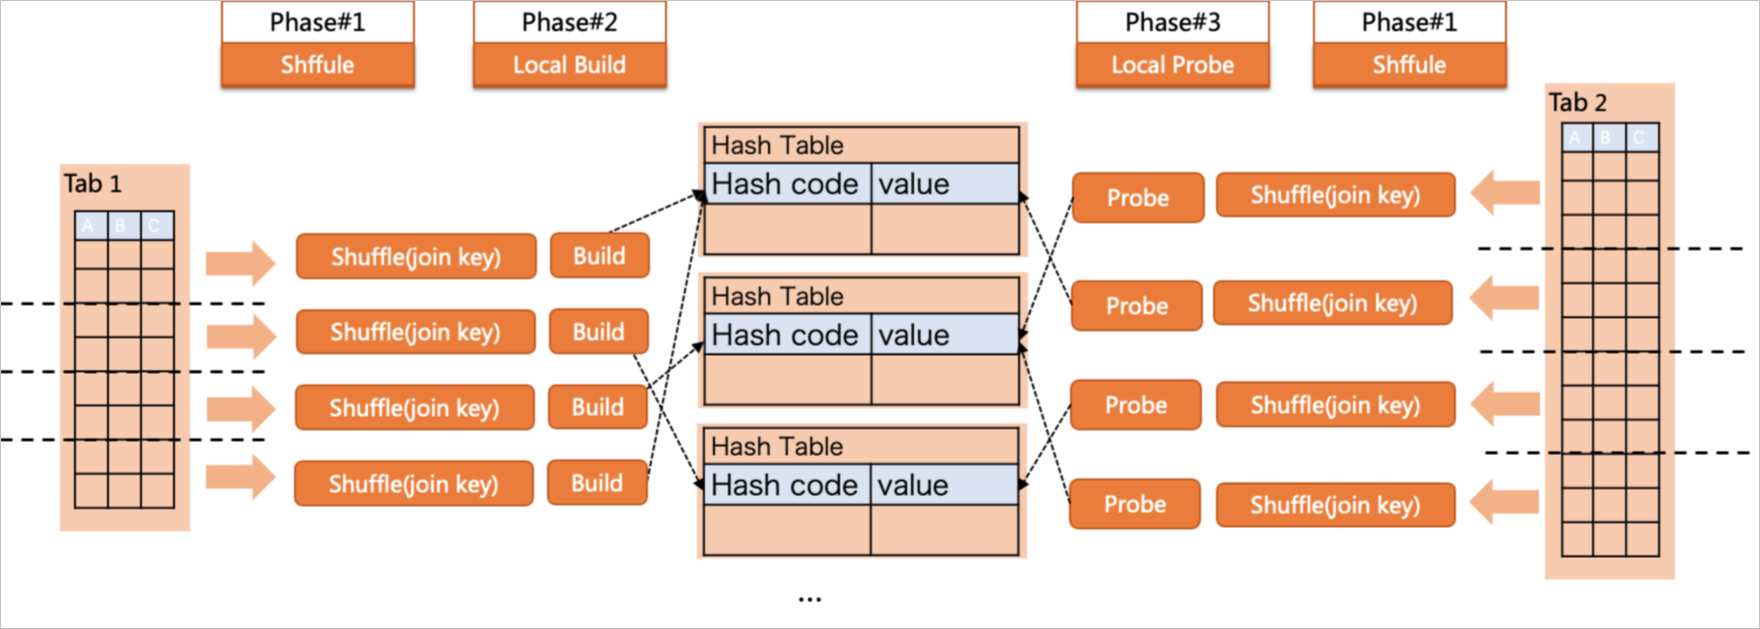
並列ハッシュ結合は、ビルドフェーズとプローブフェーズの両方を並列で実行します。しかし、共有ハッシュテーブルが大きすぎてメモリに収まらない場合、ディスクにスピルオーバーし、I/O オーバーヘッドが発生してクエリ効率が低下します。シャッフルハッシュ結合戦略は、両方のテーブルのデータを再パーティション分割することでこの問題に対処します。図に示すように、このプロセスはテーブル t1 の並列スキャンから始まります。複数のワーカーがテーブルを同時にスキャンします。次に、各ワーカーは、結合キーに基づいて、自身のデータを 2 番目のワーカーセットに再パーティション分割 (シャッフル) します。これにより、2 番目のセットの各ワーカーは、t1 のデータのパーティションから、より小さなローカルハッシュテーブルを構築できます。ビルドフェーズが完了すると、テーブル t2 で並列スキャンが開始されます。t2 のデータも結合キーによって再パーティション分割され、対応するハッシュテーブルパーティションを保持しているワーカーに送信されます。次に、各ワーカーは、自身のローカルデータパーティションに対してプローブ操作を実行します。最後に、リーダーがすべてのワーカーから結果を収集します。
使用方法
-
構文:
PolarDB では、
EXPLAIN FORMAT=TREEステートメントを使用して、実行計画内のハッシュ結合操作を確認します。 -
例:
次の例では、2 つの
テーブルを作成し、サンプルデータを挿入します。CREATE TABLE t1 (c1 INT, c2 INT); CREATE TABLE t2 (c1 INT, c2 INT); INSERT t1(c1, c2) WITH RECURSIVE seq AS ( SELECT 1 AS a, 1 AS b UNION ALL SELECT a + 1, b + 1 FROM seq WHERE a < 1000 ) SELECT a,b FROM seq; INSERT INTO t2 SELECT * FROM t1;SQL ステートメントの
実行計画を表示します。EXPLAIN FORMAT=TREE SELECT * FROM t1 JOIN t2 ON t1.c1 = t2.c2;EXPLAIN FORMAT=TREE EXPLAIN | -> Gather (slice: 1; workers: 2) (cost=33.38 rows=4) -> Inner hash join (t2.c2 = t1.c1) (cost=23.08 rows=2) -> Repartition (hash keys: t2.c2; slice: 2; workers: 1) (cost=11.35 rows=2) -> Parallel table scan on t2, with parallel partitions: 1 (cost=0.65 rows=4) -> Hash -> Repartition (hash keys: t1.c1; slice: 3; workers: 1) (cost=11.35 rows=2) -> Parallel table scan on t1, with parallel partitions: 1 (cost=0.65 rows=4)