Gomez and Maravall (1998) および TRAMO (1996) のプロシージャを用いて、時系列データに最適な ARIMA モデルを自動的に選択します。
仕組み
このコンポーネントは、4 つのステップで最適な ARIMA モデルを選択します。
デフォルトモデルの推定
frequency = 1の場合、デフォルトモデルは(0,1,1)です。frequency > 1の場合、デフォルトモデルは(0,1,1)(0,1,1)です。
差分次数の特定:
diffとseasonalDiffが指定されている場合、このステップはスキップされます。それ以外の場合は、単位根検定により、非季節差分次数 d と季節差分次数 D を決定します。ARMA 次数の特定:ベイズ情報量規準 (BIC) に基づいて、最も適切なモデルを選択します。
maxOrderとmaxSeasonalOrderパラメーターで上限を制御します。モデルの比較と最終チェック:Ljung-Box Q 統計量を使用して、特定したモデルをデフォルトモデルと比較します。両方のモデルが不適切な場合は、
(3,d,1)(0,D,1)モデルにフォールバックします。
ARIMA の詳細については、「自己回帰和分移動平均」をご参照ください。
制限事項
MaxCompute のコンピューティングリソースでのみ実行されます。
1 グループあたりのデータレコード数は最大 1,200 件です。
数値列は 1 列のみです。
リソース計算
groupColNamesを指定しない場合:coreNum = 1 memSizePerCore = 4096groupColNamesを指定する場合:coreNum = floor(総行数 / 120,000) memSizePerCore = 4096
コンポーネントの設定
x13_auto_arima は、以下のいずれかの方法で設定します。
方法1:PAI コンソールでの設定
ビジュアルモデリングのパイプラインページでパラメーターを設定します。
フィールド設定
パラメーター | 必須 | 説明 |
時系列列 | はい | 値列の値を並べ替えます。 |
値列 | はい | 時系列値を含む数値列。 |
層化列 | いいえ | 複数のカラムは、カンマ ( |
パラメーター設定
パラメーター | 説明 | デフォルト |
開始日 | 形式: | -- |
系列頻度 | (0,12] の範囲の正の整数。 | -- |
p と q の最大値 | [0,4] の範囲の整数。 | -- |
季節性の p と q の最大値 | [0,2] の範囲の整数。 | -- |
差分 d の最大値 | [0,2] の範囲の整数。 | -- |
季節差分 d の最大値 | [0,1] の範囲の整数。 | -- |
差分 d | 0 より大きく 2 以下の正の整数です。 | -- |
季節差分 d | 範囲 (0,1] 内の正の整数です。 | -- |
予測数 | 予測数。 たとえば、過去 1 か月間に基づいて今後 7 日間の売上を予測するには、 | -- |
予測信頼区間 | 予測区間を計算するための信頼度。 | 0.95 |
収束許容誤差 | オプション。 モデルフィッティングの収束許容誤差。 | 1e-5 |
最大反復回数 | 正の整数。 | 1500 |
実行チューニング
パラメーター | 説明 |
コア数 | デフォルトではシステムが自動的に決定します。 |
メモリサイズ | コアあたりのメモリサイズ (MB)。 |
方法2:PAI コマンドでの設定
SQL スクリプトを使用して PAI コマンドを実行します。 詳細については、「SQL スクリプト」をご参照ください。
PAI -name x13_auto_arima
    -project algo_public
    -DinputTableName=pai_ft_x13_arima_input
    -DseqColName=id
    -DvalueColName=number
    -Dstart=1949.1
    -Dfrequency=12
    -DpredictStep=12
    -DoutputPredictTableName=pai_ft_x13_arima_out_predict2
    -DoutputDetailTableName=pai_ft_x13_arima_out_detail2
パラメーターリファレンス
パラメーター | 必須 | 説明 | デフォルト |
inputTableName | はい | 入力テーブルの名前。 | 該当なし |
inputTablePartitions | いいえ | 入力テーブルのパーティション。 | テーブル全体 |
seqColName | はい | 時系列列。 値列の値を並べ替えます。 | 該当なし |
valueColName | はい | 値列。 | 該当なし |
groupColNames | いいえ | 層別列。複数の列はカンマ ( | 該当なし |
start | いいえ | 時系列の開始時刻。 形式: | 1.1 |
frequency | いいえ | 時系列の頻度。 (0,12] の範囲の正の整数。 値 12 は 12 か月 (1 年) を示します。 詳細については、「時系列フォーマット」をご参照ください。 | 12 |
maxOrder | いいえ | p と q の最大値。 [0,4] の範囲の整数。 | 2 |
maxSeasonalOrder | いいえ | 季節性の p と q の最大値。 [0,2] の範囲の整数。 | 1 |
maxDiff | いいえ | 非季節差分次数 d の最大値。 [0,2] の範囲の整数。 | 2 |
maxSeasonalDiff | いいえ | 季節差分次数 d の最大値。 [0,1] の範囲の整数。 | 1 |
diff | いいえ | 非季節性差分階数 d。[0,2] の範囲の正の整数です。 | -1 |
seasonalDiff | いいえ | 季節階差の次数 d。 [0,1] の範囲の正の整数。 | -1 |
maxiter | いいえ | 最大反復回数。 正の整数。 | 1500 |
tol | いいえ | 収束許容誤差。 DOUBLE 型。 | 1e-5 |
predictStep | いいえ | 予測エントリ数。 (0,365] の範囲の正の整数。 | 12 |
confidenceLevel | いいえ | 予測区間の信頼度。 (0,1) の範囲の数値。 | 0.95 |
outputPredictTableName | はい | 出力予測テーブル。 | 該当なし |
outputDetailTableName | はい | 出力詳細テーブル。 | 該当なし |
outputTablePartition | いいえ | データをパーティションにエクスポートするかどうかを指定します。 | パーティションにデータをエクスポートしない |
coreNum | いいえ | コア数。正の整数です。 | システムによって決定 |
memSizePerCore | いいえ | コアあたりのメモリサイズ (MB)。 [1024, 65536] の範囲の正の整数。 | システムによって決定 |
lifecycle | いいえ | 出力テーブルのライフサイクル。 | 該当なし |
時系列フォーマット
start パラメーターと フリークエンシー パラメーターは、数値列に ts1 と ts2 という 2 つの時間次元を定義します。
フリークエンシーは、1 つの ts1 単位に収まる ts2 単位の数を指定します。startはn1.n2というフォーマットを使用します。これは、系列が n1 番目の ts1 における n2 番目の ts2 から始まることを意味します。
一般的な設定:
時間単位 | ts1 | ts2 | フリークエンシー | start の例 |
12 か月/年 | 年 | 月 | 12 |
|
4 四半期/年 | 年 | 四半期 | 4 |
|
7 日/週 | 週 | 日 | 7 |
|
1 | 任意の時間単位 | 1 | 1 |
|
時系列の例
指定値: value = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15]
start=1949.3, フリークエンシー=12 (月次データ、12 か月/年)
予測は 1950 年 6 月から始まります。
年 | 1月 | 2月 | 3月 | 4月 | 5月 | 6月 | 7月 | 8月 | 9月 | 10月 | 11月 | 12月 |
1949 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | ||
1950 | 11 | 12 | 13 | 14 | 15 |
start=1949.3, フリークエンシー=4 (四半期データ、4 四半期/年)
予測は 1953 年第 2 四半期から始まります。
年 | 第 1 四半期 | 第 2 四半期 | 第 3 四半期 | 第 4 四半期 |
1949 | 1 | 2 | ||
1950 | 3 | 4 | 5 | 6 |
1951 | 7 | 8 | 9 | 10 |
1952 | 11 | 12 | 13 | 14 |
1953 | 15 |
start=1949.3, フリークエンシー=7 (日次データ、7 日/週)
予測は 1951 週目の 4 日目から始まります。
週 | 日 | 月 | 火 | 水 | 木 | 金 | 土 |
1949 | 1 | 2 | 3 | 4 | 5 | ||
1950 | 6 | 7 | 8 | 9 | 10 | 11 | 12 |
1951 | 13 | 14 | 15 |
start=1949.1, フリークエンシー=1 (非季節性データ)
予測は 1964 年から始まります。
サイクル | p1 |
1949 | 1 |
1950 | 2 |
1951 | 3 |
1952 | 4 |
1953 | 5 |
1954 | 6 |
1955 | 7 |
1956 | 8 |
1957 | 9 |
1958 | 10 |
1959 | 11 |
1960 | 12 |
1961 | 13 |
1962 | 14 |
1963 | 15 |
例
テストデータの準備
この例では、AirPassengers.csv データセットを使用します。このデータセットは、1949 年から 1960 年までの国際航空旅客数を月ごとに記録したものです。データセットの詳細については、「AirPassengers」をご参照ください。
サンプルデータ:
id | number |
1 | 112 |
2 | 118 |
3 | 132 |
4 | 129 |
5 | 121 |
... | ... |
MaxCompute クライアントで次の Tunnel コマンドを実行して、データをアップロードします。MaxCompute クライアントのインストールと設定については、「MaxCompute クライアント (odpscmd)」をご参照ください。Tunnel コマンドの詳細については、「Tunnel コマンド」をご参照ください。
create table pai_ft_x13_arima_input(id bigint, number bigint);
tunnel upload xxx/airpassengers.csv pai_ft_x13_arima_input -h true;
PAI コマンドの実行
SQL スクリプトまたは ODPS SQL コンポーネントを使用して PAI コマンドを実行します。
PAI -name x13_auto_arima
    -project algo_public
    -DinputTableName=pai_ft_x13_arima_input
    -DseqColName=id
    -DvalueColName=number
    -Dstart=1949.1
    -Dfrequency=12
    -DmaxOrder=4
    -DmaxSeasonalOrder=2
    -DmaxDiff=2
    -DmaxSeasonalDiff=1
    -DpredictStep=12
    -DoutputPredictTableName=pai_ft_x13_arima_auto_out_predict
    -DoutputDetailTableName=pai_ft_x13_arima_auto_out_detail
出力
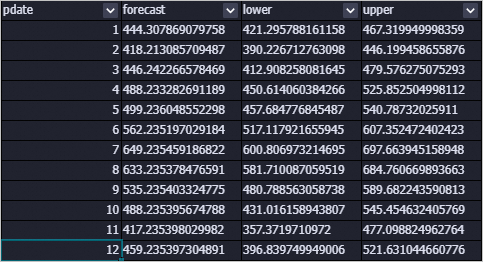
予測テーブル (outputPredictTableName)
列 | 説明 |
pdate | 予測の日付。 |
forecast | 予測の結論。 |
lower | 指定した信頼度における予測区間の下限。デフォルト: 0.95。 |
upper | 指定した信頼度における予測区間の上限。デフォルト: 0.95。 |
生成されたデータ:
詳細テーブル (outputDetailTableName)
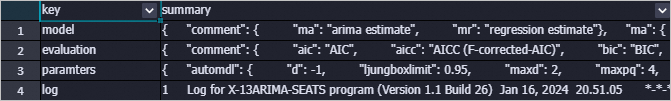
列 | 説明 |
key | 次のいずれか: |
summary | 対応するキーのストレージ詳細。 |
生成されたデータ:
よくある質問
すべての予測結果が同じ値になるのはなぜですか?
これは、モデルトレーニング中に例外が発生し、平均モデルにフォールバックした場合に発生します。平均モデルは、すべての予測に対してトレーニングデータの平均値を出力します。一般的な原因としては、差分後の不安定性、トレーニング中の収束の失敗、または入力データの分散が 0 であることが挙げられます。
具体的なエラーを診断するには、Logview で個々のノードの stderr ファイルを確認してください。
x13_arima と x13_auto_arima のどちらを選択すればよいですか?
x13_arima では、p、d、q、sp、sd、sq パラメーターを手動で指定する必要があります。どの値を使用すればよいかわからない場合は、代わりに x13_auto_arima を選択してください。x13_auto_arima では、上限 (maxOrder や maxDiff など) のみを設定すれば、コンポーネントがパラメーターを自動的に調整します。
エラー:差分後の観測値数が最小系列長未満
ERROR: Number of observations after differencing and/or conditional AR estimation
is 9, which is less than the minimum series length required for the model estimated, 24
指定されたモデルでは、トレーニングデータが不足しています。 frequency パラメーターを変更するか、トレーニングデータを追加してください。
エラー:MA 演算子の次数が過大
ERROR: Order of the MA operator is too largeこのエラーは通常、トレーニングデータ不足が原因です。入力テーブルにデータポイントを追加してください。
エラー:系列に 3 年分以上の完全なデータが必要
ERROR: Series to be modelled and/or seasonally adjusted must have at least 3 complete
years of data
季節性パラメーターが指定されている場合、入力データには少なくとも 3 年分の完全な観測値を含める必要があります。
リファレンス
X-13ARIMA-SEATS は、オープンソースの X-13ARIMA-SEATS アルゴリズムに基づく季節調整済み自己回帰和分移動平均 (ARIMA) モデルアルゴリズムです。関連する手動パラメーターコンポーネントについては、x13_arima をご参照ください。