不正行為者が単独で行動することはほとんどありません。不正行為者はネットワーク内で行動し、アカウント、住所、デバイス、連絡先を共有します。従来のルールベースのシステムは各人を個別に評価するため、こうした隠れたつながりを見落とします。グラフアルゴリズムは、個々の属性だけでなく人と人の関係性を分析することで、不正を検知します。
このチュートリアルでは、PAI Designer の Financial Risk Management パイプラインテンプレートを使用し、関係性ネットワーク内の各人物について不正確率スコアを算出する方法を説明します。
パイプラインによる不正検知の仕組み
このパイプラインでは、人を頂点、関係性をエッジとして表現します。各エッジには近さを測る count 値があり、値が大きいほど関係性が強いことを示します。
3 つのグラフアルゴリズムコンポーネントが順に実行されます:
[最大連結サブグラフ]:関係グラフ内の人物を 2 つのグループに分類し、各グループに ID を割り当てます。続いて、SQL Script コンポーネントおよび JOIN コンポーネントと組み合わせて、相互にリンクしている人物数が最大の集合を特定することで、無関係な人物を除外します。
[単一始点最短経路]:Enoch が目的の人物に到達するまでに経由する人物の数を測定します。出力の
distanceフィールドに、このホップ数が記録されます。[ラベル伝播分類]:既知のケース (不正行為者である Evan) の不正ラベルをネットワーク全体に伝播します。ラベルは、ラベル付きの頂点から隣接する頂点へ広がります。出力の
weightフィールドに、各人物が不正行為者である確率が記録されます。
データセット
このパイプラインは、次のフィールドを持つ関係性データセットを使用します。
| フィールド | タイプ | 説明 |
|---|---|---|
start_point | STRING | エッジの始点頂点。人物の名前。 |
end_point | STRING | エッジの終点頂点。人物の名前。 |
count | DOUBLE | 2 人の近さ。値が大きいほど関係性が強いことを示します。 |
次の図は、パイプラインで使用するサンプルデータを示しています。 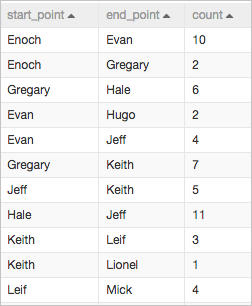
前提条件
開始する前に、次のものをご用意ください:
PAI ワークスペース。セットアップ手順については、PAI のドキュメントをご参照ください。
Designer を使用する権限と、PAI コンソールへのアクセス権。
パイプラインの構築と実行
手順 1:Designer の起動
PAI コンソールにログインします。
左側のナビゲーションペインで、[ワークスペース] をクリックします。 「ワークスペース」ページで、お使いのワークスペースの名前をクリックします。
左側のナビゲーションペインで、[モデルトレーニング] > [可視化モデリング (デザイナー)] を選択します。
手順 2:テンプレートからのパイプライン作成
可視化モデリング (デザイナー) ページで、[プリセットテンプレート] タブをクリックします。
金融リスク管理 テンプレートを見つけ、[作成] をクリックします。
[パイプラインの作成] ダイアログボックスで、パラメーターを確認します。[データストレージ] パラメーターは、パイプラインが実行時に一時データとモデルを格納する Object Storage Service (OSS) バケットパスを設定します。このチュートリアルでは、デフォルト値のままで問題ありません。
[OK] をクリックします。パイプラインは約 10 秒で作成されます。
[パイプライン] タブで、[金融リスク管理] パイプラインをダブルクリックしてキャンバスで開きます。
キャンバスには、3 つのセクションで構成されたパイプラインが表示されます。 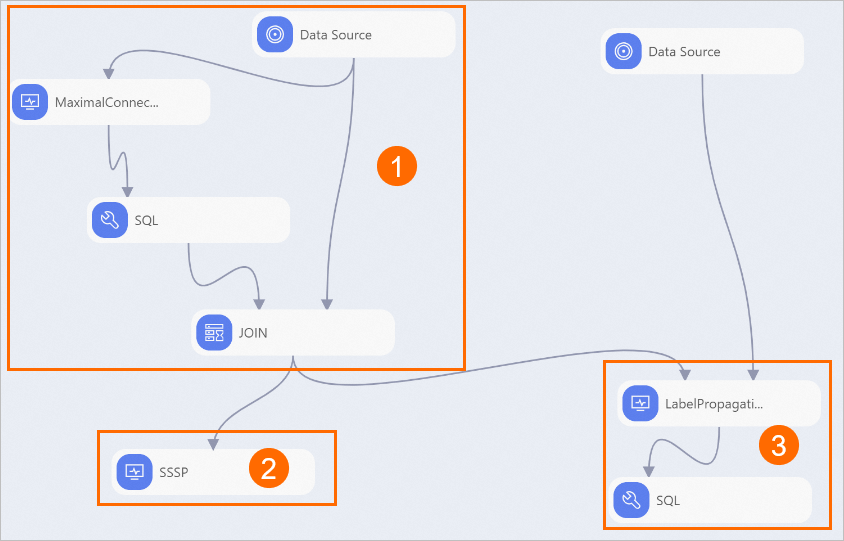
| セクション | コンポーネント | 目的 |
|---|---|---|
| ① | 最大連結サブグラフ → SQL Script → JOIN | 人物を 2 つのグループに分類し、各グループに ID を割り当てます。続いて、相互にリンクしている人物数が最大の集合を特定することで、無関係な人物を除外します。 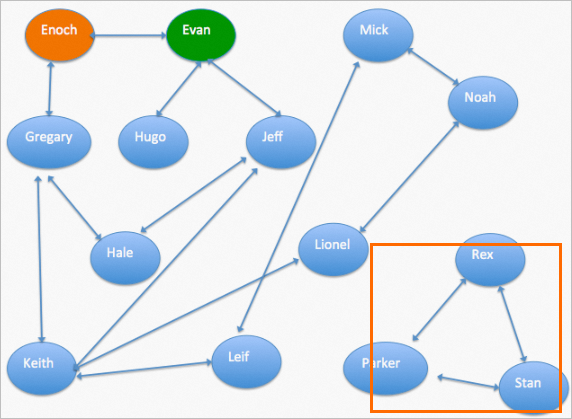 |
| ② | 単一始点最短経路 | Enoch が目的の人物に到達するまでに経由する人物の数を算出します。出力の distance フィールドに、この値が記録されます。 単一始点最短経路コンポーネントの出力には、4 つの列が含まれます:
|
| ③ | Data Source → ラベル伝播分類 → SQL Script | ラベル付きデータ (weight = 不正確率) をインポートし、既知の不正行為者から隣接する頂点へ不正ラベルをネットワーク全体に伝播し、結果をフィルタリングして各人物の不正確率を表示します。 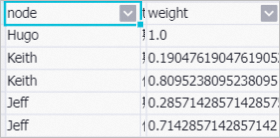 |
手順 3:パイプラインの実行と結果の確認
キャンバスの左上隅にある
 をクリックし、パイプラインを実行します。
実行が完了したら、キャンバス上の[SQL]を右クリックし、[データを表示]を選択します。
出力テーブルには、不正行為者としてラベル付けされた 8 人 (Leif、Evan、Mick、Noah、Hugo、Keith、Jeff、Lionel) と、不正確率を示す weight 値が表示されます。
グラフアルゴリズムが、ルールベースのシステムでは見逃される不正を検知できる理由
次の図は、関係グラフの例を示しています。矢印は、同僚や親族などの関係性を表します。このグラフでは、Enoch は信頼できる顧客であり、Evan は不正行為者です。 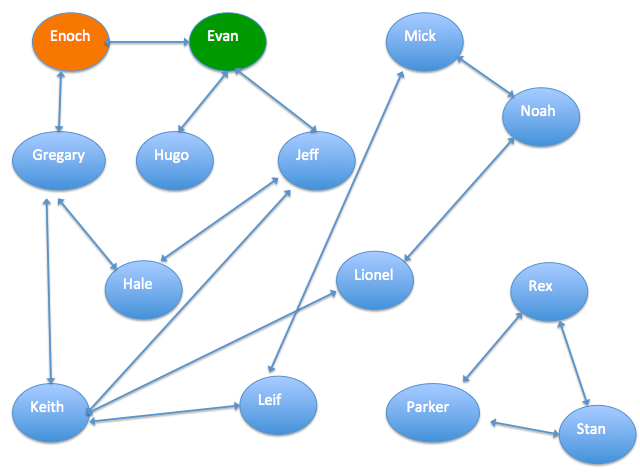
Machine Learning Platform for AI (PAI) は、関係性分析向けに K-Core、最大連結サブグラフ、ラベル伝播分類など、複数のグラフアルゴリズムコンポーネントを提供します。これらのコンポーネントは関係性の構造を分析し、個人レベルのモデルでは見落とされがちなリスクシグナルを顕在化させます。
ラベル伝播の仕組み:ラベル伝播分類は半教師あり分類アルゴリズムです。関係グラフとラベル付きデータを入力として使用し、ラベル付き頂点のラベルに基づいて、ラベルなし頂点のラベルを予測します。ラベル伝播では、各頂点のラベルが隣接する頂点へ伝播します。