概要
Alibaba Cloud は 3 月 6 日、Qwen ファミリーの推論モデルである QwQ-32B をオープンソース化しました。大規模な強化学習に基づき、数学、コーディング、汎用能力で画期的な向上を実現します。全体的な性能は DeepSeek-R1 と同等でありながら、デプロイコストを大幅に削減します。
-
数学向けの AIME24 ベンチマークおよびコーディング向けの LiveCodeBench において、QwQ-32B は DeepSeek-R1 と同等の性能を示し、同規模の o1-mini および R1-distilled モデルを大きく上回ります。
-
LiveBench (Meta のチーフサイエンティスト Yann LeCun 氏が主導する「最も難しい LLM 評価リーダーボード」)、指示追従の IFEval (Google などが提案)、関数呼び出し精度の BFCL テスト (UC Berkeley などが提案) において、QwQ-32B は DeepSeek-R1 を上回るスコアを記録しています。
-
QwQ-32B はエージェント機能を統合しており、ツールを使用しながら批判的に考え、環境からのフィードバックに基づいて理由付けのプロセスを調整できます。
PAI-モデルギャラリーは、QwQ-32B のワンクリックデプロイ、ファインチューニング、評価を完全にサポートしています。デプロイには 96 GB の GPU メモリを搭載した GPU が必要です。QwQ-32B-GGUF や QwQ-32B-AWQ などの量子化バージョンもサポートしており、単一の A10 カードなど、より低コストの GPU にデプロイできます。
モデルデプロイ
-
PAI-モデルギャラリーのページに移動します。
-
PAI コンソールにログインし、左上隅でリージョンを選択します。利用可能なコンピューティングリソースを確認するには、リージョンを切り替えることができます。
-
左側のナビゲーションペインで、ワークスペース一覧 を選択し、ワークスペースの名前をクリックして移動します。
-
左側のナビゲーションペインで、クイックスタート > [モデルギャラリー] を選択します。
-
-
PAI-モデルギャラリーのページで、QwQ-32B のモデルカードをクリックしてモデル詳細ページを開きます。
-
右上の [Deploy] をクリックします。デプロイフレームワークを選択し、推論サービスの名前を設定して、デプロイ用のリソースを指定します。これにより、モデルが Elastic Algorithm Service (EAS) にデプロイされます。プラットフォームは、SGLang、vLLM、BladeLLM (PAI が開発した高性能推論フレームワーク) など、さまざまなデプロイフレームワークをサポートしています。
デプロイ方法として、[Single-Node - Standard Instance] または [Single-Node - GP7V Instance] を選択できます。サービスの作成では、[New Service] または [Update Existing Service] を選択し、グループとタグを設定できます。サポートされるリソースタイプは、[Public Resources]、[EAS Resource Group]、[Resource Quota] です。
-
推論サービスを使用します。デプロイが成功したら、サービスページに移動し、[View Call Information] をクリックしてエンドポイントとトークンを取得します。サービスの呼び出し方法については、事前学習済みモデルのリンクをクリックしてモデル詳細ページに戻り、手順を確認してください。
サービス作成中に、[Status] フィールドの横にある [View Deployment Events] をクリックして、デプロイの進捗を監視できます。ステータスメッセージには
Waiting task server to be readyと表示されます。また、Elastic Algorithm Service (EAS) で、デプロイ済みの QwQ-32B モデルサービスをオンラインデバッグすることもできます。
オンラインデバッグページで、[チャット] タブを選択します。 HTTP メソッドは POST で、リクエストパスは
/api/predict/quickstart_qwq32b/v1/chat/completionsです。 ボディの JSON の例では、modelがQwQ-32Bに設定され、messagesにはrole: userとcontent: Please introduce yourselfが含まれており、max_tokensは1024に設定されています。 [リクエストを送信] をクリックすると、ステータスコード 200 が返され、レスポンスボディにはchat.completionタイプの推論結果が含まれ、assistant ロールのコンテンツには<think>タグで囲まれた思考プロセスが含まれます。
モデルのファインチューニング
PAI-モデルギャラリーは、QwQ-32B 向けの教師ありファインチューニング (SFT) アルゴリズムを提供します。LoRA ファインチューニングと全パラメータファインチューニングの両方をサポートしているため、すぐにモデルをファインチューニングできます。
-
トレーニングデータを準備します。SFT アルゴリズムは、JSONL などの形式のトレーニングデータセットをサポートします。形式要件の詳細については、「モデルドキュメント」をご参照ください。以下は、JSONL 形式のトレーニングデータセットの例です:
{"messages": [{"role": "system", "content": "You are a helpful and harmless assistant."}, {"role": "user", "content": "Who are you?"}, {"role": "assistant", "content": "I am Xiaopai, an AI assistant trained by PAI. My goal is to provide users with useful, accurate, and timely information and to help them communicate effectively in various ways. How can I help you?"}]} {"messages": [{"role": "system", "content": "You are a helpful and harmless assistant."}, {"role": "user", "content": "Who are you!"}, {"role": "assistant", "content": "Hello! I am an AI language model developed by PAI, named Xiaopai. I can answer your questions, provide information, engage in conversation, and help you solve problems. If you have any questions or need assistance, please feel free to let me know!"}]} -
トレーニングパラメーターを設定します。データを準備したら、Object Storage Service (OSS) のバケットにアップロードします。32B モデルは大規模であるため、アルゴリズムには 96 GB 以上の GPU メモリを搭載した GPU リソースが必要です。リソースクォータで十分なコンピューティングリソースが提供されていることを確認してください。
アルゴリズムは次のハイパーパラメーターをサポートします。データセットとコンピューティングリソースに基づいて調整するか、デフォルト値を使用できます。
パラメーター
説明
詳細
learning_rate
学習率。モデルの重みの調整幅を制御します。
学習率が高すぎるとトレーニングが不安定になり、損失値が大きく変動して収束しない場合があります。学習率が低すぎると損失の減少が遅くなり、収束までに時間がかかります。適切な学習率を設定すると、モデルは最適解に迅速かつ安定して収束します。
num_train_epochs
トレーニングデータセットを繰り返し学習する回数を指定します。
エポック数が少なすぎるとアンダーフィットになり、多すぎるとオーバーフィットになる可能性があります。サンプル数が少ない場合は、アンダーフィットを避けるためにエポック数を増やすことができます。一般に、学習率が小さいほど、より多くのエポック数が必要になります。
per_device_train_batch_size
1 回のトレーニング反復で各 GPU が処理するサンプル数です。
バッチサイズを大きくするとトレーニング速度は向上しますが、GPU メモリの要求も増えます。理想的なバッチサイズは、通常、GPU メモリのオーバーフローを発生させない最大値です。トレーニング詳細のタスク監視ページで GPU メモリ使用量を確認できます。
gradient_accumulation_steps
勾配を蓄積するステップ数です。
バッチサイズが小さいと勾配推定の分散が増加し、収束速度に影響します。勾配蓄積を使用すると、指定した数のバッチから勾配を蓄積した後にモデルの重みを更新できます。
gradient_accumulation_stepsが GPU 数の倍数になるように設定してください。max_length
1 回のトレーニングステップでモデルが処理する入力データの最大トークン長です。
トークナイザーはトレーニングデータを処理してトークンシーケンスを生成します。トークン推定ツールを使用して、トレーニングデータ内のテキスト長を見積もることができます。
lora_rank
LoRA の次元。
lora_alpha
LoRA の重み。
LoRA のスケーリング係数。通常は
lora_rank * 2に設定します。lora_dropout
LoRA トレーニングのドロップアウト率。トレーニング中にニューロンをランダムに無効化することで、オーバーフィットを防止します。
lorap_lr_ratio
LoRA+ の学習率比 (λ = ηB/ηA)。ここで ηA と ηB は、それぞれアダプタ行列 A と B の学習率です。
LoRA と比較して、LoRA+ は計算要件を増やさずに、プロセスの重要な部分に異なる学習率を使用することで、より高い性能とより高速なファインチューニングを実現できます。
lorap_lr_ratioを 0 に設定すると、トレーニングでは LoRA+ ではなく標準の LoRA を使用します。advanced_settings
上記のパラメーターに加えて、このフィールドで
--key1 value1 --key2 value2形式を使用して他のパラメーターをカスタマイズできます。不要な場合は、このフィールドを空のままにします。-
save_strategy:モデルのチェックポイントの保存戦略。オプションはsteps、epoch、noです。デフォルト:steps。 -
save_steps:モデルの保存間隔。デフォルト:500。 -
save_total_limit:保存するチェックポイントの最大数。この上限内に収めるため、システムは古いチェックポイントを削除します。デフォルト:2。Noneの場合、システムはすべてのチェックポイントを保存します。 -
warmup_ratio:学習率のウォームアップフェーズを制御するハイパーパラメーター。この初期フェーズでは、学習率が小さな値から初期設定値まで段階的に増加します。warmup_ratioは、このフェーズがトレーニング全体に占める割合を決定します。デフォルト:0。
-
-
[Train] ボタンをクリックしてトレーニングを開始します。トレーニングタスクのステータスとログを確認できます。また、ファインチューニング済みモデルをオンラインサービスとしてデプロイすることもできます。
モデル評価
PAI-モデルギャラリーには評価アルゴリズムが組み込まれており、事前学習済みモデルとファインチューニング済みモデルをすぐに評価できます。評価によってモデルの性能を把握できるほか、サイドバイサイド比較も可能なため、ユースケースに最適なモデルを選択できます。
モデル評価は次の 2 つの場所から開始できます:
|
事前学習済みモデルの直接評価 |
PAI-モデルギャラリーのモデル詳細ページで、右上の [Evaluate] ボタンをクリックします。 |
|
トレーニングタスク詳細ページからのファインチューニング済みモデルの評価 |
右上の [Evaluate] ボタンをクリックします。 |
モデル評価は、カスタムデータセットとパブリックデータセットの両方をサポートします。
[New Evaluation Task] ページで、ページタイトルの横にある [Switch to professional mode] をクリックしてプロフェッショナルモードに切り替えます。プロフェッショナルモードでは、ジャッジモデル評価などの高度な機能を使用できます。フォームで、[Task Name]、[Model]、[Output Path]、[Dataset Source]、[Resource Type]、[Resource Group Type]、[Resource Configuration Method]、[Task Resources]、[VPC Configuration]、[Internet gateway] を設定します。
-
カスタムデータセット評価
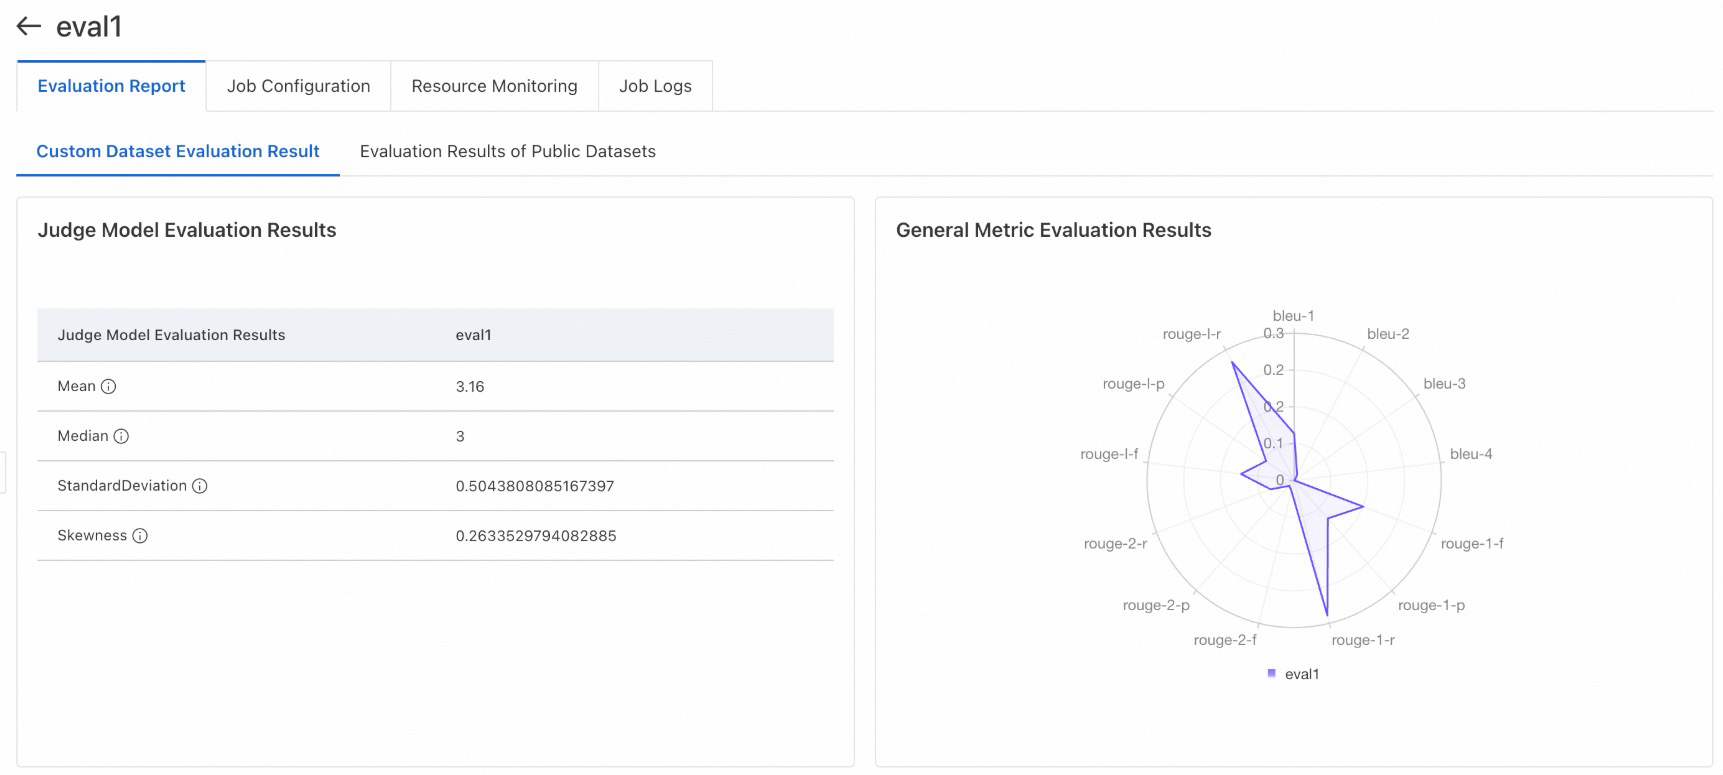
モデル評価は、BLEU や ROUGE などの一般的な NLP テキストマッチング指標に加えて、ジャッジモデル評価もサポートします。この機能は [professional mode] でのみ利用できます。ジャッジ LLM を使用して別の LLM を評価し、スコアと理由付けを提示します。シナリオ固有のデータを使用して、選択したモデルが適しているかどうかを判断できます。
評価には JSONL 形式の評価セットファイルが必要です。各行は JSON オブジェクトです。質問列は
questionで、回答列はanswerで識別します。ファイル例:evaluation_test.jsonl。 -
パブリックデータセット評価
ドメイン別にグループ化されたオープンソースの評価データセットを使用して、大規模モデルを包括的に評価します。PAI は現在、CMMLU、GSM8K、TriviaQA、MMLU、C-Eval、TruthfulQA、HellaSwag などのデータセットを提供しており、数学、知識、理由付けなど複数の分野をカバーしています。パブリックデータセットは定期的に追加されます。注意:GSM8K、TriviaQA、HellaSwag の評価は時間がかかります。必要な場合のみ選択してください。
次に、評価結果の出力パスを選択し、推奨されるコンピューティングリソースを選択して、評価タスクを送信します。タスクが完了したら、タスクページで評価結果を確認します。複数のデータセットを選択した場合、モデルがそれらを順番に評価するため、待ち時間が長くなることがあります。ログを確認して、タスクの進捗を把握できます。
評価レポートを確認します:次の画像は、カスタムデータセットおよびパブリックデータセットの評価結果の例を示しています。
お問い合わせ
PAI-モデルギャラリーをぜひご利用ください。プラットフォームには SOTA モデルを継続的に追加しています。ご要望のモデルがありましたら、お気軽にお問い合わせください。DingTalk グループ番号 79680024618 を検索して、PAI-モデルギャラリーのユーザーコミュニティに参加できます。