因子分解マシン (FM) アルゴリズムは、特徴量の相互作用を組み込んだ非線形モデルであり、E コマース、広告、ライブストリーミングにおけるレコメンデーションシナリオに適しています。Platform for AI (PAI) のビジュアルモデリング (デザイナー) には、Alink フレームワークに基づいて FM レコメンデーションモデルを構築するための、プリセットの FM アルゴリズムテンプレートが用意されています。
手順
Machine Learning Designerページに移動します。
PAIコンソールにログインします。
左側のナビゲーションウィンドウで、[ワークスペース] をクリックします。 [ワークスペース] ページで、管理するワークスペースの名前をクリックします。
左側のナビゲーションウィンドウで、を選択します。
-
パイプラインを作成します。
-
[ビジュアルモデリング (デザイナー)] ページで、[Preset Templates] タブをクリックします。
-
このタブで、[Alink]FM-Embedding for Rec-System テンプレートを見つけて [Create] をクリックします。
-
ワークフローの新規作成 ダイアログボックスで、パラメーターを設定します。すべてのパラメーターにデフォルト設定を使用できます。
ワークフローデータストレージ パラメーターには、パイプラインの実行中に生成される一時データとモデルを格納する OSS バケットのパスを指定します。
-
OK をクリックします。
パイプラインの作成には約 10 秒かかります。
-
[Pipelines] タブで、作成したパイプラインをクリックします。右側の [Basic Information] セクションで、[Open] をクリックします。
パイプライン設定タブでは、キャンバス上で作成されたパイプラインを表示できます。

このパイプラインは、Alink アルゴリズムによる FM のトレーニングと予測のために、2 つの手法をサポートしています:
-
手法 1:[FM Train] コンポーネントと [FM Prediction] コンポーネントを使用して、FM のトレーニングと予測を実行します。
[FM Train] と [FM Prediction] は、紫色の点でマークされた Alink コンポーネントであり、グループで実行できます。グループ実行の詳細については、「Alink コンポーネント」をご参照ください。
-
手法 2:PyAlink コンポーネントを使用して、FM のトレーニングと予測を実行します。
カスタム PyAlink コンポーネントは、Python コードを通じて手法 1 と同じ結果が得られます。サポートされているオペレーターについては、「Alink の概要」をご参照ください。
-
-
-
[FM Train-1] ノードのパラメーターを設定します。
-
キャンバス上の [FM Train-1] ノードをクリックします。
-
右側のパネルの [Fields Setting] タブで、次の表で説明するパラメーターを設定します。
パラメーター
説明
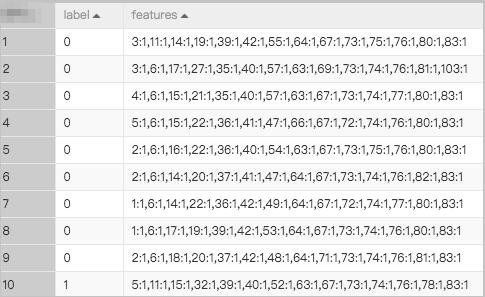
[特徴列]
特徴列の名前です。特徴列のデータは
key:value形式です。特徴列内の複数のキーと値のペアは、カンマ (,) で区切られます。[ラベル列]
ラベル列の名前です。ラベル列は
DOUBLEデータ型である必要があります。ビジュアルモデリング (デザイナー) で提供される FM アルゴリズムは、LIBSVM 形式のデータのみをサポートしています。ワンホットエンコーディングコンポーネントを使用すると、別の形式のデータを LIBSVM 形式に変換できます。詳細については、「ワンホットエンコーディング」をご参照ください。入力データには、次の図に示すように、特徴列とラベル列を含める必要があります。
-
右側のパネルの [Parameters Setting] タブと [Tuning] タブで、トレーニングパラメーターを設定します。
サンプル数が 1 億 2000 万、特徴量が 130 万のパイプラインでは、次の表の推奨値を使用し、他のパラメーターはデフォルトのままにしてください。これらの値は、データ量に応じて調整してください。
タブ
パラメーター
説明
[Parameters Setting]
[Learning rate]
学習率です。推奨値:0.005。トレーニングが発散する場合は、このパラメーターをより小さい値に設定してください。
[Dimensions]
次元数です。推奨値:1,1,16。
[Block size]
-
ブロックのサイズです。特徴量データレコードが 200 万件未満の場合は、このパラメーターを 1000000 に設定することを推奨します。
-
特徴量データレコードが 200 万件以上の場合は、このパラメーターを設定する必要はありません。
[Tuning]
[Number of Workers]
使用するワーカー数です。推奨値:32。大量のデータを扱う場合は、このパラメーターをより大きい値に設定してください。
[Memory Size per Node (MB)]
各ノードに割り当てるメモリサイズです。推奨値:16384。単位:MB。
-
-
-
PyAlink FM トレーニングノードと PyAlink FM 予測ノードのコードを記述します。
-
PyAlink FM トレーニングノードのコードを記述します。
from pyalink.alink import * def main(sources, sinks, parameter): print('start') # Alink アルゴリズムを呼び出すモード 1。 # train = HugeFmTrainBatchOp().setVectorCol('features').setLabelCol('label').linkFrom(sources[0]) # Alink アルゴリズムを呼び出すモード 2。 train = HugeFmTrainBatchOp( vectorCol='features', labelCol='label', task='binary_classification', numEpochs=10) # 入力ポート 0 からトレーニングデータを取得します。トレーニング済みモデルは出力ポート 0 から生成され、ダウンストリームに渡されます。 sources[0].link(train).link(sinks[0]) BatchOperator.execute() print('end') -
PyAlink FM 予測ノードのコードを記述します。
from pyalink.alink import *

def main(sources, sinks, parameter):
    predictor = HugeFmPredictBatchOp().setPredictionCol("prediction_result")\
    .setPredictionDetailCol("prediction_detail").setReservedCols(["label"])
    output = predictor.linkFrom(sources[0], sources[1])
    # 予測結果は最初の出力ポートから生成され、ダウンストリームに渡されます。
    output.link(sinks[0])
    BatchOperator.execute()
    print('predict end')
-
-
キャンバスの左上隅にある [Run] アイコンをクリックします。
-
パイプラインの実行後、キャンバス上の [二項分類評価] ノードを右クリックし、[可視化分析] を選択します。
[Alink]FM-Embedding for Rec-System テンプレートデータを使用すると、FM アルゴリズムでは曲線下面積 (AUC) が 0.92 に近い値になります。
-
手法 1 を使用して生成された評価レポート

-
手法 2 を使用して生成された評価レポート

-