PageRank アルゴリズムは、ウェブページの重要度を測定します。 このアルゴリズムは、ページへのリンクの数と質がその重要度を決定するという考えに基づき、ハイパーリンクを分析します。 被リンクが多いページほど、ランキングは高くなります。 リンク元ページの重みも、最終的な PageRank スコアに影響します。 PageRank コンポーネントは、各ノードの重みを出力します。
アルゴリズムの説明
PageRank アルゴリズムは、ウェブページの相対的な重要度を評価するために使用されるリンク分析手法です。 その中心的な原則は次のとおりです。
他の多くのウェブページからリンクされているウェブページは、一般的により重要、または高品質なリソースと見なされます。
このアルゴリズムは、被リンクの数だけでなく、各リンク元ページの重みも考慮します。 この重みは、リンク元ページ自身の PageRank スコアと、そのページのアウトバウンドリンクの数に基づいています。
PageRank の概念は、ソーシャルネットワークにも適用されます。 ユーザーの影響力は、そのユーザー個人の属性とソーシャルコネクションの質に依存します。 たとえば、Sina Weibo では、ユーザーがフォロワーに与える影響は、関係の近さによって決まります。 通常、ユーザーは家族、クラスメート、同僚に対してより大きな影響力を持ちます。 このネットワークモデルでは、エッジの重みが関係の近さを反映し、その強さを示します。
リンクの重みを考慮した PageRank の計算式は次のとおりです。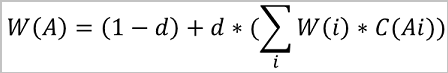
W(i):ノード i の重み。
C(Ai):リンクの重み。
d:減衰係数。
W(A):アルゴリズムが収束した後のノードの重み。 これは各ユーザーの影響力指数を表します。
コンポーネントの設定
方法1:可視化による設定
Designer ワークフローで、[PageRank] コンポーネントを追加し、インターフェイスの右側でパラメーターを設定します。
パラメータータイプ | パラメーター | 説明 |
フィールド設定 | ソース頂点列 | エッジリストのソース頂点を含む列。 |
宛先頂点列 | エッジリストの宛先頂点を含む列。 | |
エッジの重み列 | エッジの重みを含む列。 | |
パラメーター設定 | 最大反復回数 | アルゴリズムが収束すると反復を停止します。 デフォルト値は 30 です。 |
減衰係数 | ユーザーがウェブページに到達した後、閲覧を続ける確率。 | |
実行チューニング | プロセス数 | 並列ジョブ実行のためのノード数。 値を大きくすると並列度は高くなりますが、フレームワークの通信オーバーヘッドが増加します。 |
ワーカーごとのメモリサイズ | 単一ジョブの最大メモリサイズ。 単位:MB。 デフォルト値は 4096 です。 実際のメモリ使用量がこの値を超えると、 |
方法2:PAI コマンドの使用
PAI コマンドを使用して、SQL スクリプトコンポーネントからコマンドを呼び出すことで、[PageRank] コンポーネントのパラメーターを設定できます。 詳細については、「シナリオ 4:SQL スクリプトコンポーネントでの PAI コマンドの実行」をご参照ください。
PAI -name PageRankWithWeight
    -project algo_public
    -DinputEdgeTableName=PageRankWithWeight_func_test_edge
    -DfromVertexCol=flow_out_id
    -DtoVertexCol=flow_in_id
    -DoutputTableName=PageRankWithWeight_func_test_result
    -DhasEdgeWeight=true
    -DedgeWeightCol=weight
    -DmaxIter=100;
パラメーター | 必須 | デフォルト値 | 説明 |
inputEdgeTableName | はい | なし | 入力エッジリストのテーブル名。 |
inputEdgeTablePartitions | いいえ | フルテーブルスキャン | 入力エッジリストのパーティション。 |
fromVertexCol | はい | なし | 入力エッジリストのソース頂点を含む列。 |
toVertexCol | はい | なし | 入力エッジリストの宛先頂点を含む列。 |
outputTableName | はい | なし | 出力テーブルの名前。 |
outputTablePartitions | いいえ | なし | 出力テーブルのパーティション。 |
lifecycle | いいえ | なし | 出力テーブルのライフサイクル。 |
workerNum | いいえ | 未設定 | 並列ジョブ実行のためのノード数。 値を大きくすると並列度は高くなりますが、フレームワークの通信オーバーヘッドが増加します。 |
workerMem | いいえ | 4096 | 単一ジョブの最大メモリサイズ。 単位:MB。 デフォルト値は 4096 です。 実際のメモリ使用量がこの値を超えると、 |
splitSize | いいえ | 64 | データチャンクのサイズ。 単位:MB。 |
hasEdgeWeight | いいえ | false | 入力エッジリストのエッジに重みがあるかどうかを指定します。 |
edgeWeightCol | いいえ | なし | 入力エッジリストのエッジの重みを含む列。 |
maxIter | いいえ | 30 | 最大反復回数。 |
例
SQL スクリプトコンポーネントを追加します。 [Use Script Mode] と [System Adds Create Table Statement] のチェックを外し、[SQL Script] フィールドに次の SQL 文を入力します。
drop table if exists PageRankWithWeight_func_test_edge;
create table PageRankWithWeight_func_test_edge as
select * from
(
    select 'a' as flow_out_id,'b' as flow_in_id,1.0 as weight
    union all
    select 'a' as flow_out_id,'c' as flow_in_id,1.0 as weight
    union all
    select 'b' as flow_out_id,'c' as flow_in_id,1.0 as weight
    union all
    select 'b' as flow_out_id,'d' as flow_in_id,1.0 as weight
    union all
    select 'c' as flow_out_id,'d' as flow_in_id,1.0 as weight
)tmp;
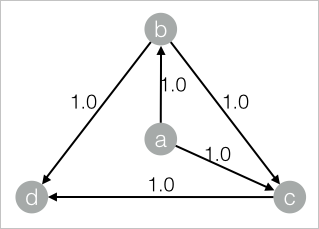
対応するデータ構造グラフを以下に示します:
別の SQL スクリプトコンポーネントを追加します。 [Use Script Mode] と [System Adds Create Table Statement] のチェックを外します。 [SQL Script] フィールドに次の PAI コマンドを入力します。 手順 1 のコンポーネントをこのコンポーネントに接続します。
drop table if exists ${o1};
PAI -name PageRankWithWeight
    -project algo_public
    -DinputEdgeTableName=PageRankWithWeight_func_test_edge
    -DfromVertexCol=flow_out_id
    -DtoVertexCol=flow_in_id
    -DoutputTableName=${o1}
    -DhasEdgeWeight=true
    -DedgeWeightCol=weight
    -DmaxIter=100;
左上隅の
 をクリックしてワークフローを実行します。
ワークフローが完了したら、手順 2 のコンポーネントを右クリックし、[View Data > Output of SQL Script] を選択してトレーニング結果を表示します。
| node | weight     |
| ---- | ---------- |
| a    | 0.12841452 |
| b    | 0.18299069 |
| c    | 0.26076174 |
| d    | 0.42783305 |