DLC の使用時によくある問題の解決策を紹介します。
はじめに Xiao PAI に質問
PAI AI アシスタント (Xiao PAI) は、すべての PAI 製品に関する詳細なガイダンスとステップバイステップの手順を提供します。DSW インスタンス、DLC ジョブ、EAS サービスを診断し、障害の原因を自動的に特定して次のステップを推奨できます。
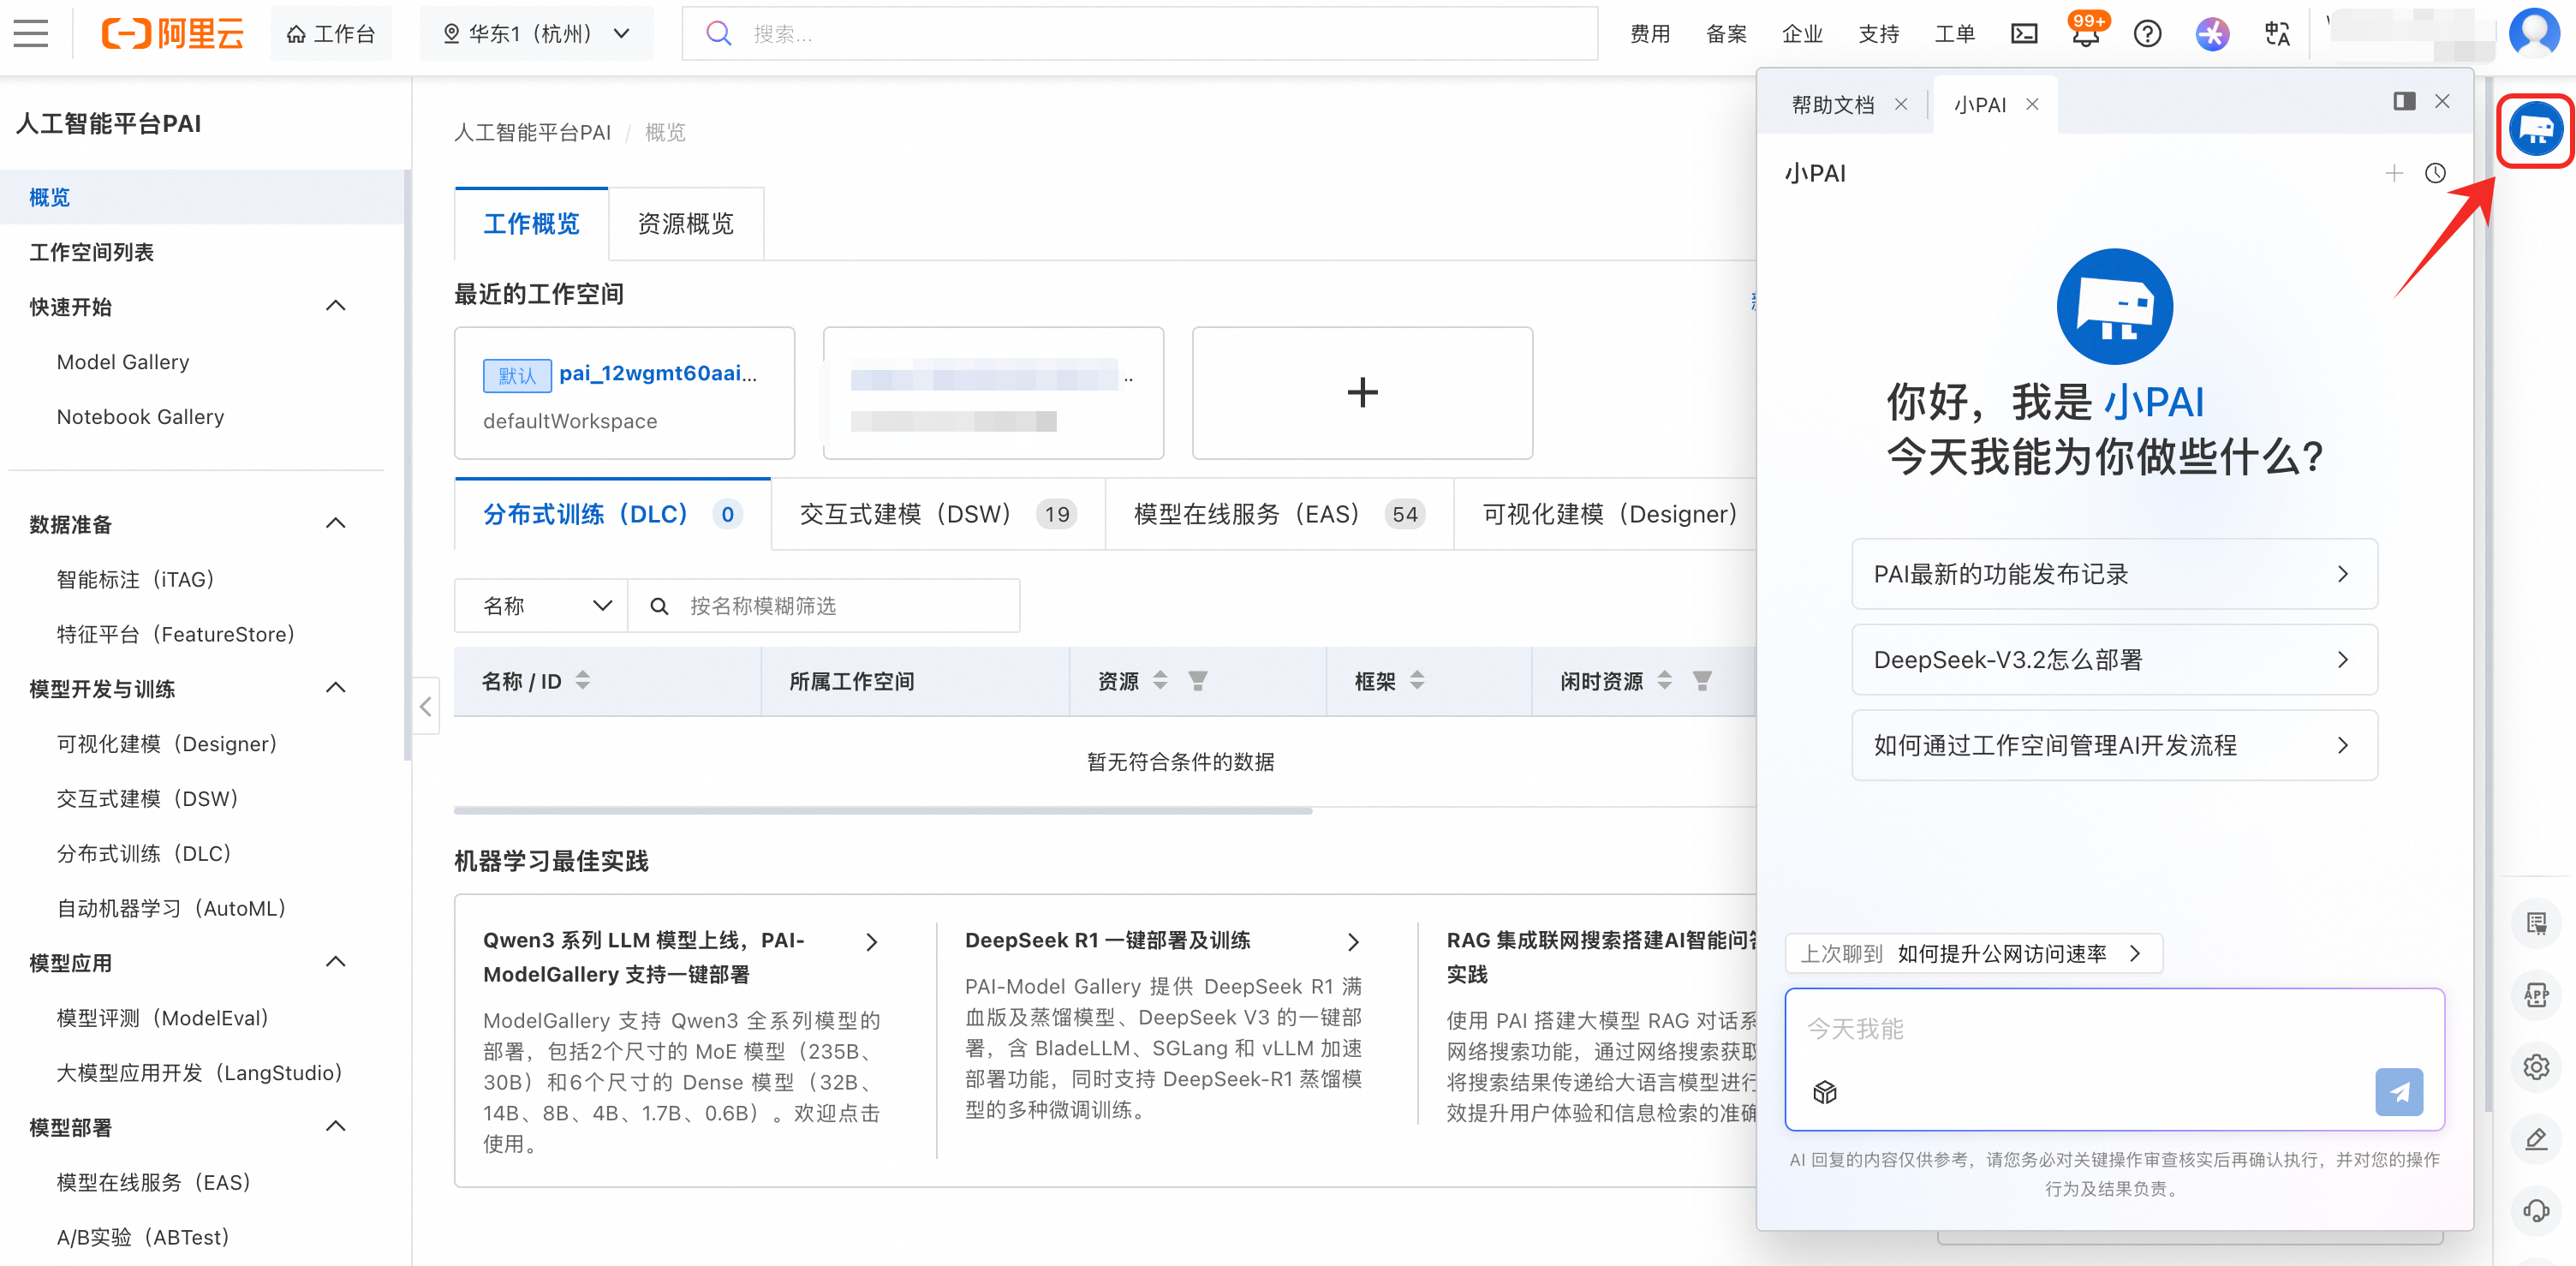
Q:DLC ジョブが長時間キューイングされていますが、リソースモニタリングでは全体的なキャパシティは十分です。この問題のトラブルシューティング方法を教えてください。
リソースモニタリングページにはリソースプールの合計クォータが表示されますが、スケジューラは個々のノードで利用可能なリソースに基づいてリソースを割り当てます。クラスターに十分な合計リソースがある場合でも、単一のノードがジョブで要求されるリソースの組み合わせ (CPU + GPU など) を完全に満たせない場合、ジョブはキューイングされたままになります。
以下の一般的な原因を確認してください:
1. リソースの断片化 (最も一般的な原因)
-
症状:GPU リソースは少数のノードに集中していますが、それらのノードの CPU やメモリは他のジョブによってすでに消費されています。これらのノードの残りのリソースでは、キューイングされているジョブが必要とする CPU と GPU の組み合わせを満たすことができません。
-
解決策:優先度の低いジョブをいくつか停止してノードリソースを解放し、対象のジョブを再送信します。または、ジョブが要求する CPU スペックを減らし、断片化したリソースの可用性に合わせます。
2. 要求された単一ノードのリソーススペックが大きすぎる
-
症状:ジョブがノードごとに要求するリソーススペック (CPU コア数やメモリなど) が、リソースグループ内のすべてのノードの実際の利用可能キャパシティを超えています。
-
解決策:リソースグループ内の各ノードの実際の構成を確認します。ノードごとのリソーススペック (たとえば、より少ない CPU コア数) を減らし、ジョブがスケジュールされるかどうかを確認してください。
3. 同時実行ジョブの競合と優先度の問題
-
症状:複数のジョブが同じリソースプールをめぐって競合しており、優先度の低いジョブは優先度の高いジョブがリソースを解放するのを待つ必要があります。
-
解決策:ジョブの優先度を適切に設定します。緊急でないジョブはオフピーク時に送信してください。
4. エラーコードリファレンス
-
ジョブが
Resource queue timeout, lack of sufficient resourcesを報告した場合、集計された合計値に頼るのではなく、リソースグループ内の各ノードで実際に利用可能な CPU/GPU の数を確認してください。
Q:モデルトレーニングが「SupportsDistributedTraining false, please set InstanceCount=1」というエラーで失敗します
-
原因:トレーニングジョブが複数のインスタンス (ノード数が 1 より大きい) を使用するように設定されていますが、モデルが分散トレーニングをサポートしていません。
-
解決策:ノード数を 1 に設定してください。
Q:モデルトレーニングが「failed to compose dlc job specs, resource limiting triggered, you are trying to use more GPU resources than the threshold」というエラーで失敗します
トレーニングジョブは、同時に実行できる GPU ユニットが最大 2 つに制限されています。このしきい値を超えると、リソース制限がトリガーされます。新しいトレーニングジョブを開始する前に、実行中のトレーニングジョブが終了するのを待つか、チケットを送信してクォータの引き上げをリクエストしてください。
Q:ジョブがエラーコード 137 で終了しました。どうすればよいですか。
Linux におけるエラーコード 137 は、プロセスが SIGKILL シグナルによって強制終了されたことを意味します。最も一般的な原因は、メモリ不足 (OOM) エラーとしても知られる過剰なメモリ使用量です。
このエラー (例:「xxx exited with code 137」) が発生した場合は、ジョブのワーカー詳細に表示されるメモリ使用率を確認してください。調査結果に基づいて、以下の 1 つ以上を試してください:
-
より多くのメモリを持つインスタンスタイプに切り替えます。
-
ワーカーの数を増やします。
-
コード内のメモリ割り当てを減らします。
Q:DLC ジョブのステータスが「Failed」と表示された場合、どうすればよいですか。
DLC ジョブの実行は、次のステータスシーケンスに従います:
|
ジョブタイプ |
ステータスシーケンス |
|
|
従量課金リソースのジョブ |
Lingjun スポットリソースの使用 |
|
|
Lingjun または汎用パブリックリソースの使用 |
|
|
|
サブスクリプションリソースのジョブ |
|
|
-
ジョブのステータスが「環境準備中」の場合の対処法
ジョブが長時間 環境準備中 のままである場合、分散トレーニングジョブで CPFS データセットを使用しているにもかかわらず VPC が設定されていないことが原因と考えられます。CPFS データセットを設定し、VPC を追加してジョブを再作成してください。選択した VPC が、CPFS で使用されている VPC と一致することを確認してください。詳細については、「トレーニングジョブの作成」をご参照ください。
-
ジョブのステータスが「失敗」の場合の対処法
ジョブ詳細ページで、ジョブステータスの横にある
 アイコンにカーソルを合わせるか、インスタンス操作ログを確認して、最初の失敗原因を特定してください。詳細については、「トレーニングジョブの詳細の表示」をご参照ください。
環境準備フェーズが完了した直後にジョブが失敗した場合、ジョブ詳細ページのユーザーログが空になることがあります。これは、マシンから DLC コンソールへのログの同期がまだ行われていないためです。
トラブルシューティングを行うには:
-
[Logs] タブで、ログ収集の時間範囲を広げ、ジョブ ID をキーワードとして使用してログイベントを検索してください。
-
Simple Log Service (SLS) のログ転送を設定している場合は、DLC ジョブ ID をキーワードとして使用して SLS で実際のエラーを検索してください。
起動コマンドの前に
sleep 10を追加することは、ログが同期する時間を確保できるため、ジョブコマンド自体が stdout/stderr 出力を生成する場合にのみ有効です。exit 1のような出力のないコマンドの場合、sleepを追加しても、同期するログは生成されません。 -
Q:DLC ジョブをパブリックリソースから専用リソースに切り替えることはできますか。
リソースタイプを切り替えるには、新しいジョブを作成する必要があります。元のジョブの [Actions] 列で [Clone] をクリックし、元の設定を再利用する新しいジョブを作成してください。これにより、すべてのパラメータを再入力する必要がなくなります。課金の詳細については、「DLC の課金」をご参照ください。
Q:DLC でマルチノード、マルチ GPU のトレーニングを設定するにはどうすればよいですか。
マルチノード、マルチ GPU のトレーニングを有効にするには、DLC ジョブの作成時に次の起動コマンドを追加してください。完全な設定の詳細については、「トレーニングジョブの作成」をご参照ください。
python -m torch.distributed.launch \ --nproc_per_node=2 \ --master_addr=${MASTER_ADDR} \ --master_port=${MASTER_PORT} \ --nnodes=${WORLD_SIZE} \ --node_rank=${RANK} \ train.py --epochs=100Q:トレーニング済みのモデルを PAI-DLC からローカルマシンにダウンロードするにはどうすればよいですか。
DLC ジョブを送信するときは、データセットをアタッチし、マウントされたデータセットディレクトリにトレーニング出力を書き込むように起動コマンドを設定します。ジョブの [環境] 設定で、カスタムデータセットを追加し、[マウントパス] を /mnt/data/ に設定します。次に、[起動コマンド] で cp -r ./output /mnt/data を実行して、モデルファイルをマウントされたデータセットディレクトリにコピーします。
トレーニングが完了すると、モデルファイルはマウントされたデータセットディレクトリに保存されます。データセットに関連付けられたファイルシステムにアクセスし、ファイルをローカルマシンにダウンロードしてください。
-
DLC ジョブを送信する際にデータセットをアタッチする方法については、「トレーニングジョブの作成」をご参照ください。
-
OSS ファイルシステムからローカルマシンにファイルをダウンロードする方法については、「コンソールクイックスタート」をご参照ください。
-
NAS ファイルシステムからローカルマシンにファイルをダウンロードする方法については、「Function Compute 関数へのファイルシステムのマウント」をご参照ください。
Q:DLC で Docker イメージを使用するにはどうすればよいですか。
-
Docker イメージを使用して DLC ジョブを作成する:Docker イメージを Alibaba Cloud Container Registry (ACR) にプッシュし、それをカスタムイメージとして PAI ワークスペースに追加してください。その後、DLC ジョブを作成する際にそのイメージを選択できます。
-
Docker イメージを ACR にプッシュする方法については、「パーソナル版インスタンスでのイメージのプッシュとプル」をご参照ください。
-
PAI にカスタムイメージを追加する方法については、「カスタムイメージ」をご参照ください。
-
-
DLC コンテナ内で Docker をインストールして使用する:DLC ジョブはコンテナ内で実行されるため、DLC コンテナ内での Docker のインストールや実行はサポートされていません。
Q:DLC ジョブの一部のノードが早期に終了します。そのリソースを他のジョブのために解放するにはどうすればよいですか。
背景:
マルチワーカーの分散 DLC ジョブでは、データの偏りなどの理由で、ワーカーが異なる時間に終了することがあります。デフォルトでは、完了したワーカーはジョブ全体が終了するまで割り当てられたノードを保持し続けます。
解決策: ReleaseResourcePolicy 高度なパラメーターを設定します。 デフォルトでは、ジョブ全体が完了するまでリソースは保持されます。 このパラメーターを pod-exit に設定すると、各ワーカーが終了するとすぐにそのリソースが解放されます。
Q:DLC ジョブが「OSError: [Errno 116] Stale file handle」というエラーで失敗します。
背景:
複数のワーカーで PyTorch の torch.compile (AOT コンパイル) を実行中に、このエラーが発生します。このエラーは、サーバー側でファイルが削除または移動されたことで、プロセスが保持するファイルハンドルが無効になった場合に発生します。
根本原因:
PyTorch の AOT コンパイルは、最適化された計算グラフをファイルシステム (デフォルト: /tmp、通常はローカルの tmpfs) にキャッシュします。クラスター環境では、このキャッシュは CPFS (NFS 経由でマウントされた分散ファイルシステム) に配置されることがあります。NFS はファイルの削除の影響を受けやすく、次の条件により stale file handle が発生します。
-
PyTorch が古いキャッシュエントリを自動的にクリーンアップするか、別のプロセスがキャッシュディレクトリを削除した場合。
-
NFS サーバーがファイルを移動、削除、または権限を変更したが、クライアントはまだ古いハンドルを保持している場合。
-
NFS クライアントはデフォルトでファイル属性をキャッシュするため、クライアントがサーバー側の変更を検出しない場合があります。
これらの条件は、マルチワーカージョブで発生しやすくなります。CPFS は NFS ベースであり、特に短命のキャッシュファイルに対して、高並行性アクセス下で無効なファイルハンドルが発生しやすいためです。複数のワーカーが同時にキャッシュの読み取り、書き込み、またはクリーンアップを行うと、競合状態が発生する可能性があります。
主な解決策:
-
環境変数
TORCHINDUCTOR_CACHE_DIR=/dev/shm/torch_cacheを設定して、キャッシュにローカル tmpfs を強制的に使用させます。
代替の解決策:
-
公式の PyTorch ドキュメントに従い、共有キャッシュバックエンドとして Redis を使用します (Redis サービスが必要です)。
-
CPFS の NFS マウントオプションを調整します (
noacオプションは無効なファイルハンドルの発生を減らす可能性がありますが、パフォーマンスに影響を与えることがあります)。 -
TORCHINDUCTOR_CACHE_DIR=""を設定してキャッシュを無効にします。これによりエラーは解消されますが、コンパイルのパフォーマンス上の利点も失われます。
Q:/mnt/data へのアクセスが「Transport endpoint is not connected」というエラーで失敗します
背景:
DLC ジョブの開始後、起動コマンドでマウントされたデータセットのパス (/mnt/data など) にアクセスすると、Transport endpoint is not connected というエラーで失敗します。このエラーは、NFS マウントポイントが切断されたことを示しています。
一般的な原因:
-
CPFS VPC の不一致:CPFS データセットを使用する場合、トレーニングジョブの VPC は CPFS ファイルシステムの VPC と一致する必要があります。不一致があるとマウントが失敗します。
-
データセットが準備できていない:AI アセット管理を通じて作成されたデータセットがまだ初期化中の可能性があります。
-
不正なマウントパス:ジョブで設定されたマウントパスが、データセットの実際のマウントポイントと一致していません。
解決策:
-
AI アセット管理で、データセットのステータスが「利用可能」であることを確認してください。
-
CPFS データセットを使用している場合:トレーニングジョブを作成する際に、設定する VPC が CPFS ファイルシステムの VPC と一致することを確認してください。VPC の設定詳細については、「トレーニングジョブの作成」をご参照ください。
-
ジョブログで
ls -la /mnt/dataを実行し、マウントがアクセス可能であることを確認します。 -
OSS データセットを使用している場合:互換性を高めるために、データセットマウントの代わりにストレージマウントを使用してください。
Q:DLC ジョブが「Unable to attach or mount volumes」というエラーで「環境準備中」のままになります
背景:
起動中、DLC ジョブがネットワーク初期化または環境準備フェーズで停止 (スタック) します。ログには次のエラーが表示されます:
Unable to attach or mount volumes: unmounted volumes=[hostpath-volume], unattached volumes=[...]: timed out waiting for the condition一般的な原因:
-
ノードのディスク容量不足:計算ノードのローカルディスクがいっぱいのため、hostpath-volume をマウントできません。
-
ストレージバックエンドの問題:NAS、CPFS、または OSS ストレージで一時的な障害または接続タイムアウトが発生しています。
-
ノードリソースの競合:複数のジョブが同時に同じノードにスケジュールされ、ボリュームマウント操作がキューで待機中にタイムアウトします。
解決策:
-
ジョブを再送信する:ほとんどの場合、これは一時的な問題であり、ジョブを再送信することで解決できます。
-
ストレージの接続性を確認する:データセットに関連付けられている NAS、CPFS、または OSS サービスが正常であり、VPC とセキュリティグループの設定が正しいことを確認してください。
-
問題が解決しない場合は、Alibaba Cloud テクニカルサポートに連絡し、ジョブ ID と完全なエラーログを添付してください。