事前にクラスター数を定義することなく、密度に基づいてデータをクラスタリングします。任意の形状のクラスターを検出し、外れ値を特定します。
点の分類
DBSCAN は、各データポイントを次の 3 つのカテゴリのいずれかに割り当てます:
コアポイント:epsilon 半径内に少なくとも minPoints 個の近傍点があります。クラスターの基盤を形成します。
境界ポイント:コアポイントの epsilon 半径内にありますが、近傍点の数が minPoints 未満です。クラスターに属しますが、クラスターを拡張しません。
ノイズポイント (外れ値):コアポイントではなく、いずれのコアポイントの epsilon 半径内にもありません。どのクラスターにも属しません。クラスター ID 2147483648 (2^31) が割り当てられます。
クラスターは、密度接続されたポイントの極大集合です。2 つのコアポイントは、互いの距離が epsilon 以内であり、直接、またはコアポイントの連鎖を介して到達できる場合に密度接続されます。
設定
次のパラメーターを使用して DBSCAN を設定します。
タブ | パラメーター | 説明 |
[フィールド設定] | [idCol] | ID 列名。 |
[vectorCol] | クラスタリングの特徴データを含むベクター列。 | |
[パラメーター設定] | [epsilon] | 近傍と見なす 2 点間の最大距離です。値を小さくすると、より多くの、より密なクラスターが生成されます。値を大きくすると、近接するクラスターが結合されます。付録 1:リソース使用量の見積もりをご参照ください。 |
[minPoints] | ポイントをコアポイントと見なすために、その [epsilon] 近傍内に必要となるデータポイントの最小数です。値を大きくすると、より高密度なクラスターが生成され、より多くのポイントがノイズとして分類されます。付録 1:リソース使用量の見積もりをご参照ください。 | |
[predictionCol] | 予測結果列名です。各データポイントに割り当てられたクラスター ID を格納します。 | |
[distanceType] | クラスタリングに使用する距離メトリックです。デフォルト値は [EUCLIDEAN] です。サポートされている値は次のとおりです:
| |
[実行チューニング] | [ワーカー数] | 分散実行に使用するワーカー数です。正の整数である必要があります。有効な値:1 ~ 9,999。付録 1:リソース使用量の見積もりをご参照ください。 |
[ワーカーあたりのメモリ、単位 MB] | ワーカーあたりのメモリ (MB) です。有効な値:1,024 ~ 65,536 (64 x 1,024)。付録 1:リソース使用量の見積もりをご参照ください。 |
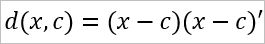

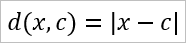
付録 1:リソース使用量の見積もり
各ノードのメモリサイズを見積もるにはどうすればよいですか?
入力データサイズに 15 を掛けて、各ノードのメモリサイズを算出します。
例:入力データサイズが 1 GB の場合、各ノードのメモリサイズは 15 GB に設定できます。ノード数を見積もるにはどうすればよいですか?
通信オーバーヘッドの影響により、ノード数が増えるにつれて分散トレーニングタスクの速度は最初は向上しますが、その後低下します。ノードを追加した後にトレーニング速度が低下する場合は、ノード数の増加を止めてください。このアルゴリズムはどの程度のデータをサポートしますか?
このアルゴリズムは、100 万件 (サンプル) 未満のデータサイズ、および 200 次元未満をサポートします。説明データサイズがこの上限を超える場合は、先にデータをパーティション (グループ化) し、各グループに対して個別に DBSCAN アルゴリズムを実行することを推奨します。
外れ値のクラスター ID が 2147483648 なのはなぜですか?
このデータポイントは外れ値であり、どのクラスターにも属さないためです。
付録 2:パラメーターの設定方法
DBSCAN コンポーネントで最も一般的に使用される 2 つのパラメーターは、minPoints (近傍内の最小サンプル数のしきい値) と epsilon (近傍距離のしきい値) です。チューニングのガイドラインは次のとおりです:
クラスター数を減らす (クラスターが多すぎる場合):まず minPoints を増やし、その後 epsilon を減らすことを推奨します。
クラスター数を増やす (クラスターが少なすぎる場合):まず minPoints を減らし、その後 epsilon を増やすことを推奨します。