機械学習において、データピボットアルゴリズムは、データセットの可視化と探索的データ分析のためのメソッドです。チャート、テーブル、その他の可視化ツールを使用して、データの構造、ディストリビューション、関係性を明らかにし、ユーザーが特徴を理解し、パターンを特定し、異常を発見するのに役立ちます。このアルゴリズムは、後続のモデリングと分析の指針となるため、データの前処理および特徴量エンジニアリングの段階で非常に重要です。
コンポーネントの構成
方法1:コンソールを使用
ビジュアルモデリングで、[データピボット] コンポーネントをパイプラインに追加し、右側のペインでそのパラメーターを構成します。
|
パラメータータイプ |
パラメーター |
説明 |
|
フィールド設定 |
特徴列 |
可視化と分析に使用する特徴列を指定します。コンポーネントは、それらのディストリビューションと関係性をチャートやテーブルに表示します。 |
|
ターゲット列 |
予測または分析のためのターゲット変数 (通常はラベルまたは応答変数) を指定します。 |
|
|
列挙型特徴量 |
選択した特徴を列挙型特徴量として扱います。 |
|
|
k:v、k:v スパースデータ形式 |
キーと値のペア形式のスパースデータを使用するかどうかを指定します。 |
|
|
パラメーター設定 |
連続特徴量のビン数 |
可視化と分析のために、連続特徴量を分割する離散的な間隔 (ビン) の数を指定します。 |
|
チューニング |
コア数 |
計算に使用するコア数。正の整数である必要があります。 |
|
コアあたりのメモリ |
各コアのメモリ量 (MB) 。値は 1 から 65536 までの整数である必要があります。 |
方法2:PAI コマンドを使用
SQL スクリプトコンポーネントで PAI コマンドを実行することで、[データピボット] コンポーネントのパラメーターを構成できます。詳細については、「シナリオ 4:SQL スクリプトコンポーネントで PAI コマンドを実行」をご参照ください。
PAI
-name fe_meta_runner
-project algo_public
-DinputTable="pai_dense_10_10"
-DoutputTable="pai_temp_2263_20384_1"
-DmapTable="pai_temp_2263_20384_2"
-DselectedCols="pdays,previous,emp_var_rate,cons_price_idx,cons_conf_idx,euribor3m,nr_employed,age,campaign,poutcome"
-DlabelCol="y"
-DcategoryCols="previous"
-Dlifecycle="28"-DmaxBins="5" ;|
パラメーター |
必須 |
デフォルト |
説明 |
|
inputTable |
はい |
なし |
入力テーブルの名前。 |
|
inputTablePartitions |
いいえ |
なし |
トレーニングに使用する入力テーブルのパーティション。次のフォーマットがサポートされています:
説明
単一のパーティションキーに複数の値を指定するには、値をカンマ (,) で区切ります。例:name1=value1,value2。 |
|
outputTable |
はい |
なし |
出力テーブルの名前。 |
|
mapTable |
はい |
なし |
出力マッピングテーブル。機械学習のトレーニング用にデータを準備するため、データピボットは STRING 型の特徴の統計を収集し、それらを整数 ID にマッピングします (ラベルエンコーディング)。 |
|
selectedCols |
はい |
なし |
入力テーブルから選択する列の名前。 |
|
labelCol |
いいえ |
なし |
ラベル列。 |
|
categoryCols |
いいえ |
なし |
列挙型特徴量として扱う数値 (INT または DOUBLE) 型の列を指定します。 |
|
maxBins |
いいえ |
100 |
連続特徴量の等距離離散化のための最大間隔数を指定します。 |
|
isSparse |
いいえ |
false |
入力データがスパースフォーマットであるかどうかを指定します。有効な値は true と false です。 |
|
itemSpliter |
いいえ |
カンマ (,) |
入力データがスパースフォーマットの場合に、キーと値のペアを区切るデリミタを指定します。 |
|
kvSpliter |
いいえ |
コロン (:) |
入力データがスパースフォーマットの場合に、キーと値を区切るデリミタを指定します。 |
|
lifecycle |
いいえ |
28 |
テーブルのライフサイクル。 |
|
coreNum |
いいえ |
システムが決定 |
ジョブに使用する CPU コア数。正の整数である必要があります。有効値:[1, 9999]。 |
|
memSizePerCore |
いいえ |
システムが決定 |
各コアのメモリ量 (MB) 。値は 1 から 65536 までの整数である必要があります。 |
例
-
次のテーブルに示すように、テストデータを準備します。
年齢
勤務形態
Fwlght
学歴
学歴 (数値)
既婚
C
家族
人種
性別
Gail
損失
勤続年数
国
収入
39
State-gov
77516
Bachelors
13
Never-married
Adm-clerical
Not-in-family
White
Male
2174.0
0.0
40.0
United-States
<=50K
50
Self-emp-not-inc
83311
Bachelors
13
Married-civ-spouse
Exec-managerial
Husband
White
Male
0.0
0.0
13.0
United-States
<=50K
38
Private
215646
HS-grad
9
Divorced
Handlers-cleaners
Not-in-family
White
Male
0.0
0.0
40.0
United-States
<=50K
53
Private
234721
11th
7
Married-civ-spouse
Handlers-cleaners
Husband
Black
Male
0.0
0.0
40.0
United-States
<=50K
28
Private
338409
Bachelors
13
Married-civ-spouse
Prof-specialty
Wife
Black
Female
0.0
0.0
40.0
Other
<=50K
37
Private
284582
Masters
14
Married-civ-spouse
Exec-managerial
Wife
White
Female
0.0
0.0
40.0
United-States
<=50K
49
Private
160187
9th
5
Married-spouse-absent
Other-service
Not-in-family
Black
Female
0.0
0.0
16.0
Jamaica
<=50K
52
Self-emp-not-inc
209642
HS-grad
9
Married-civ-spouse
Exec-managerial
Husband
White
Male
0.0
0.0
45.0
United-States
>50K
31
Private
45781
Masters
14
Never-married
Prof-specialty
Not-in-family
White
Female
14084.0
0.0
50.0
United-States
>50K
42
Private
159449
Bachelors
13
Married-civ-spouse
Exec-managerial
Husband
White
Male
5178.0
0.0
40.0
United-States
>50K
-
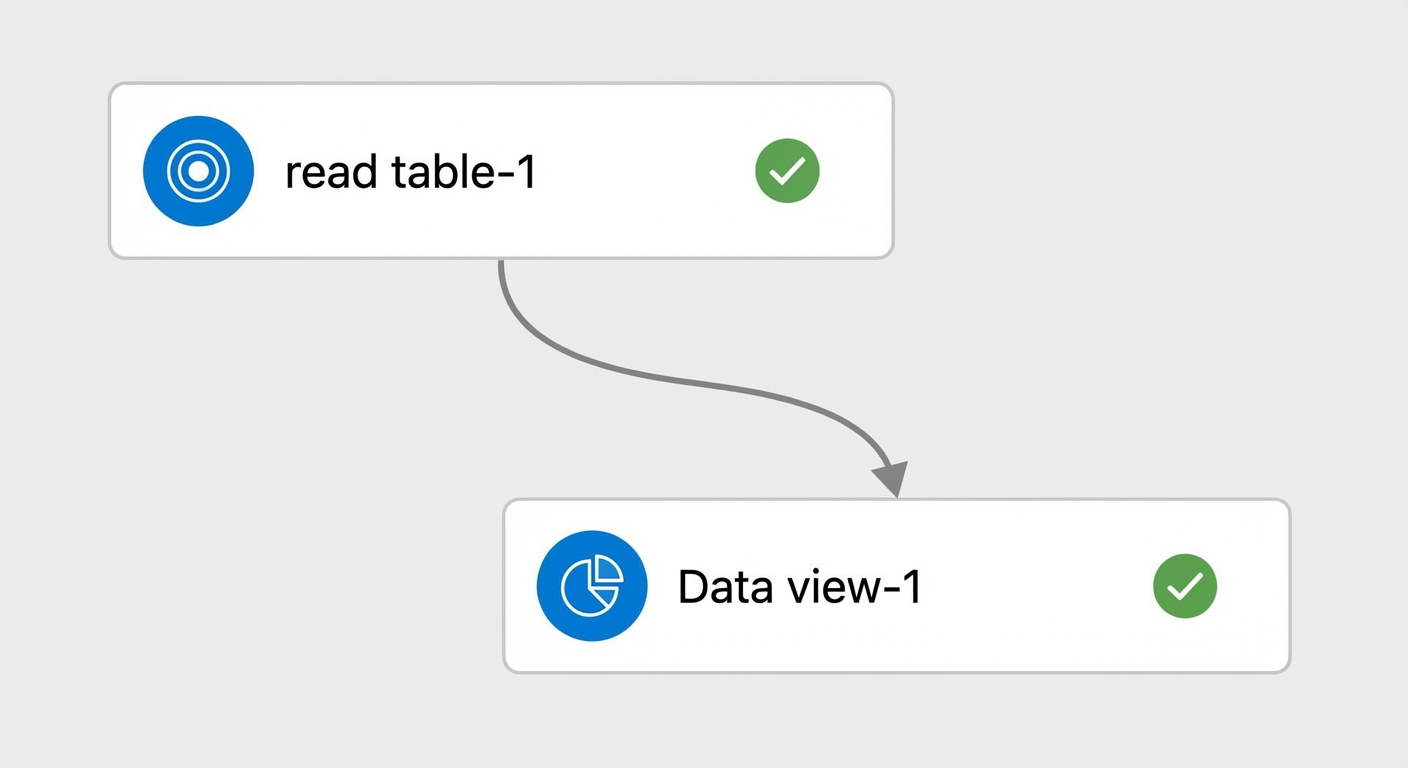
Read Table コンポーネントとデータピボットコンポーネントをパイプラインに追加し、接続します。
[データピボット] コンポーネントの [フィールド設定] タブで、income をターゲット列として選択し、他の 14 のフィールドを特徴列として選択します。BIGINT 型の edu_num フィールドを列挙型特徴量として扱います。[データピボット] コンポーネントの [フィールド設定] タブには、[特徴列]、[ターゲット列]、[列挙型特徴量] にそれぞれ 14、1、1 のフィールドが選択されていることが表示されます。
-
左上隅の
 をクリックしてパイプラインを実行します。
-
パイプラインの実行が完了したら、データピボットコンポーネントを右クリックし、[データを表示] を選択して結果を表示します:
-
出力:機械学習アルゴリズム用にデータを準備するため、family、race、sex、income などの STRING 型の列が数値にマッピングされます。結果のトレーニングデータテーブルには、age、fwlght、edu_num、edu、workclass、married、c、family、race、sex、country、gail、loss、work_year、income の 15 列が含まれます。country 列は、STRING 型の特徴列であることを示すためにハイライト表示されます。
-
文字列型特徴量マッピングテーブル
説明STRING 型の特徴列が選択されていない場合、[文字列カラム特徴マッピングテーブル]は空になります。
文字列型特徴量マッピングテーブルには、feature_name、feature_value、map_id の 3 つの列が含まれます。各行は、カテゴリカル特徴量の値を数値 ID にマッピングします。たとえば、特徴
edu_numの場合、値 13 は 1 に、14 は 2 にマッピングされます。特徴eduの場合、値 '11th' は 1 に、'Bachelors' は 3 にマッピングされます。 -
出力メタテーブル:出力特徴メタデータテーブルには 10 列 (feature_name、feature_id、feature_type、feature_value、mean、std、min_value、max_value、label_num、distribute_info) と 15 行の特徴データが含まれます。feature_type は、
label(income の場合)、enum(edu_num、edu、workclass、married、c、family、race、sex、country の場合)、またはnum(age、fwlght、gail、loss、work_year の場合) になります。数値特徴 (num) の場合、mean、std、min_value、max_value の列には特定の統計値が含まれます。列挙 (enum) およびラベル特徴の場合、これらの列にはすべて-1.0が含まれます。feature_value 列には、各特徴の列挙値または数値範囲が表示され、distribute_info 列には、特徴値のディストリビューションが表示されます。distribute_info は、特徴の値の範囲を等間隔に分割した後の各間隔のレコード数を示します。
-