AI Search オープンプラットフォームは、API 経由でドキュメント解析サービスを提供します。このサービスをビジネス処理ワークフローに統合することで、非構造化データを構造化データに解析し、ビジネスアプリケーションで利用できます。
|
サービス名 |
サービス ID |
説明 |
API QPS 制限 |
|
ドキュメント分析サービス |
ops-document-analyze-001 |
非構造化ドキュメントから論理的な階層構造 (タイトルや段落など)、テキスト、テーブル、イメージを抽出し、構造化されたフォーマットで出力を返します。 対応ドキュメントタイプ: TXT、PDF、HTML、DOC、DOCX、PPT、PPTX。 |
10 説明
より高い API QPS 制限をリクエストするには、テクニカルサポートにチケットを送信してください。 |
|
ops-document-analyze-002 |
PDF やイメージなど、複数の非構造化ドキュメントフォーマットを分析します。テーブル、数式、チャートなどの複雑な要素の識別に優れており、高い推論速度を提供します。 使用制限: PDF ファイルは 400 ページに制限されます。リクエストボディは 8 MB を超えることはできません。 |
前提条件
-
認証情報の取得
AI Search オープンプラットフォームでは、認証に API キーが必要です。手順については、「API キーの取得」をご参照ください。
-
サービスエンドポイントの取得
サービスは、パブリックネットワークまたは VPC 経由で呼び出すことができます。詳細については、「サービスエンドポイントの取得」をご参照ください。
概要
-
リクエストボディは 8 MB を超えることはできません。
概要
ドキュメントコンテンツ解析は、同期インターフェイスと非同期インターフェイスの両方を提供します。同期インターフェイスは HTTP タイムアウトのリスクがあるため、本番環境での使用は推奨されませんが、デバッグには使用できます。本番環境では、非同期インターフェイスの使用を推奨します。これは 2 段階のプロセスです。まず、非同期抽出タスクを作成して task_id を取得し、次にタスクが完了するまで非同期インターフェイスを介してタスクのステータスをポーリングします。
非同期抽出タスク
リクエストメソッド
POST
URL
{host}/v3/openapi/workspaces/{workspace_name}/document-analyze/{service_id}/async-
host:サービスエンドポイント。API サービスは、パブリックネットワークまたは VPC 経由で呼び出すことができます。詳細については、「サービスエンドポイントの取得」をご参照ください。コンソールの左側のナビゲーションウィンドウで、[API キー] をクリックし、対象のワークスペース (例: [default]) を選択し、[アクセスエンドポイント] セクションで [パブリック API エンドポイント] と [プライベート API エンドポイント] を表示します。
-
workspace_name:ワークスペースの名前。例:default。 -
service_id:組み込みサービスの ID。例:ops-document-analyze-001。
リクエストパラメーター
ヘッダーパラメーター
API キー認証
|
パラメーター |
型 |
必須 |
説明 |
値の例 |
|
Content-Type |
String |
はい |
リクエストボディのメディアタイプ。 |
application/json |
|
Authorization |
String |
はい |
認証用の API キー。 |
Bearer OS-d1**2a |
ボディパラメーター
|
パラメーター |
型 |
必須 |
説明 |
例 |
|
service_id |
String |
はい |
組み込みサービスの ID。 |
ops-document-analyze-001 |
|
document.url |
String |
いいえ |
ドキュメントの URL。ファイルは認証なしで HTTP または HTTPS 経由でパブリックにダウンロード可能である必要があります。
|
http://opensearch-shanghai.oss-cn-shanghai.aliyuncs.com/chatos/***/file-parser/samples/GB10767.pdf |
|
document.content |
String |
いいえ |
ドキュメントの Base64 エンコードされたコンテンツ。
|
"aGVsbG8gd29ybGQ=" |
|
document.file_name |
String |
いいえ |
ファイル名。このパラメーターが指定されていない場合、システムは URL から推論します。 |
test.pdf |
|
document.file_type |
String |
いいえ |
ファイルタイプ。このパラメーターが指定されていない場合、システムは サポートされているファイルタイプ: TXT、PDF、HTML、DOC、DOCX、PPT、PPTX。
|
|
|
output.image_storage |
String |
いいえ |
ドキュメントから抽出されたイメージの保存方法を指定します。
|
url |
|
strategy.enable_semantic |
Boolean |
いいえ |
TXT およびその他の非構造化ドキュメントから、セマンティックベースの階層構造の抽出を有効にします。
|
false |
以下の図のように、目次と本文が明確に区別されていないドキュメントの場合、この機能はより正確な階層構造を生成します。
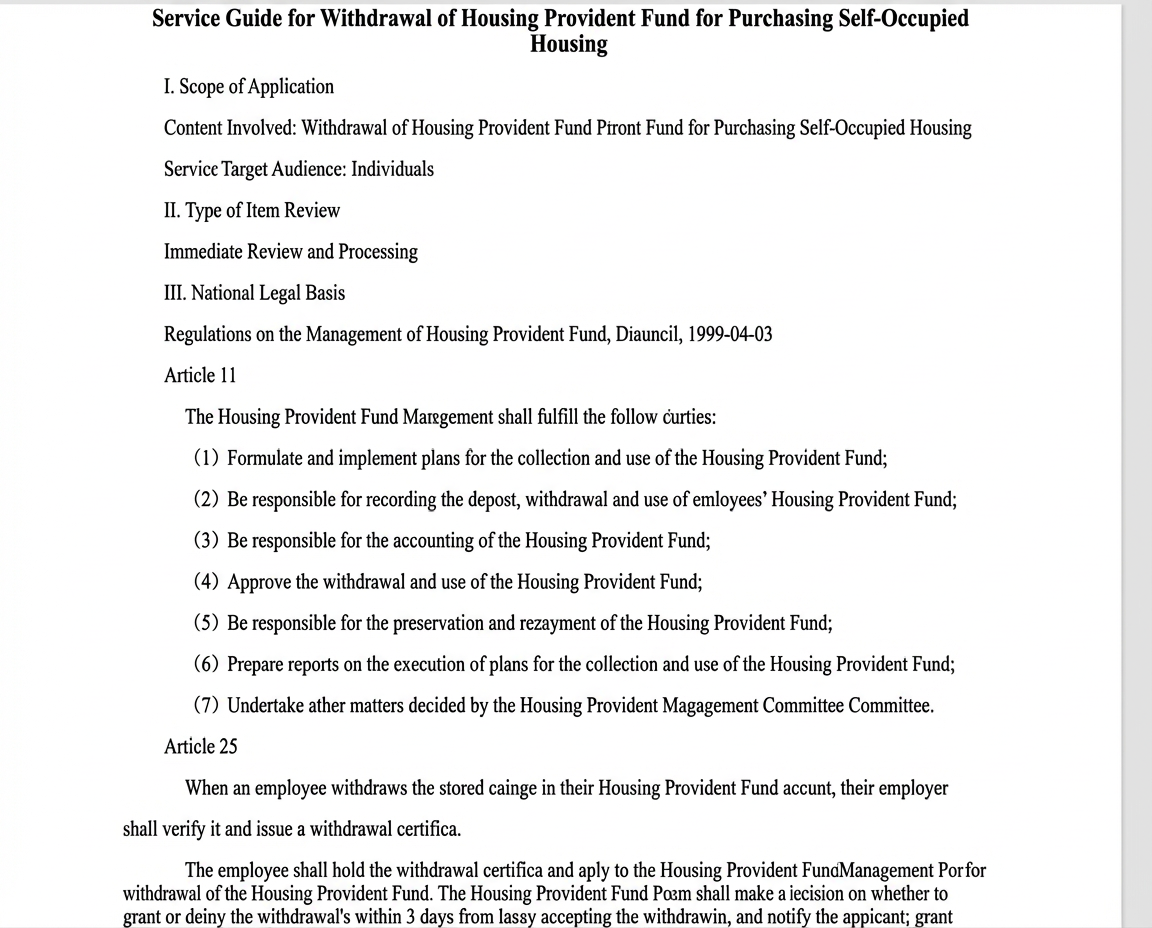
-
セマンティック構造抽出が無効の場合:
curl -XGET -H"Content-Type: application/json" "http://xxx.opensearch.aliyuncs.com/v3/openapi/workspaces/default/document-analyze/ops-document-analyze-001/async/task-status?task_id=f6122788-30e2-4/t8-8d18-33217f6a5e7c" -H "Authorization: Bearer OS xxx" {"request_id":"63877CEA-BB65-43E3-806B-DE4710DEDA98","latency":"3.0","http_code":200,"result":{"status":"SUCCESS","data":"{xxx","事项前置\n10024910010024251717233000000\n\n购买自住住房提取住房公积金 事项前置\n\n购买自住住房提取住房公积金\n金 基金 指南\n\n一、适用范围\n\n及的内容。购买自住住房提取住房公积金\n\n服务对象:\n个人\n二、事项前置类型\n\n即配即办\n\n三、国家/省/市依据\n\n住房公积金相关条例\n\n1999-04-03\n\n第十一条 \n\n住房公积金管理中心履行下列职责:\n\n...(后续为住房公积金管理条例详细内容)\n\n购买1 购买自住住房提取住房公积金流程福利\n\n[IMO]:data:image/jpeg;base64,/9j/4AAQSkZJRgABAQAYABeAAD..."}} -
セマンティック構造抽出が有効の場合、レスポンスの例は次のようになります。
contentフィールドの##および###Markdown マーカーは認識された階層ディレクトリ構造を示し、\nは改行を表します。{"request_id":"9F7B4F1A-4EE0-4430-A537-2C21B01E3676","latency":3.0,"http_code":200,"result":{"status":"SUCCESS","data":{"content":"... 事项编码:1\n## 适用范围\n及的内容:购买自住住房提取住房公积金\n(含购买自住住房提取住房公积金和购服务指南)的制定和发布 事项名称:购买自住住房提取住房公积金 适用范围\n及的内容:购买自住住房提取住房公积金\n\n### 二 事项审查类型\n即时即办\n### 三 国家法律依据\n住房公积金管理条例(国务院 1999-04-03...\n(二)购买自住住房的提取...住房公积金的保值和归集...\n使用等情况...在住房公积金的核算...使用...住房公积金的保值和归集...\n...管理中心应当...提取住房公积金...自3日内作出准予提取或者不准提取的决定,并通知申请人;准予提取的,由受委托银行办理支付手续...\n...建设住房公积金...储存余额的存储方式...建设住房公积金...\n...住房公积金流程...相关申请材料文件\n...\n附录3 帮助购趣群答..."}}}説明usage.semantic_token_countが値を返す場合、セマンティック構造の抽出は成功し、この課金項目のトークン料金が請求されます。値が返されない場合、抽出は失敗し、料金は請求されません。
以下のテーブルは、セマンティック結果抽出を有効にした後の推定所要時間とセマンティックトークン数を示しています。
|
PDF ページ数 |
トークン |
セマンティック階層なし |
セマンティック階層あり |
|
|
時間 (秒) |
時間 (秒) |
セマンティックトークン |
||
|
7 |
11504 |
2 |
49 |
36243 |
|
25 |
10375 |
1 |
33 |
59332 |
|
42 |
41435 |
5 |
68 |
130717 |
レスポンスパラメーター
|
パラメーター |
型 |
説明 |
例 |
|
result.task_id |
String |
ドキュメント解析の非同期タスクの ID。 |
d5a4019e-853a-****-b5b6-8053d9f5a9fc |
cURL の例
curl --location 'http://****shanghai.opensearch.aliyuncs.com/v3/openapi/workspaces/default/document-analyze/ops-document-analyze-001/async/' \
--header 'Authorization: Bearer ご利用の API キー' \
--header 'Content-Type: application/json' \
--data '{
  "document":{
      "url": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241018/jahnyn/%E8%A7%A3%E6%9E%90%E6%B5%8B%E8%AF%95.doc"
    },
    "output" :{
      "image_storage":"base64"
    },
    "strategy": {
      "enable_semantic":true
    }
}'
レスポンスの例
成功レスポンス
{
    "request_id": "D5A4019E-853A-4E20-****-8053D9F5A9FC",
    "latency": 5.0,
    "http_code": 200,
    "result": {
        "task_id": "d5a4019e-853a-****-b5b6-8053d9f5a9fc"
    }
}
エラーレスポンス
リクエストが失敗した場合、レスポンスの code フィールドと message フィールドにエラーが記述されます。
{
    "request_id": "590A7EB8-AA84-****-AF31-8C35DC965972",
    "latency": 0.0,
    "code": "InvalidParameter",
    "http_code": 400,
    "message": "document.file_name required"
}
非同期タスクの取得
リクエストメソッド
GET
URL
{host}/v3/openapi/workspaces/{workspace_name}/document-analyze/{service_id}/async/task-status?task_id=${task_id}-
host:サービスエンドポイント。API サービスは、パブリックネットワークまたは VPC 経由で呼び出すことができます。詳細については、「サービスエンドポイントの取得」をご参照ください。 -
workspace_name:ワークスペースの名前。例:default。 -
service_id:組み込みサービスの ID。例:ops-document-analyze-001。 -
task_id:タスク作成リクエストによって返された非同期タスク ID。例:d5a4019e-853a-****-b5b6-8053d9f5a9fc。
リクエストパラメーター
ヘッダーパラメーター
API キー認証
|
パラメーター |
型 |
必須 |
説明 |
例 |
|
Content-Type |
String |
はい |
リクエストのメディアタイプ。値は application/json である必要があります。 |
application/json |
|
Authorization |
String |
はい |
認証用の API キー。プレフィックスとして Bearer を付けます。 |
Bearer OS-d1**2a |
レスポンスパラメーター
|
パラメーター |
型 |
説明 |
値 |
|
result.task_id |
String |
非同期ドキュメント解析タスクの ID。 |
24c3ad59-****-40cf-974b-b63d63e0571 |
|
result.status |
String |
タスクのステータス。指定可能な値は次のとおりです:
|
PENDING |
|
result.error |
String |
失敗したタスクのエラーメッセージ。それ以外の場合、このパラメーターは空です。 |
ドキュメントの復号に失敗しました。 |
|
result.data |
Object |
ドキュメント解析結果。 |
markdown |
|
result.data.content |
String |
ドキュメントの解析済みコンテンツ。
|
"XXX" |
|
result.data.content_type |
String |
解析済みコンテンツのフォーマット。
|
markdown |
|
result.data.page_num |
Int |
ドキュメントのページ数。 |
15 |
|
request_id |
String |
この API 呼び出しの一意の識別子。 |
B4AB89C8-B135-****-A6F8-2BAB8018688 |
|
latency |
Float/Int |
リクエストのレイテンシー (ミリ秒単位)。 |
10 |
|
usage |
Object |
この API 呼び出しの計量情報。 |
"usage": { "token_count": 123, "table_count": 5, "image_count": 6, "semantic_token_count":3068 } |
|
usage.token_count |
Int |
ドキュメント内の文字数。 |
1234 |
|
usage.table_count |
Int |
ドキュメント内のテーブル数。 |
5 |
|
usage.image_count |
Int |
ドキュメント内のイメージ数。 |
6 |
|
usage.semantic_token_count |
Int |
セマンティック抽出モデルへの入力の文字数。 |
3068 |
cURL リクエスト
curl -XGET -H"Content-Type: application/json" \
"http://****-hangzhou.opensearch.aliyuncs.com/v3/openapi/workspaces/default/document-analyze/ops-document-analyze-001/async/task-status?task_id=110d6349-2e51-****-8bfb-25e5de434686" \
-H "Authorization: Bearer ご利用の API キー"
レスポンスの例
成功レスポンス
{
    "request_id": "27F9CEC3-9052-****-83FF-E7957B680492",
    "latency": 13.0,
    "http_code": 200,
    "result": {
        "status": "SUCCESS",
        "data": {
            "content": "Provided proper attribution is provided, Alibaba hereby grants permission to reproduce the tables and figures in this paper solely for use in journalistic or scholarly works....",
            "content_type": "markdown",
            "page_num": 15
        },
        "task_id": "24c3ad59-b196-****-974b-b63d63e05895"
    },
    "usage": {
        "token_count": 31867,
        "table_count": 4,
        "image_count": 8,
        "semantic_token_count":3068
    }
}
エラーレスポンス
アクセスリクエストが失敗した場合、レスポンスの code フィールドと message フィールドにエラーが説明されます。
同期解析タスクの作成
同期インターフェイスは HTTP タイムアウトのリスクがあるため、本番環境での使用は避けてください。代わりにデバッグに使用できます。
リクエストメソッド
POST
URL
{host}/v3/openapi/workspaces/{workspace_name}/document-analyze/{service_id}/syncパラメーター
-
host:サービスエンドポイント。API サービスは、パブリックネットワークまたは VPC 経由で呼び出すことができます。詳細については、「サービスエンドポイントの取得」をご参照ください。 -
workspace_name:ワークスペース名。例:default。 -
service_id:組み込みサービスの ID。例:ops-document-analyze-001。
リクエストパラメーター
ヘッダーパラメーター
API キー認証
|
パラメーター |
型 |
必須 |
説明 |
値 |
|
Content-Type |
String |
はい |
リクエストのタイプ。 |
application/json |
|
Authorization |
String |
はい |
ご利用の API キー。 |
Bearer OS-d1**2a |
ボディパラメーター
|
パラメーター |
型 |
必須 |
説明 |
値の例 |
|
document.url |
String |
いいえ |
ドキュメントのパブリック URL。認証なしで HTTP または HTTPS 経由でアクセスできる必要があります。
|
http://opensearch-shanghai.oss-cn-shanghai.aliyuncs.com/chatos/***/file-parser/samples/GB10767.pdf |
|
document.content |
String |
いいえ |
Base64 エンコードされたドキュメントコンテンツ。
|
"aGVsbG8gd29ybGQ=" |
|
document.file_name |
String |
いいえ |
ファイル名。このパラメーターを省略した場合、システムは document.url から名前を推論します。document.content が指定されている場合、このパラメーターは必須です。 |
test.pdf |
|
document.file_type |
String |
いいえ |
ファイルタイプ。このパラメーターを省略した場合、システムは 対応ファイルタイプ: TXT、PDF、HTML、DOC、DOCX、PPT、PPTX。 |
|
|
output.image_storage |
String |
いいえ |
イメージの保存方法。
|
url |
|
strategy.enable_semantic |
Boolean |
いいえ |
セマンティック構造抽出を有効にするかどうかを指定します。デフォルトは |
false |
レスポンスパラメーター
|
パラメーター |
型 |
説明 |
例 |
|
result.status |
String |
タスクのステータス。有効な値は次のとおりです:
|
PENDING |
|
result.error |
String |
ステータスが |
ドキュメントの復号に失敗しました |
|
result.data |
Object |
ドキュメント解析結果。 |
markdown |
|
result.data.content |
String |
ドキュメントの解析済みコンテンツ。
|
"XXX" |
|
result.data.content_type |
String |
解析されたドキュメントのコンテンツタイプ。有効な値は次のとおりです:
|
markdown |
|
result.data.page_num |
Int |
ドキュメントのページ数。 |
15 |
|
request_id |
String |
リクエストの一意の識別子。 |
B4AB89C8-B135-****-A6F8-2BAB801A2CE4 |
|
latency |
Float/Int |
リクエストのレイテンシー (ミリ秒単位)。 |
10 |
|
usage |
Object |
リクエストの使用量の詳細。 |
"usage": { "token_count": 123, "table_count": 5, "image_count": 6, "semantic_token_count":3068 } |
|
usage.token_count |
Int |
ドキュメント内のトークンの総数。 |
1234 |
|
usage.table_count |
Int |
ドキュメント内のテーブルの総数。 |
5 |
|
usage.image_count |
Int |
ドキュメント内のイメージの総数。 |
6 |
|
usage.semantic_token_count |
Int |
セマンティック抽出モデルの入力として使用されたセマンティックトークンの総数。 |
3068 |
cURL
curl --location 'http://****shanghai.opensearch.aliyuncs.com/v3/openapi/workspaces/default/document-analyze/ops-document-analyze-001/sync/' \
--header 'Authorization: Bearer ご利用の API キー' \
--header 'Content-Type: application/json' \
--data '{
  "document":{
      "url": "https://help-static-aliyun-doc.aliyuncs.com/file-manage-files/zh-CN/20241018/jahnyn/%E8%A7%A3%E6%9E%90%E6%B5%8B%E8%AF%95.doc"
    },
    "output" :{
      "image_storage":"base64"
    },
    "strategy": {
      "enable_semantic":true
    }
}'
レスポンスの例
成功レスポンスの例
{
    "request_id": "27F9CEC3-9052-****-83FF-E7957B689D04",
    "latency": 13.0,
    "http_code": 200,
    "result": {
        "status": "SUCCESS",
        "data": {
            "content": "Provided proper attribution is given, Alibaba hereby grants permission to reproduce the tables and figures in this paper solely for use in journalistic or scholarly works....",
            "content_type": "markdown",
            "page_num": 15
        }
    },
    "usage": {
        "token_count": 31867,
        "table_count": 4,
        "image_count": 8,
        "semantic_token_count":3068
    }
}
エラーレスポンスの例
アクセスリクエストが失敗した場合、レスポンスは code フィールドと message フィールドでエラーを示します。
{
    "request_id": "6F33AFB6-A35C-****-AFD2-9EA16CCF4383",
    "latency": 2.0,
    "code": "InvalidParameter",
    "http_code": 400,
    "message": "JSON parse error: Cannot deserialize value of type `ImageStorage` from String \\"xxx\\"
}
ステータスコード
|
HTTP ステータスコード |
エラーコード |
説明 |
|
200 |
- |
リクエストは成功しました。このステータスはタスクが失敗した場合でも返されます。タスクのステータスを確認するには、 |
|
404 |
BadRequest.TaskNotExist |
タスクが存在しません。 |
|
400 |
InvalidParameter |
リクエストが無効でした。 |
|
500 |
InternalServerError |
内部エラーが発生しました。 |
ステータスコードの詳細については、「ステータスコード」をご参照ください。