基本概念
各ドキュメントは複数のフィールドで構成され、各フィールドには一連のタームが含まれています。インデックス構築の目的は、検索を高速化することです。マッピングの方向性に基づき、インデックスは次の種類に分類されます:
-
フィールド:インデックス テーブルのフィールド名とフィールドタイプを定義します。
-
転置インデックス:転置インデックスは、単語からドキュメント ID へのマッピングを
word: (Doc1, Doc2, ..., DocN)の形式で格納します。主に検索で使用され、ユーザーのクエリ内のキーワードに一致するドキュメントを迅速に特定できます。 -
順インデックス (属性):順インデックスは、ドキュメント ID からフィールドへのマッピングを
DocID --> (term1, term2, ..., termn)の形式で格納します。順インデックスには、単一値と複数値のタイプがあります。単一値の属性は (STRING 型を除き) 固定長であるため、検索効率が高く、更新をサポートします。複数値の属性とは、1 つのフィールドに複数の値 (可変個数) が含まれるものです。長さが不確定なため、検索効率は単一値の属性よりも低くなり、更新はサポートされません。順インデックスは主に、ドキュメントが見つかった後にその DocID によってドキュメントの属性を迅速に取得し、統計、ソート、フィルタリングに使用されます。現在、エンジンは順インデックスフィールドに対して、以下のプリミティブデータ型をサポートしています:
INT8 (8 ビット符号付き整数型)、UINT8 (8 ビット符号なし整数型)、
INT16 (16 ビット符号付き整数型)、
UINT16 (16 ビット符号なし整数型)、
INTEGER (32 ビット符号付き整数型)、
UINT32 (32 ビット符号なし整数型)、INT64 (64 ビット符号付き整数型)、
UINT64 (64 ビット符号なし整数型)、
FLOAT (32 ビット浮動小数点数)、
DOUBLE (64 ビット浮動小数点数)、
STRING (文字列型)
-
サマリー:サマリーは属性と同様の方法で格納されますが、ドキュメントの複数のフィールドをまとめて格納し、マッピングを構築するため、DocID によって対応するサマリーコンテンツを迅速に特定できます。サマリーは主に結果を表示するために使用されます。通常、サマリーのコンテンツは比較的大きいため、クエリごとにあまり多くのサマリーを取得するには適していません。結果を表示する必要があるドキュメントのみが、対応するサマリーを取得します。サマリーは大きくなる可能性があるため、エンジンにはそれらを格納するための圧縮メカニズムが用意されています。スキーマでサマリーの圧縮を設定すると、エンジンは格納前にサマリーを zstd で圧縮し、読み取り時に解凍して返します。
インデックス テーブル設定の詳細については、「インデックス テーブル設定」をご参照ください。
インデックススキーマの例:
{
  "file_compress": [
    {
      "name": "file_compressor",
      "type": "zstd"
    },
    {
      "name": "no_compressor",
      "type": ""
    }
  ],
  "table_name": "test",
  "summarys": {
    "summary_fields": [
      "id",
      "fb_boolean",
      "fb_datetime",
      "fb_string",
      "fb_decimal",
      "fb_bigint",
      "fb_text"
    ],
    "parameter": {
      "file_compressor": "zstd"
    }
  },
  "indexs": [
    {
      "index_name": "id",
      "index_type": "PRIMARYKEY64",
      "index_fields": "id",
      "has_primary_key_attribute": true,
      "is_primary_key_sorted": false
    },
    {
      "index_name": "fb_boolean",
      "index_type": "STRING",
      "index_fields": "fb_boolean",
      "file_compress": "file_compressor",
      "format_version_id": 1
    },
    {
      "index_name": "fb_datetime",
      "index_type": "STRING",
      "index_fields": "fb_datetime",
      "file_compress": "file_compressor",
      "format_version_id": 1
    },
    {
      "index_name": "fb_string",
      "index_type": "STRING",
      "index_fields": "fb_string"
    },
    {
      "index_name": "fb_text",
      "index_type": "TEXT",
      "index_fields": "fb_text"
    }
  ],
  "attributes": [
    {
      "field_name": "id",
      "file_compress": "no_compressor"
    },
    {
      "field_name": "fb_boolean",
      "file_compress": "file_compressor"
    },
    {
      "field_name": "fb_datetime",
      "file_compress": "no_compressor"
    },
    {
      "field_name": "fb_string",
      "file_compress": "file_compressor"
    },
    {
      "field_name": "fb_decimal",
      "file_compress": "no_compressor"
    },
    {
      "field_name": "fb_bigint",
      "file_compress": "no_compressor"
    }
  ],
  "fields": [
    {
      "user_defined_param": {},
      "field_name": "id",
      "field_type": "INT64",
      "compress_type": "equal"
    },
    {
      "field_name": "fb_boolean",
      "field_type": "STRING",
      "compress_type": "uniq"
    },
    {
      "field_name": "fb_datetime",
      "field_type": "STRING",
      "compress_type": "uniq"
    },
    {
      "user_defined_param": {
        "multi_value_sep": ","
      },
      "field_name": "fb_string",
      "field_type": "STRING",
      "compress_type": "equal",
      "multi_value": true
    },
    {
      "field_name": "fb_decimal",
      "field_type": "DOUBLE"
    },
    {
      "field_name": "fb_bigint",
      "field_type": "INT64",
      "compress_type": "equal"
    },
    {
      "field_name": "fb_text",
      "field_type": "TEXT",
      "analyzer": "chn_standard"
    }
  ]
}
インデックス テーブルの追加
-
インスタンス管理ページで、[設定センター] > [インデックススキーマ] に移動し、[インデックス テーブルの追加] をクリックします:
-
[インデックス テーブル] を設定し、[データソース] を選択し、[データシャーディング] を設定します:
-
フィールド設定:
複数値フィールドの区切り文字設定:
デフォルトは HA3 の区切り文字 ^] です。ビジネス要件に応じて、この区切り文字をカスタマイズすることもできます。
属性とフィールドコンテンツの圧縮:
-
属性フィールドの場合、圧縮を有効にするかどうかを選択できます。デフォルトでは圧縮は無効になっています。
file_compressorを選択すると圧縮が有効になります。 -
フィールドコンテンツの場合、圧縮を有効にするかどうかを選択できます。デフォルトでは圧縮は無効になっています。複数値および STRING 型の場合、デフォルトで
uniqが使用され、単一値の数値型の場合、equalが使用されます。
属性圧縮が有効な場合は、[デプロイメント管理] - [データノード] - [オンラインテーブル設定] に移動してインデックスの読み込み方法を編集し、パフォーマンスへの影響を軽減することを推奨します。
-
インデックス設定:
インデックスフィールドの圧縮設定:
-
インデックスフィールドの場合、圧縮を有効にするかどうかを選択できます。デフォルトでは圧縮は無効になっています。
file_compressorを選択すると圧縮が有効になります。
-
プライマリキーインデックスは圧縮をサポートしていません。
-
インデックス圧縮が有効な場合は、[デプロイメント管理] - [データノード] - [オンラインテーブル設定] に移動してインデックスの読み込み方法を編集し、パフォーマンスへの影響を軽減することを推奨します。
-
設定が完了したら、[バージョンを保存] をクリックし、ダイアログに備考 (任意) を入力して、[デプロイ] をクリックします:
-
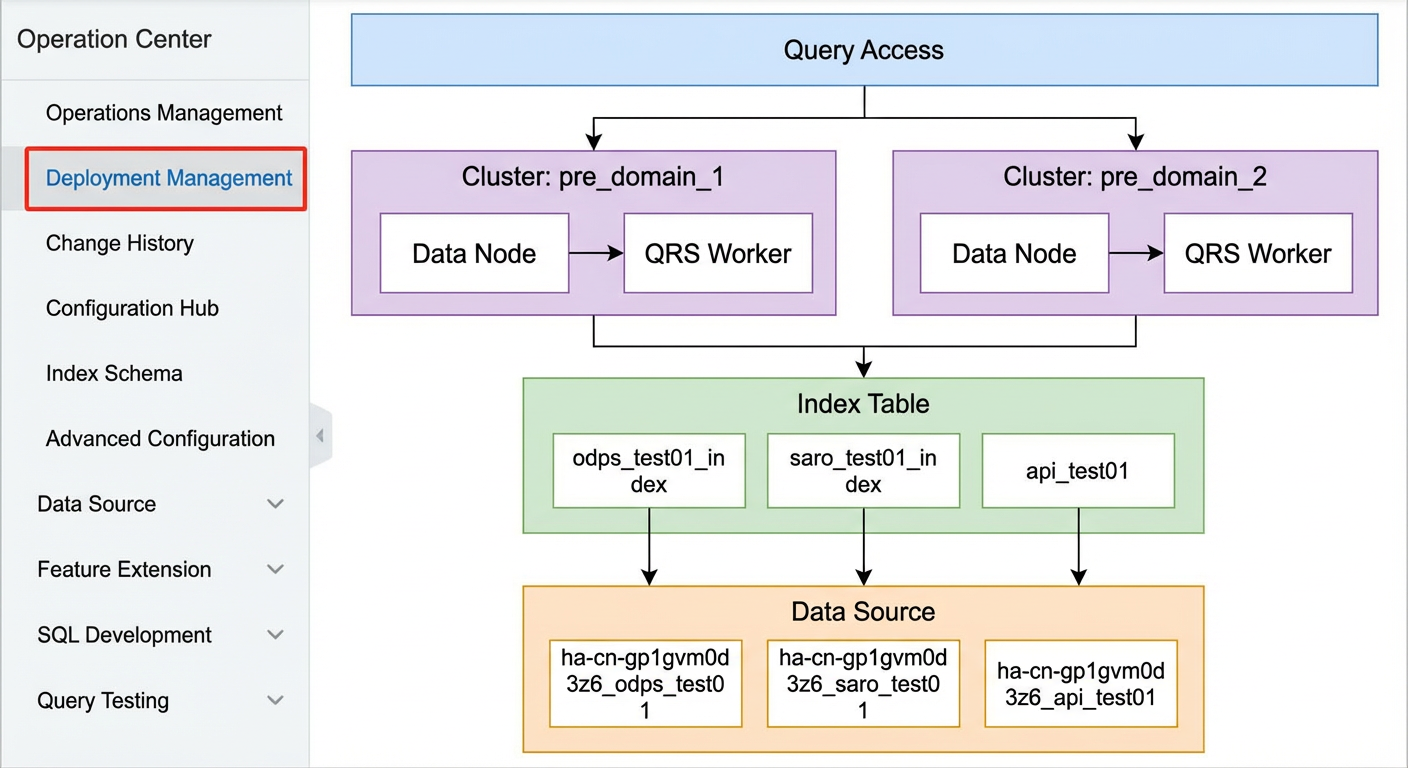
インデックス テーブルが追加された後、[オペレーションセンター] > [デプロイメント管理] で新しく追加されたインデックス テーブルのトポロジーを表示できます:
-
新しく追加されたインデックス テーブルをクラスターで有効にするには、[オペレーションセンター] > [運用管理] で設定の更新と完全な再構築を手動でトリガーする必要があります。[設定の更新] 操作で、[Push configuration and trigger index rebuild] を実行します:
-
インデックス再構築中に、[オペレーションセンター] > [変更履歴] の [データソースの変更] で完全な再構築の進捗状況を確認できます:
インデックス再構築が完了すると、新しいインデックス テーブルをクエリできます。
-
フィールド設定では、プライマリキーは 1 つだけ設定する必要があります。
-
フィールド設定では、検索結果に表示するフィールドを少なくとも 1 つ選択する必要があります。
-
TEXT フィールドにはアナライザーを設定する必要があり、複数値はサポートされていません。
-
インデックス設定では、プライマリキーインデックスは 1 つだけ設定する必要があります。
-
デフォルトの区切り文字を除き、複数値の区切り文字は単一文字のみをサポートし、全角文字はサポートしていません。
-
データシャーディングを設定する際には注意が必要です。クラスター内のレプリカ数が 2 で、データシャーディングが 2 に設定されているとします。この場合、インスタンスを購入する際、新しく追加されたインデックス テーブルが正常に機能するためには、データノード数 > レプリカ数 × データシャーディング である必要があります。
-
シャード数を設定する際は、次のルールを参照してください:単一シャードのデータ量は 6 億件を超えないようにします (最大 21 億件)。単一シャードのインデックスサイズは 300 GB を超えないようにします。リアルタイム更新が必要な場合、単一シャードのデータ更新 TPS は 4,000 を超えないようにします (
addコマンドを含むドキュメントの場合。updateのみの場合は 10,000 TPS に達することがあります)。
インデックス テーブルの編集
インデックス テーブルのバージョン:
新しく作成されたインデックス テーブルには、デフォルトで 2 つのバージョンがあります:
-
index_config_v1:最初に設定されたインデックス テーブルバージョン。設定がプッシュされ、インデックスが再構築された場合、そのステータスは「使用中」に変わります。設定がプッシュされず、インデックスが再構築されていない場合、そのステータスは「未使用」です。 -
index_config_edit:編集中のインデックス テーブルバージョン。そのステータスは常に「編集中」です。
インデックス テーブルのバージョンが順次デプロイされるにつれて、バージョン名は順にインクリメントされます。たとえば、2 番目のバージョンは「index_config_v2」、3 番目のバージョンは「index_config_v3」という名前になります。バージョンを明確に区別するために、各バージョンには備考が必要です。
新しいインデックス テーブルバージョンの編集とデプロイ:
-
ステータスが「編集中」のバージョンを見つけて、[編集] をクリックします:
cluster.json 設定に関する補足:
プラットフォームはインデックスマージポリシーの設定に対応しており、図に示すように customized_merge_config および segment_customize_metrics_updater (新規インスタンスでのみサポート) を設定できます。
パラメーターの詳細については、「オフラインクラスター設定」をご参照ください。
-
変更後、[バージョンを保存] をクリックします:
開発者モードに切り替えて、スキーマを手動で編集することもできます:
-
ステータスが「編集中」のバージョンを見つけ、[デプロイ] をクリックし、[備考] を入力して [OK] をクリックします:
これにより、システムはこのインデックス テーブルの新しいインデックス テーブルバージョンを生成し、ステータスは「未使用」になります。
-
新しく追加されたインデックス テーブルバージョンをクラスターで有効にするには、[オペレーションセンター] > [運用管理] > [設定の更新] で [Push configuration and trigger index rebuild] を実行する必要があります:
インデックス テーブルバージョンの削除:
ステータスが「未使用」のインデックス テーブルバージョンは直接削除できます:
インデックス テーブルバージョンの表示:
[表示] をクリックすると、インデックス テーブルバージョンの読み取り専用設定ページにリダイレクトされます:
-
管理者モード:
-
開発者モード:
インデックス テーブルの削除
インデックス テーブルに「使用中」ステータスのバージョンがない場合、そのインデックス テーブルは直接削除できます:
インデックス テーブルに「使用中」ステータスのバージョンがある場合:
削除するには、次の手順に従ってください:
-
[運用管理] > [デプロイメント管理] で、インデックス テーブルをクリックし、図のように [登録解除] を選択します:
-
次に、[設定センター] > [インデックススキーマ] で、該当のインデックス テーブルを削除します:
デプロイメント管理でインデックス テーブルを [登録解除] した場合は、インデックススキーマで該当のインデックス テーブルを削除する必要があります。そうしないと、オンラインクラスターに影響を及ぼします。
注意事項
-
インデックス テーブルを追加する際には、データソースが必要です。データソースがない場合は、まずデータソースを追加してからインデックス テーブルを追加する必要があります。
-
インデックス テーブル名は作成後に変更できません。
-
「使用中」ステータスのバージョンを含むインデックス テーブルは、直接削除できません。
-
各インデックス テーブルが持てる「編集中」状態のバージョンは 1 つのみです。