OpenSearch Industry Algorithm Edition は、さまざまな言語、業界、検索シナリオに対応した組み込みのテキストアナライザーを提供します。各アナライザーは、インデックス作成時のフィールド内容のトークン化と、クエリ時のマッチング方法を制御します。
アナライザーの概要
次の表は、利用可能なすべてのアナライザーをまとめたものです。「専用インスタンスのみ」とは、アナライザーには専用のアプリケーションインスタンスが必要であることを意味します。
| アナライザー | 言語 / ドメイン | サポートされるフィールドタイプ | 専用インスタンスのみ |
|---|---|---|---|
| N-gram | すべて | SHORT_TEXT | はい |
| キーワード | すべて | LITERAL、INT、LITERAL_ARRAY、INT_ARRAY | いいえ |
| 中国語汎用アナライザー | 中国語 | TEXT、SHORT_TEXT | いいえ |
| 中国語 E コマースアナライザー | 中国語 / E コマース | TEXT、SHORT_TEXT | いいえ |
| 中国語シングルキャラクターアナライザー | 中国語 | TEXT、SHORT_TEXT | いいえ |
| 中国語キャラクターアナライザー | 中国語 | TEXT、SHORT_TEXT | はい |
| ファジーアナライザー | 中国語 / ピンイン | SHORT_TEXT | いいえ |
| ピンインフルスペルアナライザー | ピンイン | SHORT_TEXT | いいえ |
| ピンイン短縮アナライザー | ピンイン | SHORT_TEXT | いいえ |
| 英語ステミングアナライザー | 英語 | TEXT、SHORT_TEXT | いいえ |
| 英語非ステミングアナライザー | 英語 | TEXT、SHORT_TEXT | いいえ |
| 英語細粒度アナライザー | 英語 | TEXT、SHORT_TEXT | はい |
| タイ語汎用アナライザー | タイ語 | TEXT、SHORT_TEXT | はい |
| タイ語 E コマースアナライザー | タイ語 / E コマース | TEXT、SHORT_TEXT | はい |
| ベトナム語汎用アナライザー | ベトナム語 | TEXT、SHORT_TEXT | はい |
| インドネシア語汎用アナライザー | インドネシア語 | TEXT、SHORT_TEXT | はい |
| 韓国語汎用アナライザー | 韓国語 | TEXT、SHORT_TEXT | はい |
| 韓国語 E コマースアナライザー | 韓国語 / E コマース | TEXT、SHORT_TEXT | はい |
| 日本語汎用アナライザー | 日本語 | TEXT、SHORT_TEXT | はい |
| 日本語 E コマースアナライザー | 日本語 / E コマース | TEXT、SHORT_TEXT | はい |
| シンプルアナライザー | すべて | TEXT、SHORT_TEXT | いいえ |
| 数値アナライザー | 数値 | INT、TIMESTAMP | いいえ |
| 地理位置情報アナライザー | 地理 | geo_point | いいえ |
| IT コンテンツアナライザー | IT 業界 | TEXT、SHORT_TEXT | いいえ |
| 汎用 E コマース分析 | E コマース | TEXT | はい (E コマース向け業界特化型拡張版) |
| ゲーム業界向け汎用分析 | ゲーム | TEXT、SHORT_TEXT | はい (ゲーム向け業界特化型拡張版) |
| 英語 E コマース汎用アナライザー | 英語 / E コマース | TEXT | はい (E コマース向け業界特化型拡張版) |
| カスタムテキストアナライザー | すべて | TEXT、SHORT_TEXT | いいえ |
N-gram アナライザー
テキストを N 個の連続した文字のシーケンスにトークン化します。2-gram と 3-gram のトークン化をサポートしています。このアナライザーは、文字レベルの部分文字列マッチングが必要な、非セマンティック検索のシナリオで使用します。
専用アプリケーションでのみ利用可能です。フィールドタイプは SHORT_TEXT である必要があります。
例 — 2-gram
入力:Open Search
トークン:op、pe、en、n 、 s、se、ea、ar、rc、ch
例 — 3-gram
入力:Open Search
トークン:ope、pen、en 、n s、 se、sea、ear、arc、rch
キーワードアナライザー
フィールド値をトークン化しません。値全体が 1 つのトークンとして扱われます。このアナライザーは、タグ、識別子、文字列コード、分割すべきではない数値など、完全一致のシナリオで使用します。
サポートされるフィールドタイプ:LITERAL、INT、LITERAL_ARRAY、INT_ARRAY
例
入力:chrysanthemum tea
ドキュメントは、クエリが chrysanthemum tea と完全に一致する場合にのみ取得されます。
OpenSearch で完全一致検索用にフィールドを設定するには:
-
アプリケーションスキーマのオフライン変更で、フィールドタイプを LITERAL に設定します。
-
インデックススキーマで、フィールドのインデックスを作成します。分析方法は自動的にキーワード分析に設定されます。
-
オフライン変更を送信し、サービス切り替えが完了するのを待ちます。
-
query=field_name:"search_term"を使用して完全一致検索を行います。たとえば、query=id:"云搜索"は、idフィールドが云搜索と完全に一致するドキュメントのみを返します。
TEXT フィールドの場合、フレーズを二重引用符で囲んで、トークン化せずにフレーズ全体に一致するフレーズクエリを実行します。たとえば、query=default:"开放搜索" を使用します。フレーズの一部や、ピンイン、プレフィックス、サフィックスで検索するには、「ファジー検索」をご参照ください。
中国語汎用アナライザー
中国語テキスト向けの汎用セマンティックアナライザーです。中国語のセマンティクスに基づいて、コンテンツを意味のある検索単位にトークン化します。ほとんどの業界に適しています。
サポートされるフィールドタイプ:TEXT、SHORT_TEXT
例
入力:juhuacha
ドキュメントは、クエリ juhuacha、juhua、cha、または huacha で取得されます。
中国語 E コマースアナライザー
中国の E コマースの製品名と説明に最適化されたセマンティックアナライザーです。一般的な製品用語に対して、汎用アナライザーよりも細かい粒度のトークンを生成します。
サポートされるフィールドタイプ:TEXT、SHORT_TEXT
例
入力:Dabao SOD lotion
ドキュメントは、クエリ Dabao、sod、sod lotion、SOD lotion、または lotion で取得されます。
中国語シングルキャラクターアナライザー
中国語テキストを個々の文字と単語にトークン化します。このアナライザーは、著者名、店舗名、あるいは個々の文字の再現率がセマンティックなグループ化よりも重要なフィールドといった、非セマンティックな中国語検索シナリオで使用します。
サポートされるフィールドタイプ:TEXT、SHORT_TEXT
このアナライザーは、数字と英単語を単一のトークンとして扱います。heの検索では、hello worldを含むドキュメントは取得されません。数字や英語テキストの部分的な単語一致が必要な場合は、ファジーアナライザーを使用してください。
TEXT フィールドに検索結果のサマリーが設定されている場合、huacha などの一部の拡張トークンはハイライト表示されません。
例
入力:juhuacha
ドキュメントは、クエリ juhuacha、juhua、cha、huacha、hua、または jucha で取得されます。
中国語キャラクターアナライザー
テキストを個々の漢字、数字、英字、句読点にトークン化します。最大の粒度を必要とする非セマンティック検索シナリオに適しています。
サポートされるフィールドタイプ:TEXT、SHORT_TEXT
専用アプリケーションでのみ利用可能です。
例
入力:開放捜索 OpenSearch123.
ドキュメントは、開、放、捜、索、、O、p、e、n、S、e、a、r、c、h、1、2、3、または . のいずれかの 1 文字を検索することで取得されます。
ファジーアナライザー
ピンイン、単一文字、アルファベットによる検索をサポートします。数字、アルファベット、ピンインのプレフィックスおよびサフィックスマッチングにも対応しています。中国語テキストは、プレフィックスまたはサフィックスマッチングをサポートしていません。フィールド長は 100 バイトに制限されています。
サポートされるフィールドタイプ:SHORT_TEXT のみ
詳細については、「ファジー検索」をご参照ください。
例 — 中国語とピンイン
入力:菊花茶
このドキュメントは、chrysanthemum tea、chrysanthemum、tea、flower tea、flower、ju、juhua、juhuacha、j、jh、または jhc などのクエリによって取得されます。
例 — プレフィックスとサフィックスのマッチング
入力:138****5678
-
^138を使用して、138で始まる電話番号を照合します。 -
5678$を使用して、5678で終わる電話番号を照合します。
例 — 英字の組み合わせ
入力:OpenSearch
ドキュメントは、単語内の任意の単一文字または文字の組み合わせで取得されます。
ピンインフルスペルアナライザー
SHORT_TEXT フィールドの漢字を、完全なピンインのスペルまたは各音節の最初の文字を使用して検索します。映画名や著者名など、完全なピンインまたは短縮ピンインによる検索に適しています。
完全なピンインで検索するには、漢字の完全なピンインを入力します。部分的な音節のスペルはサポートされていません。
サポートされるフィールドタイプ:SHORT_TEXT のみ
例
入力:大内密探007
ドキュメントは、d、dn、dnm、dnmt、dnmt007、da、danei、daneimi、または daneimitan で取得されます。
ドキュメントは an または anei では取得されません。
ピンイン短縮アナライザー
SHORT_TEXT フィールドの漢字を、各ピンイン音節の最初の文字を使用して取得します。このアナライザーは、人名、映画のタイトル、その他同様の短いコンテンツといった、ピンインの頭文字による検索が必要なシナリオで使用します。
サポートされるフィールドタイプ:SHORT_TEXT
例
入力:大内密探007
ドキュメントは、d、dn、dnm、dnmt、dnmt0、dnmt007、m、mt、mt007、または 007 で取得されます。
英語ステミングアナライザー
各トークンをステミングして語幹に戻し、複数形を処理する英語のセマンティックアナライザーです。analyzing や analyzers のような検索で analyze を含むドキュメントに一致させたい場合に使用します。
サポートされるフィールドタイプ:TEXT、SHORT_TEXT
このアナライザーは、クエリ分析設定をサポートしていません。連続する漢字は単一のトークンとして扱われます。
例
入力:English tokenizer english analyzer
ドキュメントは、English tokenizer、english、analyz、analyzer、analyzers、analyze、analyzed、または analyzing で取得されます。
英語非ステミングアナライザー
ステミングを適用せずに、スペースと句読点に基づいて英語テキストをトークン化します。このアナライザーは、書籍のタイトルや著者名といった、正確な単語の一致が必要なフィールドなど、非セマンティックな英語検索シナリオで使用します。
サポートされるフィールドタイプ:TEXT、SHORT_TEXT
このアナライザーは、クエリ分析設定をサポートしていません。連続する漢字は単一のトークンとして扱われます。
例
入力:English tokenizer english analyzer
ドキュメントは、English tokenizer、english、または analyzer で取得されます。
英語細粒度アナライザー
標準の英語アナライザーよりも細かい粒度で、セマンティクスに基づいて英語テキストをトークン化します。複合語をその構成要素に分割する必要がある一般的な業界アプリケーションに適しています。
サポートされるフィールドタイプ:TEXT、SHORT_TEXT
専用アプリケーションでのみ利用可能です。
例
入力:dataprocess
トークン化の結果:data process
ドキュメントは、dataprocess、data process、data、または process で取得されます。
タイ語汎用アナライザー
タイ語テキストを検索単位にトークン化する汎用アナライザーです。一般的な業界アプリケーションに適しています。
サポートされるフィールドタイプ:TEXT、SHORT_TEXT
専用アプリケーションでのみ利用可能です。
例
入力:แหล่งดึงดูดนักท่องเที่ยว
トークン化の結果:แหล่ง ดึง ดูด นักท่องเที่ยว
ドキュメントは นักท่องเที่ยว または แหล่งดึงดูดนักท่องเที่ยว で取得されます。
タイ語 E コマースアナライザー
タイ語の E コマースシナリオ向けに設計されたセマンティックアナライザーです。
サポートされるフィールドタイプ:TEXT、SHORT_TEXT
専用アプリケーションでのみ利用可能です。
例
入力:หน้าจอโทรศัพท์
トークン化の結果:หน้าจอ โทรศัพท์
ドキュメントは、หน้าจอโทรศัพท์、หน้าจอ、または โทรศัพท์ で取得されます。
ベトナム語汎用アナライザー
一般的な業界アプリケーションにおけるベトナム語テキスト向けの汎用アナライザーです。
サポートされるフィールドタイプ:TEXT、SHORT_TEXT
専用アプリケーションでのみ利用可能です。
インドネシア語汎用アナライザー
一般的な業界アプリケーションにおけるインドネシア語テキスト向けの汎用アナライザーです。
サポートされるフィールドタイプ:TEXT、SHORT_TEXT
専用アプリケーションでのみ利用可能です。
韓国語汎用アナライザー
一般的な業界アプリケーションにおける韓国語テキスト向けの汎用アナライザーです。
サポートされるフィールドタイプ:TEXT、SHORT_TEXT
専用アプリケーションでのみ利用可能です。
例
入力:인제군의교육
トークン化の結果:인제군 의 교육
ドキュメントは、인제군의교육、의、または 교육 で取得されます。
韓国語 E コマースアナライザー
E コマースシナリオにおける韓国語テキスト向けに設計されたセマンティックアナライザーです。
サポートされるフィールドタイプ:TEXT、SHORT_TEXT
専用アプリケーションでのみ利用可能です。
例
入力:스포츠캐주얼신발
トークン化の結果:스포츠 캐주얼 신발
ドキュメントは、스포츠、캐주얼、または 신발 で取得されます。
日本語汎用アナライザー
一般的な業界アプリケーションにおける日本語テキスト向けの汎用アナライザーです。
サポートされるフィールドタイプ:TEXT、SHORT_TEXT
専用アプリケーションでのみ利用可能です。
例
入力:メキシコアグーチ
トークン化の結果:メキシコ アグーチ
ドキュメントは メキシコ または アグーチ で取得されます。
日本語 E コマースアナライザー
E コマースシナリオにおける日本語テキスト向けに設計されたセマンティックアナライザーです。
サポートされるフィールドタイプ:TEXT、SHORT_TEXT
専用アプリケーションでのみ利用可能です。
例
入力:ラウンドネックスーツ
トークン化の結果:ラウンド ネック スーツ
ドキュメントは、ラウンド、ネック、または スーツ で取得されます。
シンプルアナライザー
トークン化を完全に制御できます。このアナライザーは、組み込みのアナライザーが要件を満たさない特殊なシナリオで使用します。ドキュメントをプッシュしたり検索を実行したりするときは、タブ文字 (\t) を使用してトークンを区切ります。フィールドのコンテンツと検索クエリは同じ方法でトークン化する必要があります。そうしないと、ドキュメントを取得できません。
サポートされるフィールドタイプ:TEXT、SHORT_TEXT
このアナライザーは、クエリ分析設定をサポートしていません。
例
フィールド値:chrysanthemum\tflower tea\thao
ドキュメントは、chrysanthemum、flower tea、chrysanthemum\tflower tea、flower tea\thao、chrysanthemum\thao、または chrysanthemum\tflower tea\thao で取得されます。
数値アナライザー
時間間隔または数値範囲に基づく検索をサポートします。このアナライザーは、範囲クエリが必要な INT および TIMESTAMP フィールドで使用します。
サポートされるフィールドタイプ:INT、TIMESTAMP
例
query=default:'OpenSearch' AND index:[number1,number2]この例では、index は数値アナライザーで設定されたインデックスフィールドの名前です。
地理位置情報アナライザー
地理的な場所の範囲クエリをサポートします。
サポートされるフィールドタイプ:geo_point のみ
例
query=spatial_index:'circle(116.5806 39.99624, 1000)'このクエリは、円内のポイントを検索して、数キロメートル以内の近くの場所を見つけます。
IT コンテンツアナライザー
IT コンテンツ向けに設計された業界特化型アナライザーです。IT 関連の用語を汎用アナライザーとは異なる方法でトークン化します。たとえば、プログラミング言語名や技術的な略語をより高い適合率で処理します。
サポートされるフィールドタイプ:TEXT、SHORT_TEXT
例
元のコンテンツ:C++ array usage notes
一般的な分析:C++ 配列の使用上の注意
IT コンテンツの分析: C++ 配列の使用上の注意
汎用 E コマース分析
Alibaba DAMO Academy の自然言語処理 (NLP) 技術を活用した、E コマース向けの業界特化型アナライザーです。商品属性の解析やブランド認識など、E コマース検索における一般的な課題を解決します。
サポートされるフィールドタイプ:TEXT のみ
E コマース向け業界特化型拡張版の仕様を使用する専用アプリケーションでのみ利用可能です。
例
入力:Small Gold Tube Concealer Cream
E コマース分析の出力:Small Gold Tube、Concealer、Cream
ゲーム業界向け汎用分析
ゲームコンテンツ向けに設計された業界特化型アナライザーです。
サポートされるフィールドタイプ:TEXT、SHORT_TEXT
ゲーム向け業界特化型拡張版の専用アプリケーションでのみ利用可能です。
例
入力:Genshin equipment
トークン化の結果:Genshin、equipment
ドキュメントは、Genshin equipment、Genshin、または equipment で取得されます。
英語 E コマース汎用アナライザー
E コマースシナリオにおける英語テキスト向けのセマンティックアナライザーです。
サポートされるフィールドタイプ:TEXT のみ
E コマース向け業界特化型拡張版の専用アプリケーションでのみ利用可能です。
カスタムテキストアナライザー
汎用アナライザー、E コマースアナライザー、人名アナライザーなどの業界特化型アナライザーと、カスタムの介入エントリを組み合わせます。このアナライザーを使用して、ドメイン固有の語彙で組み込みのトークン化の動作を拡張します。
サポートされるフィールドタイプ:TEXT、SHORT_TEXT のみ
設定の詳細については、「カスタムテキストアナライザー」をご参照ください。
アナライザーのテスト
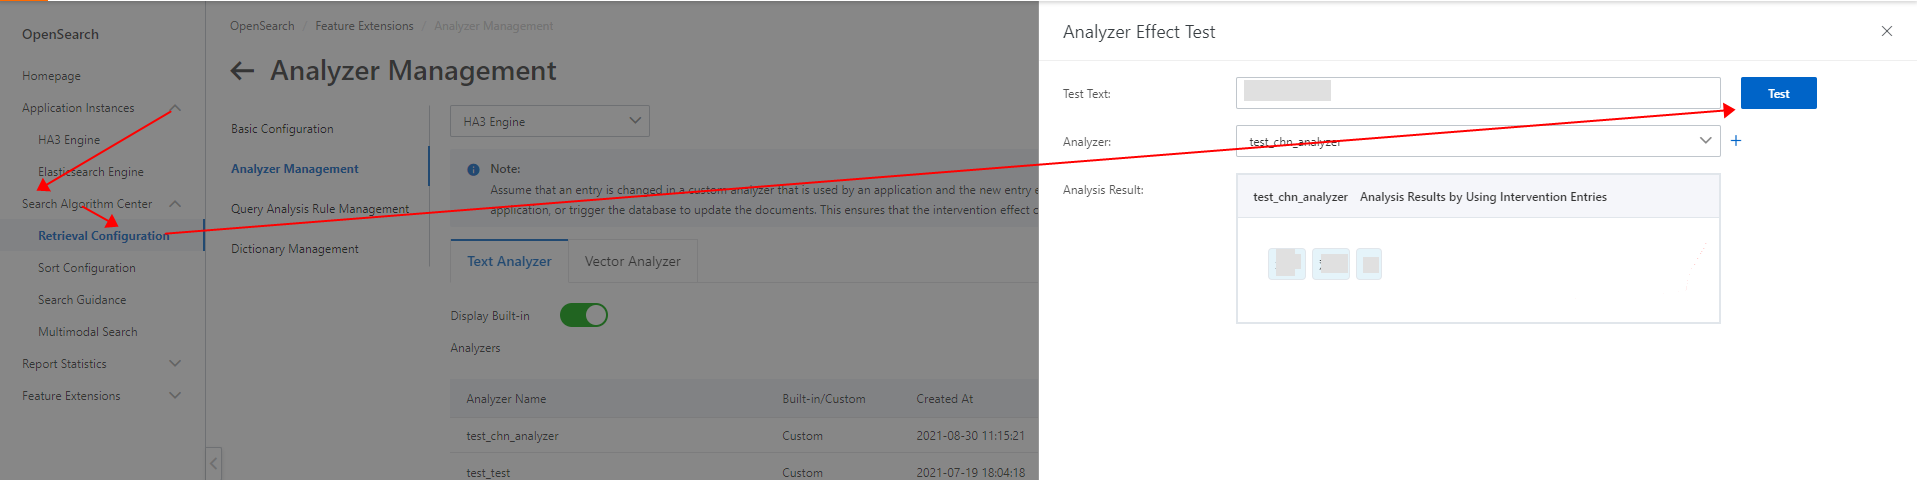
OpenSearch コンソールで、業界特化型アナライザーとカスタムアナライザーのトークン化の結果をテストできます。[検索アルゴリズムセンター] > [取得設定] > [アナライザー管理] へ移動し、[分析テスト] タブをクリックします。
適切なアナライザーの選択
次のガイダンスを使用して、シナリオに適したアナライザーを選択してください。
| シナリオ | 推奨アナライザー |
|---|---|
| セマンティックな中国語検索 (ほとんどの業界) | 中国語汎用アナライザー |
| 非セマンティックな中国語検索または高い再現率が必要な短いテキスト | 中国語シングルキャラクターアナライザー |
| 最大の文字粒度を必要とする中国語検索 | 中国語キャラクターアナライザー |
| ピンイン検索 (フルまたは短縮) | ファジーアナライザー |
| ピンインの頭文字のみによる検索 | ピンイン短縮アナライザー |
| 完全なピンインスペルによる検索 | ピンインフルスペルアナライザー |
| ステミングによる英語のセマンティック検索 | 英語ステミングアナライザー |
| 英語の完全一致単語検索 (タイトル、名前) | 英語非ステミングアナライザー |
| 英語の複合語の分割 | 英語細粒度アナライザー |
| E コマース製品検索 (中国語) | 中国語 E コマースアナライザーまたは汎用 E コマース分析 |
| IT 業界のコンテンツ | IT コンテンツアナライザー |
| 数値または時間範囲クエリ | 数値アナライザー |
| 地理的近接クエリ | 地理位置情報アナライザー |
| タグ、識別子、またはトークン化されていない文字列 | キーワードアナライザー |
| 文字レベルの部分文字列マッチング | N-gram アナライザー |
| カスタムトークン化ロジック | シンプルアナライザー |
再現率と適合率を向上させるためのアナライザーの組み合わせ
中国語検索では、汎用アナライザーとシングルキャラクターアナライザーを組み合わせて、個々の文字を含むドキュメントを取得しつつ、完全なフレーズのランクを高くします。例:
query=title_index:'juhuacha' OR sws_title_index:'juhuacha'このクエリをソート式 text_relevance(title)×5+field_proximity(sws_title) と組み合わせることで、juhuacha の個々の文字が離れていてもドキュメントが取得され、一方で完全なフレーズ juhuacha を含むドキュメントのランクが高くなります。
注意事項
インデックスフィールドでサポートされるフィールドタイプ
| サポート対象 | サポート対象外 |
|---|---|
| INT、INT_ARRAY、TEXT、SHORT_TEXT、LITERAL、LITERAL_ARRAY、TIMESTAMP、GEO_POINT | FLOAT、FLOAT_ARRAY、DOUBLE、DOUBLE_ARRAY |
追加の制約:
-
アプリケーションスキーマのプライマリテーブルのデフォルトのプライマリキーは、
idという名前のインデックスフィールドとして設定されます。この設定は変更できません。 -
TEXT フィールドに検索結果のサマリーが設定されている場合、一部の拡張検索単位のフレーズ (
juhuachaから派生したhuachaなど) は検索結果でハイライト表示されません。 -
中国語シングルキャラクターアナライザーは、数字と英単語を単一のトークンとして扱います。
heの検索では、hello worldを含むドキュメントは取得されません。数字や英語テキストの部分的な単語一致が必要な場合は、ファジーアナライザーを使用してください。