データセットは、モデルのトレーニングと評価の基盤です。Alibaba Cloud Model Studio (Model Studio) のデータ管理機能は、データセットの効率的な作成と管理をサポートします。
データセットの概要
Alibaba Cloud Model Studio の データ管理 は、ビジネスワークスペース内のすべての大規模モデル関連のデータセットを一元管理します。データセットは、トレーニングセット (モデルのファインチューニング 用、SFT/DPO/CPT をサポート) と 評価セット (モデル評価 用) に分けられます。
トレーニングセットは、テキスト生成、マルチモーダル理解、イメージツービデオ (最初のフレーム)、およびイメージツービデオ (最初と最後のフレーム) の 4 つのトレーニングシナリオをサポートします。評価セットは、テキスト生成シナリオのみをサポートします。データセットタイプは作成後に変更できないため、下流の用途に基づいて慎重に選択してください。
データセット名は最大 50 文字 (中国語、英語、数字、アンダースコア、ハイフン、ピリオドをサポート)、説明は最大 200 文字です。空のデータセットの作成や公開はサポートされていません。作成できるデータセットの数に制限はなく、インポートできるデータ量にも上限はありません。
DPO/CPT トレーニング方法とクラウドストレージのマウントは、北京リージョンでのみサポートされています。
トレーニング方法とシナリオ
トレーニングセットは、適用シナリオと最小データ要件が異なる 3 つのトレーニング方法をサポートします。
- SFT (教師ありファインチューニング): 特定のタスクをモデルが解決できるようにする指示ファインチューニングです。1,000 件以上を推奨。すべてのサイトで利用可能です。
- DPO (直接選好最適化): 選好のアライメントトレーニングです。100 件以上を推奨。
- CPT (継続的事前学習): ドメイン知識の注入です。5,000 万トークン以上のデータを推奨。
すべてのトレーニングセットは、作成して送信すると即時に公開されます。先にドラフトとして保存することは現在サポートされていません。過去に作成されたドラフトバージョンは、引き続きオンラインで編集または削除できます。
トレーニング方法 | 目的 | 推奨データ量 | サイトでの利用可否 |
|---|---|---|---|
SFT | 教師ありファインチューニング (指示ファインチューニング) | 1,000 件以上 | すべてのサイト |
DPO | 直接選好最適化 (選好のアライメント) | 100 件以上 | 北京リージョン |
CPT | 継続的事前学習 (ドメイン知識) | 5,000 万トークン | 北京リージョン |
インポート方法
データセットは、適用シナリオと前提条件が異なる 3 つのインポート方法をサポートします。
- ローカルファイルのアップロード: 前提条件なし。ローカルファイルを直接アップロードし、小規模なデータに適しています。
- OSS インポート: 対象バケットにタグ
bailian-datahub-access=readを追加します。大規模なデータに適しています。評価セットではサポートされていません。 - ログバックフロー: SLS の推論ログからトレーニングデータを自動的に抽出します。サービスリンクロールの承認が必要で、推論 → データ → ファインチューニングの強化ループを形成します。
ログバックフローの完全な制限事項 (30 日間の範囲、100,000 件の上限、API キー/モデルフィルター) と承認要件については、ログバックフロー のトピックをご参照ください。
インポートされたデータは、OSS サーバーサイド暗号化 (SSE-OSS、AES256) で自動的に暗号化されます。ログバックフローが利用可能です。制限事項の完全なリストについては、「データセットの概要」をご参照ください。
インポート方法 | 前提条件 | 適用シナリオ | 評価セットのサポート |
|---|---|---|---|
ローカルアップロード | なし | 小規模なデータ | サポート |
OSS インポート | バケットタグ bailian-datahub-access=read | 大規模なデータ | 非サポート |
ログバックフロー | 承認 + API キー/モデルフィルター | 推論ログからトレーニングデータを構築 | サポート |
警告ログバックフローを実行するには、まずサービスリンクロールを承認する必要があります。完全な制限事項と操作の詳細については、ログバックフロー のトピックをご参照ください。
データ準備
高品質なデータを準備することは、モデルファインチューニングの結果の鍵となります。各トレーニング方法 (SFT/DPO/CPT テキスト生成) の推奨データ量については、チューニングデータのアップロードルール をご参照ください。
マルチモーダル理解およびイメージツービデオのトレーニングセットには、公式の推奨データ量はありません。実際のシナリオに基づいて十分なサンプルを準備してください。
データ形式とテンプレート
各トレーニングシナリオ (SFT テキスト/マルチモーダル理解 (画像/動画 → テキスト)、DPO、CPT、評価セット) のデータファイル形式の仕様については、チューニングデータのアップロードルール をご参照ください。
データ管理 のデータセット作成ページで、対応するシナリオのデータテンプレートをダウンロードできます。テンプレートの構造に従ってデータを準備することで、インポートの失敗を防ぐことができます。
データの多様性と拡張戦略については、モデルのファインチューニング のドキュメントをご参照ください。評価セットについては、モデルの汎化能力を客観的に評価するために、重複しない独立したデータセットを準備してください。
データセットの作成
データセットを作成する前に、以下の前提条件を満たす必要があります: Model Studio サービスがアクティブ化されていること。OSS インポートの場合は対象バケットへのタグ bailian-datahub-access=read の追加、ログバックフローの場合はサービスリンクロールの承認が必要です。
データ管理 > Dataset のリストページで、データセットの追加 をクリックし、以下の手順で操作します。
- データセット名 (最大 50 文字) と説明 (最大 200 文字、任意) を入力します。
- データセットタイプを選択します: トレーニングセット または 評価セット (作成後は変更不可)。
- トレーニングシナリオを選択します: テキスト生成、マルチモーダル理解、イメージツービデオ (最初のフレーム)、またはイメージツービデオ (最初と最後のフレーム)。評価セットはテキスト生成のみをサポートします。
- トレーニング方法を選択します: SFT、DPO、または CPT。
- ストレージの場所を選択します: プラットフォーム OSS ストレージ (無料、データ量制限なし) または クラウドストレージのマウント (評価セットでは利用不可)。
- インポート方法を選択してデータをアップロードします: ローカルアップロード、OSS インポート、またはログバックフロー (以下のタブの説明をご参照ください)。
- 送信 をクリックすると、データセットは即時に公開され、作成が完了します。
3 つのインポート方法はそれぞれ異なるタブで操作され、タブごとにフィールドと操作が異なります。SFT テキスト生成および DPO テキスト生成のトレーニングセットは、複数のファイルを同時にアップロードすることが可能です。
パラメーター | 説明 | 必須 | 値の説明 |
|---|---|---|---|
データセット名 | データセットの識別子 | はい | 最大 50 文字。中国語/英語/数字/アンダースコア/ハイフン/ピリオド |
データセットの説明 | データセットの説明 | 最大 200 文字 | |
データセットタイプ | トレーニングセットまたは評価セット。作成後は変更不可 | はい | トレーニングセット/評価セット |
トレーニングシナリオ | データが対応するトレーニングシナリオ | はい | テキスト生成/マルチモーダル理解/イメージツービデオ (最初のフレーム)/イメージツービデオ (最初と最後のフレーム) |
トレーニング方法 | トレーニングアルゴリズムのタイプ | はい | SFT/DPO/CPT |
ストレージの場所 | データセットのストレージ方法 | はい | プラットフォーム OSS ストレージ/クラウドストレージのマウント |
インポート方法 | データのインポートソース | はい | ローカルアップロード/OSS インポート/ログバックフロー |
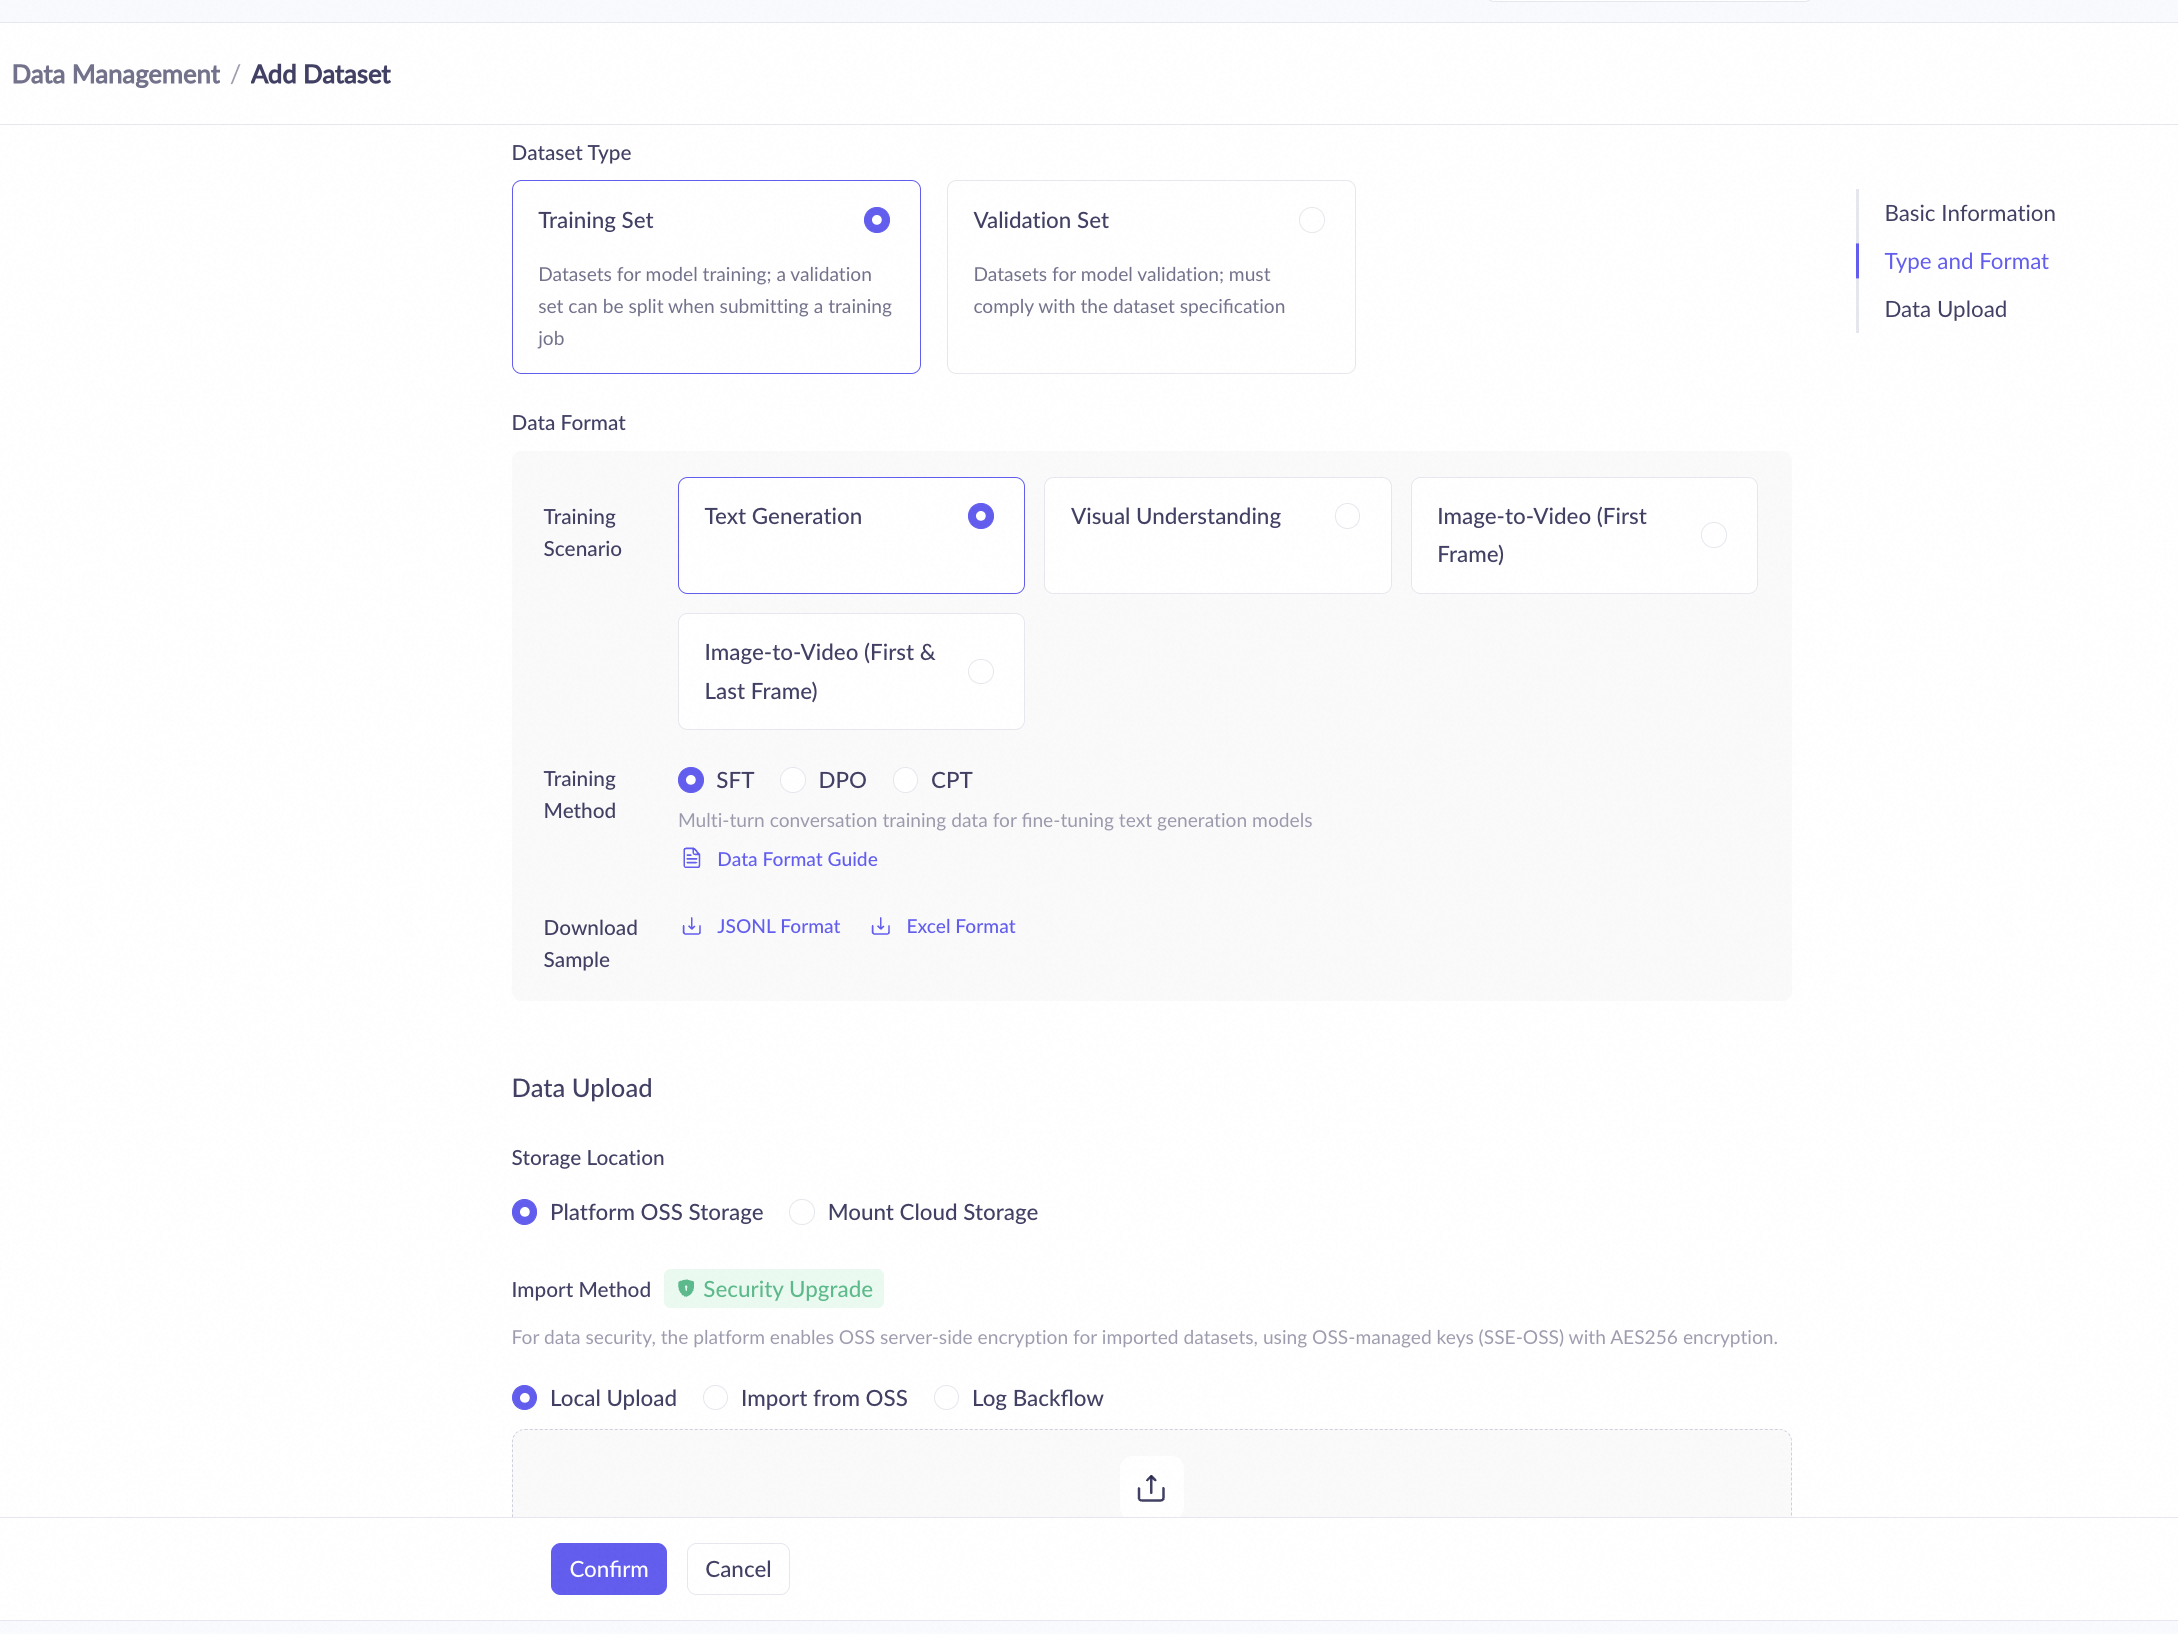
ローカルアップロード
ファイルのアップロード をクリックしてローカルデータファイルを選択します。SFT テキスト生成および DPO テキスト生成は複数ファイルのアップロードをサポートします。ファイル形式はシナリオの要件を満たす必要があり (データ準備 セクションをご参照ください)、インポートされたデータは SSE-OSS で自動的に暗号化されます。
OSS インポート
対象のバケットにタグ bailian-datahub-access=read を追加した後、バケットを選択し、データファイルのパスを指定します。大規模なデータのインポートに適していますが、評価セットではサポートされていません。
ログバックフロー
まずサービスリンクロールを承認します。API キーとモデルを選択し、過去 30 日間の推論ログをフィルタリングします (1 回あたり 100,000 件の上限)。システムはログからトレーニングデータを自動的に抽出し、推論 → データ → ファインチューニングの強化ループを形成します。完全な操作の詳細については、ログバックフローの専用トピックをご参照ください。
バージョン管理
データセットは複数の独立したバージョンを持つことができ、バージョン番号は自動的に増分されます。データセットの詳細ページで、バージョンの追加 をクリックして新しいバージョンを作成します。
バージョンの追加は新規作成モードを採用しており、すべてのデータを再インポートする必要があります。以前のバージョンに基づいてデータを増分的に変更する継承モードは、現在サポートされていません。
- 新規作成モード: すべてのデータを再インポートします。大規模な更新に適しています。
過去に作成されたドラフトバージョンのデータセットは、公開前に データ処理 (データクレンジングとデータ拡張) に使用して、データ品質を向上させることができます。
データセット管理
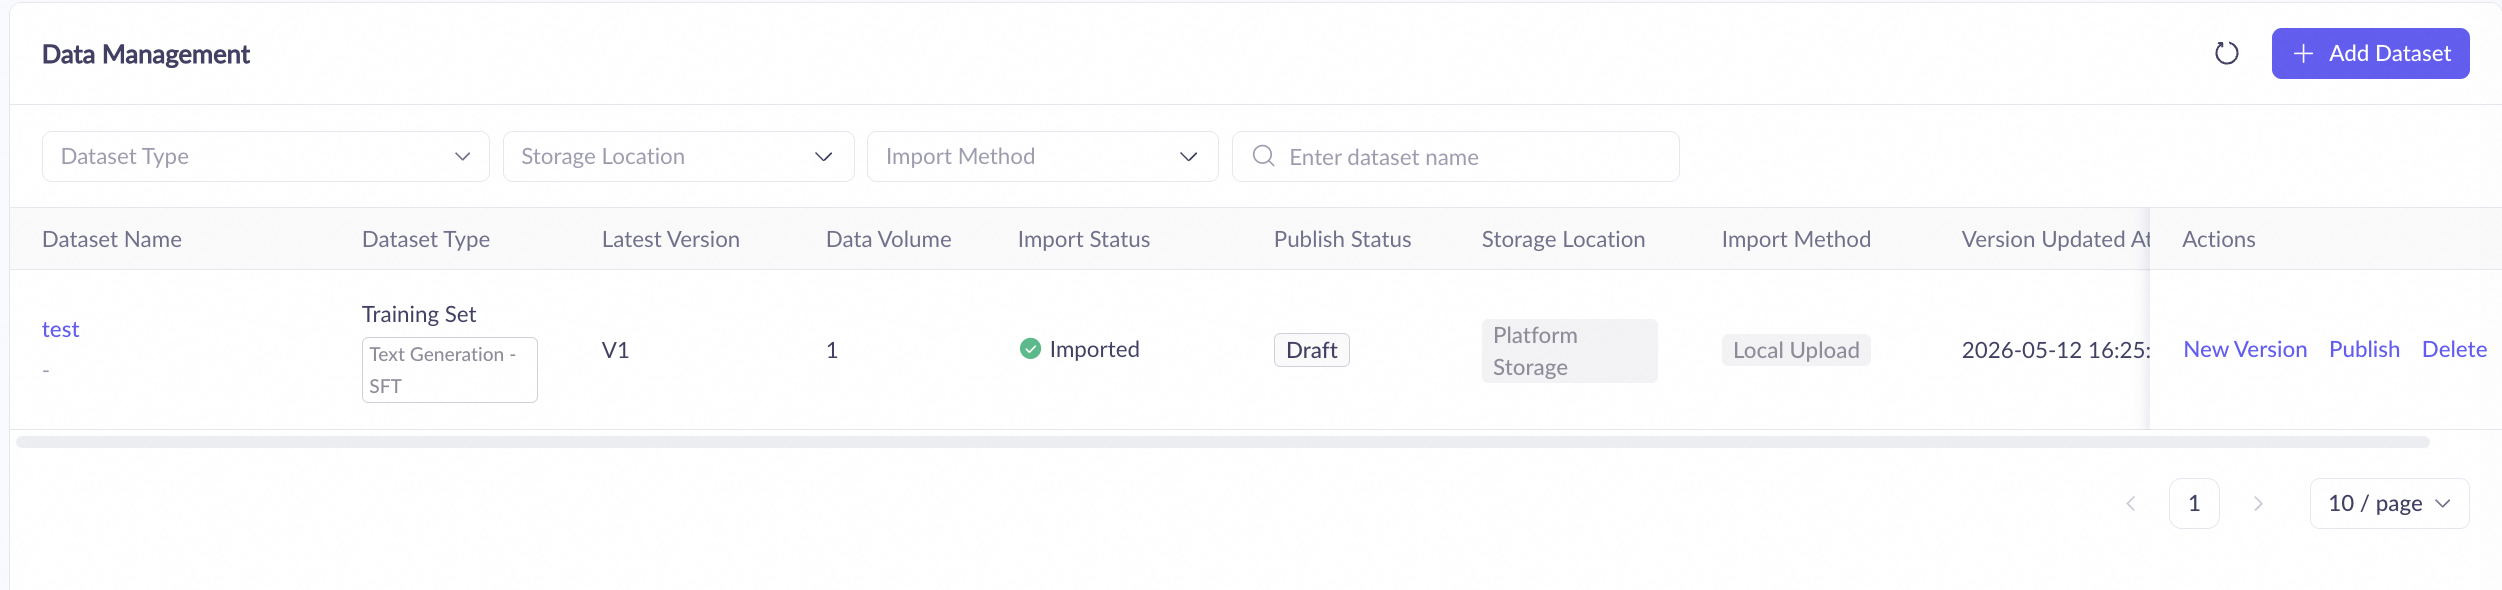
データ管理 > Dataset のリストページでは、すべてのデータセットを表示し、タイプ (トレーニングセット/評価セット) でフィルタリングし、名前で検索できます。インポート中のデータセットは 5 秒ごとにステータスを自動更新するため、手動での更新は不要です。
公開と削除
公開 は元に戻せません。公開されたバージョンは編集できなくなります。公開済みバージョンの 削除 も元に戻せません。削除できるのは、過去に作成されたドラフトバージョンのみです。データセット全体を削除すると、そのすべてのバージョンが削除されます。これらの操作はすべて元に戻せないため、慎重に実行してください。
編集とエクスポート
オンラインで編集できるのは、過去に作成されたドラフトバージョンのみです (Prompt/Completion の内容が編集可能)。新しいデータセットは送信すると即時に公開され、ドラフトバージョンは生成されなくなり、公開済みバージョンの編集はできません。データセットのエクスポートでは、タイプごとに形式が異なります: SFT トレーニングセットは .jsonl、マルチモーダルトレーニングセットは .zip、評価セットは .xlsx としてエクスポートされます。空のデータセットのエクスポートはサポートされていません。
重要公開および削除の操作は元に戻せません。公開されたバージョンは編集できず、削除できるのは過去に作成されたドラフトバージョンのみです。慎重に操作してください。
課金
データ管理機能は無料ですが、データセットのストレージと下流のリソースには料金が発生します。詳細については、Model Studio の課金ページをご参照ください。
- プラットフォーム OSS ストレージ: 料金は Model Studio の課金ページに準じます。
- クラウドストレージのマウント: 料金はユーザー自身の OSS アカウントに課金されます。
- ログバックフロー: 発生した SLS 料金は SLS 製品のアカウントに課金されます。
使用前に Model Studio の課金ドキュメントで最新の価格をご確認ください。
次のステップ
データセットが作成され公開されると、以下の下流シナリオで使用できます。
- トレーニングセットは公開後、モデルのファインチューニング (SFT/DPO/CPT) に使用されます。
- 評価セットは公開後、モデル評価 に使用されます。
ログバックフロー の完全な操作の詳細 (承認フロー、フィルターロジック) については、専用のトピックをご参照ください。
データセットの CRUD は現在コンソールのみでサポートされています。モデルファインチューニング API では、training_file_ids パラメーターを介して公開済みトレーニングセットの ID を参照できます。