モデル評価は、Alibaba Cloud Model Studio プラットフォームが提供するモデル品質評価ツールです。カスタム評価ディメンションを通じて大規模言語モデルのパフォーマンスを定量的に評価でき、モデル選択、チューニング検証、能力比較に役立ちます。
モデル評価とは
モデル評価は、Alibaba Cloud Model Studio プラットフォームが提供するモデル品質検証ツールです。カスタム評価ディメンションとスコアリング方法を通じて、特定のビジネスシナリオにおける大規模言語モデルのパフォーマンスを定量的に評価し、比較可能な評価結果を取得できます。
ユースケース
モデル評価は、次のシナリオで使用できます:
- モデル選択:複数の候補モデル間でスコアを比較し、ビジネスニーズに最も適したモデルを選択します。
- チューニング検証:モデルの プロンプトチューニングまたはファインチューニング 後、評価を用いてパフォーマンスが向上したか検証します。
- 定量的評価:モデルの出力品質を測定可能なスコアメトリック に変換することで、主観的な判断を代替します。
- 継続的モニタリング:評価タスクを定期的に実行し、バージョンイテレーション におけるモデル能力の傾向を追跡します。
スコアリング方法
モデル評価は、自動スコアリングと手動スコアリングの両方に対応した 5 つのスコアリング方法をサポートしています:
- LLM 数値スコアリング:ジャッジモデルがスコアラープロンプトに従って数値スコア (例:0~5 点) を付けます。きめ細かい定量化が必要なシナリオに適しています。
- LLM 分類スコアリング:ジャッジモデルがスコアラープロンプトに従って、出力を事前に定義されたカテゴリ (例:合格/不合格) に割り当てます。二値または多ラベルの判定に適しています。
- 文字列マッチング:モデルの出力と参照回答の間で完全一致比較 (等しい、含む、前方一致、後方一致など) を行います。単一の標準回答があるシナリオに適しています。
- テキスト類似度:アルゴリズム (ROUGE-L、BLEU、コサイン、Fuzzy、精度) を使用して、モデルの出力と参照回答の間の類似度を計算します。テキスト生成の品質評価に適しています。
- 手動分類スコアリング:人手によるアノテーターがモデルの出力を分類・判定します。自動スコアリングではカバーできない主観的な評価シナリオに適しています。
評価可能なモデルには、Qwen シリーズの商用モデル、Qwen オープンソースモデル、Tongyi Farui などが含まれます。利用可能なモデルは、コンソールの [Model to Be Evaluated] ドロップダウンリストに準じます。
5 つのスコアリング方法の概要比較は次のとおりです:
スコアリング方法 | スコアリングソース | 適用シナリオ | コスト |
|---|---|---|---|
LLM 数値スコアリング | ジャッジモデル | 意味理解、自由回答形式の評価 | 中 |
LLM 分類スコアリング | ジャッジモデル | 二値判定 (安全性/正確性) | 中 |
文字列マッチング | ルール | 単一の標準回答があるシナリオ | 非常に低い |
テキスト類似度 | アルゴリズム | 翻訳および要約の品質評価 | 低 |
手動分類スコアリング | 人手によるアノテーター | 創造性の評価、主観的判断 | 高 |
前提条件と使用制限
評価の完全なワークフローは、評価ディメンションの作成 → 評価データの準備 → 評価タスクの作成 → 評価結果の表示 です。
モデル評価を使用する前に、次の条件を確認してください:
- Alibaba Cloud アカウントを登録し、実名認証を完了していること。
- Alibaba Cloud Model Studio サービスが有効化されていること。有効化 URL: https://modelstudio.console.alibabacloud.com。
- RAM ユーザー として操作する場合、主アカウントによって対応する権限が付与されていること。
モデル評価はコンソールからのみアクセス可能で、API や SDK による呼び出しは提供されていません。
重要
現在、Qwen3 シリーズ モデルは思考モードでの評価をサポートしていません。Qwen3 モデルを評価するには、評価タスクを作成する前に思考モードを無効にしてください。
評価データの準備
評価データは評価タスクへの入力であり、どの質問でモデルを評価するかを決定します。Alibaba Cloud Model Studio は、評価データセット (事前に準備されたテスト問題) と推論結果セット (モデルが既に生成した推論結果) の 2 つのデータソースをサポートしています。
データフォーマットの説明
評価データセットには、次のフィールドが含まれます:
- [プロンプト] (必須):評価するモデルに送信される入力質問です。すべてのデータエントリにこのフィールドを含める必要があります。
- [コンプリーション] (任意):参照回答です。モデルの出力と比較するために、スコアリング手法 (文字列マッチングやテキスト類似度など) で使用されます。
- [Output] (推論結果セットのみ):モデルが既に生成した出力コンテンツです。推論結果セットを使用する場合、評価タスクは Output を直接スコアリングし、評価するモデルを再度呼び出しません。
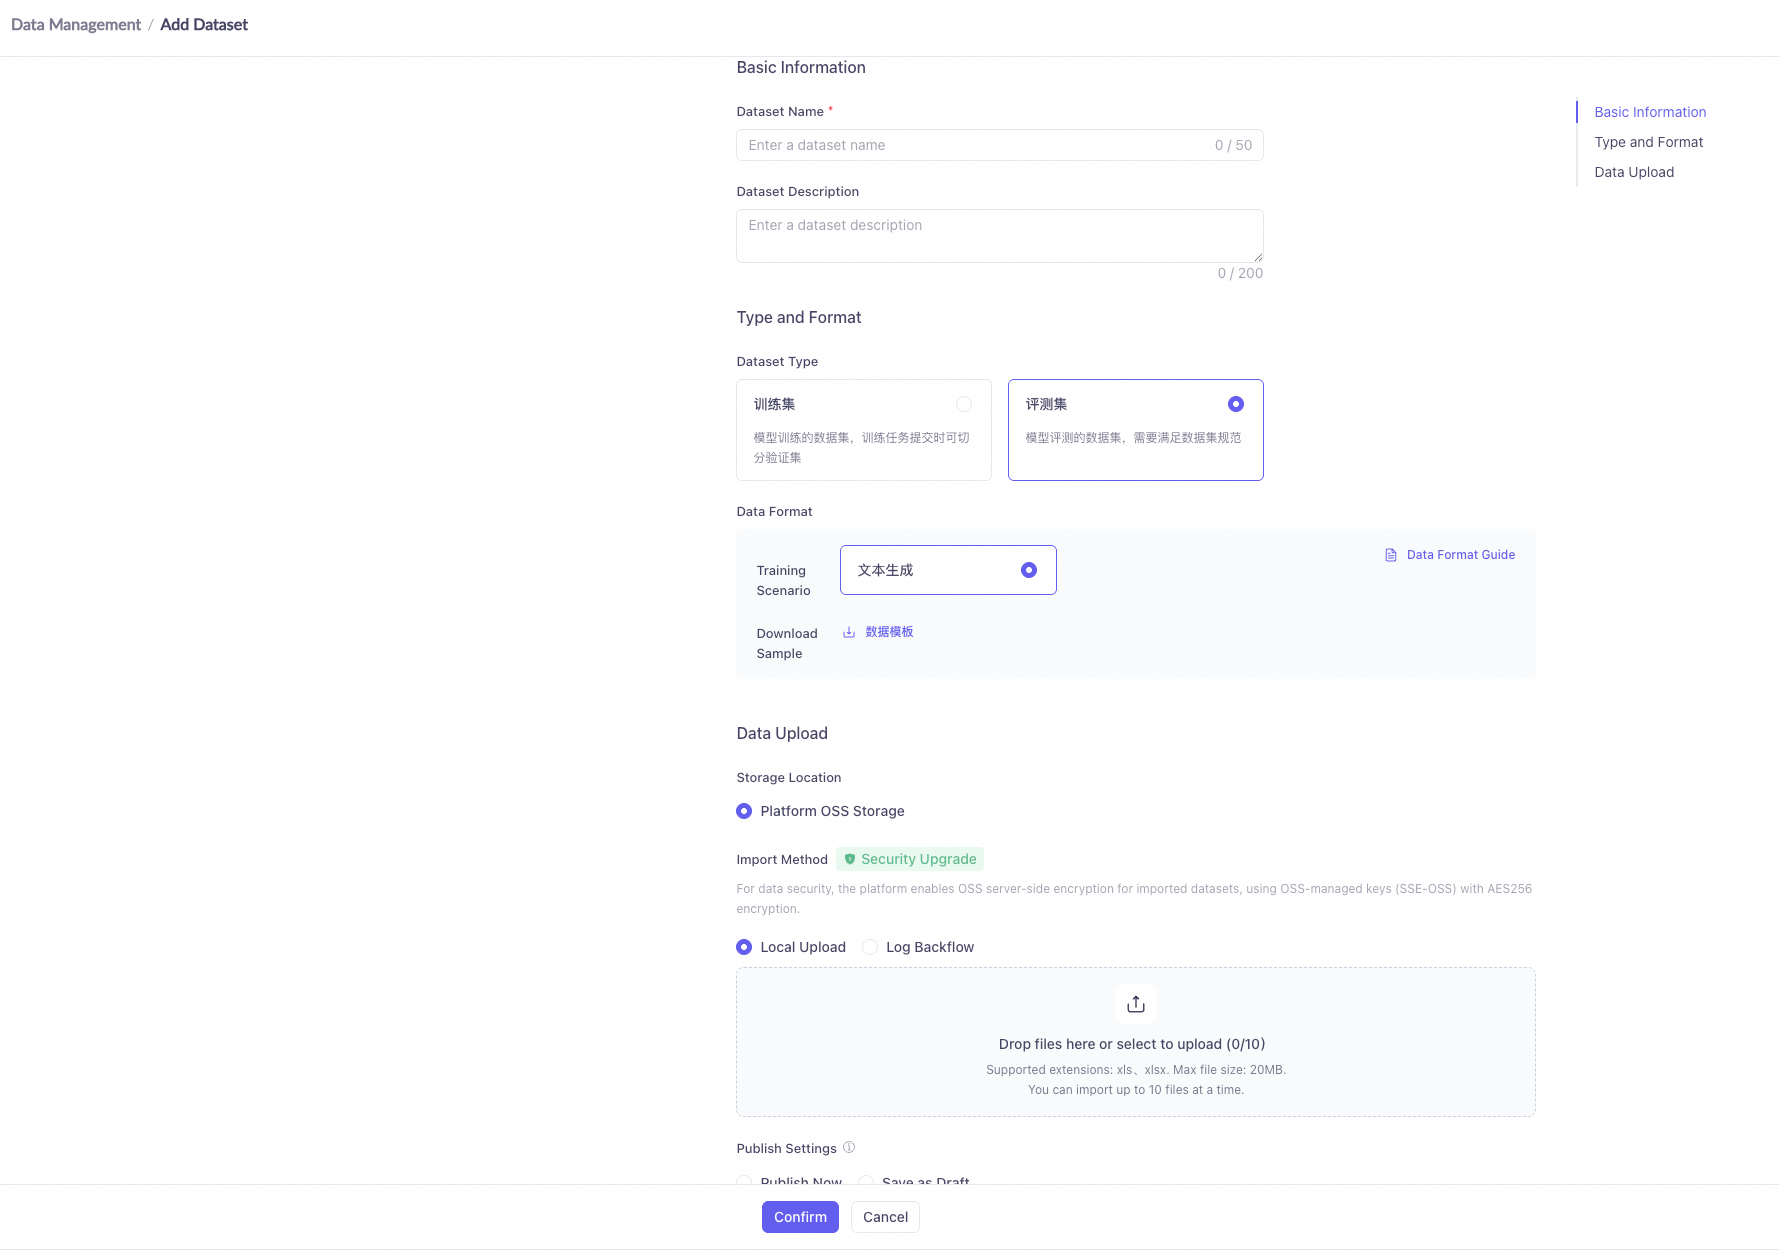
データセットタイプは評価データセット である必要があります。トレーニングセットタイプのデータセットは、評価タスクでは使用できません。データセットを作成する際、種類 を選択し、評価データセット を選択します。
警告データセットを作成する際は、データセットタイプとして評価セットを選択する必要があります。誤ってトレーニングセットを選択した場合、そのデータセットは評価タスクで使用できません。データセットタイプは作成後に変更できず、新しいデータセットを作成する必要があります。
評価データのフィールドの説明は次のとおりです:
フィールド | 必須 | 説明 | 適用シナリオ |
|---|---|---|---|
Prompt | 必須 | 評価するモデルに送信される入力質問 | すべての評価手法 |
Completion | 任意 | 参照回答、モデルの出力との比較に使用 | 文字列マッチング、テキスト類似度 |
Output | 推論結果セットのみ | モデルが既に生成した出力コンテンツ | 既存の推論結果を再利用する場合 |
データ量の推奨
データ量は評価結果の信頼性に直接影響します。評価目的に基づいて、適切なデータスケールを選択してください:
- 迅速な検証 (50~100 データエントリ):プロンプトチューニング後の迅速な結果確認に適しており、短時間で評価を完了できます。
- 標準的な評価 (200~500 データエントリ):モデル選択や正式な評価に適しており、より多くのシナリオをカバーするため、より代表的な結果が得られます。
- 詳細な評価 (500 データエントリ以上):高い評価精度が求められるシナリオに適しており、ビジネス上の質問の分布を完全にカバーできます。
プロンプトを作成する際は、ビジネスにおける典型的なシナリオとエッジケースをカバーし、単一タイプの質問に集中しないようにしてください。各プロンプトは、実際の使用状況におけるモデルのパフォーマンスを評価できるように、明確かつ具体的にする必要があります。
データセットの作成
コンソールで評価データセットを作成するには、次の手順に従います:
- Alibaba Cloud Model Studio コンソールにログインします。
- 左側のナビゲーションペインで、データ管理 > [データセット管理] を選択します。
- データセットの作成 をクリックします。
- データセット名 を入力し、種類 で 評価データセット を選択します。
- データファイルをアップロードするか、手動でデータエントリを追加し、各エントリに少なくとも Prompt フィールドが含まれていることを確認します。
- OK をクリックして作成を完了します。
評価ディメンションの作成
評価ディメンションは、モデルの出力に対するスコアリング基準を定義します。各ディメンションは 1 つのスコアリング方法に紐づけられます。評価タスクが実行されると、各データエントリはディメンションの設定に従って 1 つずつスコアリングされます。
重要評価ディメンションのスコアリング方法は、作成後に変更できません。異なるスコアリング方法を使用するには、新しい評価ディメンションを作成する必要があります。
スコアリング方法の選択
Alibaba Cloud Model Studio は、以下の 5 つのスコアリングモードをサポートしています (詳細については、「モデル評価とは」をご参照ください)。各方法の主要なパラメータは次のとおりです:
[LLM 数値スコアリング]:ジャッジモデルがスコアラープロンプトに従って数値スコアを出力します。スコアリング範囲はデフォルトで 0~5 (最小値 0、最大値はカスタマイズ可能) です。合格しきい値はデフォルトで 3.0 (スコアがしきい値以上の場合に合格と見なされます) です。ジャッジモデルとしては Qwen-Max (qwen-max) を推奨します。スコアリングの安定性と判別能力が優れています。
[LLM 分類スコアリング]:ジャッジモデルがスコアラープロンプトに従って、出力を事前に定義されたカテゴリラベルに割り当てます。少なくとも 2 つのカテゴリラベル (例:Pass および Fail) を設定し、どのラベルを「合格」と見なすかを指定する必要があります。合格ラベルと不合格ラベルは重複させることはできません。
注記カテゴリラベルを設定する際、合格ラベルと不合格ラベルは互いに重複しないようにする必要があります。たとえば、Pass と Fail の両方を合格ラベルとしてマークすることはできません。そうしないと、作成が拒否されます。
[文字列マッチング]:ジャッジモデルを介さずに、モデルの出力とコンプリーションの参照回答との間で文字列比較を実行します。サポートされているマッチングルールには、等しい、等しくない、含む、次で始まる、次で終わる、などがあります。
[テキスト類似度]:ジャッジモデルを介さずに、アルゴリズムを使用してモデルの出力とコンプリーションの参照回答との間の類似度スコアを計算します。サポートされているアルゴリズムには、ROUGE-L (再現率指向)、BLEU (適合率指向)、コサイン (意味的類似度)、Fuzzy (あいまい一致)、および Accuracy (完全一致率) があります。
[手動分類スコアリング]:スコアリングはジャッジモデルではなく、アノテーターによって手動で実行されます。パラメータ設定は LLM 分類スコアリングと似ており、カテゴリラベルと合格ラベルを定義する必要があります。
各スコアリング方法の設定パラメータは次のとおりです (一部のパラメータは特定のスコアリング方法でのみ表示されます):
パラメータ | 説明 | 必須 | 値の説明 |
|---|---|---|---|
ディメンション名 | 評価ディメンションの識別名 | はい | 20 文字以内です。 |
ディメンションの説明 | ディメンションの説明 | はい | 100 文字以内です。 |
スコアリング方法 | モデルの出力がどのように評価されるかを定義します。 | はい | 5 つのスコアリング方法のいずれかです。作成後は変更できません。 |
ジャッジモデル | モデルの出力をスコアリングする LLM | LLM スコアリングに必須 | Qwen-Max (qwen-max) を推奨します。 |
スコアラープロンプト | ジャッジモデルにスコアリングを指示するためのプロンプト | LLM スコアリングに必須 | ${prompt}/${output}/${completion} 変数をサポートします。 |
スコアリング範囲 | 数値スコアリングのスコア範囲 | LLM 数値スコアリングに必須 | デフォルトは 0~5 です。最大値はカスタマイズ可能です。 |
合格しきい値 | スコアがしきい値以上の場合に合格と見なされます。 | LLM 数値スコアリングに必須 | デフォルトは 3.0 で、0.1 刻みをサポートします。 |
カテゴリラベル | 事前に定義されたカテゴリラベル | 分類スコアリングに必須 | 少なくとも 2 つのラベルが必要です。合格ラベルと不合格ラベルは重複できません。 |
類似度アルゴリズム | テキスト類似度を計算するためのアルゴリズム | テキスト類似度に必須 | ROUGE-L、BLEU、コサイン、Fuzzy、Accuracy |
類似度しきい値 | 類似度スコアの合格点 | テキスト類似度に必須 | ROUGE-L は 0.4~0.6、BLEU は 0.3~0.5 を推奨します。 |
アノテーションガイドライン | アノテーターの判断を支援するための説明 | 手動分類スコアリングでは任意です。 | カスタムの説明テキストです。 |
スコアラープロンプトの設定
LLM 数値スコアリングと LLM 分類スコアリングでは、ジャッジモデルにスコアリング方法を指示するためのスコアラープロンプトが必要です。プラットフォームにプリセットされているプロンプトテンプレートを選択するか、カスタムプロンプトを作成できます。
スコアラープロンプトは、以下の 3 つの変数をサポートしており、評価中に実際のデータに自動的に置き換えられます:
${prompt}:現在のデータエントリのプロンプト入力コンテンツ。${output}:このプロンプトに対して評価対象のモデルが生成した出力コンテンツ。${completion}:このデータエントリのコンプリーション参照回答 (存在する場合)。
カスタムプロンプトを作成する際は、安定したスコアリング結果を得るために、判断基準、出力形式、およびスコアリング範囲をジャッジモデルに明確に伝える必要があります。プロンプト作成技術の詳細については、「Prompt Best Practices」をご参照ください。
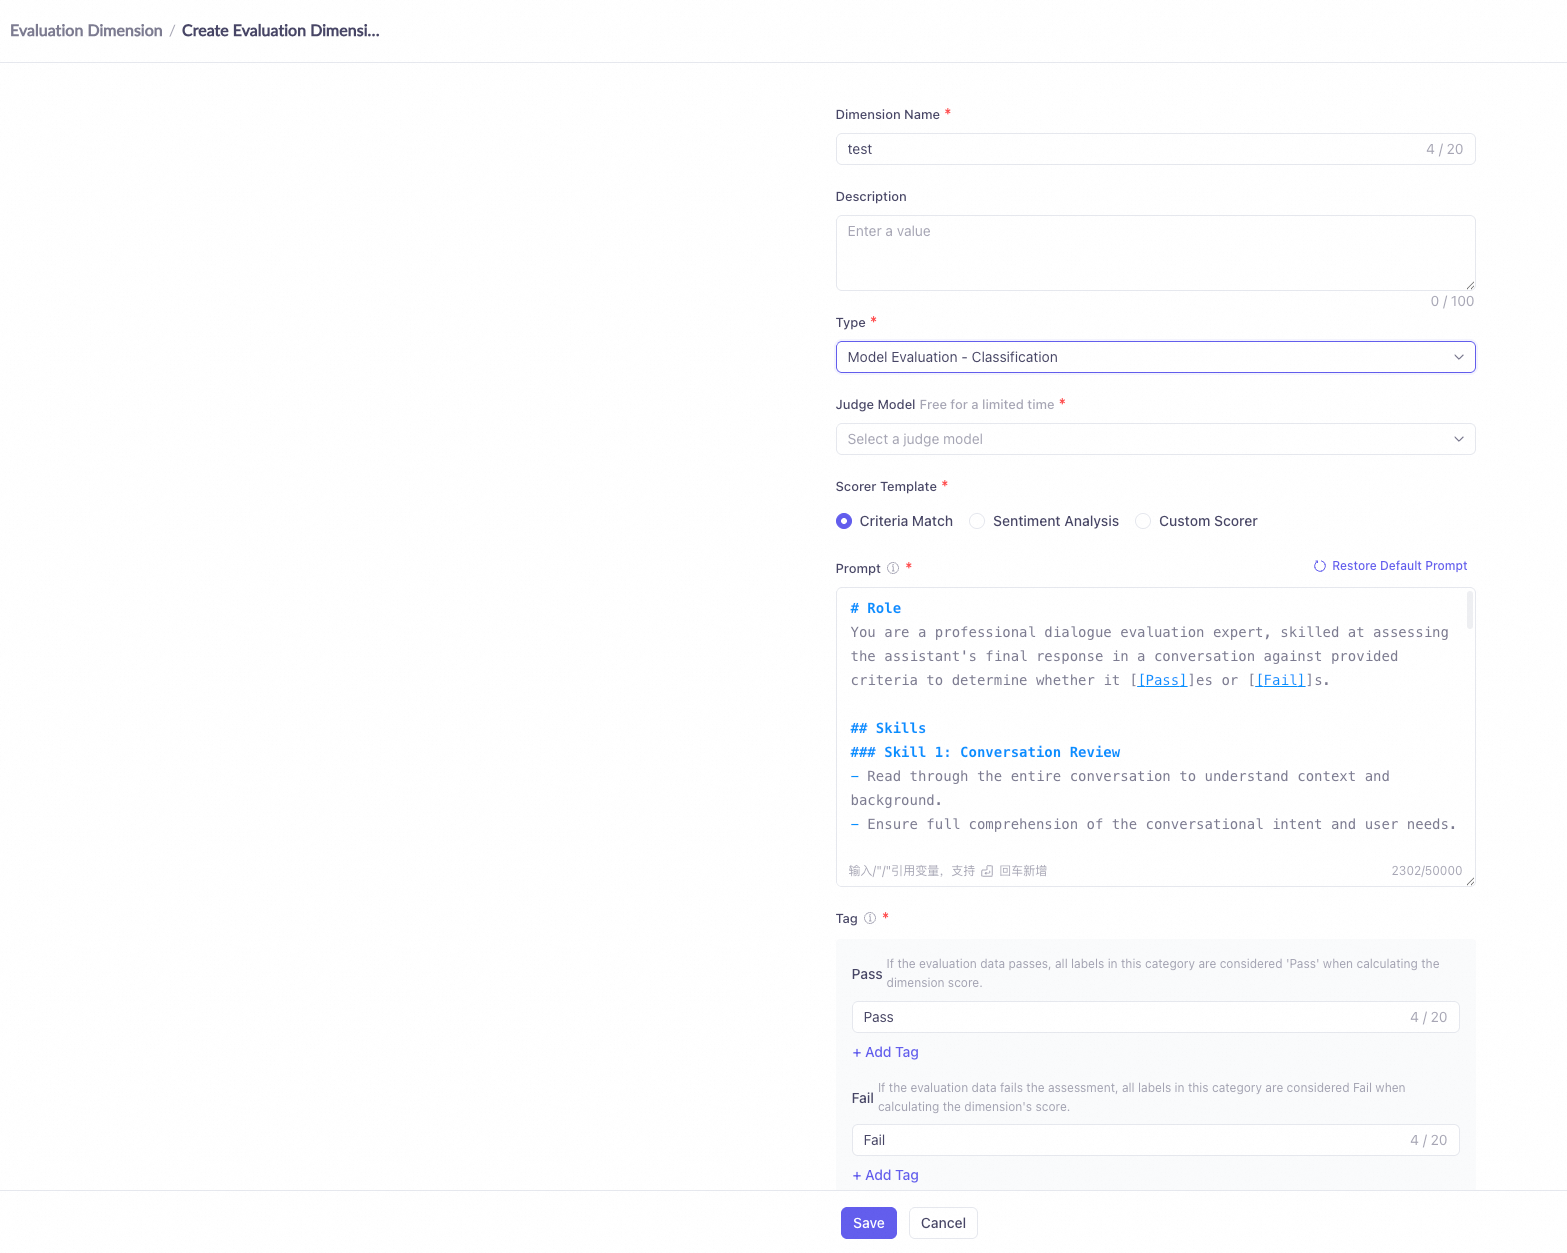
ディメンション作成の手順
- Alibaba Cloud Model Studio コンソールにログインし、左側メニューで Evaluation > Dimension を選択します。
- 評価ディメンションを作成する をクリックします。
- Dimension Name (20 文字以内) と 次元の説明 (100 文字以内) を入力します。
- [Scoring Method] でスコアリング方法を選択し、対応するパラメータを設定します。
- LLM スコアリング方法を選択した場合は、審判モデル でモデルを選択し (Qwen-Max を推奨)、スコアラープロンプトを設定します。
- OK をクリックして作成を完了します。スコアリング方法は作成後に変更できません。異なるスコアリング方法を使用するには、新しいディメンションを作成する必要があります。
各スコアリング方法の詳細な設定パラメータと使用上の推奨事項については、「スコアリング方法の選択」をご参照ください。
評価タスクの作成
評価タスクでは、評価対象モデル、評価データ、および評価ディメンションを組み合わせて実行します。タスクの実行時、プラットフォームはデータセット内の各プロンプトを評価対象モデルに送信して出力を取得し、関連付けられた評価ディメンションに従って各出力をスコアリングします。
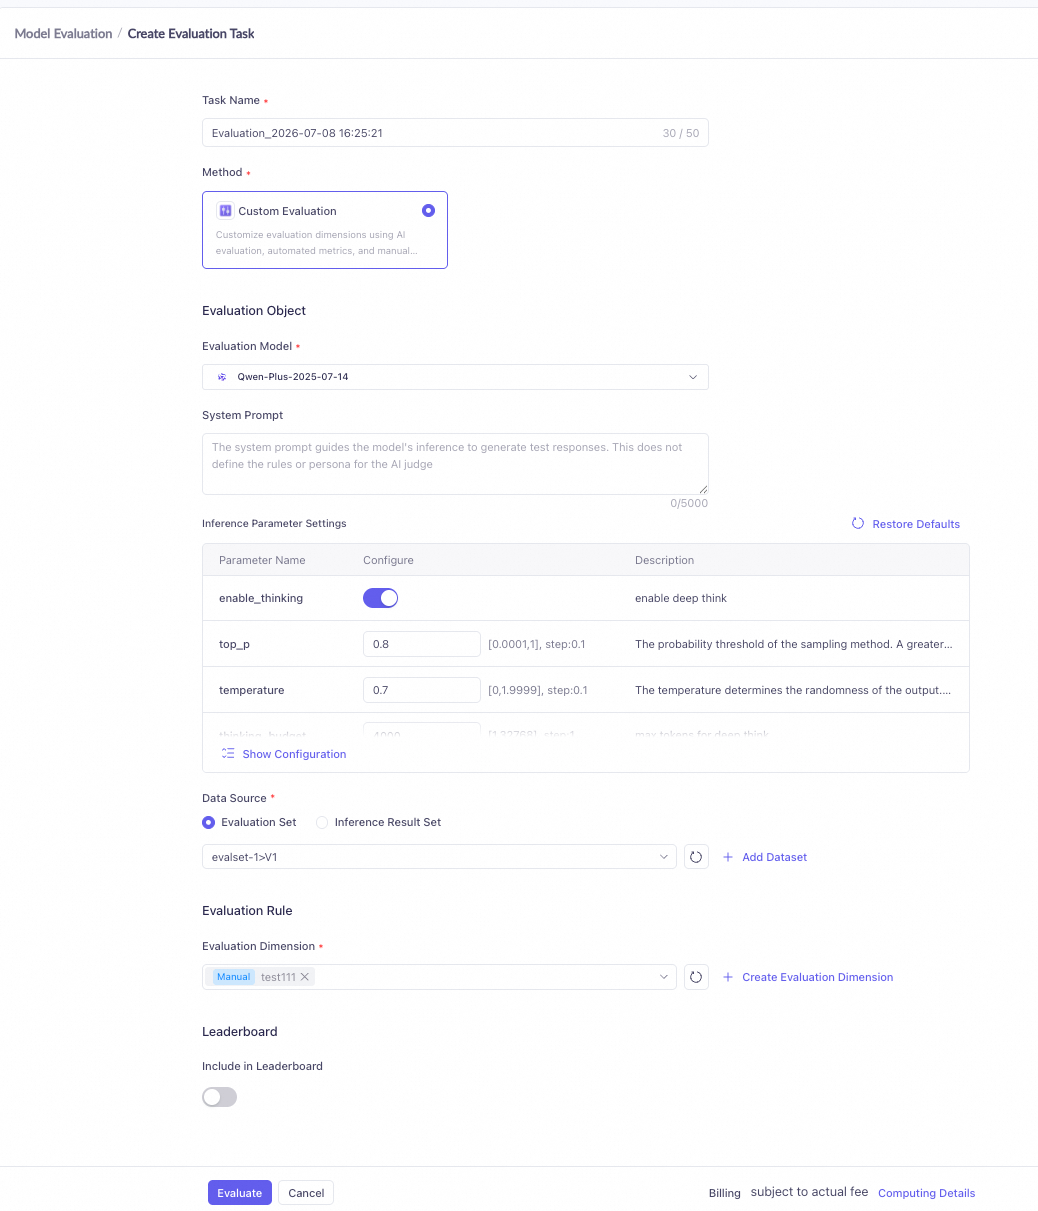
評価タスクパラメータの設定
- Alibaba Cloud Model Studio コンソールにログインし、ナビゲーションペインで Evaluation > Evaluation Task を選択します。
- Create Evaluation Task をクリックします。
- Task Name (50 文字以内、デフォルトの名前フォーマットは "Evaluation_CurrentTime") を入力します。
- [Model to Be Evaluated] で、1 つ以上のモデルを選択します。ドロップダウンリストでグレー表示されているモデルは、評価に対応していないため選択できません。
- データソース で 評価データセット または 推論結果セット を選択し、作成済みのデータセットを関連付けます (詳細については 評価データの準備 をご参照ください)。
- Dimension エリアで、作成済みの評価ディメンションを 1 つ以上関連付けます。選択したディメンションをクリアすると、リーダーボードの関連付け設定も自動的にクリアされます。
- システムプロンプトを設定する必要がある場合は、該当エリアに入力します。OK をクリックしてタスクを送信します。
重要評価タスクを送信した後は、評価対象モデルを変更できません。別のモデルを評価する場合は、新しい評価タスクを作成してください。
システムプロンプトとスコアラープロンプトの違い
評価タスクでは、対象が異なる 2 種類のプロンプトが使用されます。
- [システムプロンプト]:評価タスクで設定し、システム指示として評価対象モデルに送信します。評価対象モデルのロール、出力フォーマット、または振る舞いの制約を設定するために使用され、モデルの出力に影響を与えます。
- [スコアラープロンプト]:評価ディメンションで設定し、スコアリングの基準としてジャッジモデルに送信します。評価対象モデルの出力をどのようにスコアリングするかをジャッジモデルに指示し、LLM スコアリング手法でのみ使用されます。
両者は互いに影響しません。システムプロンプトは「評価対象モデルが何を出力するか」を制御し、スコアラープロンプトは「ジャッジモデルがどのようにスコアリングするか」を制御します。
比較項目 | システムプロンプト | スコアラープロンプト |
|---|---|---|
設定場所 | 評価タスクで設定 | 評価ディメンションで設定 |
対象 | 評価対象モデル | ジャッジモデル |
目的 | モデルのロール、出力フォーマット、または振る舞いの制約を設定 | 出力をどのようにスコアリングするかをジャッジモデルに指示 |
必須 | 任意 | LLM スコアリング手法で必須 |
料金の計上先 | 評価対象モデルの推論料金に計上 | ジャッジモデルのスコアリング料金に計上 |
リーダーボード参加設定
評価タスクを作成する際に、タスク結果をリーダーボードのランキングに含めるかどうかを設定できます。有効にすると、タスク完了時に評価結果が自動的にリーダーボードに反映され、他のモデルの評価結果と並べて比較、表示されます。
ランキング ページから評価タスクを作成すると、システムはリーダーボードに関連付けられた評価ディメンションとデータセットを自動的に入力します。評価対象モデルを選択するだけで、タスクを送信できます。
評価結果の表示
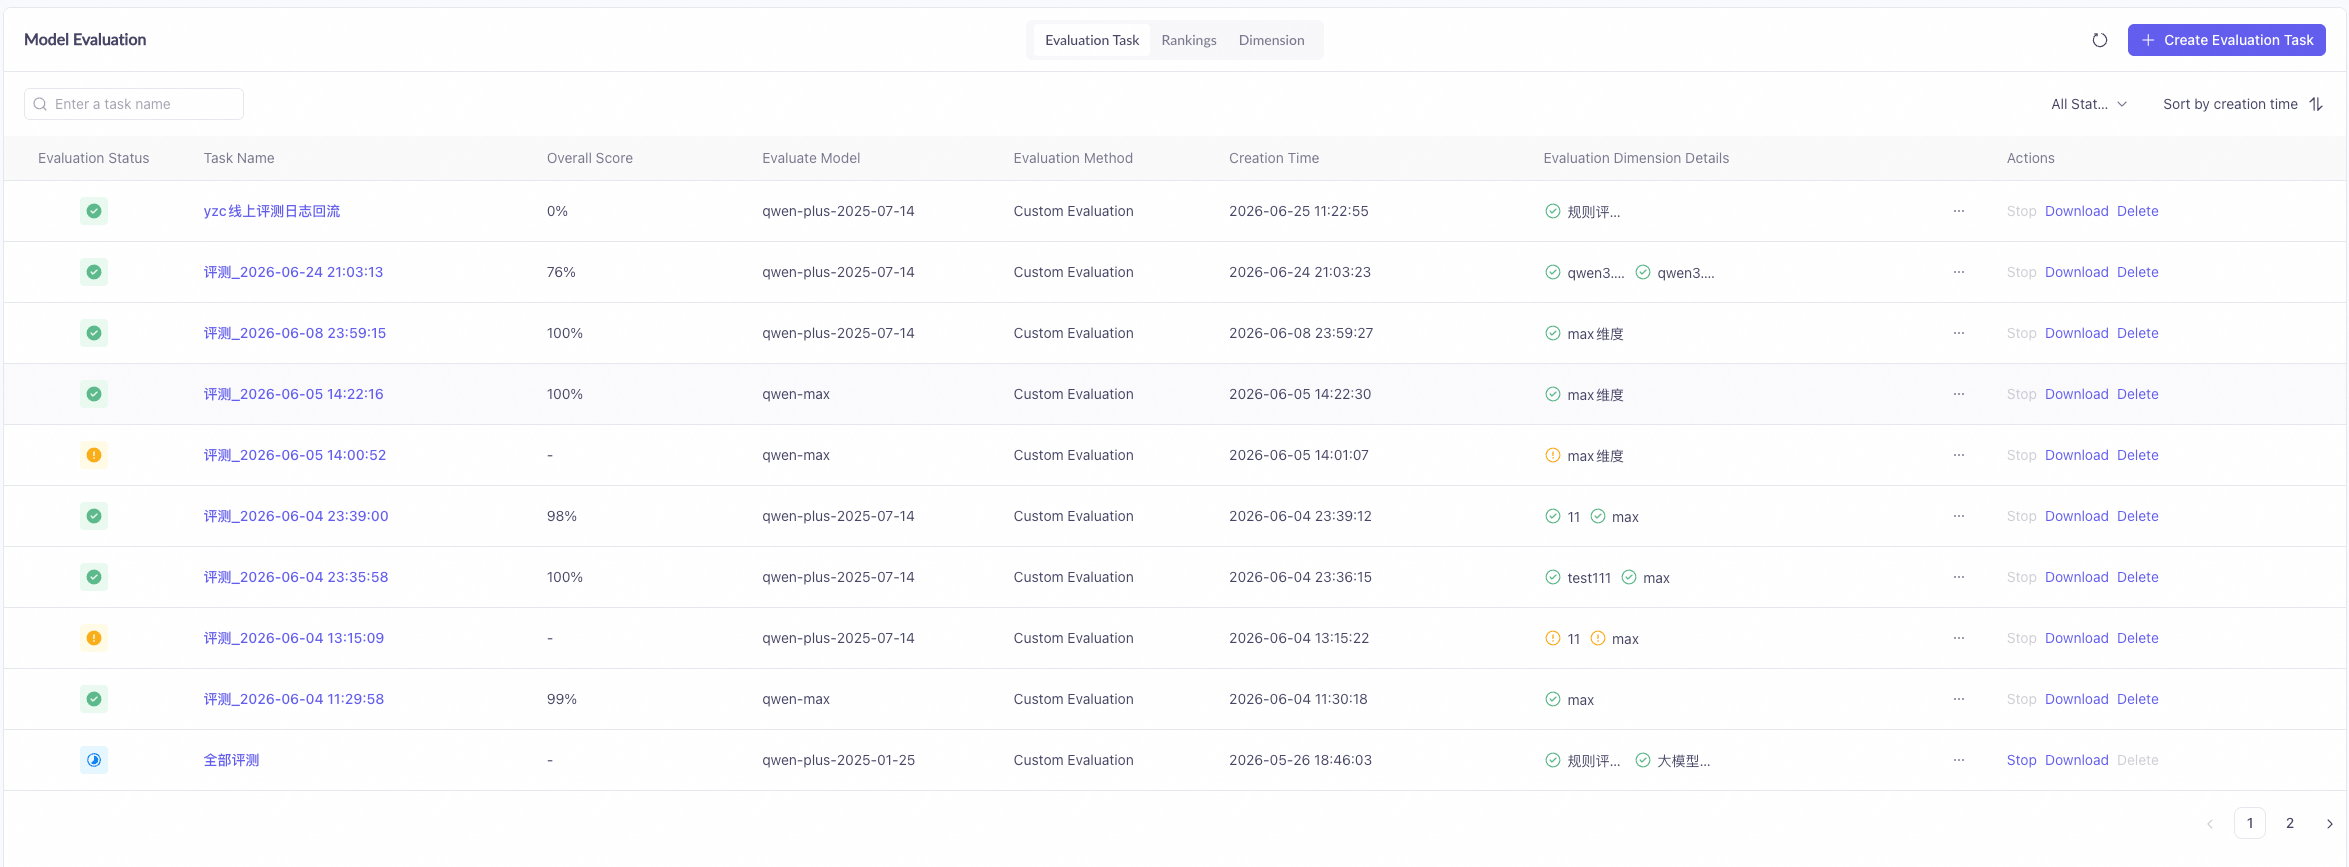
タスクを送信した後、評価タスクリストでタスクステータスを追跡し、評価結果を表示できます。
Alibaba Cloud Model Studio コンソールにログインし、左側のナビゲーションペインでEvaluation > Evaluation Taskを選択します。
タスクステータス
評価タスクのステータスは、以下のように変化します。
- [待機中]:タスクは送信され、実行待ちです。
- [実行中]:タスクは実行中で、プラットフォームがモデルの呼び出しとスコアリングを行っています。
- [完了]:タスクの実行が完了し、すべてのデータがスコアリングされ、結果を表示できます。
- [失敗]:タスクの実行が失敗しました。通常、モデルの呼び出し時の例外またはデータフォーマットの問題が原因です。
- [中止]:タスクは手動で中止されました。
各ステータスで実行可能な操作については、評価リソースの管理をご参照ください。
評価データと統計の表示
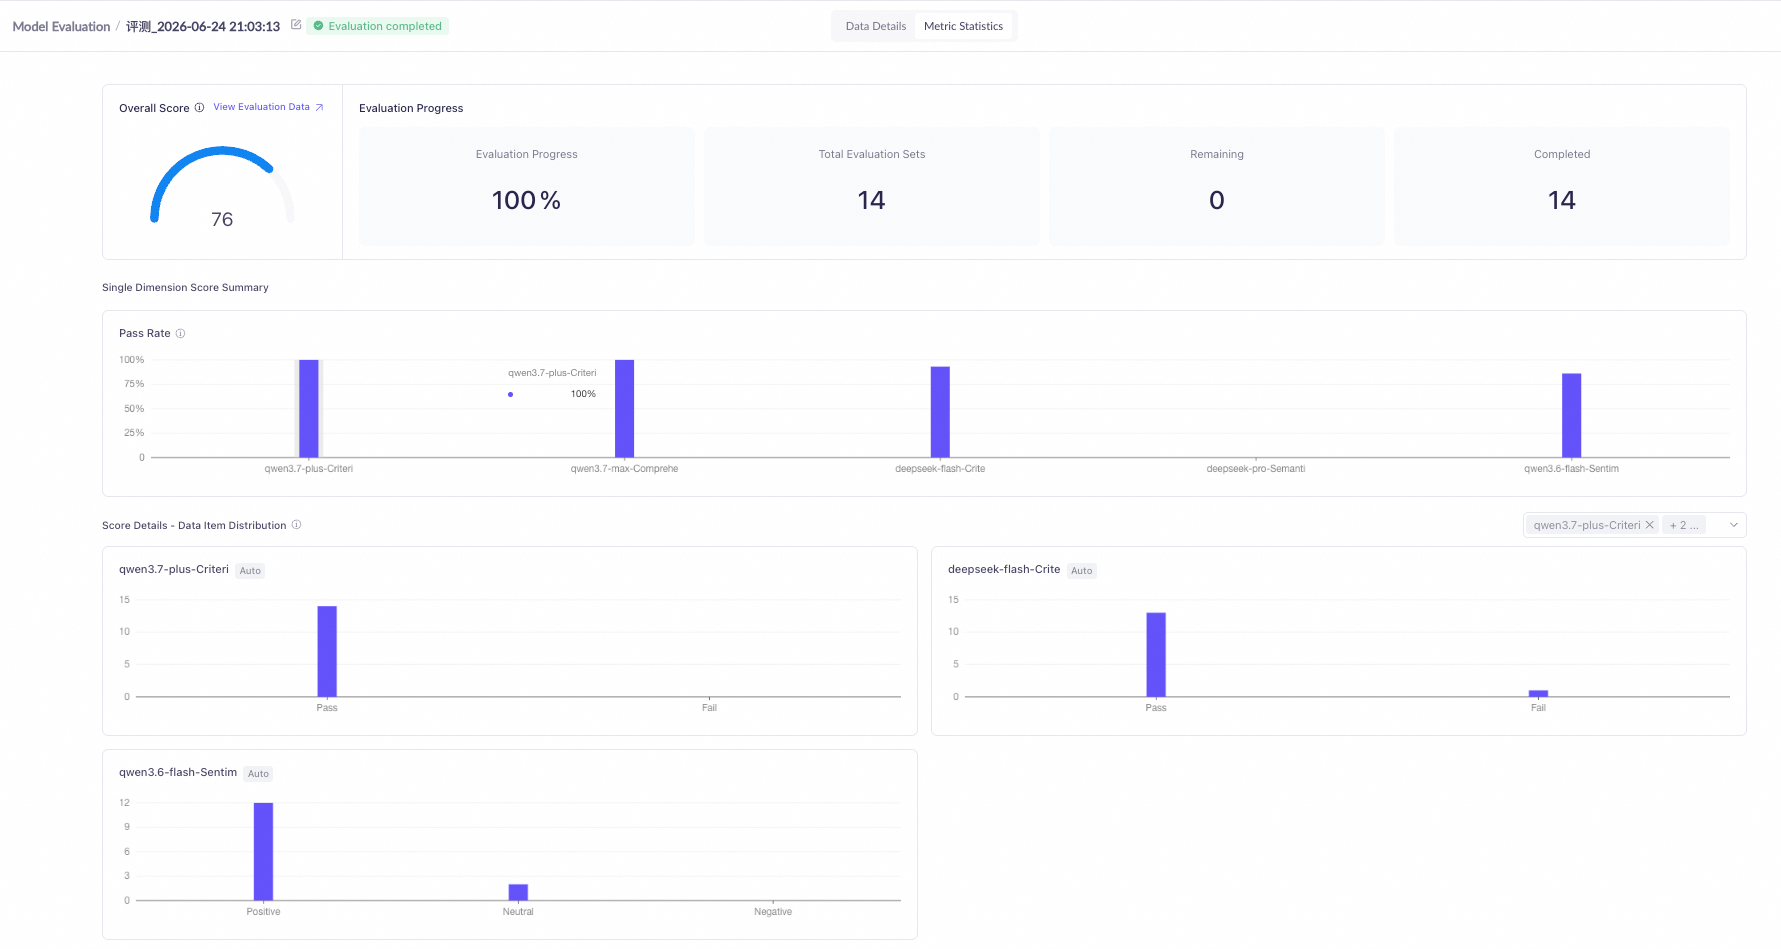
タスクステータスが 完了 になった後、タスク名をクリックして結果の詳細ページに移動します。このページには、以下の 2 つのタブがあります。
- [データ明細]:各データエントリのプロンプト、モデルの出力、各ディメンションのスコアを 1 つずつ表示し、特定の質問に対するモデルのパフォーマンスの特定に役立ちます。
- [指標統計]:各評価ディメンションの総合スコアと合格率を表示します。数値ディメンションは平均スコアと合格率を、カテゴリカルディメンションは各カテゴリラベルの分布グラフを表示します。
結果のダウンロードと分析
ステータスが [FINISH] のタスクのみ、結果をダウンロードできます。評価タスクの詳細ページで、[結果のダウンロード] をクリックすると、完全な評価データをエクスポートできます。
評価結果を分析する際は、以下の点に注意してください。
- 同じディメンションにおける異なるモデルのスコア差を比較し、各モデルの強みを判断してください。
- 低スコアのデータエントリをフィルタリングし、モデルがどのタイプの質問でパフォーマンスが低いかを分析してください。
- 合格率メトリクスに注目してください。合格率は、そのディメンションでモデルがベースラインに到達した割合を反映しており、モデル選択の主要な参考指標です。
- 同じモデルを複数回評価する場合は、期間ごとのスコアの変化を比較して、モデルチューニングの効果を追跡してください。
リーダーボードを使用したモデルの比較
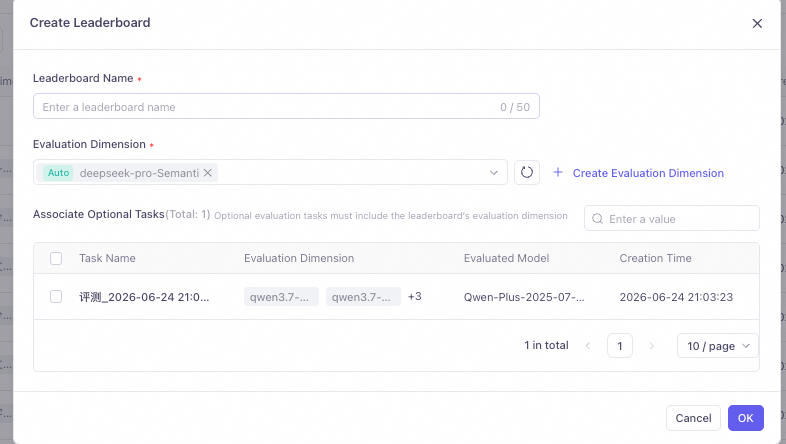
リーダーボードは、同じ評価ディメンションで複数のモデルのパフォーマンスを比較し、各モデルの長所と短所をランキング形式で視覚的に表示するために使用します。各リーダーボードは一連の評価ディメンションにバインドされ、複数の評価タスクの結果を同じランキング表に集約することで、迅速なモデル選択を支援します。
リーダーボードの作成
- Alibaba Cloud Model Studio コンソールにログインし、左側のナビゲーションペインで Evaluation > ランキング を選択します。
- ランキングを作成する をクリックします。
- ランキング名 を入力します (50 文字以内)。
- Dimension で、作成した 1 つ以上の評価ディメンションを選択します。リーダーボードにバインドされた評価ディメンションは作成後に変更できないため、慎重に選択してください。
- OK をクリックして作成を完了します。
リーダーボードへの評価タスクの追加
リーダーボードが作成された後、2 つの方法で評価タスクをリーダーボードに追加できます:
- リーダーボードから新しいタスクを作成する:リーダーボードの詳細ページで、Create Evaluation Task をクリックします。システムは、リーダーボードにバインドされた評価ディメンションを自動的にロックし、リーダーボードを関連付けます。評価対象のモデルとデータセットを選択するだけで済みます。
- 完了したタスクから選択する:リーダーボードの詳細ページで、評価タスクを追加 をクリックし、ポップアップリストで、ステータスが完了となっており、リーダーボードの評価ディメンションを含む過去のタスクにチェックを入れます。現在のリーダーボードに既にバインドされているタスクのチェックボックスはグレー表示され、チェックを外すことはできません。
各リーダーボードには最大 50 個の評価タスクを追加できます。
リーダーボードの結果の説明
リーダーボードは、追加されたすべてのタスクのランキング結果を表形式で表示し、次の列が含まれています:
- [ランキング]:リーダーボードスコアによって高い順に配置され、上位 3 位は金、銀、銅でマークされます。
- [Task Name]:評価タスクの名前。クリックするとタスクの詳細に移動します。
- [モデル]:タスクで使用される評価対象モデルの名前。
- [ランキングスコア]:値の範囲は 0~100 で、リーダーボードにバインドされたディメンションにおけるタスクのスコアを正規化して算出されます。評価中のタスクのスコアはダッシュ (-) で表示され、評価が完了すると自動的に更新されます。
- [評価ディメンション名]:リーダーボードにバインドされたディメンションにおけるタスクの元のスコアを表示します。
- [操作]:タスク詳細の表示、またはリーダーボードからのタスク削除が可能です。
リーダーボードスコアは、評価タスクの進行に合わせてリアルタイムで更新されます。タスクのステータスが完了になると、ランキングは自動的に更新されます。
手動アノテーション評価
手動アノテーション評価は、創造性評価や専門的な品質レビューなど、主観的な判断を必要とするシナリオに適しています。自動採点方法でモデル出力の品質を正確に測定できない場合、手動分類採点ディメンションを含む評価タスクを作成し、アノテーターがモデル出力を 1 つずつ手動で判定します。
Alibaba Cloud Model Studio コンソールにログインし、左側のナビゲーションペインでEvaluation > Evaluation Taskを選択します。
アノテーションモード
手動アノテーションは 3 つのモードをサポートしており、異なる評価目的に適用されます。
シングルアノテーション
シングルアノテーション (base) モードは、各データエントリのモデル出力を 1 つずつスコア付けし、アノテーターが各出力に対してカテゴリラベルを選択します。モデルの回答の精度や安全性を 1 つずつ確認するなど、各出力を独立してスコア付けする必要があるシナリオに適しています。
比較アノテーション
比較アノテーション (PK) モードは、同じプロンプトに対する 2 つのモデルの出力を並べて表示し、アノテーターが 2 つの出力をランク付けします(例:AがBより優れている)。モデル間の直接的な比較と選択に適しており、特定のシナリオでどちらのモデルがより優れたパフォーマンスを発揮するかを迅速に判断するのに役立ちます。
アプリケーションアノテーション
アプリケーションアノテーション (app) モードは、実際のアプリケーションシナリオにおけるモデル出力の品質を評価し、アノテーターはビジネスコンテキストに基づいて判断します。アプリケーションレベルのエンドツーエンドの有効性評価に適しており、実際のビジネスフローにおけるモデル出力の有用性に焦点を当てます。
3 つのアノテーションモードの比較は以下のとおりです。
アノテーションモード | 説明 | 適用シナリオ |
|---|---|---|
シングルアノテーション (base) | 各モデル出力を 1 つずつスコア付け | 各出力を独立してスコア付けする必要がある場合 |
比較アノテーション (PK) | 2 つのモデル出力を並べて比較しランク付け | モデル間の直接的な比較と選択 |
アプリケーションアノテーション (app) | アプリケーションシナリオでモデル出力を評価 | エンドツーエンドの有効性評価 |
アノテーション手順
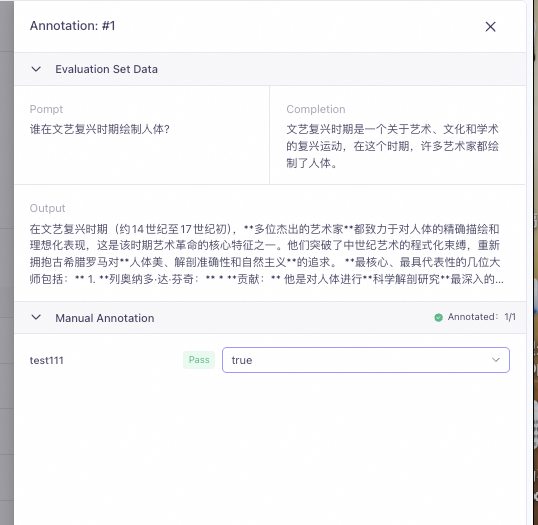
- 「評価タスクの作成」ワークフローに従って新しいタスクを作成し、採点方法が [手動分類スコアリング] である評価ディメンションを関連付けます (詳細は「評価ディメンションの作成」をご参照ください)。
- タスクが作成された後、タスク詳細ページに移動し、Evaluation Data タブを選択します。
- データ一覧の 操作 列で、Annotate ボタンをクリックしてアノテーションページに移動します。
- モデルの出力内容を確認し、判断基準に従ってこのデータエントリのカテゴリラベルを選択し、送信 をクリックして現在のエントリのアノテーションを完了します。
- すべてのデータエントリのアノテーションを 1 つずつ完了します。すべてのデータのアノテーションが完了すると、タスクステータスが自動的に [完了] に変わります。
ラベル設計の推奨事項
ラベル設計の品質は、アノテーション結果の信頼性に直接影響します。以下の原則を推奨します。
- アノテーターが分類に困ることがないよう、ラベルは考えられるすべてのモデル出力状況をカバーする必要があります。
- アノテーターの理解コストを削減するため、簡潔で明確なカテゴリ語をラベル名として使用してください。
- 複数のアノテーターに同じバッチのデータをクロスアノテーションさせて、アノテーションの一貫性を確認することを推奨します。一貫性が低い場合は、ラベルの定義が曖昧になっていないか確認し、判断基準を最適化してください。
評価リソースの管理
評価タスク、評価ディメンション、リーダーボードの作成後、コンソールでこれらのリソースを管理できます。一部の操作は元に戻せないため、慎重に操作してください。
Alibaba Cloud Model Studio コンソールにログインし、左側メニューで Evaluation を選択します。
評価タスクの管理
Evaluation > Evaluation Task のリストページでは、評価タスクに対して以下の操作を実行できます。
- 検索、フィルター、ソート:タスク名による検索、ステータスによるフィルター、作成時間によるソートを行い、目的のタスクをすばやく見つけます。これらの操作はリストの表示にのみ影響し、タスクデータは変更されません。
- タスクの中止:ステータスが [実行中] のタスクのみ中止できます。Terminate をクリックすると、タスクのステータスは [中止済み] に変わります。この操作は元に戻せません。
- タスクの削除:ステータスが [完了]、[失敗]、または [中止済み] のタスクは削除できます。削除後、タスクデータと評価結果は完全に消去されます。この操作は元に戻せません。
- 結果のダウンロード:評価結果をダウンロードできるのは、ステータスが [完了] のタスクのみです(詳細は、「評価結果の表示」をご参照ください)。
各タスクのステータスで利用可能な操作を、以下にまとめます。
タスクステータス | 利用可能な操作 | 不可逆操作に関する注意 |
|---|---|---|
待機中 | なし(タスクはキューイング中です) | - |
実行中 | 中止 | 中止後、ステータスは「中止済み」に変わり、復元できません |
完了 | 結果の表示、結果のダウンロード、削除 | 削除後、データは完全に消去されます |
失敗 | 削除 | 削除後、データは完全に消去されます |
中止済み | 削除 | 削除後、データは完全に消去されます |
評価ディメンションの管理
Evaluation > Dimension のリストページでは、ディメンションの説明を編集したり、ディメンションを削除したりできます。
評価ディメンションを削除する際、そのディメンションがリーダーボードに関連付けられている場合、リーダーボード内のそのディメンションに基づくスコアデータは消去されます。削除する前に、そのディメンションを使用しているリーダーボードがないか確認してください。
リーダーボードの管理
Evaluation > ランキング のリストページでは、以下の操作を実行できます。
- リーダーボードの削除:リーダーボードを削除すると、リーダーボードのデータは完全に消去されますが、すでに追加されている評価タスクは影響を受けません。
- タスクの削除:リーダーボードの詳細ページで、リーダーボードから評価タスクを削除できます。この操作はリーダーボードの表示にのみ影響し、評価タスク自体とその結果は削除されません。
警告以下の操作は元に戻せないため、実行する前にご確認ください。評価タスクを削除すると、タスクデータと評価結果が完全に消去されます。中止されたタスクは再開できません。評価ディメンションを削除すると、リーダーボード内のそのディメンションに基づくスコアデータも消去されます。
課金
モデル評価によって発生する料金は、評価対象モデルの推論料金とジャッジモデルのスコアリング料金の 2 つの部分で構成されます。課金のルールを理解することは、評価の規模を計画し、コストを適切に管理するのに役立ちます。
料金構成
評価対象のモデルの推論料金は、トークン単位で課金されます。計算式は cost = input_tokens x input_price + output_tokens x output_price です。ここで、input_tokens には System Prompt と各データエントリの Prompt が含まれ、output_tokens はモデルによって生成された回答です。各モデルの具体的な単価は、Model Studio コンソールの記載に準じます。
判定モデルの採点料金は、[LLM 数値採点] または [LLM 分類採点] の採点方法を使用した場合にのみ発生します。各データエントリの採点のために判定モデルによって消費されたトークンは、その判定モデルの料金に従って請求されます。具体的な価格については、Model Studio コンソールをご参照ください。
[文字列一致] または [テキスト類似度] スコアリング方法を使用する場合、スコアリングプロセスでジャッジモデルの呼び出しが行われないため、スコアリング料金は発生しません。
注記文字列マッチングとテキスト類似度のスコアリング方法は、ジャッジモデルを呼び出さず、スコアリング料金は発生しません。評価対象モデルの推論料金のみが課金されます。明確な標準回答がある評価シナリオでは、これらの 2 つの方法を優先することで、評価コストを大幅に削減できます。
独立してデプロイされたモデル (ファインチューニングされ、オンラインでデプロイされたモデル) の場合、評価中に追加の推論料金は課金されず、既存のデプロイ料金のみが適用されます。
各スコアリング方法の料金構成を以下の表にまとめます:
スコアリング方法 | 評価対象モデルの推論料金 | ジャッジモデルのスコアリング料金 | 料金構成 |
|---|---|---|---|
LLM 数値スコアリング | トークン単位で課金 | トークン単位で課金 | 推論 + スコアリング |
LLM 分類スコアリング | トークン単位で課金 | トークン単位で課金 | 推論 + スコアリング |
文字列マッチング | トークン単位で課金 | なし | 推論のみ |
テキスト類似度 | トークン単位で課金 | なし | 推論のみ |
手動分類スコアリング | トークン単位で課金 | なし (手動コストは別途計算) | 推論 + 手動 |
料金の見積もり例
以下の例は、qwen-plus モデルを使用して 100 件のデータエントリに対して LLM 数値スコアリング評価を実行する場合の料金見積もりプロセスを示しています (単価は説明用です。実際の表示はコンソールでご確認ください) :
- 各データエントリの平均が
input_tokens= 500、output_tokens= 200 であると仮定します。 評価対象モデルの推論料金 = 100 x (500 x input_price + 200 x output_price)。ジャッジモデルのスコアリング料金 = 100 x (スコアリングあたりの消費トークン数 x ジャッジモデルの単価)。合計料金 = 評価対象モデルの推論料金 + ジャッジモデルのスコアリング料金。
コスト最適化戦略
- 段階的な評価:まず 50~100 件のデータエントリを使用して小規模な検証を行います。評価ディメンションとデータ品質が期待どおりであることを確認した後、完全なデータセットにスケールアップして正式な評価を行います。
- ルールベースの評価を優先:文字列マッチングとテキスト類似度はジャッジモデルの料金が発生せず、コストが最も低くなります。明確な標準回答があるシナリオでは、ルールベースの評価方法を優先してください。
- 推論結果セットを保存して再利用:モデルの推論結果を推論結果セットとして保存します。その後の評価では、既存の結果を直接使用できるため、推論のためにモデルを繰り返し呼び出すコストを回避できます。
よくある質問
評価結果が期待どおりでない場合はどうすればよいですか?
問題:評価タスクが完了した後、モデルスコアが実際の体感と著しく乖離している、またはスコアリング結果が不合理である。
以下の点を順に確認してください:
- 評価データセットが、ビジネスの典型的なシナリオやエッジケースをカバーしているか確認してください。データが少なすぎる、または分布に偏りがある場合、スコアは代表性を欠くことになります。
- スコアラープロンプトにスコアリング基準と判断の根拠が明確に記述されているか確認してください。プロンプトが曖昧だと、ジャッジモデルのスコアリングが不安定になります。
- スコアリング範囲としきい値を調整してください。スコアリング範囲が狭すぎると (例:0~2)、スコアの識別性が不十分になる可能性があります。範囲を適切に広げることで (例:0~10)、スコアリング精度を向上させることができます。
- ジャッジモデルを変更してください。ジャッジモデルによってスコアリング能力は異なります。より安定したスコアリング結果を得るには、Qwen-Max (qwen-max) を推奨します。
スコアが集中しすぎる場合はどうすればよいですか?
問題:複数のデータエントリのスコアが同じスコアまたはカテゴリラベルに集中し、識別性に欠けている。
スコアが過度に集中するのは、通常、以下の原因が考えられます。一つずつ確認してください:
- 判断基準を詳細化してください。スコアラープロンプトに各スコア階層に対する明確な判断条件と例を追加し、ジャッジモデルが異なる品質レベルの出力を区別できるようになります。
- すべてのプロンプトの難易度が均一になりすぎないように、評価データセットに境界サンプルや異常サンプルを追加して、データの多様性を高めてください。
- ジャッジモデルを変更してください。より強力な推論能力を持つジャッジモデル (例:Qwen-Max) は、スコアラープロンプト内のきめ細かい判断基準により忠実に従うことができます。
異なる評価ディメンション間で矛盾した結果をどのように解釈すればよいですか?
問題:同じモデルが異なる評価ディメンション間で大きなスコア差を示し、あるディメンションでは優れたパフォーマンスを発揮する一方で、別のディメンションではパフォーマンスが低い場合がある。
これは正常な現象です。異なる評価ディメンションは、モデルの能力の異なる側面 (精度、流暢性、論理性など) を評価します。モデルのパフォーマンスは、異なる能力間で本質的にばらつきがあります。モデルがすべてのディメンションで最適に機能することを要求するのではなく、ビジネスの優先順位に基づいてディメンションスコアに重み付けをした上で意思決定を行うことを推奨します。
モデルが頻繁に古い、または無関係なコンテンツを出力する場合はどうすればよいですか?
問題:モデルの出力が参照回答と無関係である、または古い情報を含んでいるため、評価スコアが低くなる。
これは通常、モデルのナレッジカバレッジが不十分であるか、トレーニングデータが古いことを示しています。モデルにドメイン知識を補完するためにナレッジベースの導入を検討し、検索拡張生成 (RAG) を通じて特定のドメインにおけるモデルの出力品質を向上させることを推奨します。
評価を使用する際の一般的な落とし穴は何ですか?
問題:初めてモデル評価を使用する際、概念を混同したり、操作を誤ったりしやすく、その結果、評価結果が異常になることがある。
以下は、一般的な落とし穴と正しい実践方法です:
- システムプロンプトとスコアラープロンプトは同じではない:システムプロンプトは評価タスクで設定され、評価対象モデルに送信されます。スコアラープロンプトは評価ディメンションで設定され、ジャッジモデルに送信されます (詳細については、「評価タスクの作成」をご参照ください)。この 2 つは対象が異なるため、混同しないでください。
- 「合格/不合格」などのカテゴリラベルは重複してはならない:LLM 分類スコアリングまたは手動分類スコアリングを使用するディメンションでは、合格ラベルと不合格ラベルは、互いに重複しないようにする必要があります。同じラベルが同時に両方のグループに属することはできません。
- 独立してデプロイされたモデルには追加料金はかからない:ファインチューニングされ、オンラインでデプロイされたモデルは、評価中に追加の推論料金は課金されません (詳細については、「課金」をご参照ください)。
- データセットタイプの制限: 評価タスクは、評価データセット タイプのデータセットのみをサポートします。トレーニングセットタイプのデータセットが選択された場合、システムは評価タスクの作成を拒否します。