このトピックでは、MaxCompute がサポートする MapReduce プログラミングインターフェイスとその制限について説明します。
MapReduce とは
MapReduce は、典型的な分散コンピューティングフレームワークです。 分割統治法を用いて、大規模または複雑な問題を扱いやすい小さなサブ問題に分割します。 これらのサブ問題を解決し、その結果を統合して最終的な解を得ます。 従来の並列プログラミングフレームワークと比較して、MapReduce は、高いフォールトトレランス、使いやすさ、優れた拡張性などの利点があります。 MapReduce で並列プログラムを実装する場合、データストレージやノード間の通信メカニズムなど、分散クラスターの基盤となる詳細を考慮する必要はありません。 これにより、分散プログラミングが簡素化されます。
次の図は、MapReduce のワークフローを示しています。
MaxCompute は、2 つの MapReduce プログラミングインターフェイスを提供します:
MaxCompute MapReduce:これはネイティブの MaxCompute API です。 このバージョンは高速に実行され、ファイルシステムを公開しないため、開発が簡素化されます。
MaxCompute 拡張 MapReduce (MR2):このバージョンは、より複雑なジョブスケジューリングロジックをサポートし、その実装はネイティブの MaxCompute インターフェイスと一致しています。 従来の MapReduce と比較して、この拡張モデルは、基盤となるスケジューリングモデルと I/O モデルを変更し、ジョブ実行中の冗長な I/O 操作を回避します。
これらのバージョンは、用語、ジョブの投入、入出力、リソース使用量の点でほぼ一貫していますが、Java SDK は異なります。 詳細については、「Hadoop Map/Reduce チュートリアル」をご参照ください。
MapReduce を使用して外部テーブル内のデータを読み書きすることはできません。
MapReduce
シナリオ
MapReduce は、次のシナリオをサポートします:
検索:Web クローリング、転置インデックス、PageRank。
Web アクセスログの分析:
閲覧やショッピングなどのユーザー行動を分析・マイニングし、パーソナライズされたレコメンデーションを提供します。
ユーザーのアクセスパターンを分析します。
テキストの統計分析:
人気小説の単語カウントと単語頻度-逆文書頻度 (TF-IDF) 分析。
学術論文や特許文書の統計分析と引用分析。
Wikipedia データ分析。
非構造化データ、時空間データ、画像データなどの大量のデータのマイニング。
機械学習:教師あり学習、教師なし学習、および決定木やサポートベクターマシン (SVM) などの分類アルゴリズム。
自然言語処理:
ビッグデータに基づくトレーニングと予測。
コーパスに基づく単語共起行列の構築、頻出アイテムセットのマイニング、重複ドキュメントの検出。
広告レコメンデーション:クリックスルー率 (CTR) とコンバージョン率 (CVR) の予測。
MapReduce プロセスの説明
MapReduce プログラムは、主に Map フェーズとそれに続く Reduce フェーズの 2 つのフェーズでデータを処理します。 これらのフェーズの処理ロジックを定義できますが、MapReduce フレームワークの規約に従う必要があります。 MapReduce の完全なデータ処理フローは次のとおりです:
入力データ:Map フェーズの前に、入力データは同じサイズのデータブロックに分割されます。 各データブロックは、Map ワーカーの入力として使用されます。 これにより、複数の Map ワーカーが同時に実行できるようになります。
Map フェーズ:各 Map ワーカーは、割り当てられたデータブロックを読み取って処理します。 次に、各出力レコードにキーを割り当てます。 このキーによって、どの Reduce ワーカーがレコードを受信するかが決定されます。
説明同じキーを持つデータレコードは、同じ Reduce ワーカーに送信されます。 1 つの Reduce ワーカーは、異なるキーを持つデータレコードを受信できます。
Shuffle フェーズ:Reduce フェーズの前に、MapReduce フレームワークはキーによってデータをソートし、同じキーを持つデータをグループ化します。 [結合操作 (コンバイナ)] を指定した場合、フレームワークはコンバイナを呼び出して、同じキーを持つデータを集約します。 コンバイナのロジックはカスタマイズできます。 MaxCompute では、従来の MapReduce フレームワークプロトコルとは異なり、コンバイナの入力パラメーターと出力パラメーターは Reduce フェーズのものと一致している必要があります。 この処理は一般的に [Shuffle] とも呼ばれます。
Reduce フェーズ:同じキーを持つデータレコードが同じ Reduce ワーカーに送信されます。 1 つの Reduce ワーカーは、複数の Map ワーカーからデータを受信できます。 各 Reduce ワーカーは、同じキーを持つデータレコードに対して Reduce 操作を実行し、それらを単一の値に変換します。
出力データ:結果が生成されます。
このセクションでは、MapReduce フレームワークの概要を説明します。 詳細については、「機能紹介」をご参照ください。
以下では、WordCount の例を使用して、MaxCompute MapReduce の各フェーズの概念を説明します。
a.txt という名前のファイルがあり、ファイルの各行に 1 桁の数字が含まれているとします。 目標は、各数字が出現する回数をカウントすることです。 この文脈では、各数字は「単語」であり、出現回数は「カウント」です。 これを実現するために、MaxCompute MapReduce は次の図に示すプロセスに従います。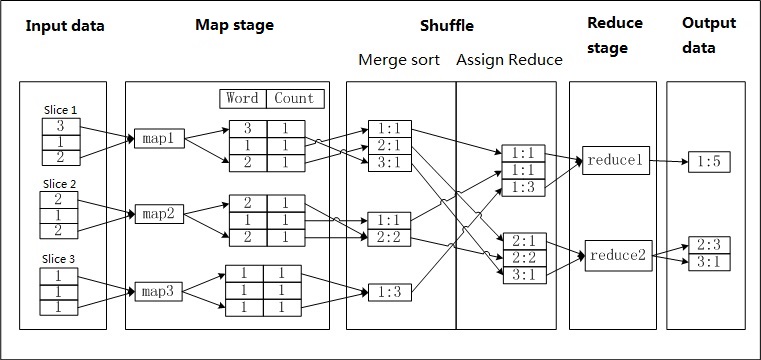
[手順]
入力データ:テキストファイルが分割されます。 各パーティションのデータは、Map ワーカーの入力として使用されます。
Map フェーズ:Map ワーカーが入力を処理します。 受信した各数字について、カウントを 1 に設定し、<Word, Count> のペアを出力します。 単語は、出力データのキーとして使用されます。
Shuffle > 結合とソート:Shuffle の初期段階で、各 Map ワーカーからの出力は、まずキー (単語) によってソートされます。 ソート後、コンバイナ操作が実行されます。 同じキー (単語) のカウントが集約され、新しい <Word, Count> ペアが形成されます。 このプロセスは、結合とソートと呼ばれます。
Shuffle > Reducer への割り当て:Shuffle の後半の段階で、データは Reducer に送信されます。 Reduce ワーカーがデータを受信した後、キーによってデータを再度ソートします。
Reduce フェーズ:各 Reduce ワーカーは、コンバイナと同じロジックを使用してデータを処理します。 同じキー (単語) のカウントを集約して、最終結果を取得します。
出力データ。
すべての MaxCompute データはテーブルに格納されます。 したがって、MaxCompute MapReduce の入出力はテーブルである必要があります。 出力形式は指定できません。 ファイルシステムのようなインターフェイスは提供されません。
制限事項
MapReduce の制限については、「制限の概要」をご参照ください。
ローカルでの MapReduce の実行に関する制限については、「ローカル実行と分散環境での実行の違い」をご参照ください。
拡張 MapReduce (MR2)
ネイティブの MaxCompute MapReduce と比較して、MR2 での Map や Reduce などの関数の記述方法はほぼ同じです。 主な違いは、ジョブの実行方法です。 例については、「パイプラインの例」をご参照ください。
MR2 モデルの背景
従来の MapReduce モデルでは、MapReduce 操作の各ラウンドの後、結果のデータを Hadoop 分散ファイルシステム (HDFS) や MaxCompute テーブルなどの分散ファイルシステムに格納する必要があります。 MapReduce ワークフローは通常、複数の MapReduce ジョブで構成されます。 各ジョブが完了すると、その中間データをディスクに書き込む必要があります。 ただし、後続の Map タスクは、次の Shuffle フェーズの前にこのデータを 1 回だけ読み取るだけで済む場合があります。 このプロセスにより、冗長なディスク I/O 操作が発生します。
MaxCompute のコンピューティングロジックとスケジューリングロジックは、より複雑なプログラミングモデルをサポートします。 この状況に対処するため、MaxCompute では、中間の Map 操作なしで、別の Reduce 操作の直後に Reduce 操作を実行できます。 したがって、MaxCompute は、Map > Reduce > Reduce のように、Map 操作の後に複数の Reduce 操作を連鎖させることをサポートする拡張 MapReduce モデルを提供します。
Hadoop Chain Mapper and ChainReducer との比較
Hadoop Chain Mapper and ChainReducer も、同様の連鎖した Map または Reduce 操作をサポートしています。 ただし、これらは MaxCompute の拡張 MapReduce (MR2) モデルとは根本的に異なります。
Chain Mapper と ChainReducer は、従来の MapReduce モデルに基づいています。 これらは、元の Map または Reduce 操作の後に 1 つ以上の Map 操作のみを追加できます。 Reduce 操作を追加することはできません。 このアプローチの利点は、既存の Mapper ビジネスロジックを再利用して、Map または Reduce 操作を複数の Mapper ステージに分割できることです。 ただし、これは基盤となるスケジューリングモデルと I/O モデルを根本的に変更するものではありません。