このトピックでは、LogView V2.0(以下、LogView)の機能と使用方法について説明します。LogView の URL にアクセスすることで、ジョブ情報を表示できます。
概要
LogView は、MaxCompute ジョブのステータスを記録・表示するためのツールです。LogView には以下の機能があります。
-
ジョブ処理の論理アーキテクチャを表示するインタラクティブな有向非循環グラフ(DAG)を提供します。また、ジョブのオペレーターを確認することもできます。
-
ジョブの実行プロセスを再生できます。
-
Fuxi Sensor を使用して、メモリ使用量および CPU 使用率を確認できます。
エントリポイント
MaxCompute ジョブを送信すると、自動的にhttps://logview.aliyun.com/logviewで始まる URL が生成されます。
-
MaxCompute クライアントを使用してジョブを送信する場合、ブラウザのアドレスバーに URL をコピーして LogView にアクセスする必要があります。
-
DataWorks を使用してジョブを送信する場合、URL をクリックして直接 LogView ページに移動できます。
LogView ページは、上部のタイトルおよび機能セクション(1)、左側の Basic Info パネル(2)、右側のジョブ詳細セクション(3)の 3 つのセクションに分かれています。ジョブ詳細セクションには、Job Details、Result、SourceXML、SQL Script、Summary の各タブページ、およびプログレスチャート DAG 図と Fuxi Jobs リストが含まれます。
|
番号 |
セクション |
|
1 |
タイトルおよび機能セクション。詳細については、「タイトルおよび機能セクション」をご参照ください。 |
|
2 |
Basic Info セクション。詳細については、「Basic Info セクション」をご参照ください。 |
|
3 |
ジョブ詳細セクション。詳細については、「ジョブ詳細セクション」をご参照ください。 |
タイトルおよび機能セクション
このセクションには、ジョブ ID およびジョブ名が表示されます。ジョブ ID は MaxCompute ジョブを一意に識別するもので、ジョブ送信時に生成されます。ジョブ名は SDK を使用してジョブを送信した場合にのみ表示されます。また、このセクションの右側にあるアイコンをクリックして操作を実行することもできます。
|
アイコン |
説明 |
|
|
ジョブ詳細を含む Logview_detail.txt ファイルを開きます。このファイルはご利用のコンピューターに保存されています。 |
|
|
LogView V1.0 ページに戻ります。 |
|
|
ジョブ詳細をファイルとしてご利用のコンピューターに保存します。 |


Basic Info セクション
このセクションには、ジョブに関する基本情報が表示されます。
|
パラメーター |
説明 |
|
MaxCompute Service |
ジョブが実行される MaxCompute のエンドポイント。エンドポイントの詳細については、「エンドポイント」をご参照ください。 |
|
Project |
ジョブが属する MaxCompute プロジェクトの名前。 |
|
Cloud account |
ジョブ送信に使用された Alibaba Cloud アカウント。 |
|
Type |
ジョブのタイプ。有効な値:SQL、SQLRT、LOT、XLib、CUPID、AlgoTask、Graph。 |
|
Status |
ジョブのステータス。有効な値:
|
|
Start Time |
ジョブが送信された時刻。 |
|
End Time |
ジョブが完了した時刻。 |
|
Latency |
ジョブの実行期間。 |
|
Progress |
ジョブの進捗状況。 |
|
Priority |
ジョブの優先度。 |
|
Queue |
リソースクォータグループ内のキューにおけるジョブの位置。 |
ジョブ詳細セクション
ジョブ詳細セクションでは、ジョブの詳細情報を照会できます。このセクションは以下のタブで構成されています。
Job details
-
プログレスチャート
Job details タブの上部には、プログレスチャートが表示されます。このチャートは、Fuxi job、Fuxi task、オペレーターの 3 つのレイヤーにわたるサブタスクの依存関係を可視化し、トラブルシューティングツールも提供します。
番号
説明
1
Fuxi jobs を切り替えるためのパンくずナビゲーション。JOB:_SQL_0_0_0_job_0 は Fuxi job の名前です。
2
問題をトラブルシューティングするためのツール。プログレスチャート、入力ヒートチャート、出力ヒートチャート、TaskTime ハートチャート、InstanceTime ハートチャートを使用できます。
3
 アイコンをクリックしてジョブステータスを更新し、
 アイコンをクリックしてプログレスチャートを拡大または縮小できます。また、
 アイコンをクリックして MaxCompute Studio ドキュメントを表示し、
 アイコンをクリックしてジョブの上位レベルに切り替えることもできます。
4
ズームツール。
5
Fuxi task。MaxCompute ジョブは 1 つ以上の Fuxi jobs で構成され、各 Fuxi job は 1 つ以上の Fuxi tasks で構成されます。さらに、各 Fuxi task は 1 つ以上の Fuxi instances で構成されます。入力データ量が増加すると、MaxCompute は各タスクに対してより多くのノードを起動してデータを処理します。ノードは Fuxi instance と同等です。たとえば、シンプルな MapReduce ジョブでは、map task(M1)と reduce task(R2)の 2 つの Fuxi tasks が生成されます。SQL ステートメントが複雑な場合は、複数の Fuxi tasks が生成される可能性があります。
実行ページで各 Fuxi task の名前を確認できます。たとえば、M1 は map task を示します。R4_3_9 の 3 と 9 というフィールドは、M3 および C9_3 が完了した後にのみ map task を実行できることを示しています。同様に、M2_4_9_10_16 は、M2 タスクが R4_3_9、C9_3、R10_1_16、および C16_1 が完了した後にのみ実行できることを示しています。R/W は、タスクが読み取りおよび書き込みする行数を示します。
タスクをクリックまたは右クリックして、そのタスクのオペレーター依存関係およびオペレーターグラフを表示できます。
入力テーブルおよび出力テーブルを迅速に表示できます。
6
Fuxi task の再生。再生を開始または停止するには
 アイコンをクリックします。また、プログレスバーをドラッグすることもできます。プログレスバーの両端には開始時刻と終了時刻が表示され、中央には再生時間が表示されます。
7
サムネイル。
説明-
再生機能は、Running 状態の Fuxi tasks には適用されません。
-
Platform for AI(PAI)などの AlgoTask ジョブには Fuxi task が 1 つしか含まれないため、これらのジョブにはプログレスチャートが提供されません。
-
SQL 以外のジョブでは、Fuxi jobs および Fuxi tasks のみが表示されます。
-
Fuxi job が 1 つしかない場合、プログレスチャートには Fuxi tasks 間の依存関係が表示されます。複数の Fuxi jobs が存在する場合、プログレスチャートには Fuxi jobs 間の依存関係が表示されます。
-
-
ジョブステータス
Job details タブの下部には、ジョブの詳細な実行情報が表示されます。
番号
説明
1
Fuxi Jobs タブ。このタブで Fuxi jobs を切り替えられます。
2
Fuxi job の Fuxi tasks の詳細。Fuxi task をクリックすると、そのタスクの Fuxi instance 情報が表示されます。デフォルトでは、最初の Fuxi job の最初の Fuxi task の Fuxi instance 情報が表示されます。
AlgoTask および CUPID ジョブの場合、このエリアには Sensor 列が表示されます。Fuxi task の Sensor をクリックすると、その Fuxi instances の CPU 使用率およびメモリ使用量を確認できます。Fuxi jobs は次のように分類されます。
-
M:ID が M で始まるジョブは、データスキャンジョブです。
-
R:ID が R で始まるジョブは、Reduce ジョブです。
-
J:ID が J で始まるジョブは、JOIN ジョブです。
-
C:ID が C で始まるジョブは、仮想ノードを示します。このノードは計算を伴わず、ブランチ選択にのみ使用されます。
説明-
Fuxi Sensor は、中国 (成都)、中国 (深セン)、中国 (上海)、中国 (杭州)、中国 (張家口)、および中国 (北京) リージョンで利用可能です。
-
Fuxi task が
interruptedされた場合、リトライされることがあります。この場合、Progress 列にはリトライ試行の進捗のみが表示されます。そのため、全体のジョブは正常に完了していても、この Fuxi task の進捗が100%になっていないことがあります。これは期待される動作です。
3
LogView は、インスタンスをステータスに基づいてグループに分けます。[Failed] の横の値をクリックして、障害のあるノードの情報を照会できます。
4
Fuxi instances。
-
ID の例:
M1#0_0。最初の0は Fuxi instance の自動増分 ID です。2 番目の0はタスクのリトライ回数です。0の値は、タスクがリトライされていないことを示します。n の値は、タスクが n 回リトライされたことを示します。 -
StdOut および StdErr。出力メッセージ、エラーメッセージ、および表示したい情報を確認できます。また、これらの情報をダウンロードすることもできます。
-
デバッグ。エラーのデバッグおよびトラブルシューティングが可能です。
-
Fuxi instances 数の制限。
使用する SQL ステートメントが以下のいずれかの条件を満たす場合、Fuxi instances 数は 1 に制限されます。
-
limit句を含む場合。 -
partition by key句なしでウィンドウ関数を使用する場合。 -
group by key句なしで集計関数を使用する場合。 -
JOIN 操作を実行するために使用される SQL ステートメントには、等結合キーが含まれていません。
-
order by句を含む場合。
-
-
Fuxi Sensor
Fuxi Sensor は、Fuxi instance の多次元的なリソースビューを提供し、実際の CPU 使用率およびメモリ使用量を表示します。これにより、根本原因分析やジョブパフォーマンス分析において非常に有用なツールとなります。具体的なシナリオは以下のとおりです。
-
メモリ不足(OOM)エラーが発生した際の実際のメモリ使用量を分析します。
-
機械学習ジョブの Fuxi instance の以下のリソース使用量を表示します。
-
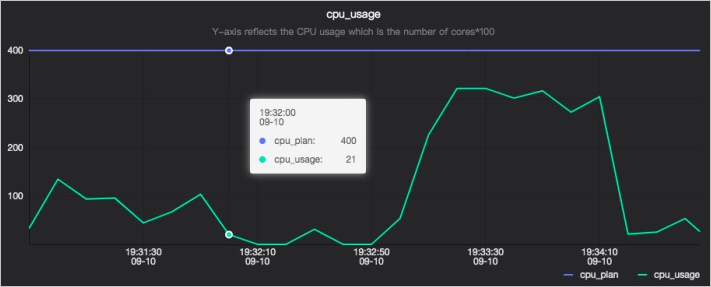
CPU 使用率
cpu_usage チャートには 2 本の線があります。1 本はリクエストされた CPU 数(cpu_plan)を示し、もう 1 本は使用された CPU 数(cpu_usage)を示します。Y 軸で 400 は 4 つのプロセッサを示します。リクエストされた CPU 数は、プロセッサ数を調整することでのみ変更できます。使用可能な CPU 数を調整することはできません。
-
メモリ使用量
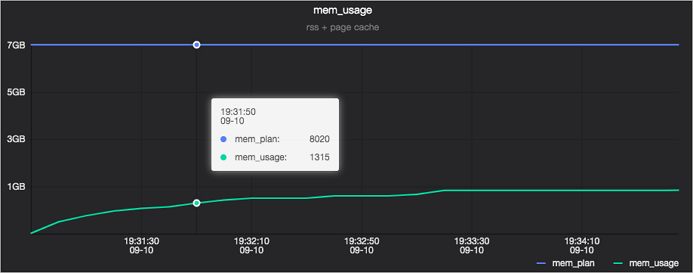
mem_usage チャートには 2 本の線があります。1 本はリクエストされたメモリリソース数(mem_plan)を示し、もう 1 本は使用されたメモリリソース数(mem_usage)を示します。
メモリ使用量(mem_usage)は、Resident Set Size(RSS)と PageCache の 2 つの部分で構成されます。RSS は、Malloc 呼び出し(非ファイルマッピング)によるページフォールトが発生した後に割り当てられるメモリです。このメモリは、メモリが不足した場合でも解放できません。PageCache は、ログファイルの読み書きなどを行う際にカーネルがファイルをキャッシュするために使用するメモリです。PageCache は通常、メモリが不足した場合に解放可能です。
-
メモリ詳細
-
RSS 使用量

-
PageCache 使用量

-
-
Result
Result タブの内容は、ジョブステータスによって異なります。
-
ジョブが正常に実行された場合、ジョブ結果が表示されます。
-
以下のコマンドを使用して、ジョブ結果の表示を無効化できます。
setproject odps.forbid.fetch.result.by.bearertoken=true; -
odps.sql.select.output.format パラメーターを設定して、結果の表示形式を指定できます。
-- 結果を CSV 形式で表示するには、このパラメーターを csv に設定します。
set odps.sql.select.output.format=csv;
-- 結果をテキスト形式で表示するには、このパラメーターを HumanReadable に設定します。
set odps.sql.select.output.format=HumanReadable;
-
-
ジョブの実行に失敗した場合、失敗の原因が表示されます。
Source XML
-
XML
このタブには、ジョブレベルおよびタスク関連情報が XML 形式で表示されます。
-
Settings
このタブには、現在のタスクの設定が表示されます。
-
Command
このタブには、現在のタスクのフラグ設定が表示されます。
SQL script
このタブには、現在のタスクの SQL スクリプトが表示されます。
History
このタブには、現在のタスクの履歴が表示されます。
SubStatusHistory
このタブには、現在のタスクのステータスが表示されます。
SubStatusHistory タブをクリックすると、タスク実行の各ステージのサブステータス履歴を確認できます。テーブルには、Code(1010、1020、1030 などの数値ステータスコード)、Description(ステータスの説明)、StartTime(開始時刻)、Latency(持続時間)、および TimeLine(タイムラインのプログレスバー)の各列が含まれます。
|
ステータスコードのメッセージ |
説明 |
|
スケジューリング待ち |
ジョブが送信され、MaxCompute フレームワークによるスケジューリングを待っています。ほとんどの場合、待機時間は短いです。 |
|
クラスターリソース待ち |
MaxCompute フレームワークが Fuxi コンピューティングクラスターのリソースが不足していると判断したため、ジョブがリソースを待っています。 |
|
同時タスクスロット待ち |
プロジェクトレベルの速度制限がトリガーされました。プロジェクトで同時に送信できる SQL タスク数を設定できます。 |
|
データレプリケーション待ち |
ジョブがデータのレプリケーションを待っています。 |
|
実行スロット待ち |
システムレベルの速度制限がトリガーされました。 |
|
以前のタスク試行のクリーンアップ待ち |
ジョブが、過去のタスクのクリーンアップ操作が完了するのを待っています。 |
|
実行待ち |
ジョブが、親プロセスキューから子プロセスに配布されるのを待っています。ほとんどの場合、待機時間は短いです。 |
|
実行準備中 |
ジョブが子プロセスに配布されようとしています。子プロセスが異常な場合、準備時間が長くなる可能性があります。 |
|
タスク実行中 |
ジョブが MaxCompute フレームワーク内で処理されています。 |
|
SQLTask 初期化中 |
SQL タスクが初期化されています。 |
|
SQLTask クエリコンパイル中 |
SQL タスクがコンパイルされています。 |
|
SQLTask クエリ最適化中 |
SQL タスクがクエリを最適化しています。実行計画が複雑な場合、最適化時間はやや長くなります。最適化時間が過度に長い場合、エラーが発生する可能性があります。 |
|
SQLTask データソース分割中 |
SQL タスクが最適化のためにデータソースを分割しています。 |
|
SQLTask 実行計画生成中 |
SQL タスクが実行計画を生成しています。このプロセスに長時間かかる場合、過剰なパーティション数または多数の小規模ファイルからデータが読み取られている可能性があります。 |
|
SQLTask 実行計画送信中 |
SQL タスクが実行計画を送信しています。 |
|
ジョブ送信済み |
ジョブがコンピューティングクラスターに送信されました。 |
|
オフラインジョブ 実行待ち |
ジョブが Fuxi コンピューティングクラスターに送信される前に、MaxCompute フレームワークがジョブにコンピューティングリソースが利用可能であると判断しました。しかし、ジョブが送信された後、MaxCompute フレームワークがクォータグループ内にコンピューティングリソースが利用可能でないと判断したため、ジョブがコンピューティングリソースを待っています。このステータスコードは 1 回のみ表示され、その後、ジョブにコンピューティングリソースが利用可能でなくても再表示されることはありません。 |
|
オフラインジョブ 実行中 |
Fuxi job が実行中です。実行中にリソースが利用不可になった場合でも、ジョブはこの状態のままになります。たとえば、優先度の高いジョブがリソースをプリエンプトした場合、影響を受けた Fuxi instances は実行できず、そのステータスは |
|
オフラインジョブ 失敗 |
Fuxi job の実行に失敗しました。 |
|
オフラインジョブ 成功 |
Fuxi job が成功しました。 |
|
SQLTask メタ情報更新中 |
SQL タスクがメタデータ情報ステータスを更新し、動的パーティションを生成しています。このプロセスには時間がかかる場合があります。 |
|
SQLTask 終了中 |
SQL タスクが完了しました。 |
|
オンラインジョブは fuxi によってキャンセルされました。 |
|
|
タスクリトライ中 |
ジョブがリトライされています。これは、 |
|
オンラインジョブ 実行待ち |
|
|
オンラインジョブ 実行中 |
|
|
オンラインジョブ 失敗 |
|
|
オンラインジョブ 成功 |
|
|
オンラインジョブ fuxi によりキャンセル |
|
|
タスクキーパス実行完了 |
ジョブのキーパスは完了しましたが、DetailStatus などの情報は生成されていません。 |
|
タスクキーパス完了 |
ジョブのキーパスは完了しました。 |
|
インスタンスキーパス完了 |
インスタンスのキーパスは完了しました。 |
|
タスク実行完了 |
ジョブが完了し、DetailStatus が生成されました。 |
|
インスタンス実行完了 |
ジョブが完了しました。 |
|
実行失敗 |
ジョブの実行に失敗しました。 |