このトピックでは、ニアリアルタイムデータウェアハウスソリューションで解決できるビジネス上の課題と、その主要なアーキテクチャ特性について説明します。
背景情報
データ処理シナリオがより複雑になるにつれて、多くのビジネスシナリオでは、数秒以内での更新データの表示や行レベルの更新は求められません。代わりに、分単位または時間単位のニアリアルタイムデータ処理と、大量データのバッチ処理が求められます。MaxCompute は、ニアリアルタイムでの全量データと増分データの保存および処理に関するビジネス要件を満たすために、Delta テーブルを提供します。
現状分析
大量のデータをバッチで処理する必要があるリアルタイム性の低いビジネスシナリオでは、MaxCompute を使用してビジネス要件を満たすことができます。秒単位のリアルタイムデータ処理やストリーミング処理が必要となるリアルタイム性の高いビジネスシナリオでは、リアルタイムデータ処理システムまたはストリーミングシステムを使用してビジネス要件を満たす必要があります。分単位または時間単位のニアリアルタイムデータ処理と大量データのバッチ処理を組み合わせるような包括的なビジネスシナリオでは、単一エンジンを使用する場合でも複数のフェデレーテッドエンジンを使用する場合でも、特有の問題が発生する可能性があります。

上図に示すように、特定のシナリオで MaxCompute のみをバッチ処理に使用すると、特有の問題が発生する可能性があります。たとえば、分単位の増分データとユーザーの全量データを継続的にマージして保存する必要があるシナリオで MaxCompute を使用すると、追加のコンピューティングコストとストレージコストが発生します。複雑なデータ処理の連携と処理ロジックを T+1 日以内のデータのバッチ処理に変換する必要があるシナリオで MaxCompute を使用すると、データ処理連携の複雑性が増し、リアルタイム性がビジネス要件を満たせなくなります。上記のシナリオでリアルタイムデータ処理システムのみを使用すると、リソースコストが高く、費用対効果が低く、大規模データのバッチ処理が不安定になります。多くの場合、解決策として Lambda アーキテクチャが使用されます。Lambda アーキテクチャでは、MaxCompute を全量データのバッチ処理に、リアルタイムデータ処理システムを増分データ処理に使用して、高いリアルタイム性要件を満たします。ただし、Lambda アーキテクチャでは、複数セットの処理およびストレージエンジン間でのデータ不整合、データの複数コピーの冗長な保存と計算による追加コスト、複雑なアーキテクチャ、長期化する開発サイクルなど、既知の問題が発生する可能性があります。
上記の問題に対処するため、近年ビッグデータのオープンソースエコシステムではさまざまなソリューションが提供されています。最も一般的なソリューションは、オープンソースのデータ処理エンジンである Spark、Flink、または Presto を、オープンソースのデータレイクである Hudi、Delta Lake、Iceberg と深く統合し、統合コンピューティングエンジンとデータストレージを実現するものです。このソリューションは、Lambda アーキテクチャに起因する一連の問題の解消に役立ちます。MaxCompute のアーキテクチャに基づいて、増分データの保存および処理アーキテクチャが開発されています。このアーキテクチャは、バッチデータ処理とニアリアルタイムの増分データ処理のための統合ソリューションを提供します。バッチ処理の費用対効果を維持しつつ、分単位での増分データの読み取り、書き込み、処理に関するビジネス要件を満たします。また、UPSERT 操作やタイムトラベル機能などの実用的な機能を提供して、ビジネスシナリオを拡張できます。これにより、データ計算、ストレージ、移行のコストを削減し、ユーザーエクスペリエンスを向上させます。
MaxCompute ニアリアルタイムアーキテクチャ
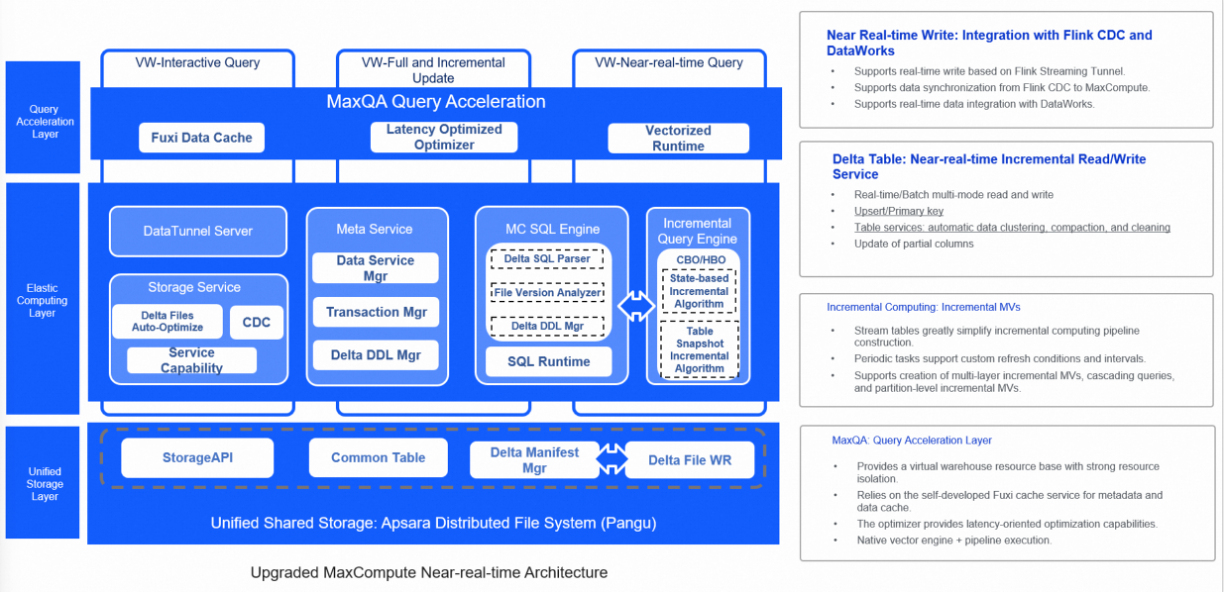
上図は、MaxCompute が前述の包括的なビジネスシナリオを効率的にサポートする新しいアーキテクチャを示しています。新しいアーキテクチャでは、MaxCompute がさまざまなデータソースをサポートし、カスタマイズされたアクセスツールを使用して、増分データと全量データを統合ストレージシステムに容易に取り込めます。バックグラウンドのデータ管理サービスがデータストレージ構造を自動的に最適化します。統合コンピューティングエンジンを使用して、ニアリアルタイムの増分データ処理と大規模データのバッチ処理をサポートします。統合メタデータサービスを使用して、トランザクション管理とファイルメタデータ管理をサポートします。新しいアーキテクチャには、バッチ処理システムのみを使用した場合に発生する冗長な計算とストレージ、低いリアルタイム性などの問題の解消、リアルタイムデータ処理システムまたはストリーミングシステムの高いリソース消費の回避、Lambda アーキテクチャにおける複数セットのシステム間のデータ不整合の排除、データの複数コピーに伴う冗長なストレージコストおよびシステム間のデータ移行コストの削減など、複数のメリットがあります。
エンドツーエンドで統合されたアーキテクチャは、増分データ処理における計算とストレージの最適化、および分単位のリアルタイム性に関するビジネス要件を満たし、バッチ処理全体の効率を確保し、リソースコストを効果的に削減します。
コア機能
MaxCompute ニアリアルタイムデータウェアハウスは主に、分単位のデータ取り込みをサポートする MC Delta Table、レイテンシーとスループットのバランスをより最適化する増分計算機能、秒単位のクエリ応答を実現する新たにアップグレードされた MCQA2.0 の 3 つの主要機能を提供します。
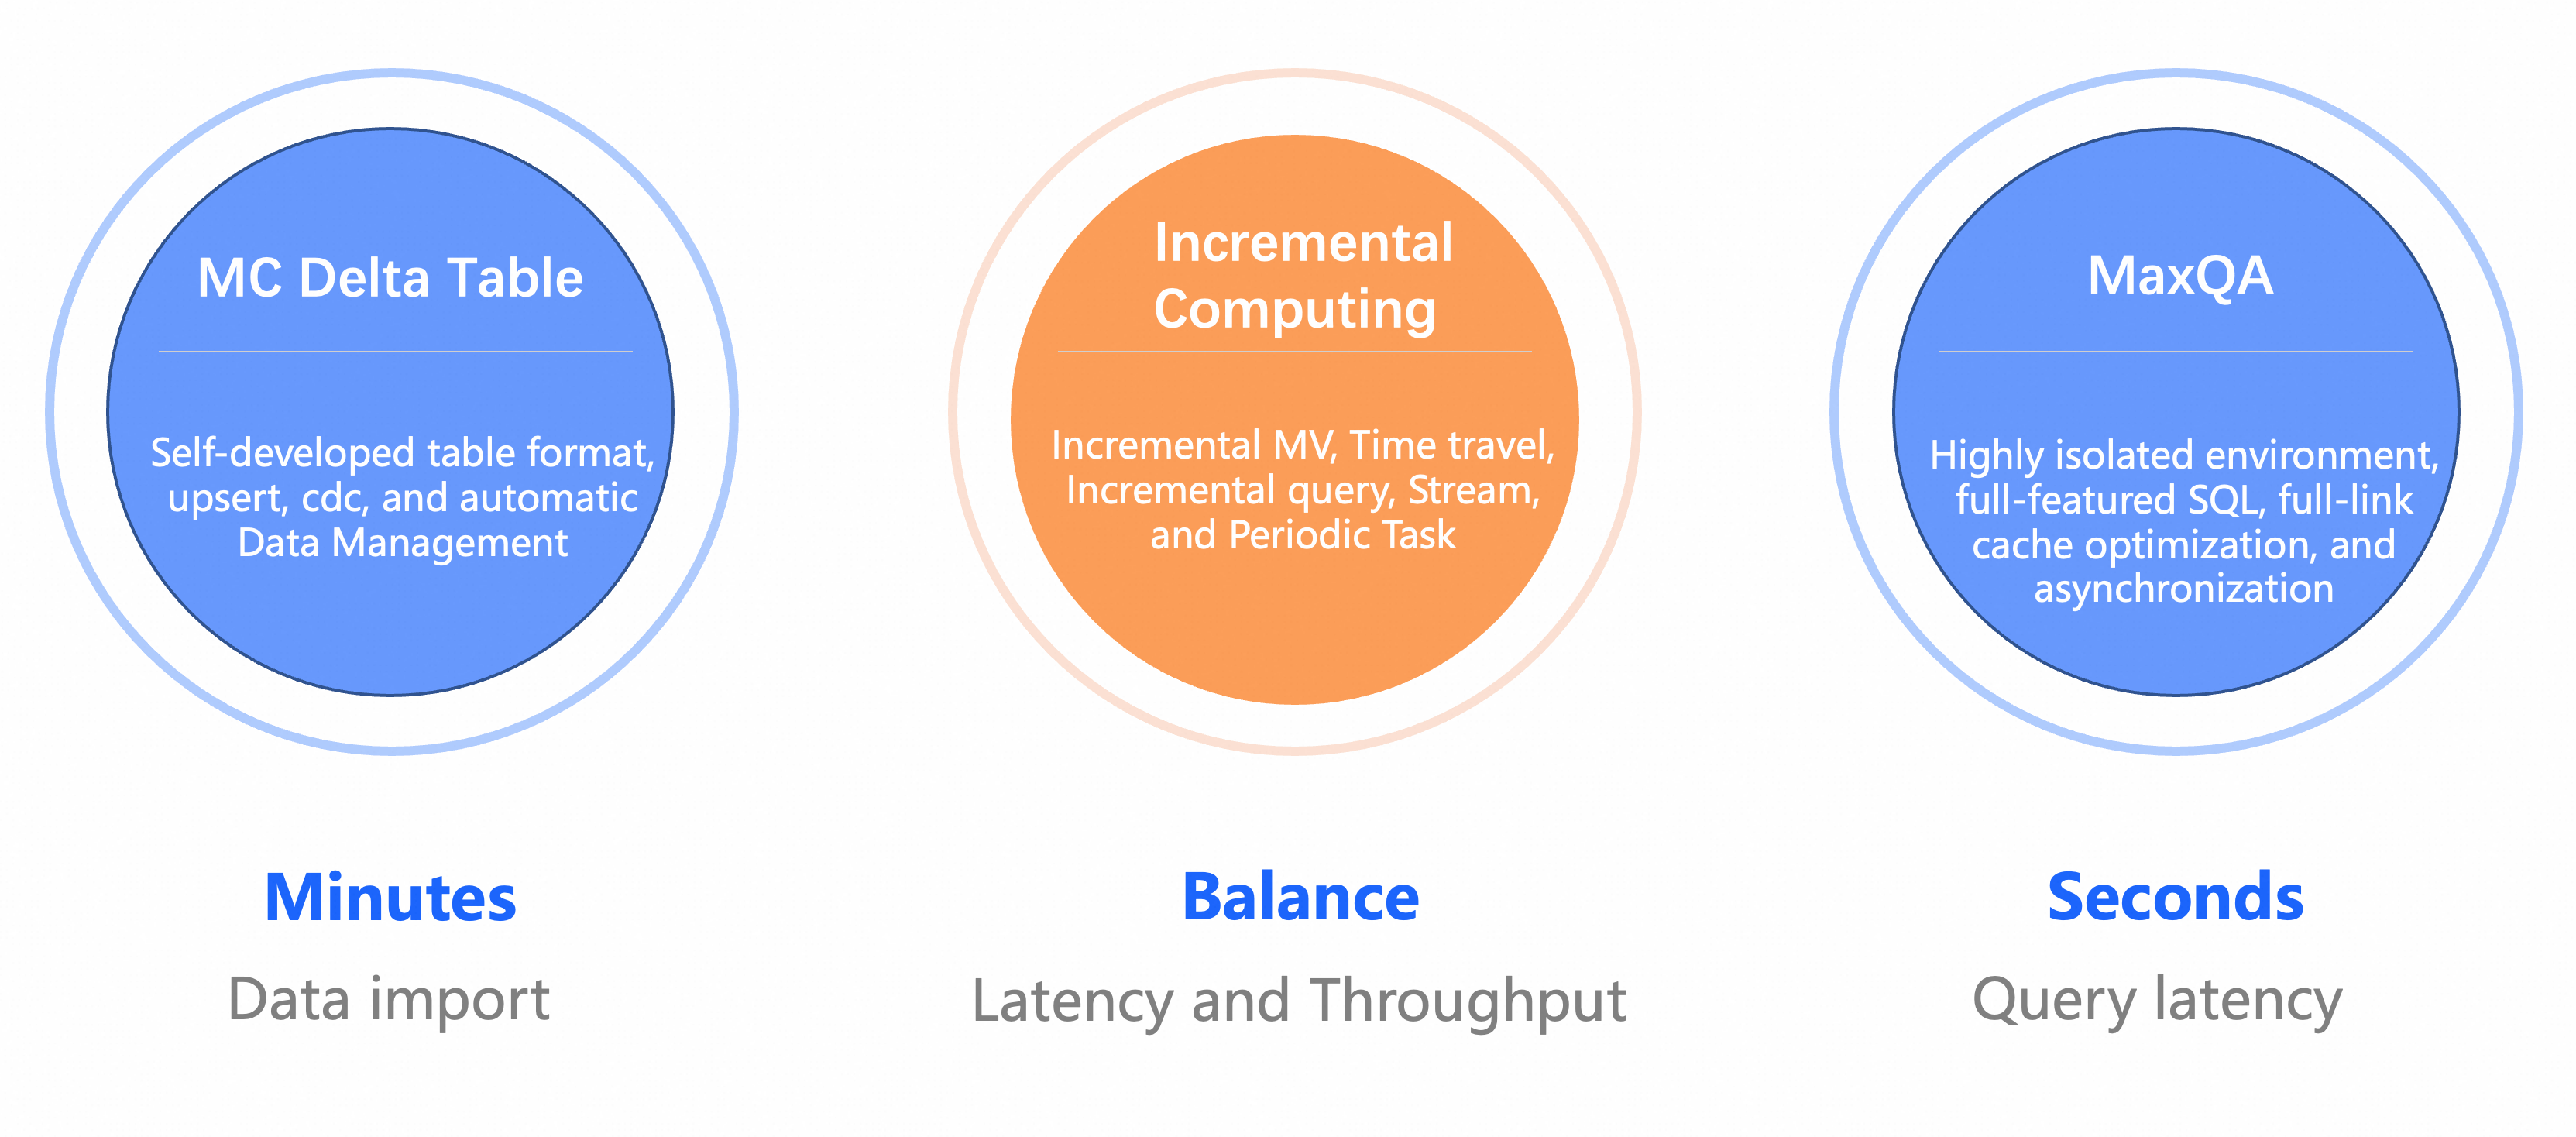
3 つのコア機能は次のとおりです:
Delta Table フォーマット:分単位のデータ取り込みをサポートします。このテーブルフォーマットは、基盤となるファイルフォーマットとして AliORC を使用し、UPSERT のセマンティクスをサポートし、増分データの読み取りと書き込みのための標準 CDC (Change Data Capture) メソッドを提供します。MaxCompute ストレージサービスとグローバルメタサービスに依存して、自動データ管理を実現します。
増分計算:Delta Table フォーマットに基づき、MaxCompute は増分マテリアライズドビュー、タイムトラベル、ストリームテーブルなど、一連の増分計算機能を追加しました。さらに、増分マテリアライズドビューと定期スケジュールタスクにより、異なるトリガー頻度を提供し、ユーザーがレイテンシーとスループットのバランスを取るための選択肢を拡充します。
MCQA2.0 クエリアクセラレーション:MaxCompute のクエリアクセラレーションを全面的にアップグレードした機能です。強く分離された環境によりパフォーマンスの安定性を向上させ、MCQA 1.0 のサポート範囲を、DQL の SELECT クエリのみから、DDL および DML を含むフル SQL 機能へと拡張します。さらに、エンドツーエンドキャッシュや、タスク投入パイプラインにおける複数ステップの非同期処理などの最適化手法により、パフォーマンスを一層強化します。
最も重要なのは、これらの新機能が MaxCompute の既存の SQL エンジンを基盤として構築および実装されている点です。MaxCompute ユーザーは、開発習慣を変えることなく、より高い費用対効果で膨大なデータを分析できます。
メリット
オープンソースのデータレイクである Hudi および Iceberg のビジネスシナリオとビジネス移行をサポートするために、新しいアーキテクチャは特定の共通機能を提供します。また、自社開発の新しいアーキテクチャは、機能、パフォーマンス、安定性、統合の観点で次のメリットも提供します:
-
ストレージ、メタデータ、コンピューティングエンジンを統合設計し、エンジン間の深く、かつ効率的な統合を実現します。新しいアーキテクチャには、低いストレージコスト、効率的なデータファイル管理、高いクエリ効率といったメリットがあります。さらに、MaxCompute のバッチクエリ向けの多数の最適化ルールを、タイムトラベルおよび増分クエリでも再利用できます。
-
新しいアーキテクチャのすべての機能をサポートする、統合された SQL 構文一式を提供します。これにより、ユーザーの操作が容易になります。
-
さまざまな複雑なビジネスシナリオをサポートするために、深くカスタマイズおよび最適化されたデータ取り込みツールを提供します。
-
MaxCompute の既存のビジネスシナリオとシームレスに統合し、移行、ストレージ、計算のコストを削減します。
-
データファイルの自動管理をサポートし、読み書きの安定性を向上させるとともに、ストレージ効率とコストの自動最適化をサポートします。
-
MaxCompute 上でフルマネージドとして提供されます。追加の導入コストなしに、新しいアーキテクチャをすぐに利用できます。新しいアーキテクチャの機能を利用するには、Delta テーブルを作成するだけで済みます。
-
自社開発アーキテクチャです。新しいアーキテクチャに基づき、ビジネス要件に合わせてデータ開発を管理できます。