このドキュメントでは、Alibaba Cloud MaxCompute で MaxFrame AI 関数を使用する方法を説明し、大規模言語モデルのオフライン推論アプリケーションを始めるためのユースケースを紹介します。
概要
MaxFrame AI 関数は、Alibaba Cloud MaxCompute プラットフォーム上で大規模言語モデル (LLM) のオフライン推論を実現するエンドツーエンドのソリューションです。データ処理と AI 機能をシームレスに統合し、エンタープライズレベルの大規模言語モデルの導入を簡素化します。
設計思想:「データを取り込み、結果を出力する」という思想に基づいています。これにより、MaxFrame Python フレームワークと pandas スタイルの API を使用して、データ準備、処理からモデル推論、結果の保存まで、ワークフロー全体を MaxCompute エコシステム内で完結させることができます。
ユースケース:この関数は、ログ分析やユーザー行動ログなどの大量の構造化データや、テキスト翻訳、ドキュメント要約、ベクトル化などのタスクにおける非構造化データの処理に最適です。単一のジョブでペタバイト規模のデータを処理でき、分散コンピューティングアーキテクチャにより低レイテンシーと線形スケーラビリティを実現します。この関数を使用することで、テキストから構造化情報を抽出し、コンテンツを整理・要約し、要約を生成し、言語を翻訳し、テキストの品質を評価し、感情を分類することができます。これにより、大規模言語モデルのデータ処理が大幅に簡素化され、結果の品質が向上します。
アーキテクチャ
MaxFrame AI 関数は、柔軟で汎用的な
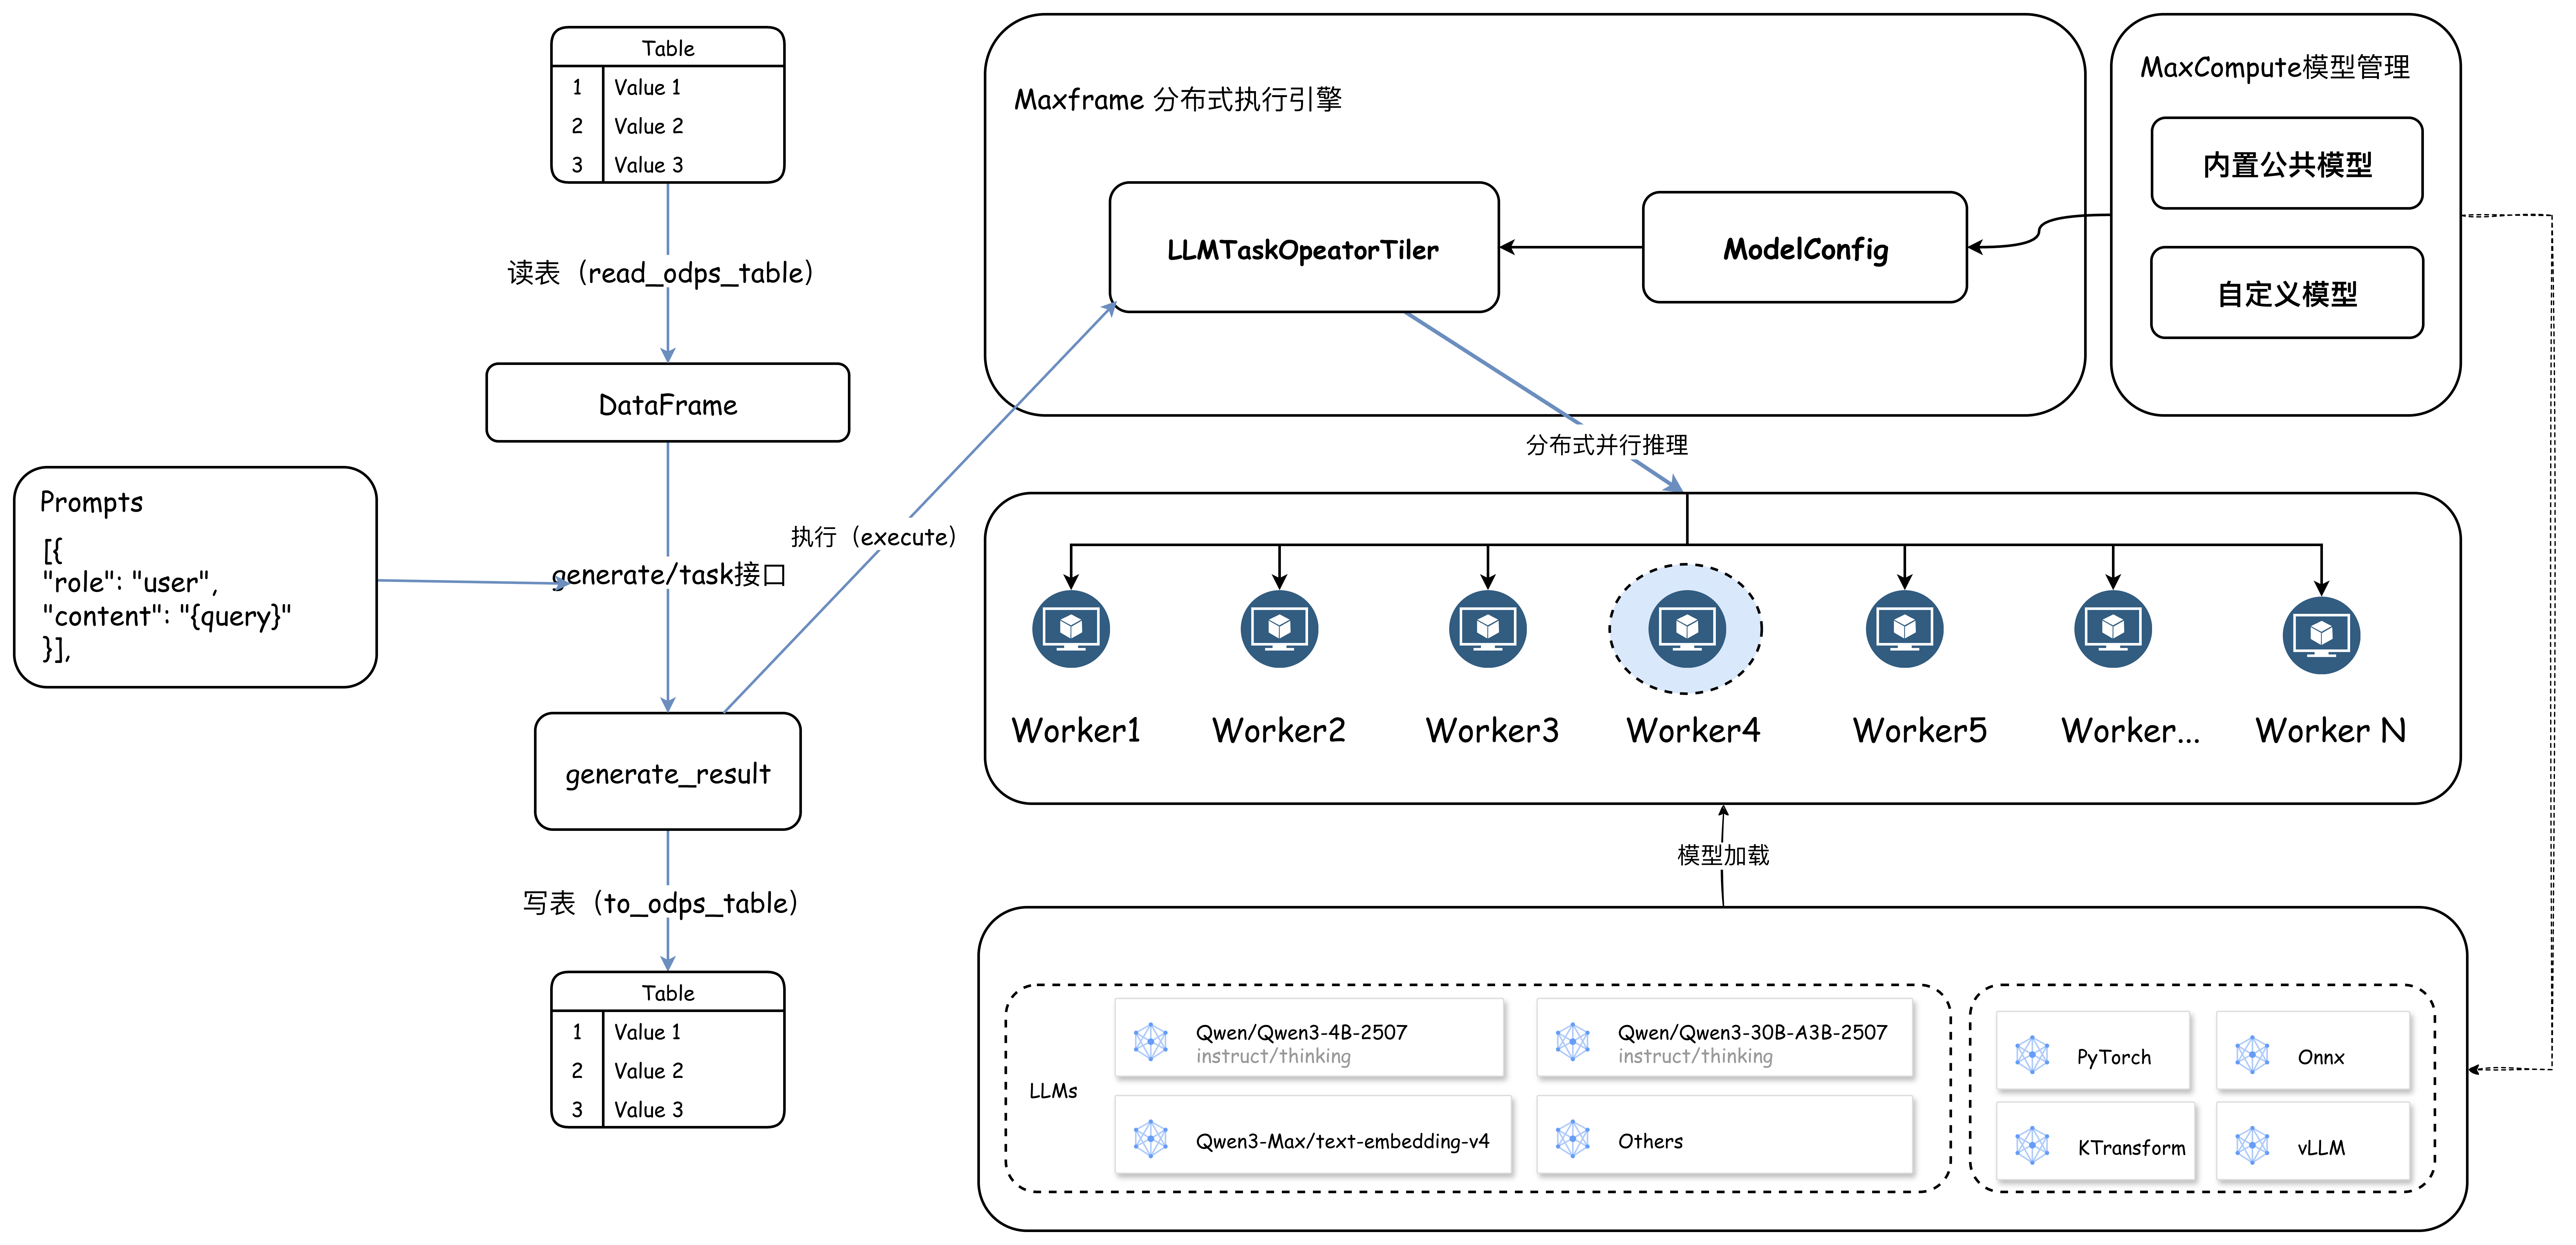
generateインターフェースと、テキスト翻訳、構造化データ抽出、ベクトル化などのシナリオに対応する簡潔なタスク固有のtaskインターフェースを提供します。ユーザーはモデルを選択し、MaxCompute テーブルとプロンプトテンプレートを入力として提供します。インターフェースを呼び出すと、MaxFrame はまず入力テーブルに対してデータシャーディングを実行します。データ量に基づいて適切な同時実行レベルを設定し、ワーカーのグループを起動してコンピューティングジョブを実行できます。各ワーカーは、提供されたプロンプトテンプレートを使用してデータ行からモデル入力をレンダリングおよび構築し、推論ジョブを実行し、結果と成功ステータスを MaxCompute に書き戻します。
次の図は、アーキテクチャとワークフローを示しています。
主な利点:
使いやすさ:使い慣れた Python API、すぐに使えるモデルライブラリ、デプロイコストゼロ。
スケーラビリティ:MaxCompute の CU クォータ、GU クォータ、および Inference Quota リソースを活用して、大規模な並列処理をサポートし、全体的なトークンスループットを向上させます。
データと AI の統合:データの読み取りと処理から AI 推論、結果の保存まで、ワークフロー全体を単一のプラットフォームで完結させます。これにより、データ移行コストが削減され、開発効率が向上します。
幅広いシナリオに対応:翻訳、構造化データ抽出、ベクトル化など、10 を超える一般的なユースケースをカバーします。
要件
サポート対象リージョン:
China (Hangzhou)、China (Shanghai)、China (Beijing)、China (Ulanqab)、China (Shenzhen)、China (Chengdu)、China (Hong Kong)、China (Hangzhou) 金融クラウド、および China (Shanghai) 金融クラウド。
サポート対象の Python バージョン: 3.11。
サポート対象の SDK バージョン: MaxFrame SDK のバージョンが 2.7.1 以降であることを確認してください。バージョンは、次のいずれかのコマンドを実行して確認できます。
// Windows の場合
pip list | findstr maxframe

// Linux の場合
pip list | grep maxframe
バージョンが古い場合は、
pip install --upgrade maxframeを実行して最新バージョンにアップグレードしてください。
サポート対象モデル
MaxFrame では、Qwen 3、DeepSeek-R1-Distill-Qwen、Qwen3-embedding など、一連の組み込み大規模言語モデルがすぐに使用できます。また、Model Studio の商用フラッグシップモデル (マルチモーダルモデルの qwen3.7-max、qwen3.6-plus、qwen3.6-flash、deepseek-v4-pro、deepseek-v4-flash、qwen3-vl-embedding、テキストモデルの text-embedding-v4 など) を呼び出すこともできます。すべてのモデルは MaxCompute プラットフォーム内でオフラインでホストされます。これにより、モデルのダウンロード、配布、または API の同時実行性制限を管理する必要がなくなります。簡単な API 呼び出しでモデルを使用できるため、MaxCompute の大規模なコンピューティングリソースを活用して、高い全体的なトークンスループットと同時実行性でオフライン推論タスクを完了できます。
サポート対象モデル
モデルタイプ | モデル名 | クォータ |
Model Studio の商用モデル |
|
|
Qwen 3 シリーズのオープンソースモデル |
|
|
Qwen Embedding のオープンソースモデル |
|
|
Deepseek-R1-Distill-Qwen シリーズのオープンソースモデル |
|
|
Deepseek-R1-0528-Qwen3 のオープンソースモデル |
|
|
クォータリソースタイプ
MaxFrame は 3 種類のリソースタイプをサポートしており、モデルのサイズやビジネス要件に最適なものを選択できます。
CU クォータリソース
コンピューティングユニット (CU) は、汎用 CPU コンピューティングリソース (1 vCPU、4 GB メモリ) で、小規模モデルや小規模な推論タスクに適しています。
設定:
# CU クォータのコンピューティングリソースを使用します。
options.session.quota_name = "mf_cpu_quota"
GU クォータリソース
GPU ユニット (GU) は、LLM 推論に最適化された GPU コンピューティングリソースです。より大規模なモデルをサポートし、8B パラメーター以上のモデルでの推論タスクに適しています。
設定:
# GU クォータのコンピューティングリソースを使用します。
options.session.gu_quota_name = "mf_gpu_quota"
Inference Quota リソース (トークンベースの課金)
このオプションを使用すると、qwen3-max や text-embedding-v4 など、Model Studio の商用大規模言語モデルを呼び出すことができます。課金は実際のトークン消費量に基づきます。このアプローチでは、CU や GU リソースをプロビジョニングしたり、基盤となるインフラストラクチャを管理したりする必要がなく、柔軟で便利、かつ費用対効果の高いソリューションを提供します。
関連 API
MaxFrame AI 機能は、柔軟性と使いやすさのバランスを取るため、汎用のgenerate インターフェイスとタスク固有のtask インターフェイスという 2 つのインターフェイスを提供します.
一般:generate
generate インターフェイス
主要なパラメーター
パラメーター | 必須 | 説明 |
model_name | はい | 使用するモデルの名前。 |
df | はい | 分析対象のテキストまたはデータで、DataFrame にカプセル化されています。 |
prompt_template | はい | OpenAI のチャットメッセージ形式に対応したメッセージのリストで、内容に |
タスク固有: task
シナリオ固有のインターフェイス: Task
プリセットの標準化されたタスクインターフェイスにより、一般的なユースケースの開発が簡素化されます。 現在サポートされている task インターフェイスには translate、extract、および embed が含まれます。
主要なパラメーター
パラメーター
必須
説明
model_name
はい
使用するモデルの名前。
df
はい
分析対象のテキストまたはデータで、DataFrame にカプセル化されています。
task interface
はい
translate: 言語翻訳を実行します。extract: 構造化データを抽出します。embed:ベクトル化を実行します。
使用例
from maxframe.learn.contrib.llm.models.managed import ManagedTextLLM

llm = ManagedTextLLM(name="<model_name>")

# テキストを翻訳します。
# target_language パラメーターに、翻訳先の言語を文字列で指定します。
translated_df = llm.translate(
    df["english_column"],
    source_language="english",
    target_language="Chinese",
    examples=[("Hello", "你好"), ("Goodbye", "再见")],
)

translated_df.execute()
ユースケース
GU クォータ
GU クォータのシナリオ
言語翻訳
シナリオ:多国籍企業が 100,000 件の英語の契約書を中国語に翻訳し、主要な条項に注釈を付ける必要があるケース。
import os
import maxframe.dataframe as md
from maxframe import new_session
from maxframe.config import options
from maxframe.udf import with_running_options
from odps import ODPS

options.dag.settings = {
    "engine_order": ["DPE", "MCSQL"]
}

o = ODPS(
    os.getenv('ALIBABA_CLOUD_ACCESS_KEY_ID'),
    os.getenv('ALIBABA_CLOUD_ACCESS_KEY_SECRET'),
    project='your-default-project',
    endpoint='your-end-point',
)

# MaxFrame セッションを初期化します。
session = new_session(o)

# ジョブの Logview URL を出力します。
print(session.get_logview_address())

# 1. GU クォータのコンピューティングリソースを使用します。
options.session.gu_quota_name = "mf_gu_quota"

# 2. Qwen3-1.7B モデルを使用します。
from maxframe.learn.contrib.llm.models.managed import ManagedTextLLM

llm = ManagedTextLLM(name="Qwen3-1.7B")

# 3. データを準備します。すでにデータがある場合は、この手順をスキップできます。
# o.execute_sql("""
#   CREATE TABLE IF NOT EXISTS raw_contracts (
#       en STRING
#   );
#   """)
#
# o.execute_sql("""
#   INSERT INTO raw_contracts VALUES
#   ('This agreement is governed by the laws of the State of California.'),
#   ('The tenant shall pay rent on the first day of each month.'),
#   ('Either party may terminate this contract with 30 days written notice.'),
#   ('All intellectual property rights shall remain with the original owner.'),
#   ('The warranty period for this product is twelve months from the date of purchase.');
#   """)

df = md.read_odps_table("raw_contracts")

# 4. プロンプトテンプレートを定義します。
messages = [
    {
        "role": "system",
        "content": "あなたはドキュメント翻訳の専門家で、英語のテキストを流暢に中国語に翻訳できます。",
    },
    {
        "role": "user",
        "content": "次の英語のテキストを中国語に翻訳してください。翻訳されたテキストのみを出力し、他のコンテンツは含めないでください。\n\n 例:\n入力: Hi\n出力: 你好。\n\n 翻訳するテキスト:\n\n{en}",
    },
]

# 5. `generate` インターフェースを呼び出し、プロンプトを定義し、対応するデータ列を参照します。
result_df = llm.generate(
    df,
    prompt_template=messages,
    params={
        "temperature": 0.7,
        "top_p": 0.8,
    },
).execute()

# 6. 結果を MaxCompute テーブルに書き込みます。
result_df.to_odps_table("raw_contracts_result")
キーワード抽出
シナリオ:このユースケースでは、MaxFrame AI 関数が非構造化データをどのように処理するかを説明します。非構造化データの大部分はテキストと画像で構成されており、ビッグデータ分析において大きな課題となっています。次の例は、AI 関数を使用してこのプロセスを簡素化する方法を示しています。
次のコードは、AI 関数を使用して履歴書から候補者の職務経歴を抽出する方法を示しています。この例では、ランダムに生成された履歴書のテキストを入力として使用します。詳細な開発プラクティスとデモについては、「GU での AI 関数の開発プラクティス」をご参照ください。
import maxframe.dataframe as md
from maxframe import new_session
from maxframe.config import options
from maxframe.udf import with_running_options
from odps import ODPS

options.dag.settings = {
    "engine_order": ["DPE", "MCSQL"]
}

o = ODPS(
    os.getenv('ALIBABA_CLOUD_ACCESS_KEY_ID'),
    os.getenv('ALIBABA_CLOUD_ACCESS_KEY_SECRET'),
    project='your-default-project',
    endpoint='your-end-point',
)

# MaxFrame セッションを初期化します。
session = new_session(o)

# ジョブの Logview URL を出力します。
print(session.get_logview_address())

# 1. GU クォータのコンピューティングリソースを使用します。
options.session.gu_quota_name = "mf_gu_quota"

# 2. Qwen3-4B モデルを使用します。
from maxframe.learn.contrib.llm.models.managed import ManagedTextLLM

llm = ManagedTextLLM(name="Qwen3-4B")

df = md.read_odps_table("traditional_chinese_medicine", index_col="index")

# 4 つの同時実行パーティションを指定します。
parallel_partitions = 4
df = df.mf.rebalance(num_partitions=parallel_partitions)

# 3. 事前設定された `extract` タスクインターフェースを使用します。
result_df = llm.extract(
    df["text"],
    description="以下のカルテから構造化データを順番に抽出してください。スキーマに従って、最終的な出力を厳密な JSON 形式で返してください。",
    schema=MedicalRecord,
    examples=[(example_input, example_output)],
)
result_df.execute()
Inference Quota
Inference Quota のシナリオ
テキストベクトル化:text-embedding-v4
シナリオ: Model Studio の商用モデル text-embedding-v4 を使用してベクトル化タスクを実行します。 課金はトークン消費量に基づくため、基盤となるコンピューティングリソースを管理する必要はありません。 このシナリオは、Model Studio の大規模モデルまたは商用大規模言語モデルを必要とする、複雑なテキスト分析および高品質な推論タスクに適しています。
画像理解:qwen3.6-plus
シナリオ:このシナリオは、大規模モデルや Model Studio の商用大規模言語モデルを必要とする、高品質な推論や複雑なテキスト分析、またはマルチモーダルデータ処理タスクに適しています。リソースはオンデマンドで消費されるため、コスト管理に役立ちます。
パフォーマンスの最適化
並列推論
MaxFrame は並列コンピューティングを使用して、大規模なオフライン推論を実行します。
データシャーディング:
rebalanceインターフェースは、指定されたパーティション数 (num_partitions) に基づいて、入力データテーブルを複数のワーカーノードに均等に分散します。並列モデル読み込み: 各ワーカーはモデルを独立してロードし、事前にウォームアップします。これにより、モデルのロードによるコールドスタートのレイテンシーを回避します。
結果の集約: 出力結果はパーティションごとに MaxCompute テーブルに書き込まれ、その後のデータ分析をサポートします。
チューニングの推奨事項
ヘテロジニアスコンピューティングリソースの切り替え
大規模モデル (8B パラメーター以上) の場合、CPU 推論は非効率的です。推論には、GU クォータまたは Inference Quota リソースへの切り替えを推奨します。
データパーティションの並列処理
大規模な推論ジョブでは、
rebalanceインターフェイスを使用して、データ分布に基づいて並列処理用にデータをシャーディングします。