このトピックでは、MaxCompute でサポートされている MapReduce プログラミングインターフェイスとその制限について説明します。
MapReduce とは
MapReduce は、代表的な分散コンピューティングフレームワークです。分割統治アプローチを使用して、大規模または複雑な問題を管理可能な小さなサブ問題に分割します。これらのサブ問題を解決し、結果をマージして最終的な解を得ます。従来の並列プログラミングフレームワークと比較して、MapReduce には高いフォールトトレランス、使いやすさ、優れた拡張性などの利点があります。MapReduce で並列プログラムを実装する際、データストレージやノード間の通信メカニズムなど、分散クラスターの基盤となる詳細を考慮する必要がありません。これにより、分散プログラミングが簡素化されます。
次の図は、MapReduce のワークフローを示しています。
MaxCompute は、2 つの MapReduce プログラミングインターフェイスを提供しています。
MaxCompute MapReduce: これは、ネイティブの MaxCompute API です。このバージョンは、ファイルシステムを公開しないため、高速に動作し、開発を簡素化します。
MaxCompute 拡張 MapReduce (MR2): このバージョンは、より複雑なジョブスケジューリングロジックをサポートし、その実装はネイティブの MaxCompute インターフェイスと一貫しています。従来の MapReduce と比較して、MR2 は基盤となるスケジューリングと I/O モデルを変更し、ジョブ実行中の冗長な I/O 操作を回避します。
これらのバージョンは、用語、ジョブの送信、入力と出力、リソースの使用の点でほぼ一致していますが、Java SDK は異なります。詳細については、「Hadoop Map/Reduceチュートリアル」をご参照ください。
MapReduce を使用して外部テーブルのデータを読み書きすることはできません。
MapReduce
シナリオ
MapReduce は、次のシナリオをサポートしています。
検索: Web クローリング、転置インデックス、PageRank。
Web アクセスログの分析:
閲覧や購入などのユーザー行動を分析・マイニングし、パーソナライズされたレコメンデーションを提供します。
ユーザーアクセスパターンを分析します。
テキストの統計分析:
人気小説の単語数と term frequency-inverse document frequency (TF-IDF) 分析。
学術論文や特許文書の統計分析と引用分析。
Wikipedia データ分析。
非構造化データ、時空間データ、画像データなど、大量のデータのマイニング。
機械学習: 教師あり学習、教師なし学習、決定木やサポートベクターマシン (SVM) などの分類アルゴリズム。
自然言語処理:
ビッグデータに基づくトレーニングと予測。
コーパスに基づいた単語共起行列の構築、頻出アイテムセットのマイニング、重複ドキュメントの検出。
広告レコメンデーション: クリック率 (CTR) とコンバージョン率 (CVR) の予測。
MapReduce プロセスの説明
MapReduce プログラムは、2 つの主要なステージでデータを処理します。Map ステージの後に Reduce ステージが続きます。これらのステージの処理ロジックは定義できますが、MapReduce フレームワークの規則に従う必要があります。MapReduce の完全なデータ処理フローは次のとおりです:
入力データ: Map 操作の前に、入力データは均等なサイズのデータブロックに分割されます。各データブロックは、Map ワーカーの入力として使用されます。これにより、複数の Map ワーカーを同時に実行できます。
Map ステージ: 各 Map ワーカーは、割り当てられたデータブロックを読み取り、処理します。次に、各出力レコードにキーを割り当てます。このキーによって、どの Reduce ワーカーがレコードを受信するかが決まります。
説明同じキーを持つデータレコードは、同じ Reduce ワーカーに送信されます。1 つの Reduce ワーカーは、異なるキーを持つデータレコードを受信できます。
シャッフル フェーズ: Reduce フェーズの前に、MapReduce フレームワークはデータをキーでソートし、同じキーを持つデータをグループ化します。 [コンバイン操作 (コンバイナ)] を指定した場合、フレームワークはコンバイナを呼び出して同じキーを持つデータを集約します。 コンバイナのロジックはカスタマイズできます。 MaxCompute では、従来の MapReduce フレームワークプロトコルとは異なり、コンバイナの入力パラメーターと出力パラメーターは Reduce フェーズのものと一致している必要があります。 プロセスのこの部分は、一般的に [シャッフル] とも呼ばれます。
Reduce ステージ: 同じキーを持つデータレコードは、同じ Reduce ワーカーに送信されます。1 つの Reduce ワーカーは、複数の Map ワーカーからデータを受信できます。各 Reduce ワーカーは、同じキーを持つデータレコードに対して Reduce 操作を実行し、それらを 1 つの値に変換します。
出力データ: 結果が生成されます。
このセクションでは、MapReduce フレームワークの概要を説明します。詳細については、「機能紹介」をご参照ください。
次のセクションでは、WordCount の例を使用して、MaxCompute MapReduce の各ステージの概念を説明します。
a.txt というファイルが存在し、ファイルの各行に 1 つの数字が含まれていると仮定します。目標は、各数字が出現する回数をカウントすることです。このコンテキストでは、各数字が「単語」であり、出現回数が「カウント」です。これを実現するために、MaxCompute MapReduce は次の図に示すプロセスに従います。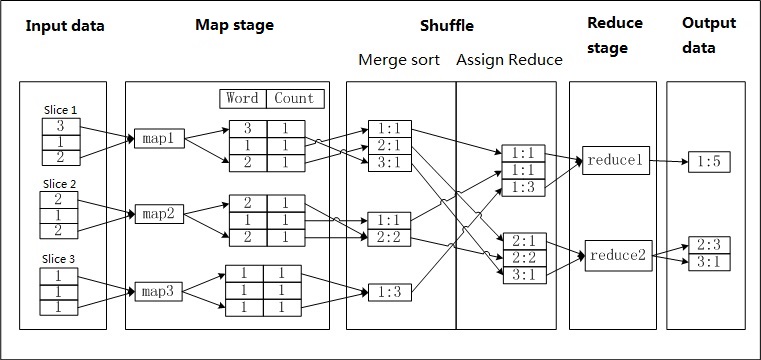
[手順]
入力データ: テキストファイルが分割されます。各パーティションのデータは、Map ワーカーの入力として使用されます。
Map ステージ: Map ワーカーは入力を処理します。受信した各数字に対して、カウントを 1 に設定し、<Word, Count> ペアを出力します。単語は、出力データのキーとして使用されます。
シャッフル > コンバイナ処理とソート: 初期のシャッフルステージでは、各 Map ワーカーからの出力は、まずキー (単語) でソートされます。ソート後、コンバイナ操作が実行されます。同じキー (単語) のカウントが集約され、新しい <Word, Count> ペアが形成されます。このプロセスは、コンバイナ処理とソートと呼ばれます。
シャッフル > Reducer への割り当て: 後期のシャッフルステージでは、データが Reducer に送信されます。Reduce ワーカーがデータを受信すると、キーで再度データをソートします。
Reduce ステージ: 各 Reduce ワーカーは、コンバイナと同じロジックを使用してデータを処理します。同じキー (単語) のカウントを集約して、最終結果を取得します。
出力データ。
すべての MaxCompute データはテーブルに格納されます。したがって、MaxCompute MapReduce の入力と出力はテーブルである必要があります。出力形式は指定できません。ファイルシステムのようなインターフェイスは提供されていません。
制限
MapReduce の制限については、「制限の概要」を参照してください。
MapReduce をローカルで実行する際の制限については、「ローカル実行と分散環境での実行の違い」を参照してください。
拡張 MapReduce (MR2)
ネイティブの MaxCompute MapReduce と比較して、MR2 で Map や Reduce などの関数を記述する方法はほぼ同じです。主な違いは、ジョブの実行方法にあります。例については、「パイプラインの例」を参照してください。
MR2 モデルの背景
従来の MapReduce モデルでは、各ラウンドの MapReduce 操作後、結果データを Hadoop Distributed File System (HDFS) や MaxCompute テーブルなどの分散ファイルシステムに保存する必要があります。MapReduce ワークフローは通常、複数の MapReduce ジョブで構成されます。各ジョブが完了すると、その中間データをディスクに書き込む必要があります。ただし、後続の Map タスクは、次のシャッフルステージの前に、このデータを一度読み取るだけで済む場合があります。このプロセスにより、冗長なディスク I/O 操作が発生します。
MaxCompute のコンピューティングとスケジューリングロジックは、より複雑なプログラミングモデルをサポートしています。この状況に対処するために、MaxCompute では、中間の Map 操作なしで、別の Reduce 操作の直後に Reduce 操作を実行できます。したがって、MaxCompute は、Map 操作の後に複数の Reduce 操作をチェーン化することをサポートする拡張 MapReduce モデルを提供します (例: Map > Reduce > Reduce)。
Hadoop ChainMapper および ChainReducer との比較
Hadoop ChainMapper と ChainReducer も、同様の直列化された Map または Reduce 操作をサポートしています。ただし、これらは MaxCompute の拡張 MapReduce (MR2) モデルとは根本的に異なります。
ChainMapper と ChainReducer は、従来の MapReduce モデルに基づいています。これらは、元の Map または Reduce 操作の後に 1 つ以上の Map 操作を追加することのみが可能です。Reduce 操作を追加することはできません。このアプローチの利点は、既存の Mapper ビジネスロジックを再利用して、Map または Reduce 操作を複数の Mapper ステージに分割できることです。ただし、これは基盤となるスケジューリングと I/O モデルを根本的に変更するものではありません。