JOIN 操作は分散システムで一般的ですが、時間とリソースの観点でコストが高くなります。特に、大規模データのシナリオではシャッフル操作のコストが高くなります。これに対処するため、MaxCompute は等価結合の特性を活用してシャッフル操作を最適化します。
仕組み
JOIN を含む一般的な SQL 文は次のとおりです:
SELECT * FROM (table1) A JOIN (table2) B ON A.a = B.b;データセットが小さいシナリオでは、動的フィルターは MergeJoin と併用した場合にのみ有効になります。正しく実行するために、次のフラグを設定してください:
-
set odps.optimizer.enable.conditional.mapjoin=false; -
set odps.optimizer.cbo.rule.filter.black=hj;
MaxCompute は JOIN の等価条件に基づき、テーブル A のデータからフィルターを生成して、シャッフルまたは JOIN 操作の前にテーブル B のデータをフィルタリングできます。MaxCompute は、基盤となるストレージにフィルターをプッシュダウンし、ソースでデータをフィルタリングすることも可能です。このように実行時にフィルターを動的に生成する機能を、動的フィルター (DF) と呼びます。
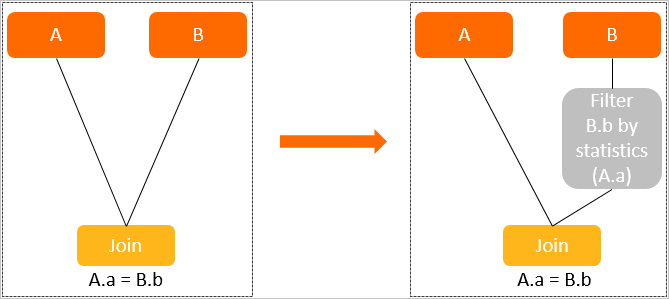
次の図は、前述の SQL 文について、動的フィルターを有効化する前後の実行計画を示しています。
ユースケース
動的フィルター機能は、等価結合の特性を利用して実行時にフィルターを生成します。これにより、シャッフルまたは JOIN 操作の前にデータをフィルタリングでき、クエリ実行を高速化します。この機能は、ディメンションテーブルをファクトテーブルに結合するシナリオに最適です。
動的な範囲フィルターまたはブルームフィルター
前述の図に示すとおり、元の実行計画にはフィルターが存在しません。システムは JOIN の特性に基づいてフィルターを自動生成します。このフィルターは、テーブル A から生成された集合にテーブル B の要素が存在するかどうかを確認し、存在しない要素を除外します。
実際には、動的フィルターはブルームフィルターを使用するか、または [min, max] 値に基づく範囲フィルターや IN 述語など、他のデータフィルタリング方法を使用できます。
動的フィルターは、次の図に示す一般的な生産者消費者モデルに従います。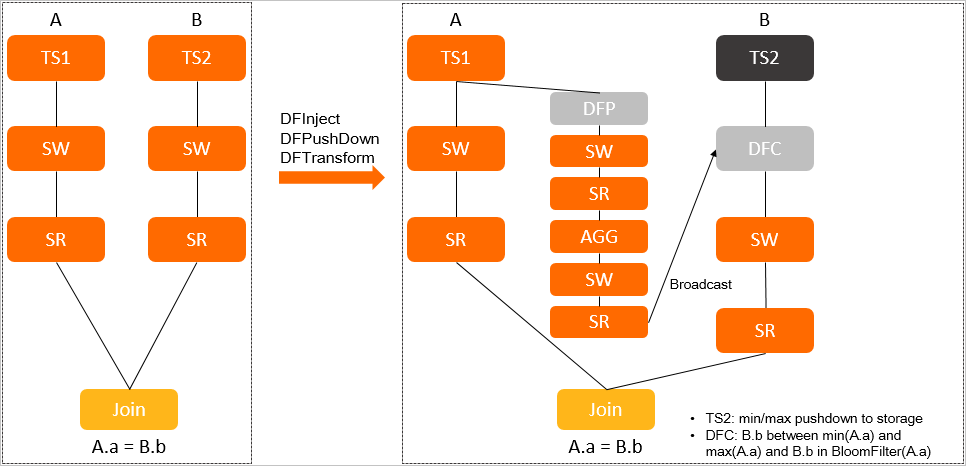
-
DFP (Dynamic Filter Producer) 演算子:動的フィルターの生産者です。小さい方のテーブルのデータを使用してブルームフィルターを生成し、結合キーの
min値およびmax値 (範囲フィルター用) を取得します。その後、この情報を DFC に送信します。 -
DFC (Dynamic Filter Consumer) 演算子:動的フィルターの消費者です。ブルームフィルターと範囲フィルターを使用して、大きい方のテーブルのデータをフィルタリングします。範囲フィルターは、フィルター条件を基盤となるストレージにプッシュダウンし、ソースでデータをフィルタリングしようとします。
JOIN のセマンティクスが異なると、結合対象のテーブルは次のように異なる役割を担います:
-
A JOIN B:A と B のいずれも、生産者または消費者として動作できます。
-
A LEFT JOIN B:A は生産者としてのみ動作でき、B は消費者としてのみ動作できます。
-
A RIGHT JOIN B:A は消費者としてのみ動作でき、B は生産者としてのみ動作できます。
-
A FULL OUTER JOIN B:動的フィルターは使用できません。
動的フィルターの使用方法については、「動的フィルターの有効化」をご参照ください。
動的パーティションプルーニング
前述のブルームフィルターと範囲フィルターの例は、結合キーがパーティションキー列ではない、非パーティションテーブルに対する最適化を示しています。結合キーがパーティションキー列である場合でも、動的な範囲フィルターまたはブルームフィルターは使用できます。ただし、MaxCompute はフィルタリングの前にパーティション内のすべてのデータを読み取ります。この処理は、読み取り前に不要なパーティションをプルーニングすることで最適化できます。この機能を動的パーティションプルーニング (DPP) と呼びます。
例として、JOIN を含む次の SQL 文を考えます:
-- A は非パーティションテーブルです。列 a の値は 20200701 です。
-- B はパーティションテーブルです。パーティションキー列 ds には 20200701、20200702、20200703 の 3 つのパーティションが含まれます。
SELECT * FROM (table1) A JOIN (table2) B ON A.a= B.ds;
動的パーティションプルーニングを有効化すると、オプティマイザはテーブルがパーティションテーブルであるかどうかに基づいて、適用するかどうかを判断します。動的パーティションプルーニングが有効になると、MaxCompute は小さい方のテーブルからデータを収集してブルームフィルターを生成します。次に、大きい方のテーブルのパーティションリストをフィルタリングし、読み取る必要があるパーティションを特定して、それ以外をプルーニングします。プロセスの対象パーティションがすべてプルーニングされた場合、そのプロセスはスケジュールされません。
前述の例では、テーブル A の列 a の値が 20200701 のみであるため、動的パーティションプルーニングを有効化すると、テーブル B の 20200702 および 20200703 パーティションがプルーニングされます。これにより、リソースを節約し、ジョブ実行時間を短縮できます。
動的パーティションプルーニングの使用方法については、「動的パーティションプルーニングの有効化」をご参照ください。
動的フィルターの有効化
MaxCompute では、次の方法で動的フィルターを有効化できます:
-
方法 1:セッションレベルで動的フィルタリングを強制します。SQL 文と一緒に次のコマンドを送信します:
set odps.optimizer.force.dynamic.filter=true;説明このプロパティはプロジェクトレベルでも設定できますが、セッションレベルで設定することを推奨します。フィルタリングの効果が得られない JOIN ジョブでは、処理効率が低下する可能性があります。
この方法では、サポートされているすべての JOIN ジョブに動的フィルターが挿入されます。
-
方法 2:セッションレベルで、動的フィルタリングを使用するかどうかをオプティマイザに自動判断させます。
set odps.optimizer.enable.dynamic.filter=true;この方法を使用すると、オプティマイザは動的フィルターを挿入するメリットが十分にあるかどうかを見積もります。十分なメリットがある場合は動的フィルターを挿入し、ない場合は挿入しません。
説明この方法は、個別値数 (NDV) などのメタデータ統計情報に依存します。メタデータ統計情報の詳細については、「オプティマイザ用の情報の収集」をご参照ください。メタデータ統計情報はオプティマイザによる推定値であるため、不正確な場合があります。その結果、想定どおりに動的フィルターが挿入されないことがあります。
-
方法 3:SQL 文内のヒントを使用して動的フィルターを有効化します。
ヒントの形式は
/*+dynamicfilter(Producer, Consumer1[, Consumer2,...])*/です。1 つの生産者が複数の消費者をフィルタリングできます。次のコマンドは例です:select /*+dynamicfilter(A, B)*/ * from table1 A join table2 B on A.a= B.b;
動的パーティションプルーニングの有効化
SQL 文と一緒に次のコマンドを送信して、セッションレベルで動的パーティションプルーニングを有効化します:
set odps.optimizer.dynamic.filter.dpp.enable=true;このプロパティはプロジェクトレベルでも設定できますが、セッションレベルで設定することを推奨します。データフィルタリングの効果が得られない JOIN ジョブでは、処理効率が低下する可能性があります。
最適化の検証
「動的フィルターの有効化」または「動的パーティションプルーニングの有効化」の説明に従って機能を有効化した後、次の方法で有効になっていることを確認できます:
動的フィルターの検証
SQL ジョブの実行後、その LogView 情報を確認します。LogView に DynamicFilterConsumer1 のような演算子が表示される場合、動的フィルターが有効になっています。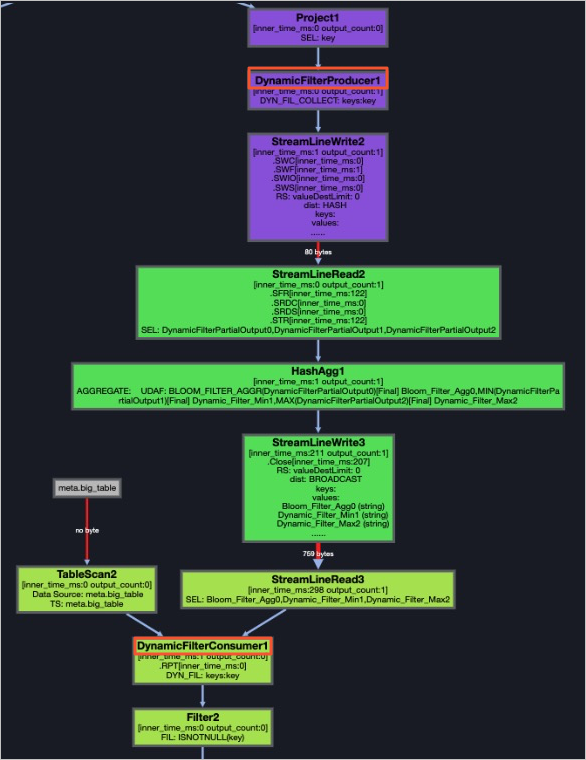
動的パーティションプルーニングの検証
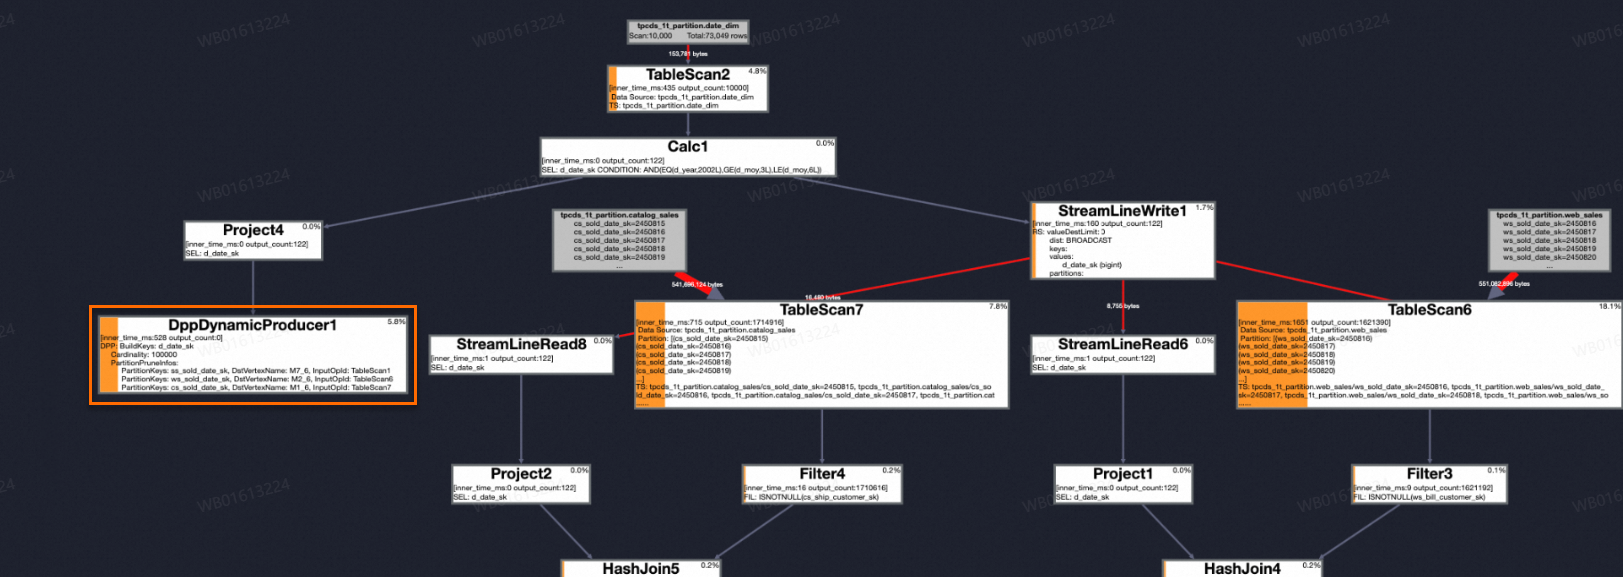
SQL ジョブの実行後、その LogView 情報を確認します。LogView に PartitionPruneInfos を含む DppDynamicProducer のような演算子が表示される場合、動的パーティションプルーニングが有効になっています。