MaxCompute は、Object Storage Service (OSS) のディレクトリにマッピングされる OSS 外部テーブルをサポートしています。OSS 外部テーブルを使用して、OSS から非構造化データを読み取ったり、OSS にデータを書き込んだりできます。
注意事項
OSS 外部テーブルはクラスタープロパティをサポートしていません。
単一ファイルのサイズは 2 GB を超えることはできません。2 GB を超えるファイルは分割する必要があります。
MaxCompute と OSS は同じリージョンにある必要があります。
アクセス方法
以下のプラットフォームは、OSS 外部テーブルの作成と使用をサポートしています。
方法 | プラットフォーム |
MaxCompute SQL | |
可視化 |
前提条件
OSS バケットとディレクトリを準備します。バケットの作成とディレクトリの管理。
MaxCompute は OSS ディレクトリを自動的に作成できます。SQL ステートメントに外部テーブルと UDF が含まれている場合、単一の SQL ステートメントで外部テーブルからの読み取りまたは書き込みと UDF の実行が可能です。手動でのディレクトリ作成もサポートされています。
MaxCompute は一部のリージョンにのみデプロイされているため、クロスリージョンのネットワーク接続に問題が発生する可能性があります。バケットは MaxCompute プロジェクトと同じリージョンに配置してください。
権限付与
OSS へのアクセス権限を取得します。Alibaba Cloud アカウント、RAM ユーザー、または RAM ロールが OSS 外部テーブルにアクセスできます。OSS の STS 認証。
MaxCompute プロジェクトで CreateTable 権限を取得します。MaxCompute 権限。
権限の説明
OSS 外部テーブルにアクセスする際、Alibaba Cloud アカウント、RAM ユーザー、または RAM ロールのいずれを使用しているかに関わらず、データは
odps.properties.rolearnパラメーターで指定されたロールを通じてアクセスされます。したがって、RAM ロールを作成し、対象の OSS バケットへのアクセス権限を付与した後、そのロールの ARN をodps.properties.rolearnパラメーターに設定する必要があります。詳細については、「パラメーター」をご参照ください。ビジネス要件に応じて、同一アカウントまたはクロスアカウントのアクセスを許可できます。よりきめ細かなアクセス制御を行うには、カスタム権限付与ポリシーを使用することを推奨します。詳細については、「外部データソースの権限付与」をご参照ください。
OSS 外部テーブルの作成
パーティションテーブルと非パーティション化テーブル:
OSS でのデータファイルの保存方法に基づいて選択します。ファイルがパーティションパスにある場合はパーティションテーブルを使用し、そうでない場合は非パーティション化テーブルを使用します。
OSS 外部テーブルはパーティション操作をサポートしています。
ネットワークドメイン名:OSS にはクラシックネットワークドメイン名を使用します。MaxCompute はパブリックネットワークドメイン名のネットワーク接続を保証しません。
OSS 外部テーブルは、OSS ディレクトリへのマッピングのみを記録します。OSS 外部テーブルを削除しても、マッピングされた OSS ディレクトリ内のデータファイルは削除されません。
OSS データファイルがアーカイブ済みオブジェクトの場合、まずオブジェクトを復元する必要があります。
CREATE EXTERNAL TABLE の構文はデータファイル形式によって異なります。構文とパラメーターをデータ形式に合わせてください。設定が正しくないと、読み取りおよび書き込みに失敗します。
構文
組み込みテキストデータパーサーを使用した外部テーブルの作成
構文 | データファイル形式 | 例 |
| OSS からの読み取りまたは OSS への書き込みでサポートされているデータファイル形式:
|
組み込みオープンソースデータパーサーを使用した外部テーブルの作成
構文 | データファイル形式 | 例 |
| OSS からの読み取りまたは OSS への書き込みでサポートされているデータファイル形式:
|
カスタムパーサーを使用した外部テーブルの作成
構文 | データファイル形式 | 例 |
| OSS からの読み取りまたは OSS への書き込みでサポートされているデータファイル形式:上記以外の形式のデータファイル。 |
パラメーター
以下のパラメーターは、すべての外部テーブル形式で共通です。形式固有のパラメーターについては、各形式のドキュメントをご参照ください。
基本構文パラメーター
パラメーター
必須
説明
mc_oss_extable_name
はい
作成する OSS 外部テーブルの名前。
テーブル名は大文字と小文字を区別せず、特定の大文字小文字に強制的に変換することはできません。
col_name
はい
OSS 外部テーブルの列の名前。
外部テーブルのスキーマは OSS データファイルのスキーマと一致する必要があります。そうでない場合、データは読み取れません。
data_type
はい
OSS 外部テーブルの列のデータ型。
各列のデータ型は、対応する OSS データファイルの列と一致する必要があります。そうでない場合、データは読み取れません。
table_comment
いいえ
テーブルのコメント。コメントは 1,024 バイト以下の有効な文字列でなければなりません。そうでない場合、エラーが報告されます。
partitioned by (col_name data_type, ...)
いいえ
OSS 内のデータファイルがパーティションパスに保存されている場合、このパラメーターを含めてパーティションテーブルを作成します。
col_name:パーティションキー列の名前。
data_type:パーティションキー列のデータ型。
'<(tb)property_name>'='<(tb)property_value>'
はい
外部テーブルの拡張プロパティ。詳細については、形式固有のドキュメントをご参照ください。
oss_location
はい
データファイルが配置されている OSS パス。デフォルトでは、このパス内のすべてのデータファイルが読み取られます。
フォーマットは
oss://<oss_endpoint>/<バケット名>/<OSS ディレクトリ名>/です。oss_endpoint:
OSS ドメイン名。OSS が提供するクラシックネットワークエンドポイントを使用する必要があり、これには
-internalが含まれます。例:
oss://oss-cn-beijing-internal.aliyuncs.com/xxx。OSS クラシックネットワークドメイン名は、「リージョンとエンドポイント」に記載されています。
データファイルが保存されている OSS リージョンを、ご利用の MaxCompute プロジェクトのリージョンと同じにしてください。異なるリージョンにある場合、ネットワーク接続の問題が発生する可能性があります。
エンドポイントを指定しない場合、システムは現在のプロジェクトが配置されているリージョンのエンドポイントを使用します。
クロスリージョンのファイルストレージはネットワーク接続の問題を引き起こす可能性があるため、この方法は推奨されません。
バケット名:OSS バケットの名前です。
oss_endpointに従う必要があります。例:
oss://oss-cn-beijing-internal.aliyuncs.com/your_bucket/path/。バケット名は「バケットのリスト」で確認できます。
ディレクトリ名:OSS ディレクトリの名前。ディレクトリの後にファイル名を指定しないでください。
例:
oss://oss-cn-beijing-internal.aliyuncs.com/oss-mc-test/Demo1/。不正な例:
 -- HTTP 接続はサポートされていません。
http://oss-cn-shanghai-internal.aliyuncs.com/oss-mc-test/Demo1/
-- HTTPS 接続はサポートされていません。
https://oss-cn-shanghai-internal.aliyuncs.com/oss-mc-test/Demo1/
-- 不正な接続アドレスです。
oss://oss-cn-shanghai-internal.aliyuncs.com/Demo1
-- ファイル名を指定しないでください。
oss://oss-cn-shanghai-internal.aliyuncs.com/oss-mc-test/Demo1/vehicle.csv
WITH serdeproperties 属性
property_name
シナリオ
property_value
デフォルト値
odps.properties.rolearn
STS 認証を使用する場合にこのプロパティを追加します。
OSS へのアクセス権限を持つ RAM ロールの ARN を指定します。
RAM コンソールのロール詳細から ARN を取得します。例:
acs:ram::xxxxxx:role/<role_name>。MaxCompute と OSS の所有者が同じアカウントの場合:
テーブル作成ステートメントで
odps.properties.rolearnを指定しない場合、デフォルトでaliyunodpsdefaultroleロールの ARN が使用されます。まず、STS 認証を使用して RAM ロールを作成する必要があります。AliyunODPSDefaultRoleは広範な権限を持っています。カスタムロールを通じて権限を付与することを推奨します。カスタムロールの ARN を使用するには、まずカスタムロールを作成します。OSS の STS 認証 (カスタム権限付与)。
MaxCompute と OSS の所有者が異なるアカウントの場合、カスタムロールの ARN を指定する必要があります。詳細については、「OSS の STS 認証 (カスタム権限付与)」をご参照ください。
ホワイトリストとブラックリスト
MaxCompute OSS 外部テーブルは、ホワイトリストとブラックリストによるフィルタリングをサポートしています。tblproperties にホワイトリストとブラックリストのパラメーターを設定することで、ディレクトリから読み取るファイルをフィルタリングできます。
tblproperties パラメーター
有効なルール
ブラックリストはホワイトリストより優先されます:ファイルがブラックリストの条件に一致する場合、そのファイルは除外されます。
セッションフラグと tblproperties のブラックリストパラメーターは「OR」関係にあります。両方が設定されている場合、両方が有効になり、どちらかのブラックリスト条件に一致するファイルは除外されます。tblProperties の設定が推奨されます。
設定方法
パスの種類
パラメーター
セッションフラグ
絶対パス
odps.sql.unstructured.file.pattern.black.list
tblproperties
相対パス
odps.external.data.file.blacklist.regex
正規表現の注意点
行頭
^と行末$のアンカーはオプションです。例えば、.jsonファイルに一致させるには、.*\.jsonで十分です。正規表現パターンは1つしかサポートされていません。複数のファイルタイプを除外するには、| を使用します:
-- csv、txt、parquet ファイルを除外
"odps.external.data.file.blacklist.regex": ".*\\.(txt|csv|parquet)$"
ホワイトリストとブラックリストのパラメーターの更新
ALTER TABLE {table_name}
SET tblproperties('odps.external.data.file.whitelist.regex'='new_regex')

ALTER TABLE {table_name}
SET tblproperties('odps.external.data.file.blacklist.regex'='new_regex')
例
サンプルデータ
-- OSS ディレクトリに以下のファイルが含まれていると仮定します:

oss://xxx/bucket/level1/data1.txt
oss://xxx/bucket/level1/data2.json
oss://xxx/bucket/level1/data3.csv
oss://xxx/bucket/level1/level2/data4.txt
oss://xxx/bucket/level1/level2/data5.json
oss://xxx/bucket/level1/level2/data6.parquet
ホワイトリスト:JSON ファイルのみを読み取る
CREATE EXTERNAL TABLE test_whitelist_table
(
    id INT,
    name STRING
)
row format serde 'org.apache.hive.hcatalog.data.JsonSerDe'
STORED AS textfile
LOCATION 'oss://xxx/bucket/level1'
TBLPROPERTIES (
  'odps.external.data.enable.extension'='true', -- ファイル拡張子サポートを有効化
  'odps.external.data.file.whitelist.regex'='.*\\.json'); -- ホワイトリスト:JSON ファイルのみ

-- SELECT * FROM test_whitelist_table を実行すると、すべての JSON ファイルが選択されます。
-- クエリは data2.json と level2/data5.json からのデータを返します
ブラックリスト:txt、csv、parquet ファイルを除外する
CREATE EXTERNAL TABLE test_blacklist_table
(
    id INT,
    name STRING
)
row format serde 'org.apache.hive.hcatalog.data.JsonSerDe'
STORED as textfile
LOCATION 'oss://xxx/bucket/level1'
TBLPROPERTIES (
  'odps.external.data.enable.extension'='true', -- ファイル拡張子サポートを有効化
  'odps.external.data.file.blacklist.regex'='.*\\.(txt|csv|parquet)$'); -- ブラックリスト:txt、csv、parquet を除外

-- SELECT * FROM test_blacklist_table を実行すると、すべての TXT、CSV、Parquet ファイルが除外されます。
-- クエリは data2.json と level2/data5.json からのデータを返します
ホワイトリストとブラックリストの組み合わせ:txt ファイルを読み取り、level2 ディレクトリを除外する
CREATE EXTERNAL TABLE test_whitelist_blacklist_table
(
    id INT,
    name STRING
)
row format serde 'org.apache.hive.hcatalog.data.JsonSerDe'
STORED as textfile
LOCATION 'oss://xxx/bucket/level1'
TBLPROPERTIES (
  'odps.external.data.enable.extension'='true', -- ファイル拡張子サポートを有効化
  'odps.external.data.file.whitelist.regex'='.*\\.txt', -- ホワイトリスト:txt ファイルのみ
  'odps.external.data.file.blacklist.regex'='.*level2/.*'); -- ブラックリスト:level2 ディレクトリを除外

-- select * from test_whitelist_blacklist_table を実行すると、
-- ホワイトリストが txt ファイルをフィルタリングし、その後ブラックリストが level2 ディレクトリを除外します
-- クエリは data1.txt のみからデータを返します
再帰的な一覧表示: サブディレクトリ内のファイルを読み取るかどうかをコントロールします
CREATE EXTERNAL TABLE test_recursive_enabled
(
    id INT,
    name STRING
)
row format serde 'org.apache.hive.hcatalog.data.JsonSerDe'
STORED as textfile
LOCATION 'oss://xxx/bucket/level1'
TBLPROPERTIES (
  'odps.external.data.enable.extension'='true', -- ファイル拡張子のサポートを有効化
  'odps.external.data.file.whitelist.regex'='.*\\.json' -- ホワイトリスト: json ファイルのみ
  'odps.external.data.file.recursive.listing.enabled'='true'); -- 再帰を有効化


-- SELECT * FROM test_recursive_enabled を実行すると、すべての JSON ファイルが選択されます。
-- クエリは data2.json と level2/data5.json からデータを返します。


CREATE EXTERNAL TABLE test_recursive_disabled
(
    id INT,
    name STRING
)
row format serde 'org.apache.hive.hcatalog.data.JsonSerDe'
STORED as textfile
LOCATION 'oss://xxx/bucket/level1'
TBLPROPERTIES (
  'odps.external.data.enable.extension'='true', -- ファイル拡張子のサポートを有効化
  'odps.external.data.file.whitelist.regex'='.*\\.json' -- ホワイトリスト: json ファイルのみ
  'odps.external.data.file.recursive.listing.enabled'='false'  -- 再帰を無効化
);

-- SELECT * FROM test_recursive_disabled を実行すると、すべての JSON ファイルが選択されますが、再帰的な読み取りは無効になっています。
-- クエリは data2.json のデータのみを返します (level2 ディレクトリは除外されます)
ALTER TABLE を介したホワイトリストとブラックリストの更新
CREATE EXTERNAL TABLE test_alter_table_properties
(
  id INT,
  name STRING
)
row format serde 'org.apache.hive.hcatalog.data.JsonSerDe'
STORED as textfile
LOCATION 'oss://xxx/bucket/level1'
TBLPROPERTIES (
  'odps.external.data.enable.extension'='true', -- ファイル拡張子サポートを有効化
  'odps.external.data.file.whitelist.regex'='.*\\.json'); -- ホワイトリスト:json ファイルのみ

-- SELECT * FROM test_alter_table_properties を実行すると、すべての JSON ファイルが選択されます
-- クエリは data2.json と level2/data5.json からのデータを返します

ALTER TABLE test_alter_table_properties
SET tblproperties(
  'odps.external.data.file.whitelist.regex'='.*level2/.*\\.json'
)
-- select * from test_alter_table_properties を実行すると
-- クエリは level2/data5.json のみからデータを返すようになります
OSS からのデータ読み取り
注意事項
OSS 外部テーブルを作成した後、外部テーブルを通じて OSS からデータを読み取ることができます。サポートされているデータファイルの種類と作成構文については、「構文」をご参照ください。
SQL ステートメントに複雑なデータ型が含まれる場合は、
set odps.sql.type.system.odps2=true;を先頭に追加して一緒に送信してください。データ型バージョン。オープンソースデータにマッピングされた OSS 外部テーブルの場合、OSS からデータを読み取る前にセッションレベルで
set odps.sql.hive.compatible=true;を設定してください。そうしないと、エラーが報告されます。OSS には帯域幅制限があります。短期間に読み取り/書き込みトラフィックがインスタンスの帯域幅制限を超えると、外部テーブルのパフォーマンスが低下します。制限とパフォーマンスメトリクス。
構文
<select_statement> FROM <from_statement>;select_statement:
SELECT句。ソーステーブルからターゲットテーブルに挿入するデータをクエリします。from_statement:
FROM句。外部テーブルの名前など、データソースを指定します。
非パーティション化データ
非パーティション化データ
非パーティション化 OSS 外部テーブルを作成した後、以下のいずれかの方法で OSS からデータを読み取ることができます:
方法 1 (推奨):OSS からオープンソース形式のデータを MaxCompute 内部テーブルにインポートし、その後データを読み取る。
繰り返し計算や高パフォーマンスのシナリオに最適です。外部テーブルと同じスキーマを持つ内部テーブルを作成し、データをインポートしてから複雑なクエリを実行します。内部ストレージは MaxCompute の最適化の恩恵を受けます。サンプルコマンド:
CREATE TABLE <table_internal> LIKE <mc_oss_extable_name>;
INSERT OVERWRITE TABLE <table_internal> SELECT * FROM <mc_oss_extable_name>;
方法 2:MaxCompute 内部テーブルの操作と同様に、OSS から直接データを読み取る。
低パフォーマンスのシナリオに最適です。各クエリは内部ストレージからではなく、OSS から直接データを読み取ります。
パーティション化データ
パーティション化データ
MaxCompute は、サブディレクトリを含む OSS ディレクトリ内のすべてのデータをフルスキャンします。大規模なデータセットの場合、これにより不要な I/O が発生し、処理時間が増加します。2つの解決策があります。
方法 1 (推奨):OSS 上のデータを標準パーティションパス形式またはカスタムパーティションパス形式で保存する。
テーブル作成ステートメントでパーティションと oss_location を指定します。標準パーティションパスが推奨されます。
方法 2:複数のデータストレージパスを計画する。
複数の外部テーブルを作成し、それぞれが OSS データの一部を指すようにします。この方法は手間がかかるため、推奨されません。
標準パーティションパス形式
oss://<oss_endpoint>/<バケット名>/<ディレクトリ名>/<partitionKey1=value1>/<partitionKey2=value2>/...例:ある企業が日々のログファイルを CSV 形式で OSS に保存し、MaxCompute を使用して毎日データを処理しています。OSS データを保存するための標準パーティションパスは次のように設定する必要があります。
oss://oss-odps-test/log_data/year=2016/month=06/day=01/logfile
oss://oss-odps-test/log_data/year=2016/month=06/day=02/logfile
oss://oss-odps-test/log_data/year=2016/month=07/day=10/logfile
oss://oss-odps-test/log_data/year=2016/month=08/day=08/logfile
...
カスタムパーティションパス形式
カスタムパーティションパス形式には、パーティション列名ではなく、パーティション列の値のみが含まれます。例:
oss://oss-odps-test/log_data_customized/2016/06/01/logfile
oss://oss-odps-test/log_data_customized/2016/06/02/logfile
oss://oss-odps-test/log_data_customized/2016/07/10/logfile
oss://oss-odps-test/log_data_customized/2016/08/08/logfile
...
OSS データが非標準のパーティションパスを使用している場合、サブディレクトリを手動でパーティションにバインドできます。
外部テーブルを作成した後、alter table ... add partition ... location ... を使用してサブディレクトリをパーティションにバインドします。例:
ALTER TABLE log_table_external ADD PARTITION (year = '2016', month = '06', day = '01')
location 'oss://oss-cn-hangzhou-internal.aliyuncs.com/bucket_name/oss-odps-test/log_data_customized/2016/06/01/';
ALTER TABLE log_table_external ADD PARTITION (year = '2016', month = '06', day = '02')
location 'oss://oss-cn-hangzhou-internal.aliyuncs.com/bucket_name/oss-odps-test/log_data_customized/2016/06/02/';
ALTER TABLE log_table_external ADD PARTITION (year = '2016', month = '07', day = '10')
location 'oss://oss-cn-hangzhou-internal.aliyuncs.com/bucket_name/oss-odps-test/log_data_customized/2016/07/10/';
ALTER TABLE log_table_external ADD PARTITION (year = '2016', month = '08', day = '08')
location 'oss://oss-cn-hangzhou-internal.aliyuncs.com/bucket_name/oss-odps-test/log_data_customized/2016/08/08/';
クエリの最適化
動的統計収集
動的統計収集
外部データには既存の統計情報がないため、クエリオプティマイザーは効率の低い保守的な戦略を使用します。動的統計収集により、オプティマイザーはクエリ実行中にテーブル統計を収集して小規模テーブルを特定し、ハッシュ結合、最適化された結合順序、シャッフルの削減、実行パイプラインの短縮を可能にします。
以下のパラメーターは、OSS 上の Hive テーブルシナリオ (Parquet、ORC、JSON、CSV など) にのみ適用され、Paimon 外部テーブル、Hudi 外部テーブル、Delta Lake 外部テーブルなどのレイクテーブルシナリオには適用されません。
SET odps.meta.exttable.stats.onlinecollect=true;
SELECT * FROM <tablename>;
パフォーマンステスト
テストデータセット:TPC-DS データ
テスト規模:100 GB
テストリソース:100 CU
注意:ビジネスシナリオは様々であるため、特定のワークロードに基づいてさらなる評価を推奨します。ビジネス SQL に応じて選択的にフラグを有効にしてください。
フラグの有効化
SET odps.meta.exttable.stats.onlinecollect=true;結論
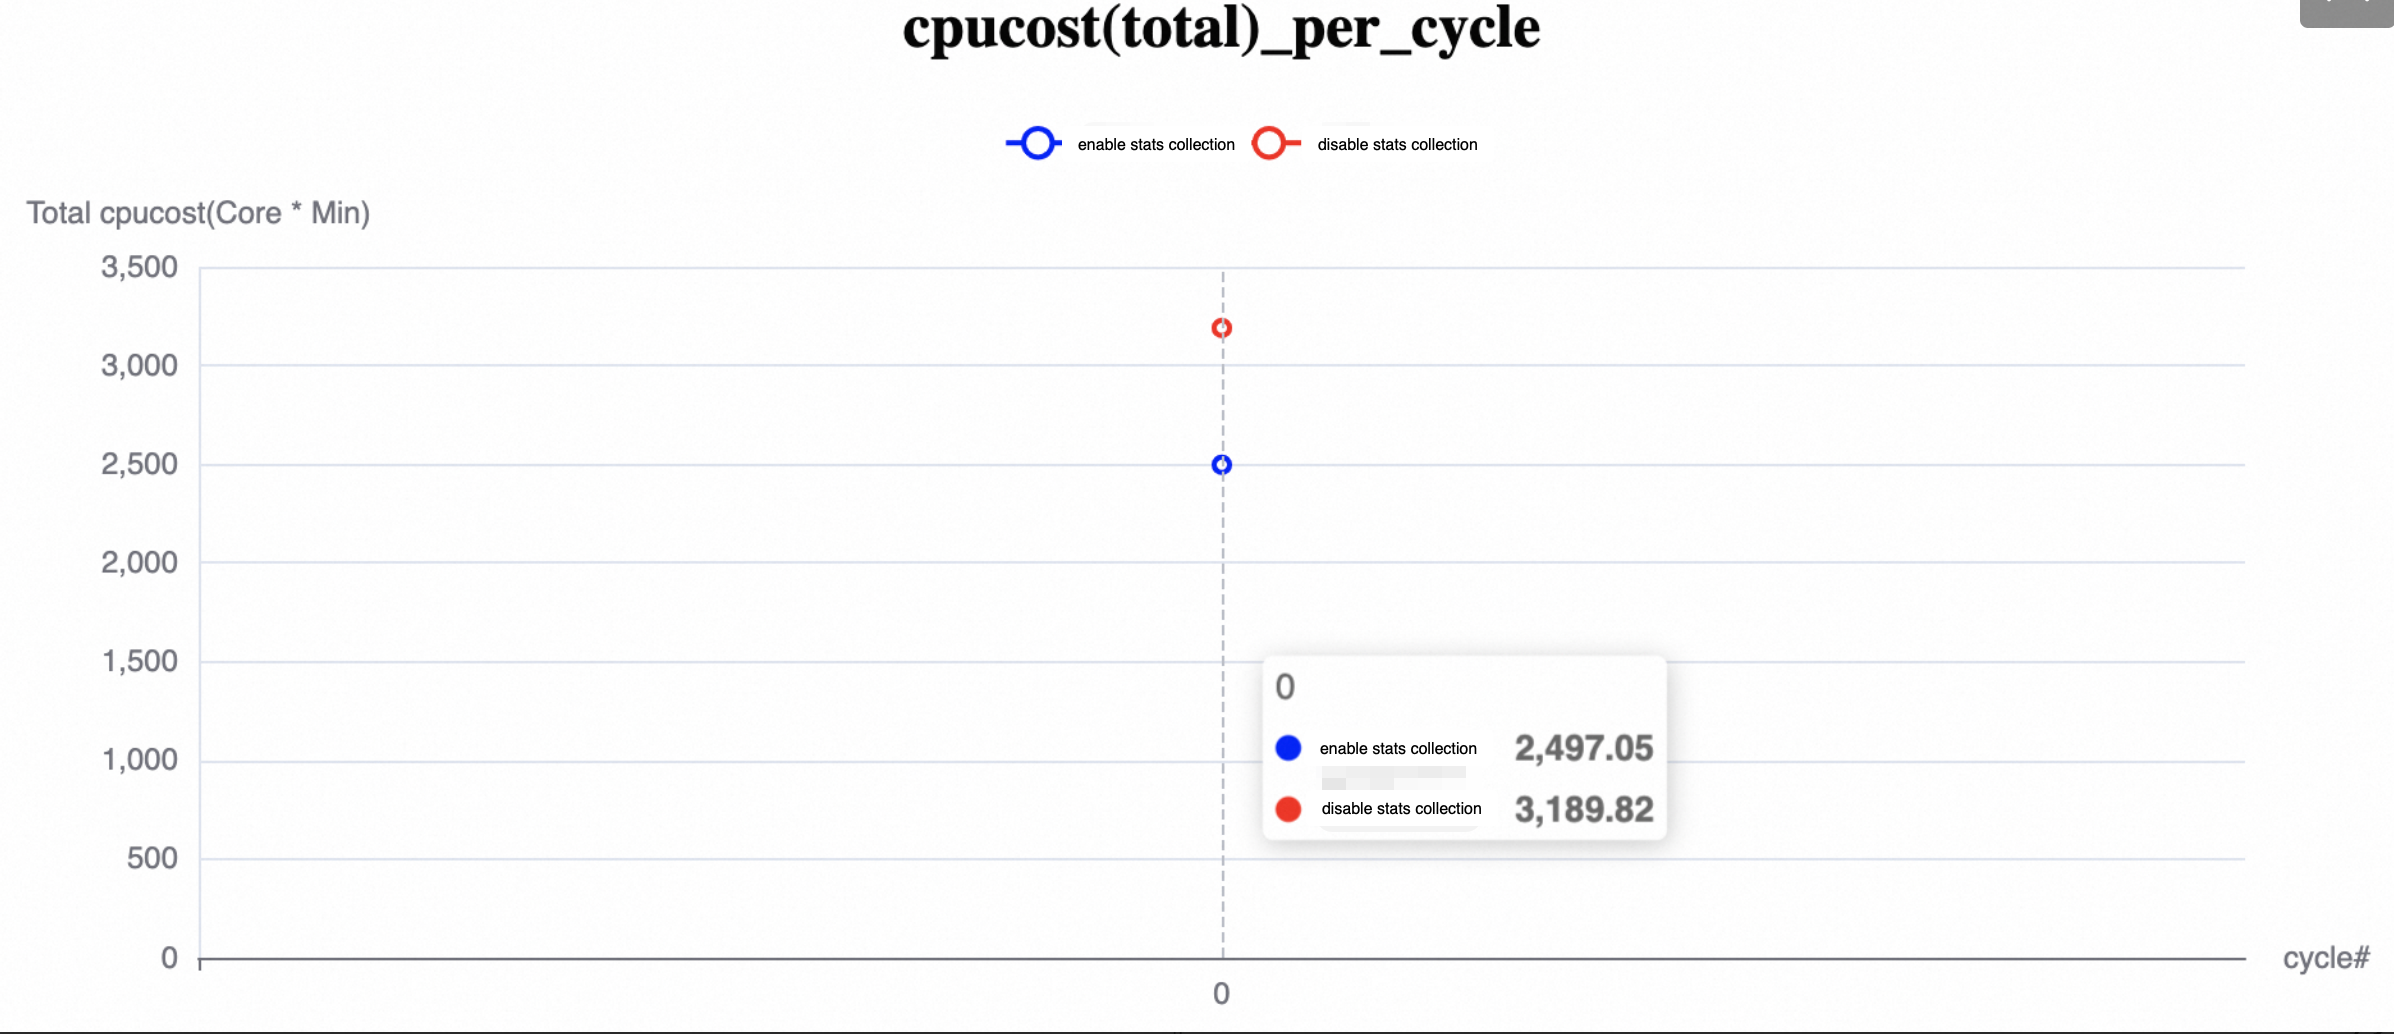
ジョブ実行時間は 22.75% 減少し、CPU 使用率は 21.72% 減少し、メモリ使用量は 24% 減少しました。
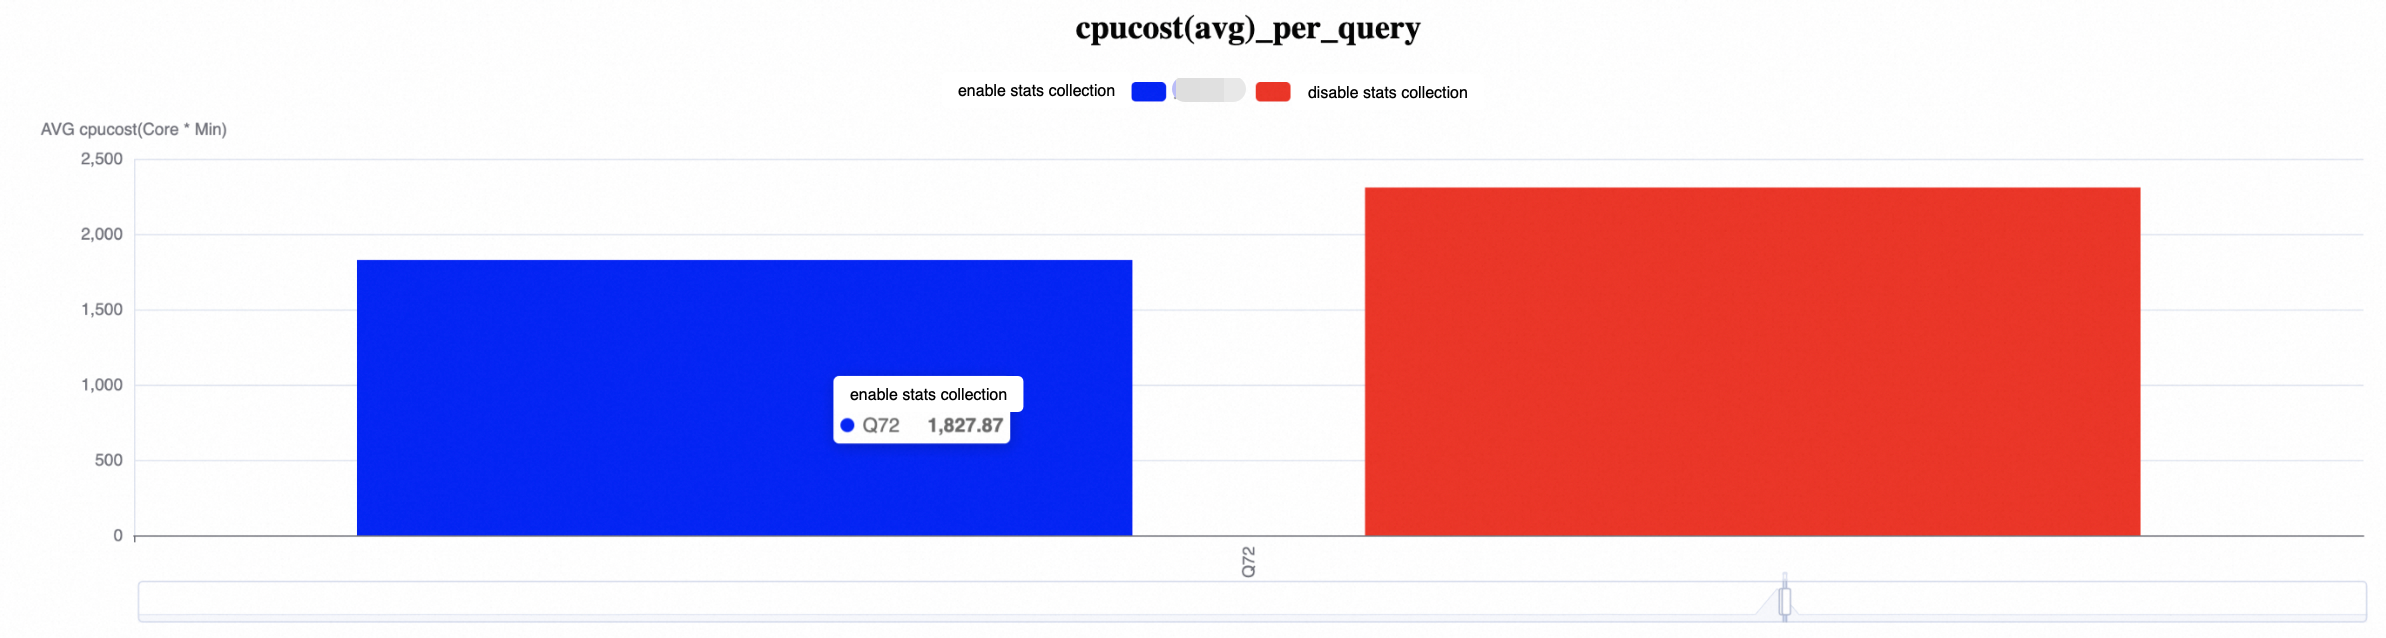
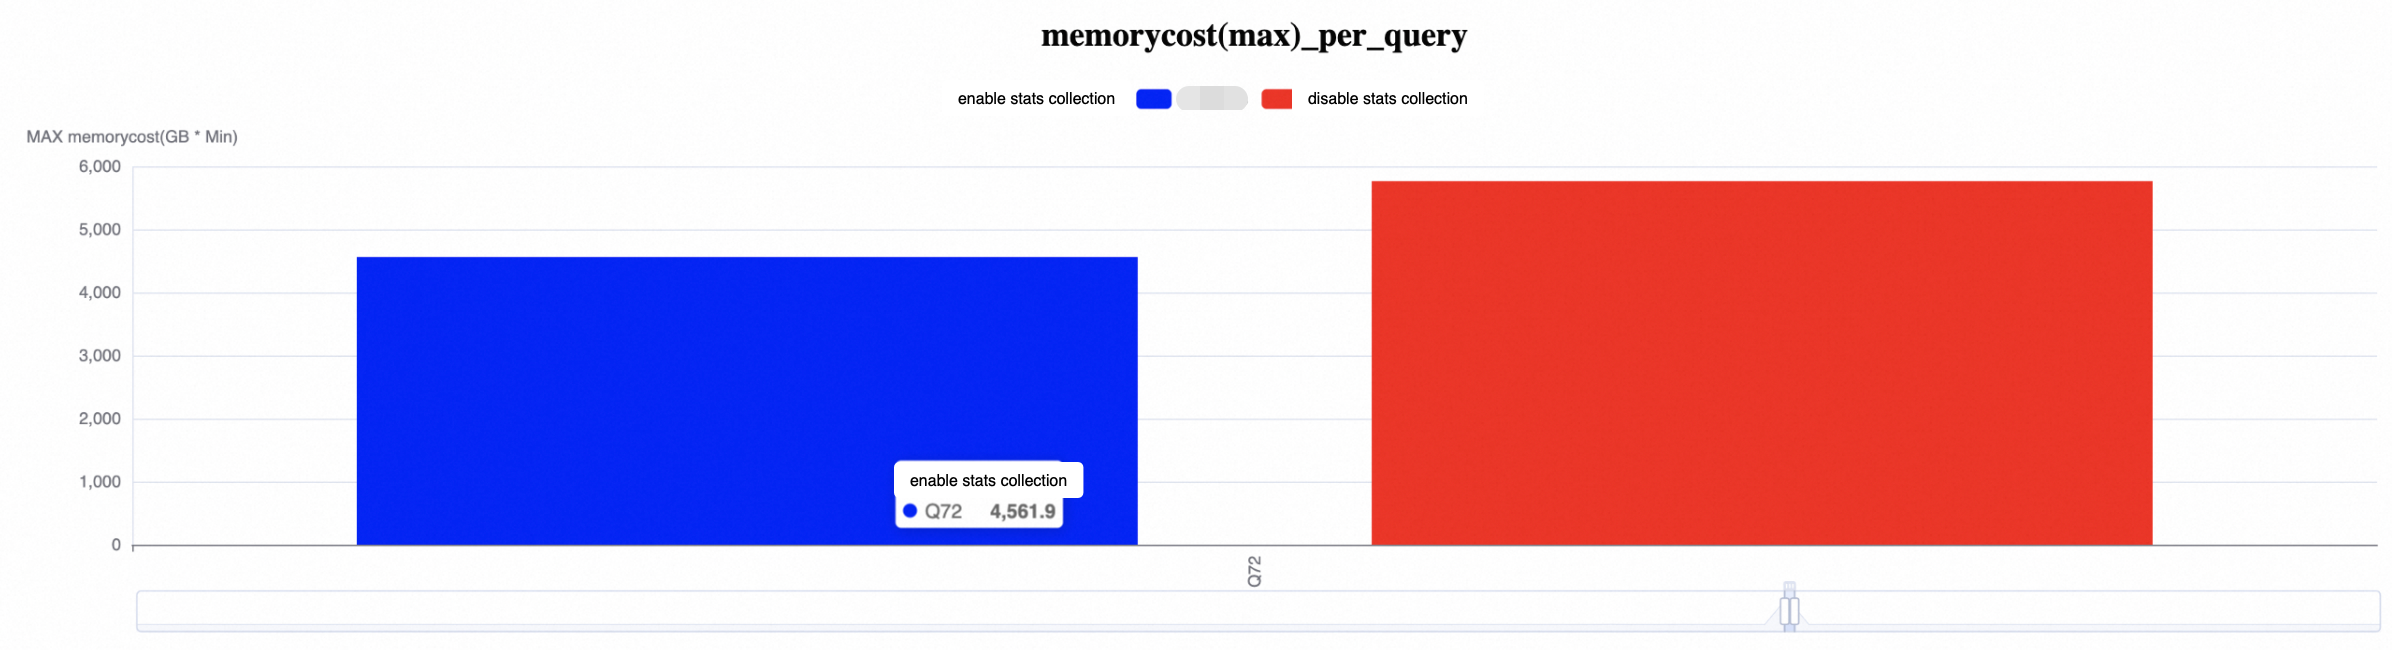
Q72 は最も遅いクエリで、ジョブ実行時間は 17.61% 減少し、CPU は 20.82%、メモリは 20.86% 減少しました。
TPCDS-Q72 では、小規模テーブルの統計情報が欠落していると実行計画が大幅に劣化しますが、統計情報を追加するとパフォーマンスが最大 5 倍向上します。Q3、Q18、Q19、Q72、Q99 も顕著な改善を示します。
全体として、クエリの大部分が大幅に恩恵を受けます。少数のクエリでは、実行計画が影響を受けないためエンドツーエンドの時間に改善は見られず、統計収集による追加のオーバーヘッドが発生するだけです。オプティマイザーフェーズで導入される追加のレイテンシは数十から数百ミリ秒の範囲であり、エンドツーエンドの時間への影響は最小限です。
すべてのクエリ
ジョブ実行時間は 22.75% 減少し、CPU 使用率は 21.72% 減少し、メモリ使用量は 24% 減少しました。



Q72
Q72 は最も遅いクエリで、ジョブ実行時間は 17.61% 減少し、CPU は 20.82%、メモリは 20.86% 減少しました。

外部テーブルの分割最適化
外部テーブルの分割最適化
分割サイズを調整して、各同時実行タスクが処理するデータ量を制御します。
データ量が大きく、分割サイズが小さすぎると、過剰な分割により並列度が高くなり、インスタンスはほとんどの時間をリソース待機に費やします。
データ量が少なく、分割サイズが大きすぎると、分割が少なすぎて同時実行数が不足し、リソースがアイドル状態になります。
-- 以下のいずれかのパラメーターを使用できます。

-- 単位:MiB。デフォルト値:256 MiB。内部テーブルまたは外部テーブルに適用されます。
SET odps.stage.mapper.split.size=<value>;
SELECT * FROM <tablename>;

-- 単位:MiB。デフォルト値:256 MiB。外部テーブルにのみ適用されます。
SET odps.sql.unstructured.data.split.size=<value>;
SELECT * FROM <tablename>;
DOP 制御
DOP による並列度の制御
データを読み取る際の並列度を調整するために、odps.sql.split.dop パラメーターを設定できます。このパラメーターは odps.sql.mapper.split.size よりも優先度が高いです。
dop の値が OSS ディレクトリ内のファイル数より大きい場合、実際の同時実行数は設定された dop の値と大幅に異なる可能性があります。
dop の値が小さすぎる場合、効果がありません。単一のインスタンスが処理できるファイルの最大数を変更するには、
odps.input.file.num.limitパラメーターを使用します。
構文
-- 2層モデルの構文:set odps.sql.split.dop={"project.table": xxx};
-- 3層モデルの構文:set odps.sql.split.dop={"project.schema.table": xxx};

SET odps.sql.split.dop={
  "project.schema.table1": xxx,
  "project.schema.table2": yyy
};

SET odps.sql.common.table.planner.ext.hive.bridge=FALSE;

SELECT * FROM <your_table>;
使用例
小規模ファイルが多すぎることによる DOP の歪みの問題と解決策
MaxCompute は、単一のインスタンスが処理できるファイルの最大数を 240 に制限しています。OSS 外部テーブルのディレクトリに 3,449 個のファイルが含まれている場合、最小並列度は 3,449 / 240 ≈ 15 になります。DOP を 15 未満の値に設定すると、その設定は無視されます。
これを解決するには、odps.input.file.num.limit を設定して、単一のインスタンスが処理できるファイルの最大数を変更します。
SET odps.sql.split.dop = {"lakehouse47_3.tpch_1t_parquet_snappy.lineitem": 2};
SET odps.input.file.num.limit = 5000;
単一のインスタンスは最大 5,000 個の OSS ファイルを処理できます。lineitem テーブルのファイル数はこの制限をはるかに下回っているため、実際の並列度は設定された DOP の値と一致します。
OSS へのデータ書き込み
MaxCompute は、内部テーブルまたは処理済みの外部テーブルから OSS にデータを書き込むことができます。制限事項については、「適用範囲」をご参照ください。
組み込みのテキストパーサまたはオープンソースのデータパーサを使用して OSS にデータを書き込む:組み込みテキストパーサ、組み込みオープンソースパーサ。
カスタムパーサを使用して OSS にデータを書き込む:例:カスタムパーサを使用した OSS 外部テーブルの作成。
OSS のマルチパートアップロード機能を使用して OSS にデータを書き込む:OSS のマルチパートアップロード機能を使用した OSS へのデータ書き込み。
構文
INSERT {INTO|OVERWRITE} TABLE <table_name> PARTITION (<ptcol_name>[, <ptcol_name> ...])
<select_statement> FROM <from_statement>;
パラメーター | 必須 | 説明 |
table_name | はい | 書き込み先の外部テーブルの名前。 |
select_statement | はい |
|
from_statement | はい | データソース (たとえば、読み取り元となる内部テーブルの名前など) を示す |
動的パーティションにデータを挿入する方法については、「動的パーティションへのデータの挿入または上書き」をご参照ください。
注意事項
INSERT OVERWRITE ... SELECT ... FROM ...;操作がソーステーブル from_tablename に 1,000 のマッパーを割り当てると、1,000 の TSV または CSV ファイルが生成されます。MaxCompute が提供する構成を使用して、生成されるファイルの数を制御できます。
アウトプッターがマッパーにある場合:
odps.stage.mapper.split.sizeを使用して同時マッパー数をコントロールすることで、生成ファイル数を調整します。アウトプッターがリデューサーまたはジョイナーにある場合は、それぞれ
odps.stage.reducer.numとodps.stage.joiner.numを使用して、生成されるファイルの数を調整します。
書き込みの不整合のリスク:OSS 外部テーブルに対して INSERT OVERWRITE 文を使用するか、UNLOAD コマンドを使用して OSS にファイルをエクスポートすると、指定された OSS の場所のサブディレクトリ、またはパーティションに対応する場所のデータが削除されてから、新しいデータが書き込まれます。場所のディレクトリに他の外部エンジンによって OSS に直接書き込まれた重要なデータが含まれている場合、そのデータも新しいデータが書き込まれる前に削除されます。したがって、外部テーブルの場所のディレクトリにある既存のファイルがバックアップされていること、または UNLOAD ディレクトリが空であることを確認する必要があります。その他の書き込みの不整合のリスクについては、「適用範囲」をご参照ください。
OSS のマルチパートアップロード機能を使用した OSS へのデータ書き込み
オープンソースフォーマットで OSS にデータを書き込むには、オープンソースデータパーサを使用して外部テーブルを作成し、OSS のマルチパートアップロード機能を有効にします。
OSS のマルチパートアップロード機能を有効にするには、次のように設定します:
シナリオ | コマンド |
プロジェクトレベルでの設定 | プロジェクト全体で有効になります。 |
セッションレベルでの設定 | 現在のタスクに対してのみ有効になります。 |
odps.sql.unstructured.oss.commit.mode のデフォルト値は false です。2 つのモードの動作は次のとおりです。
値 | 原則 |
false | データは LOCATION ディレクトリ配下の .odps フォルダに保存され、データ整合性のために .meta ファイルが使用されます。.odps の内容は MaxCompute によってのみ正しく処理できます。他のエンジンでは解析に失敗する可能性があります。 |
true | MaxCompute は、他のデータ処理エンジンとの互換性を確保するためにマルチパートアップロード機能を使用します。また、 |
エクスポートされたファイルの管理
パラメーター
次のパラメーターを使用して、出力データファイルにプレフィックス、サフィックス、または拡張子を追加します。
property_name | シナリオ | 説明 | property_value | デフォルト値 |
odps.external.data.output.prefix (odps.external.data.prefix と互換性あり) | 出力ファイルにカスタムプレフィックスを追加する必要がある場合に、このプロパティを追加します。 |
| 'mc_' のように、許可された文字の組み合わせ | なし |
odps.external.data.enable.extension | 出力ファイルの拡張子を表示する必要がある場合に、このプロパティを追加します。 | True は出力ファイルの拡張子が表示されることを示します。False は表示されないことを示します。 |
| False |
odps.external.data.output.suffix | 出力ファイルにカスタムサフィックスを追加する必要がある場合に、このプロパティを追加します。 | 数字、文字、アンダースコア (a-z, A-Z, 0-9, _) のみを含みます。 | '_hangzhou' のように、許可された文字の組み合わせ | なし |
odps.external.data.output.explicit.extension | 出力ファイルにカスタム拡張子を追加する必要がある場合に、このプロパティを追加します。 |
| "jsonl" のように、許可された文字の組み合わせ | なし |
例
OSS に書き込まれるファイルのカスタムプレフィックスを
test06_に設定します。DDL は以下のとおりです。CREATE EXTERNAL TABLE <mc_oss_extable_name> ( vehicleId INT, recordId INT, patientId INT, calls INT, locationLatitute DOUBLE, locationLongitude DOUBLE, recordTime STRING, direction STRING ) ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe' WITH serdeproperties ( 'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole' ) STORED AS textfile LOCATION 'oss://oss-cn-beijing-internal.aliyuncs.com/***/' TBLPROPERTIES ( -- カスタムプレフィックスを追加します。 'odps.external.data.output.prefix'='test06_') ; -- 外部テーブルにデータを書き込みます。 INSERT INTO <mc_oss_extable_name> VALUES (1,32,76,1,63.32106,-92.08174,'9/14/2014 0:10','NW');データ書き込み後、OSS で生成されたファイルは、カスタムプレフィックス
test06_で命名されます。たとえば、test06_202509101のようになります。OSS に書き込むファイルのサフィックスを
_beijingにカスタマイズする DDL は、次のとおりです。CREATE EXTERNAL TABLE <mc_oss_extable_name> ( vehicleId INT, recordId INT, patientId INT, calls INT, locationLatitute DOUBLE, locationLongitude DOUBLE, recordTime STRING, direction STRING ) ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe' WITH serdeproperties ( 'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole' ) STORED AS textfile LOCATION 'oss://oss-cn-beijing-internal.aliyuncs.com/***/' TBLPROPERTIES ( -- カスタムサフィックスを追加します。 'odps.external.data.output.suffix'='_beijing') ; -- 外部テーブルにデータを書き込みます。 INSERT INTO <mc_oss_extable_name> VALUES (1,32,76,1,63.32106,-92.08174,'9/14/2014 0:10','NW');出力ファイルの拡張子を自動的に生成するには、次の DDL を使用します:
CREATE EXTERNAL TABLE <mc_oss_extable_name>
(
  vehicleId INT,
  recordId INT,
  patientId INT,
  calls INT,
  locationLatitute DOUBLE,
  locationLongitude DOUBLE,
  recordTime STRING,
  direction STRING
)
ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe'
WITH serdeproperties (
  'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole'
)
STORED AS textfile
LOCATION 'oss://oss-cn-beijing-internal.aliyuncs.com/***/'
TBLPROPERTIES (
-- ファイル拡張子を自動的に生成します。
    'odps.external.data.enable.extension'='true')
;

-- 外部テーブルにデータを書き込みます。
INSERT INTO <mc_oss_extable_name> VALUES (1,32,76,1,63.32106,-92.08174,'9/14/2014 0:10','NW');
OSS に書き込まれるファイルのファイル拡張子を
jsonlにカスタマイズするには、DDL は以下のとおりです。CREATE EXTERNAL TABLE <mc_oss_extable_name> ( vehicleId INT, recordId INT, patientId INT, calls INT, locationLatitute DOUBLE, locationLongitude DOUBLE, recordTime STRING, direction STRING ) ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe' WITH serdeproperties ( 'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole' ) STORED AS textfile LOCATION 'oss://oss-cn-beijing-internal.aliyuncs.com/***/' TBLPROPERTIES ( -- カスタムファイル拡張子を追加します。 'odps.external.data.output.explicit.extension'='jsonl') ; -- 外部テーブルにデータを書き込みます。 INSERT INTO <mc_oss_extable_name> VALUES (1,32,76,1,63.32106,-92.08174,'9/14/2014 0:10','NW');生成されたファイル名は
20250905072538695g3mlopvxicr4_M1_1_0_0-0_TableSink1.jsonlで、カスタムファイル拡張子は.jsonlです。OSS に書き込まれるファイルの場合、プレフィックスを
mc_に、サフィックスを_beijingに、ファイル拡張子をjsonlに設定します。 DDL は次のとおりです。CREATE EXTERNAL TABLE <mc_oss_extable_name> ( vehicleId INT, recordId INT, patientId INT, calls INT, locationLatitute DOUBLE, locationLongitude DOUBLE, recordTime STRING, direction STRING ) ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe' WITH serdeproperties ( 'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole' ) STORED AS textfile LOCATION 'oss://oss-cn-beijing-internal.aliyuncs.com/***/' TBLPROPERTIES ( -- カスタムプレフィックスを追加します。 'odps.external.data.output.prefix'='mc_', -- カスタムサフィックスを追加します。 'odps.external.data.output.suffix'='_beijing', -- カスタムファイル拡張子を追加します。 'odps.external.data.output.explicit.extension'='jsonl') ; -- 外部テーブルにデータを書き込みます。 INSERT INTO <mc_oss_extable_name> VALUES (1,32,76,1,63.32106,-92.08174,'9/14/2014 0:10','NW');生成されるファイル名
mc_20250905073013526gra1l214x6t6_M1_1_0_0-0_TableSink1_beijing.jsonlにおいて、20250905073013526はシステム生成のタイムスタンプ、中央部分はタスク識別子です。
動的パーティションを使用した大きなファイルの書き込み
ビジネスシナリオ
先祖テーブルから計算結果をパーティションとして OSS にエクスポートし、large ファイル (例: 4 GB) として書き込みます。動的パーティションで odps.adaptive.shuffle.desired.partition.size パラメーター (単位: MB) を設定します。
利点:パラメーター値を設定することで、目的の出力ファイルサイズを制御できます。
欠点:大きなファイルを書き込むと並列度が低下し、実行時間が増加するため、全体の実行時間が長くなります。
メトリクスの説明
-- service.mode をオフにする必要があります。
SET odps.service.mode=off;

-- 動的パーティション機能を有効にする必要があります。
SET odps.sql.reshuffle.dynamicpt=true;

-- 各 reducer の目的のデータ消費量を設定します。各ファイルを 4 GB にすると仮定します。
SET odps.adaptive.shuffle.desired.partition.size=4096;
例
約 4 GB の JSON ファイルを OSS に書き込みます。
テストデータを準備します。約 30 GB のパブリックデータセットのテーブル
bigdata_public_dataset.tpcds_1t.web_salesを使用します。データは MaxCompute 上で圧縮フォーマットで保存されているため、エクスポート後にサイズが増加します。JSON 外部テーブルを作成します。
-- サンプルテーブル名:json_ext_web_sales
CREATE EXTERNAL TABLE  json_ext_web_sales(
    c_int INT ,
    c_string STRING
)
PARTITIONED BY (pt STRING)
ROW FORMAT SERDE 'org.apache.hive.hcatalog.data.JsonSerDe'
WITH serdeproperties (
  'odps.properties.rolearn'='acs:ram::<uid>:role/aliyunodpsdefaultrole'
)
STORED AS textfile
LOCATION 'oss://oss-cn-hangzhou-internal.aliyuncs.com/oss-mc-test/demo-test/';
パラメーターを設定せずに、テストテーブルを動的パーティション形式で JSON 外部テーブルに書き込みます。
-- service.mode をオフにする必要があります。
set odps.service.mode=off;

-- レイヤー 3 構文スイッチを有効にします。
SET odps.namespace.schema=true;

-- 動的パーティション形式で JSON 外部テーブルに書き込みます。
INSERT OVERWRITE json_ext_web_sales
PARTITION(pt)
SELECT CAST(ws_item_sk AS INT) AS c_int,
       CAST(ws_bill_customer_sk AS string) AS c_string ,
      COALESCE(CONCAT(ws_bill_addr_sk %2, '_', ws_promo_sk %3),'null_pt') AS pt
FROM  bigdata_public_dataset.tpcds_1t.web_sales;
OSS には 2 つのファイルが保存され、サイズはそれぞれ 2.112 GB と 2.102 GB です。
大容量ファイルの出力用にパラメーター
odps.adaptive.shuffle.desired.partition.sizeを追加し、テストテーブルを動的パーティションフォーマットで JSON 外部テーブルに書き込みます。-- service.mode をオフにする必要があります。 SET odps.service.mode=off; -- レイヤー 3 構文スイッチを有効にします。 SET odps.namespace.schema=true; -- 動的パーティション機能を有効にする必要があります。 SET odps.sql.reshuffle.dynamicpt=true; -- 各 reducer の目的のデータ消費量を設定します。各ファイルを 4 GB にすると仮定します。 SET odps.adaptive.shuffle.desired.partition.size=4096; -- 動的パーティション形式で JSON 外部テーブルに書き込みます。 INSERT OVERWRITE json_ext_web_sales PARTITION(pt) SELECT CAST(ws_item_sk AS INT) AS c_int, CAST(ws_bill_customer_sk AS string) AS c_string , COALESCE(CONCAT(ws_bill_addr_sk %2, '_', ws_promo_sk %3),'null_pt') AS pt FROM bigdata_public_dataset.tpcds_1t.web_sales;生成された単一のデータファイルのサイズは、約 4.214 GB です。
OSS 外部テーブルでのパーティション操作
OSS 外部テーブルはパーティション操作をサポートしています。OSS 外部テーブルでのパーティション操作は、内部テーブルでのパーティション操作と同様です。サポートされている操作を次の表に示します。
操作 | サポート状況 |
パーティションの追加 | |
パーティション更新時間の変更 | |
パーティション値の変更 | |
パーティションのマージ | |
パーティションのリスト表示 | |
パーティション情報の表示 | |
パーティションの削除 | |
パーティションの切り捨て |
OSS へのインポートとエクスポート
LOAD コマンド:OSS などの外部ストレージから、MaxCompute のテーブルまたはパーティションにデータをインポートします。
UNLOAD コマンド:他のコンピュートエンジンで使用するために、MaxCompute プロジェクトから OSS などの外部ストレージにデータをエクスポートします。
付録:サンプルデータの準備
OSS ディレクトリの準備
提供されるサンプルデータの情報は次のとおりです:
oss_endpoint:
oss-cn-hangzhou-internal.aliyuncs.com(中国 (杭州))。バケット名:
oss-mc-test。ディレクトリ名:
Demo1/、Demo2/、Demo3/、SampleData/。
非パーティション化テーブルのデータ
Demo1/ディレクトリにアップロードされるファイルは vehicle.csv で、次のデータが含まれています。Demo1/ディレクトリは、組み込みのテキストデータパーサで作成された非パーティション化テーブルにマッピングするために使用されます。1,1,51,1,46.81006,-92.08174,9/14/2014 0:00,S 1,2,13,1,46.81006,-92.08174,9/14/2014 0:00,NE 1,3,48,1,46.81006,-92.08174,9/14/2014 0:00,NE 1,4,30,1,46.81006,-92.08174,9/14/2014 0:00,W 1,5,47,1,46.81006,-92.08174,9/14/2014 0:00,S 1,6,9,1,46.81006,-92.08174,9/15/2014 0:00,S 1,7,53,1,46.81006,-92.08174,9/15/2014 0:00,N 1,8,63,1,46.81006,-92.08174,9/15/2014 0:00,SW 1,9,4,1,46.81006,-92.08174,9/15/2014 0:00,NE 1,10,31,1,46.81006,-92.08174,9/15/2014 0:00,Nパーティションテーブルのデータ
Demo2/ディレクトリには、direction=N/、direction=NE/、direction=S/、direction=SW/、direction=W/の 5 つのサブディレクトリが含まれています。アップロードされるファイルは、それぞれ vehicle1.csv、vehicle2.csv、vehicle3.csv、vehicle4.csv、vehicle5.csv です。これらのファイルには次のデータが含まれています。Demo2/ディレクトリは、組み込みのテキストデータパーサで作成されたパーティションテーブルにマッピングするために使用されます。--vehicle1.csv 1,7,53,1,46.81006,-92.08174,9/15/2014 0:00 1,10,31,1,46.81006,-92.08174,9/15/2014 0:00 --vehicle2.csv 1,2,13,1,46.81006,-92.08174,9/14/2014 0:00 1,3,48,1,46.81006,-92.08174,9/14/2014 0:00 1,9,4,1,46.81006,-92.08174,9/15/2014 0:00 --vehicle3.csv 1,6,9,1,46.81006,-92.08174,9/15/2014 0:00 1,5,47,1,46.81006,-92.08174,9/14/2014 0:00 1,6,9,1,46.81006,-92.08174,9/15/2014 0:00 --vehicle4.csv 1,8,63,1,46.81006,-92.08174,9/15/2014 0:00 --vehicle5.csv 1,4,30,1,46.81006,-92.08174,9/14/2014 0:00圧縮データ
Demo3/ディレクトリにアップロードされるファイルは vehicle.csv.gz です。圧縮パッケージ内のファイルは vehicle.csv で、Demo1/ディレクトリ内のファイルと同じ内容です。これは、圧縮プロパティを持つ OSS 外部テーブルにマッピングするために使用されます。カスタムパーサのデータ
SampleData/ディレクトリにアップロードされるファイルは vehicle6.csv で、次のデータが含まれています。SampleData/ディレクトリは、オープンソースのデータパーサで作成された OSS 外部テーブルにマッピングするために使用されます。1|1|51|1|46.81006|-92.08174|9/14/2014 0:00|S 1|2|13|1|46.81006|-92.08174|9/14/2014 0:00|NE 1|3|48|1|46.81006|-92.08174|9/14/2014 0:00|NE 1|4|30|1|46.81006|-92.08174|9/14/2014 0:00|W 1|5|47|1|46.81006|-92.08174|9/14/2014 0:00|S 1|6|9|1|46.81006|-92.08174|9/14/2014 0:00|S 1|7|53|1|46.81006|-92.08174|9/14/2014 0:00|N 1|8|63|1|46.81006|-92.08174|9/14/2014 0:00|SW 1|9|4|1|46.81006|-92.08174|9/14/2014 0:00|NE 1|10|31|1|46.81006|-92.08174|9/14/2014 0:00|N
OSS 外部テーブルに関するよくある質問
外部テーブルを使用して OSS データを処理する際に発生する「Inline data exceeds the maximum allowed size」エラーの解決方法
問題
OSS データを処理する際に、エラー
Inline data exceeds the maximum allowed sizeが報告されます。原因
OSS Store には、各小容量ファイルのサイズに制限があります。ファイルが 3 GB を超えるとエラーが報告されます。
解決策
以下の 2 つのプロパティを調整して、各レデューサーが外部テーブルに書き込むデータサイズを制御し、ファイルが 3 GB の制限内に収まるようにします。
set odps.sql.mapper.split.size=256; # 各マッパーが読み取るデータサイズを調整します (単位: MB)。
set odps.stage.reducer.num=100; # Reduce ステージのワーカー数を調整します。
ローカルテストに合格した UDF をアップロードして MaxCompute の OSS 外部テーブルにアクセスした後にメモリオーバーフローエラーが発生する場合の解決方法
問題
MaxCompute の OSS 外部テーブルにアクセスする際、ローカルテストに合格した UDF (ユーザー定義関数) をアップロードした後に、以下のエラーが返されます。
FAILED: ODPS-0123131:User defined function exception - Traceback:
java.lang.OutOfMemoryError: Java heap space
以下のパラメーターを設定すると、実行時間は長くなりますが、エラーは解消されません。
set odps.stage.mapper.mem = 2048;
set odps.stage.mapper.jvm.mem = 4096;
原因
外部テーブルにオブジェクトファイルが多すぎること、およびパーティションが設定されていないことが原因で、過剰なメモリ使用量が発生しています。
解決策
クエリにはより少量のデータを使用します。
オブジェクトファイルをパーティション分割して、メモリ使用量を削減します。
OSS 外部テーブルを使用して複数の小容量ファイルを 1 つのファイルにマージする方法
Logview ログを確認し、SQL 実行計画の最終ステージがレデューサーかジョイナーかを確認します。
レデューサーの場合は、文
set odps.stage.reducer.num=1;を実行します。ジョイナーの場合は、文
set odps.stage.joiner.num=1;を実行します。
OSS 外部テーブルからの読み取り時に発生する「Couldn't connect to server」エラーの解決方法
問題
OSS 外部テーブルからデータを読み取る際に、エラー
ODPS-0123131:User defined function exception - common/io/oss/oss_client.cpp(95): OSSRequestException: req_id: , http status code: -998, error code: HttpIoError, message: Couldn't connect to serverが報告されます。原因
原因 1:OSS 外部テーブルの作成時に、oss_location アドレスの
oss_endpointに内部エンドポイントではなく、パブリックエンドポイントが使用された。原因 2:OSS 外部テーブルの作成時に、oss_location アドレスの
oss_endpointに別のリージョンのエンドポイントが使用された。
解決策
原因 1 の場合
oss_location の
oss_endpointが内部エンドポイントであることを確認します。パブリックエンドポイントの場合は、内部エンドポイントに変更してください。詳細については、「パラメーター」をご参照ください。たとえば、インドネシア (ジャカルタ) リージョンのユーザーがアドレス
oss://oss-ap-southeast-5.aliyuncs.com/<bucket>/....を使用して外部テーブルを作成した場合、対応する内部アドレスoss://oss-ap-southeast-5-internal.aliyuncs.com/<bucket>/....に変更する必要があります。原因 2 の場合
oss_location の
oss_endpointがアクセスしたいリージョンと一致していることを確認します。OSS クラシックネットワークのドメイン名の一覧については、「リージョンとエンドポイント」をご参照ください。
OSS 外部テーブルの作成時に発生する「Network is unreachable (connect failed)」エラーの解決方法
問題
OSS 外部テーブルを作成する際に、エラー
ODPS-0130071:[1,1] Semantic analysis exception - external table checking failure, error message: Cannot connect to the endpoint 'oss-cn-beijing.aliyuncs.com': Connect to bucket.oss-cn-beijing.aliyuncs.com:80 [bucket.oss-cn-beijing.aliyuncs.com] failed: Network is unreachable (connect failed)が報告されます。原因
OSS 外部テーブルの作成時に、oss_location アドレスの
oss_endpointに内部エンドポイントではなく、パブリックエンドポイントが使用された。解決策
oss_location の
oss_endpointが内部エンドポイントであることを確認します。パブリックエンドポイントの場合は、内部エンドポイントに変更してください。詳細については、「パラメーター」をご参照ください。たとえば、中国 (北京) リージョンのユーザーがアドレス
oss://oss-cn-beijing.aliyuncs.com/<bucket>/....を使用して外部テーブルを作成した場合、対応する内部アドレスoss://oss-cn-beijing-internal.aliyuncs.com/<bucket>/....に変更する必要があります。
OSS 外部テーブルでの SQL ジョブ実行が遅い場合の解決方法
OSS 外部テーブル内の GZ 圧縮ファイルの読み取りが遅い
症状
ユーザーが OSS 内の 200 GB の GZ 圧縮ファイルをデータソースとして OSS 外部テーブルを作成しました。データの読み取りプロセスが遅いです。
原因
マップステージで計算を実行するマッパーが少なすぎるため、SQL の処理速度が遅くなっています。
解決策
構造化データの場合、以下のパラメーターを設定して、単一のマッパーが読み取るデータ量を調整し、SQL の実行を高速化できます。
set odps.sql.mapper.split.size=256; # 各マッパーが読み取るテーブルデータサイズを調整します (単位: MB)。非構造化データの場合、OSS 外部テーブルのパスに OSS ファイルが 1 つしかないかどうかを確認します。圧縮フォーマットの非構造化データは分割できないため、ファイルが 1 つしかない場合はマッパーも 1 つしか生成されません。これにより、処理速度が低下します。大規模な OSS ファイルを、OSS 上の対応する外部テーブルパス内でより小さなファイルに分割することを推奨します。これにより、外部テーブルの読み取り時に生成されるマッパーの数が増え、読み取り速度が向上します。
SDK を使用した MaxCompute 外部テーブルデータの検索が遅い
症状
SDK を使用して MaxCompute 外部テーブルデータを検索すると遅くなります。
解決策
外部テーブルは全表スキャンのみをサポートしており、これは低速です。代わりに MaxCompute 内部テーブルを使用してください。
OSS のマルチパートアップロード機能を使用する際に、古いデータは削除されるが新しいデータが書き込まれない問題の解決方法
問題
insert overwriteシナリオにおいて、極端なケースでジョブが失敗した場合、結果が期待通りにならないことがあります。古いデータは削除されますが、新しいデータは書き込まれません。原因
ハードウェアの障害やメタデータ更新の失敗といった、非常に低い確率で発生する事象により、新しく書き込まれるデータがターゲットテーブルに書き込まれないことがあります。OSS での削除操作はロールバックをサポートしていないため、削除された古いデータを回復することはできません。
解決策
古いデータに基づいて OSS 外部テーブルを上書きする場合、たとえば
insert overwrite table T select * from table T;のような操作を行う場合は、事前に OSS データをバックアップしてください。ジョブが失敗した場合、バックアップした古いデータに基づいて OSS 外部テーブルを上書きできます。insert overwriteジョブが再送信可能な場合は、ジョブが失敗した際に単純に再送信してください。
Spark から OSS 外部テーブルにアクセスする際に発生する「table not found」エラーの解決策
問題
Spark を使用して OSS 外部テーブルにアクセスすると、タスクが「table not found」エラーで失敗します。
解決策
以下のパラメーターを追加します:
外部テーブル構成を有効にする:
spark.sql.catalog.odps.enableExternalTable=true;OSS が配置されているリージョンを構成する:
spark.hadoop.odps.oss.region.default=cn-<region>
上記のパラメーターを追加してもエラーが解消されない場合:
at java.lang.Thread.run(Thread.java:745)
Caused by: java.lang.Exception: com.aliyun.odps.cupid.CupidException: connectionId and rolearn are mutually exclusive
    at com.aliyun.odps.cupid.table.v1.commontable.impl.reader.CupidCommonTableReadSession.splitTable
OSS 外部テーブルを再作成してから、再度アクセスしてください。
参考資料
サポートされている OSS 外部テーブルのフォーマット:
カスタムパーサーを使用して OSS 外部テーブルを作成し、OSS への読み書きを行う: カスタムパーサー。
列のフィルタリングと処理をサポートするスキーマを持つデータセットに OSS ファイルを解析する: 特別機能: スキーマレスクエリ。