このトピックでは、Hologres でクラスタリングキーを使用してデータをソートし、クエリを高速化する方法について説明します。
概要
Hologres は、クラスタリングキーに基づいてファイル内のデータをソートします。これにより、インデックス付けされた列に対する範囲クエリとフィルタークエリを高速化できます。次の構文を使用してテーブルを作成するときに、クラスタリングキーを指定する必要があります。
-- Hologres V2.1 以降でサポートされる構文
CREATE TABLE <table_name> (...) WITH (clustering_key = '[<columnName>[,...]]');
-- すべてのバージョンでサポートされる構文
BEGIN;
CREATE TABLE <table_name> (...);
CALL set_table_property('<table_name>', 'clustering_key', '[<columnName>{:asc} [,...]]');
COMMIT;
パラメーター:
|
パラメーター |
説明 |
|
table_name |
クラスタリングキーを指定するテーブルの名前。 |
|
columnName |
クラスタリングキーとして指定する列の名前。 |
使用上の推奨事項
-
クラスタリングキーは、ポイントクエリと範囲クエリに最適です。
WHERE a = 1やWHERE a > 1 AND a < 5のようなフィルター操作のパフォーマンスを大幅に向上させます。ポイントクエリのパフォーマンスを最適化するために、同じ列にクラスタリングキーとビットマップインデックスの両方を定義できます。 -
クラスタリングキーは最左一致の原則に従います。そのため、幅広いクエリに適用できるよう、クラスタリングキーに含める列は 2 つ以下にすることを推奨します。列の順序は重要です。先に指定した列は、後に指定した列よりもソート優先度が高くなります。
-
クラスタリングキーの列を指定する際、列名の後に
:ascを追加して、インデックスのソート順を指定できます。デフォルトのソート順はasc(昇順) です。Hologres V2.1 より前のバージョンでは、ソート順を降順 (desc) に設定することはサポートされていませんでした。これらのバージョンでは、ソート順が降順に設定されていると、クラスタリングキーがヒットせず、クエリのパフォーマンスが低下する可能性がありました。V2.1 からは、特定の GUC パラメーターを有効にした後、クラスタリングキーをdescに設定できます。ただし、この機能は Text、Char、Varchar、Bytea、Int などのデータ型のフィールドでのみサポートされています。他のデータ型のフィールドでは、クラスタリングキーをdescに設定することはまだサポートされていません。set hg_experimental_optimizer_enable_variable_length_desc_ck_filter = on; -
行指向テーブルの場合、クラスタリングキーはデフォルトでプライマリキーになります。Hologres V0.9 より前のバージョンでは、デフォルトでクラスタリングキーは設定されませんでした。プライマリキーとは異なるクラスタリングキーを定義すると、Hologres はソートされたデータのコピーを 2 つ作成します。1 つはプライマリキー用、もう 1 つはクラスタリングキー用です。これにより、データが冗長になります。
制限事項
-
クラスタリングキーを変更するには、新しいテーブルを作成してデータをインポートする必要があります。
-
クラスタリングキーで指定された列は
NOT NULLである必要があります。Hologres V1.3.20 から V1.3.27 までのバージョンでは、クラスタリングキーでNULL値を許容する列がサポートされていましたが、V1.3.28 からはサポートされなくなりました。NULL値を許容するクラスタリングキーは、データの正確性に影響を与える可能性があります。ビジネス要件でNULL値を許容するクラスタリングキーが必要な場合は、SQLステートメントの前に次のコマンドを実行して有効にできます。set hg_experimental_enable_nullable_clustering_key = true; -
次のデータ型の列は、クラスタリングキーでは使用できません:Float、Float4、Float8、Double、Decimal (Numeric)、Json、Jsonb、Bit、Varbit、Money、Time With Time Zone、またはその他の複雑なデータ型。
-
Hologres V2.1 より前のバージョンでは、インデックスのソート順を降順 (
desc) に設定することはできません。ソート順が降順に設定されていると、クラスタリングキーがヒットせず、クエリのパフォーマンスが低下する可能性があります。V2.1 からは、次の GUC を有効にすることで、クラスタリングキーをdescに設定できます。ただし、この機能は Text、Char、Varchar、Bytea、Int などのデータ型のフィールドでのみサポートされています。他のデータ型のフィールドでは、クラスタリングキーをdescに設定することはできません。set hg_experimental_optimizer_enable_variable_length_desc_ck_filter = on; -
列指向テーブルの場合、デフォルトではクラスタリングキーは定義されません。ユースケースに基づいて明示的に指定する必要があります。
-
Hologres では、各テーブルに設定できるクラスタリングキーは 1 つだけです。つまり、テーブルを作成するときに、
callコマンドは複数回ではなく、1 回だけ実行できます。例:-
Hologres V2.1 以降でサポートされる構文:
-- 正しい使用方法 CREATE TABLE tbl ( a int NOT NULL, b text NOT NULL ) WITH ( clustering_key = 'a,b' ); -- 誤った使用方法 CREATE TABLE tbl ( a int NOT NULL, b text NOT NULL ) WITH ( clustering_key = 'a', clustering_key = 'b' ); -
すべてのバージョンでサポートされる構文:
-- 正しい使用方法
BEGIN;
CREATE TABLE tbl (a int NOT NULL, b text NOT NULL);
CALL set_table_property('tbl', 'clustering_key', 'a,b');
COMMIT;
-- 誤った使用方法
BEGIN;
CREATE TABLE tbl (a int NOT NULL, b text NOT NULL);
CALL set_table_property('tbl', 'clustering_key', 'a');
CALL set_table_property('tbl', 'clustering_key', 'b');
COMMIT;
-
仕組み
クラスタリングキーは、ファイル内のデータを物理的にソートします。デフォルトでは、データは昇順 (asc) でソートされます。以下のセクションでは、クラスタリングキーの論理レイアウトと物理ストレージレイアウトの概念について説明します。
-
論理レイアウト
クラスタリングキーを使用するクエリは、最左一致の原則に従います。クエリのフィルター条件がクラスタリングキー列のプレフィックスと一致しない場合、クラスタリングキーはクエリを高速化できません。次の例は、Hologres におけるクラスタリングキーの論理レイアウトを示しています。
Name、Date、Classの列を持つテーブルがあるとします。
-
クラスタリングキーを (Date) に設定すると、テーブル内のデータは Date 列でソートされます。
-
クラスタリングキーを (Class, Date) に設定すると、データはまず Class 列でソートされ、次に各クラス内で Date 列でソートされます。
クラスタリングキー列の選択によって、データの最終的なソートされたレイアウトが決まります。
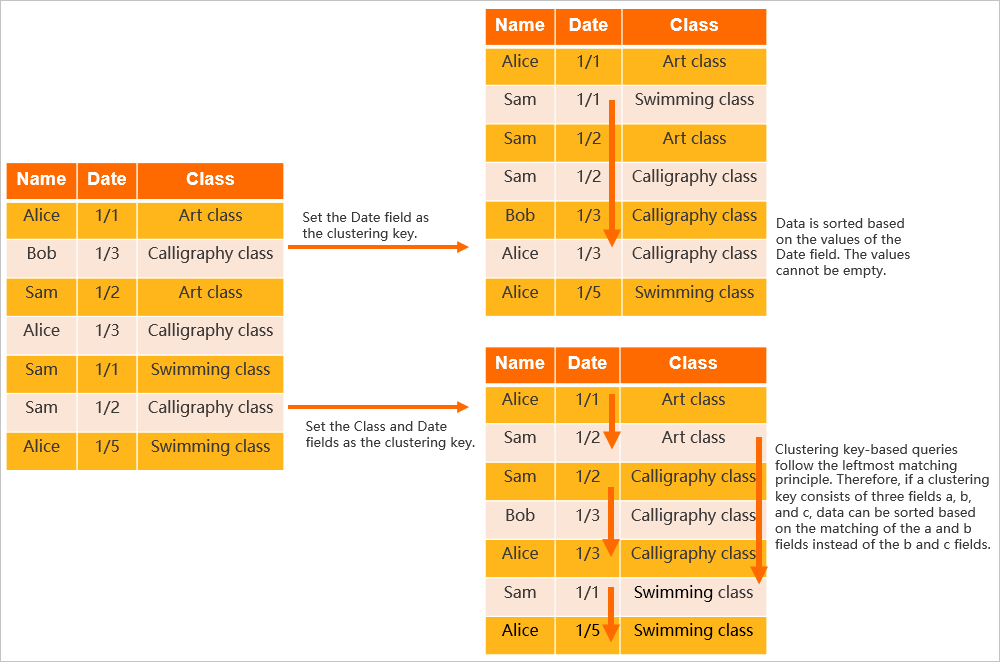
-
-
物理ストレージレイアウト
クラスタリングキーの物理ストレージレイアウトでは、関連データがまとめてグループ化されます。
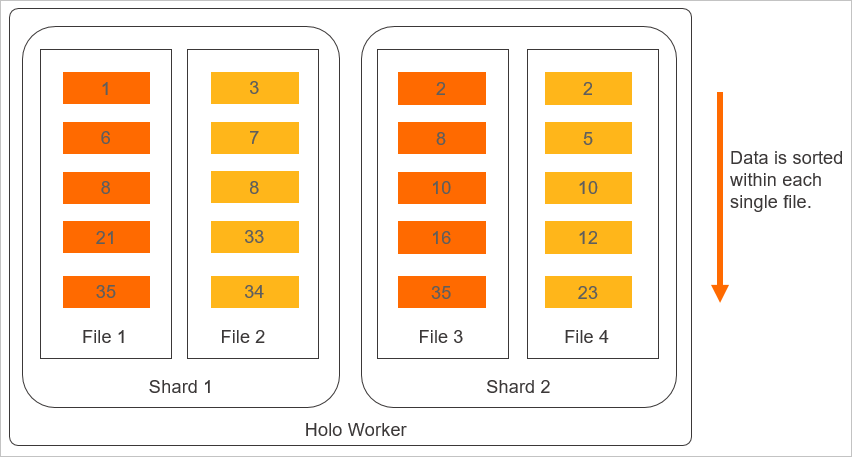
これらのレイアウトの原則には、次の意味合いがあります:
-
クラスタリングキーは、範囲フィルターに適しています。たとえば、
WHERE date = '1/1'やWHERE a > '1/1' AND a < '1/5'のような条件を持つクエリは、大幅に高速化されます。 -
クエリは最左一致の原則に従います。たとえば、クラスタリングキーが列 (
a,b,c) で定義されている場合、クエリが (a,b,c) または (a,b) でフィルタリングすると高速化できます。クエリが (a,c) でフィルタリングする場合、aの条件のみがクラスタリングキーを使用できます。クエリが (b,c) でフィルタリングする場合、クラスタリングキーをまったく使用できません。
次の例では、 uid,class,date 列がクラスタリングキーになります。
-
Hologres V2.1 以降でサポートされる構文:
CREATE TABLE clustering_test ( uid int NOT NULL, name text NOT NULL, class text NOT NULL, date text NOT NULL, PRIMARY KEY (uid) ) WITH ( clustering_key = 'uid,class,date' ); INSERT INTO clustering_test VALUES (1,'田中','1','2022-10-19'), (2,'鈴木','3','2022-10-19'), (3,'佐藤','2','2022-10-20'), (4,'伊藤','2','2022-10-20'), (5,'渡辺','2','2022-10-18'), (6,'山本','3','2022-10-17'), (7,'中村','3','2022-10-20'); -
すべてのバージョンでサポートされる構文:
BEGIN;
CREATE TABLE clustering_test (
  uid int NOT NULL,
  name text NOT NULL,
  class text NOT NULL,
  date text NOT NULL,
  PRIMARY KEY (uid)
);
CALL set_table_property('clustering_test', 'clustering_key', 'uid,class,date');
COMMIT;
INSERT INTO clustering_test VALUES
(1,'田中','1','2022-10-19'),
(2,'鈴木','3','2022-10-19'),
(3,'佐藤','2','2022-10-20'),
(4,'伊藤','2','2022-10-20'),
(5,'渡辺','2','2022-10-18'),
(6,'山本','3','2022-10-17'),
(7,'中村','3','2022-10-20');
-
uid列のみをクエリすると、クラスタリングキーがヒットします。SELECT * FROM clustering_test WHERE uid > '3';EXPLAIN ステートメントで実行計画を調べると、
Cluster Filter演算子が表示されます。これは、オプティマイザがクラスタリングキーを使用してクエリを高速化したことを示します。explain SELECT * FROM clustering_test WHERE uid > '3'; QUERY PLAN Gather (cost=0.00..1.10 rows=4 width=24) -> Exchange (Gather Exchange) (cost=0.00..1.10 rows=4 width=24) -> Decode (cost=0.00..1.10 rows=4 width=24) -> Index Scan using holo_index:[1] on clustering_test (cost=0.00..1.00 rows=4 width=24) Cluster Filter: (uid > 3) Optimizer: HQO version 1.3.0 -
uid,class列をクエリすると、クラスタリングキーがヒットします。SELECT * FROM clustering_test WHERE uid = '3' AND class >'1' ;実行計画には
Cluster Filter演算子が表示され、これはオプティマイザがクラスタリングキーを使用してクエリを高速化したことを示します。explain SELECT * FROM clustering_test WHERE uid = '3' AND class >'1' ; QUERY PLAN Exchange (Gather Exchange) (cost=0.00..1.10 rows=1 width=24) -> Decode (cost=0.00..1.10 rows=1 width=24) -> Index Scan using holo_index:[1] on clustering_test (cost=0.00..1.00 rows=1 width=24) Cluster Filter: ((uid = 3) AND (class > '1'::text)) Shard Selector(Eagerly): ->: l0 [3] Optimizer: HQO version 1.3.0 -
uid,class,date列をクエリすると、クラスタリングキーがヒットします。SELECT * FROM clustering_test WHERE uid = '3' AND class ='2' AND date > '2022-10-17';実行計画を調べると、
Cluster Filter演算子が表示されます。これは、クラスタリングキーがヒットし、クエリが高速化されたことを示します。実行計画の結果は、Index Scan using holo_index:[1] on clustering_testが使用され、Cluster Filter条件が((uid = 3) AND (class = '2'::text) AND (date > '2022-10-17'::text))であることを示しています。これにより、クラスタリングキーが正しく使用されたことが確認されます。 -
uid,date列のクエリは、最左一致の原則に従っていません。そのため、uidのみがクラスタリングキーにヒットし、dateは通常のフィルターを使用して処理されます。SELECT * FROM clustering_test WHERE uid = '3' AND date > '2022-10-17';実行計画 (EXPLAIN SQL) を見ると、以下の計画では、
uid列にのみCluster Filter演算子が適用されていることがわかります。explain SELECT * FROM clustering_test WHERE uid = '3' AND date > '2022-10-17'; QUERY PLAN Exchange (Gather Exchange) (cost=0.00..1.10 rows=1 width=24) -> Decode (cost=0.00..1.10 rows=1 width=24) -> Index Scan using holo_index:[1] on clustering_test (cost=0.00..1.00 rows=1 width=24) Filter: (date > '2022-10-17'::text) Cluster Filter: (uid = 3) Shard Selector(Eagerly): ->: I0 [3] Optimizer: HQO version 1.3.0 -
class,date列のみのクエリは、最左一致の原則に従っていません。クエリはクラスタリングキーを活用できません。SELECT * FROM clustering_test WHERE class ='2' AND date > '2022-10-17';実行計画 (
EXPLAIN SQLから) にCluster Filter演算子がないことは、クラスタリングキーが使用されなかったことを示します。EXPLAINを実行すると、クエリ計画にはIndex Scanが表示され、date列はFilterを使用し、class列はBitmap Filterを使用しますが、どちらもクラスタリングキーによって高速化されません。
例
例 1:クエリがクラスタリングキーにヒットするシナリオ。
-
Hologres V2.1 以降でサポートされる構文:
CREATE TABLE table1 ( col1 int NOT NULL, col2 text NOT NULL, col3 text NOT NULL, col4 text NOT NULL ) WITH ( clustering_key = 'col1,col2' ); -- 上記で作成したテーブルに対して、以下のクエリは高速化できます。 -- このクエリは高速化できます。 select * from table1 where col1=123; -- このクエリは高速化できます。 select * from table1 where col1>100 and col1<200; -- このクエリは高速化できます。 select * from table1 where col1 in (123, 456); -- このクエリは高速化できます。 select * from table1 where col1=123 and col2='def'; -- このクエリは高速化できません。 select col1,col4 from table1 where col2='def'; -
すべてのバージョンでサポートされる構文:
begin;
create table table1 (
  col1 int not null,
  col2 text not null,
  col3 text not null,
  col4 text not null
);
call set_table_property('table1', 'clustering_key', 'col1,col2');
commit;
-- 上記で作成したテーブルに対して、以下のクエリは高速化できます。
-- このクエリは高速化できます。
select * from table1 where col1=123;
-- このクエリは高速化できます。
select * from table1 where col1>100 and col1<200;
-- このクエリは高速化できます。
select * from table1 where col1 in (123, 456);
-- このクエリは高速化できます。
select * from table1 where col1=123 and col2='def';
-- このクエリは高速化できません。
select col1,col4 from table1 where col2='def';
例 2:クラスタリングキーが asc/desc に設定されている場合。
-
Hologres V2.1 以降でサポートされる構文:
CREATE TABLE tbl ( a int NOT NULL, b text NOT NULL ) WITH ( clustering_key = 'a:desc,b:asc' ); -
すべてのバージョンでサポートされる構文:
BEGIN;
CREATE TABLE tbl (
  a int NOT NULL,
  b text NOT NULL
);
CALL set_table_property('tbl', 'clustering_key', 'a:desc,b:asc');
COMMIT;
高度なチューニング
MySQL や SQL Server などの従来のデータベースのクラスタリングキーとは異なり、Hologres でのソートはファイル内でのみ実行され、テーブル全体にわたるものではありません。したがって、クラスタリングキーに対して ORDER BY 操作を実行すると、依然としてパフォーマンスコストが発生します。
V1.3 以降、Hologres はクラスタリングキーのユースケースに対して大幅なパフォーマンス最適化を導入しました。これらの最適化により、以下のシナリオでより優れたパフォーマンスが提供されます。お使いの Hologres インスタンスが V1.3 より前のバージョンの場合、「トラブルシューティング:アップグレード準備エラー」をご参照いただくか、「オンラインサポートの利用方法」の手順に従ってサポートにお問い合わせください。
-
クラスタリングキーでの ORDER BY の使用
Hologres では、ファイル内のデータは定義されたクラスタリングキーに従ってソートされます。V1.3 より前のバージョンでは、オプティマイザはクラスタリングキーのソート特性を使用して最適な実行計画を生成できませんでした。さらに、多方向マージのためにシャッフルノードを通過した後のデータ順序は保証されませんでした。これにより、計算負荷が高くなり、クエリ時間が長くなることがよくありました。Hologres V1.3 ではこのプロセスが最適化されています。オプティマイザは、クラスタリングキーのソート特性を使用し、シャッフル間でデータ順序を保持する実行計画を生成できるようになり、クエリのパフォーマンスが向上します。ただし、次の点にご注意ください:
-
クエリがテーブルのクラスタリングキーでフィルタリングしない場合、デフォルトで IndexScan の代わりにシーケンシャルスキャンが実行されます。IndexScan のみがクラスタリングキーのソート特性を使用します。
-
このアプローチにはいくつかのオーバーヘッドがあるため、オプティマイザは常にクラスタリングキーのソート順に依存する実行計画を選択するとは限りません。たとえば、ファイル内でソートされたデータでも、メモリ内で追加のソートが必要になる場合があります。
例:
-
Hologres V2.1 以降でサポートされる構文:
DROP TABLE IF EXISTS test_use_sort_info_of_clustering_keys;
CREATE TABLE test_use_sort_info_of_clustering_keys (
    a int NOT NULL,
    b int NOT NULL,
    c text
)
WITH (
    distribution_key = 'a',
    clustering_key = 'a,b'
);
INSERT INTO test_use_sort_info_of_clustering_keys SELECT i%500, i%100, i::text FROM generate_series(1, 1000) as s(i);
ANALYZE test_use_sort_info_of_clustering_keys;
すべてのバージョンでサポートされる構文:
DROP TABLE if exists test_use_sort_info_of_clustering_keys; BEGIN; CREATE TABLE test_use_sort_info_of_clustering_keys ( a int NOT NULL, b int NOT NULL, c text ); CALL set_table_property('test_use_sort_info_of_clustering_keys', 'distribution_key', 'a'); CALL set_table_property('test_use_sort_info_of_clustering_keys', 'clustering_key', 'a,b'); COMMIT; INSERT INTO test_use_sort_info_of_clustering_keys SELECT i%500, i%100, i::text FROM generate_series(1, 1000) as s(i); ANALYZE test_use_sort_info_of_clustering_keys; -
クエリステートメント:
explain select * from test_use_sort_info_of_clustering_keys where a > 100 order by a, b; -
実行計画の比較
-
次のコードは、V1.1 など V1.3 より前のバージョンでの実行計画を示しています。
EXPLAINステートメントを実行することで計画を表示できます。Sort (cost=0.00..0.00 rows=797 width=11) -> Gather (cost=0.00..2.48 rows=797 width=11) Sort Key: a, b -> Sort (cost=0.00..2.44 rows=797 width=11) Sort Key: a, b -> Exchange (Gather Exchange) (cost=0.00..1.11 rows=797 width=11) -> Decode (cost=0.00..1.11 rows=797 width=11) -> Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys (cost=0.00..1.00 rows=797 width=11) Cluster Filter: (a > 100) -
次のコードは、Hologres V1.3 での実行計画を示しています。
 Gather  (cost=0.00..1.15 rows=797 width=11)
   Merge Key: a, b
   ->  Exchange (Gather Exchange)  (cost=0.00..1.11 rows=797 width=11)
         Merge Key: a, b
         ->  Decode  (cost=0.00..1.11 rows=797 width=11)
               ->  Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys  (cost=0.00..1.01 rows=797 width=11)
                     Order by: a, b
                     Cluster Filter: (a > 100)
V1.3 の実行計画はより効率的です。クラスタリングキーのソート特性を使用して出力を直接マージします。これにより、パイプライン化された実行が作成され、大規模なデータセットを扱う際の遅いソート操作を防ぎます。比較で示されているように、V1.3 の計画では
Sort演算子がMerge Keyに置き換えられており、これはより効率的なマージベースのプロセスを示しています。 -
-
-
クラスタリングキーでの JOIN の使用 (ベータ版)
Hologres V1.3 では
マージ結合演算子が導入され、オプティマイザがクラスタリングキーのソート特性を活用して計算負荷を軽減し、パフォーマンスを向上させることができます。ただし、次の点にご注意ください:-
この機能はベータ版であり、デフォルトでは無効になっています。使用するには、クエリを実行する前に次のパラメーターを有効にする必要があります。
-- マージ結合を有効にする set hg_experimental_enable_sort_merge_join=on; -
クエリがテーブルのクラスタリングキーでフィルタリングしない場合、デフォルトで IndexScan の代わりにシーケンシャルスキャンが実行されます。IndexScan のみがクラスタリングキーのソート特性を使用します。
-
この特性の使用にはいくつかのコストがかかるため、オプティマイザは常にクラスタリングキーのソート順に基づいて実行計画を生成するとは限りません。たとえば、ファイル内でソートされたデータでも、メモリ内で追加のソートが必要になる場合があります。
例:
-
Hologres V2.1 以降でサポートされる構文:
DROP TABLE IF EXISTS test_use_sort_info_of_clustering_keys1;
CREATE TABLE test_use_sort_info_of_clustering_keys1 (
    a int NOT NULL,
    b int NOT NULL,
    c text
)
WITH (
    distribution_key = 'a',
    clustering_key = 'a,b'
);
INSERT INTO test_use_sort_info_of_clustering_keys1 SELECT i % 500, i % 100, i::text FROM generate_series(1, 10000) AS s(i);
ANALYZE test_use_sort_info_of_clustering_keys1;
DROP TABLE IF EXISTS test_use_sort_info_of_clustering_keys2;
CREATE TABLE test_use_sort_info_of_clustering_keys2 (
    a int NOT NULL,
    b int NOT NULL,
    c text
)
WITH (
    distribution_key = 'a',
    clustering_key = 'a,b'
);
INSERT INTO test_use_sort_info_of_clustering_keys2 SELECT i % 600, i % 200, i::text FROM generate_series(1, 10000) AS s(i);
ANALYZE test_use_sort_info_of_clustering_keys2;
すべてのバージョンでサポートされる構文:
drop table if exists test_use_sort_info_of_clustering_keys1; begin; create table test_use_sort_info_of_clustering_keys1 ( a int NOT NULL, b int NOT NULL, c text ); call set_table_property('test_use_sort_info_of_clustering_keys1', 'distribution_key', 'a'); call set_table_property('test_use_sort_info_of_clustering_keys1', 'clustering_key', 'a,b'); commit; insert into test_use_sort_info_of_clustering_keys1 select i%500, i%100, i::text from generate_series(1, 10000) as s(i); analyze test_use_sort_info_of_clustering_keys1; drop table if exists test_use_sort_info_of_clustering_keys2; begin; create table test_use_sort_info_of_clustering_keys2 ( a int NOT NULL, b int NOT NULL, c text ); call set_table_property('test_use_sort_info_of_clustering_keys2', 'distribution_key', 'a'); call set_table_property('test_use_sort_info_of_clustering_keys2', 'clustering_key', 'a,b'); commit; insert into test_use_sort_info_of_clustering_keys2 select i%600, i%200, i::text from generate_series(1, 10000) as s(i); analyze test_use_sort_info_of_clustering_keys2; -
クエリステートメント:
explain select * from test_use_sort_info_of_clustering_keys1 a join test_use_sort_info_of_clustering_keys2 b on a.a = b.a and a.b=b.b where a.a > 100 and b.a < 300; -
実行計画の比較
-
次のコードは、V1.1 など V1.3 より前のバージョンでの実行計画を示しています。
Gather (cost=0.00..3.09 rows=4762 width=24) -> Hash Join (cost=0.00..2.67 rows=4762 width=24) Hash Cond: ((test_use_sort_info_of_clustering_keys1.a = test_use_sort_info_of_clustering_keys2.a) AND (test_use_sort_info_of_clustering_keys1.b = test_use_sort_info_of_clustering_keys2.b)) -> Exchange (Gather Exchange) (cost=0.00..1.14 rows=3993 width=12) -> Decode (cost=0.00..1.14 rows=3993 width=12) -> Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys1 (cost=0.00..1.01 rows=3993 width=12) Cluster Filter: ((a > 100) AND (a < 300)) -> Hash (cost=1.13..1.13 rows=3386 width=12) -> Exchange (Gather Exchange) (cost=0.00..1.13 rows=3386 width=12) -> Decode (cost=0.00..1.13 rows=3386 width=12) -> Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys2 (cost=0.00..1.01 rows=3386 width=12) Cluster Filter: ((a > 100) AND (a < 300)) -
次のコードは、Hologres V1.3 での実行計画を示しています。
  Gather  (cost=0.00..2.88 rows=4762 width=24)
   ->  Merge Join  (cost=0.00..2.46 rows=4762 width=24)
         Merge Cond: ((test_use_sort_info_of_clustering_keys2.a = test_use_sort_info_of_clustering_keys1.a) AND (test_use_sort_info_of_clustering_keys2.b = test_use_sort_info_of_clustering_keys1.b))
         ->  Exchange (Gather Exchange)  (cost=0.00..1.14 rows=3386 width=12)
               Merge Key: test_use_sort_info_of_clustering_keys2.a, test_use_sort_info_of_clustering_keys2.b
               ->  Decode  (cost=0.00..1.14 rows=3386 width=12)
                     ->  Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys2  (cost=0.00..1.01 rows=3386 width=12)
                           Order by: test_use_sort_info_of_clustering_keys2.a, test_use_sort_info_of_clustering_keys2.b
                           Cluster Filter: ((a > 100) AND (a < 300))
         ->  Exchange (Gather Exchange)  (cost=0.00..1.14 rows=3993 width=12)
               Merge Key: test_use_sort_info_of_clustering_keys1.a, test_use_sort_info_of_clustering_keys1.b
               ->  Decode  (cost=0.00..1.14 rows=3993 width=12)
                     ->  Index Scan using holo_index:[1] on test_use_sort_info_of_clustering_keys1  (cost=0.00..1.01 rows=3993 width=12)
                           Order by: test_use_sort_info_of_clustering_keys1.a, test_use_sort_info_of_clustering_keys1.b
                           Cluster Filter: ((a > 100) AND (a < 300))
V1.3 の計画では、クラスタリングキーのソート特性を活用して
マージ結合を使用します。結合前に各シャード内でソートマージを実行し、効率的なパイプラインを構築します。このアプローチは、結合の片側がメモリに収まらないほど大きい場合にハッシュ結合で発生する可能性のあるメモリ不足 (OOM) エラーを回避します。 -
-
-
クラスタリングキーの逆順でソートする Top-N クエリの使用
Hologres V5.0.0 以降、GUC パラメーター
hg_enable_reverse_scan_for_clustering_keysを有効にすると、クラスタリングキーの逆方向でソートするORDER BY ... LIMIT Nクエリは逆順スキャンを使用できます。逆順スキャンは読み取るデータ量を減らし、Sort演算子を削除します。さらに、V5.0.0 以降、Hologres は、クエリがNULL値を許容するクラスタリングキー列のソート順を使用できるかどうかを判断する際に、NULLの順序を考慮します。詳細については、「クラスタリングキーを使用した Top-N クエリの高速化」をご参照ください。
関連ドキュメント
Hologres 内部テーブルのデータ定義言語 (DDL) ステートメントの詳細については、次のトピックをご参照ください: