ES-Hadoop は、Elasticsearch と Hadoop エコシステム間の双方向データ移動を可能にするオープンソースコネクタです。Hive などのサービスと Elasticsearch をシームレスに統合し、Elasticsearch の高速検索機能と Hadoop のバッチ処理能力を活用してインタラクティブなデータ分析を実現します。本トピックでは、ES-Hadoop を使用して Hive で Alibaba Cloud Elasticsearch (ES) からデータを読み書きする方法について説明します。これにより、Elasticsearch と Hadoop コンポーネントを組み合わせて、より柔軟なデータ分析を行うことができます。
背景情報
Hadoop エコシステムは大規模データセットの処理に優れていますが、インタラクティブなデータ分析では高いレイテンシが発生することがよくあります。一方、Elasticsearch はインタラクティブなデータ分析向けに設計されており、多くのクエリタイプ、特にアドホッククエリに対して数秒で結果を返すことができます。ES-Hadoop は両システムの強みを組み合わせます。わずかなコード変更で、ES-Hadoop を使用して Elasticsearch に保存されたデータを迅速に処理し、そのパフォーマンス向上の恩恵を受けることができます。
ES-Hadoop は、MapReduce、Spark、Hive などのデータ処理エンジンのデータソースとして Elasticsearch を使用することで機能します。コンピューティングとストレージの分離アーキテクチャでは、Elasticsearch がストレージレイヤーとして機能します。これは MapReduce、Spark、Hive が使用する他のデータソースと同様ですが、Elasticsearch は大幅に高速なデータ選択とフィルタリングを提供します。これは、あらゆる分析エンジンにとって重要な機能です。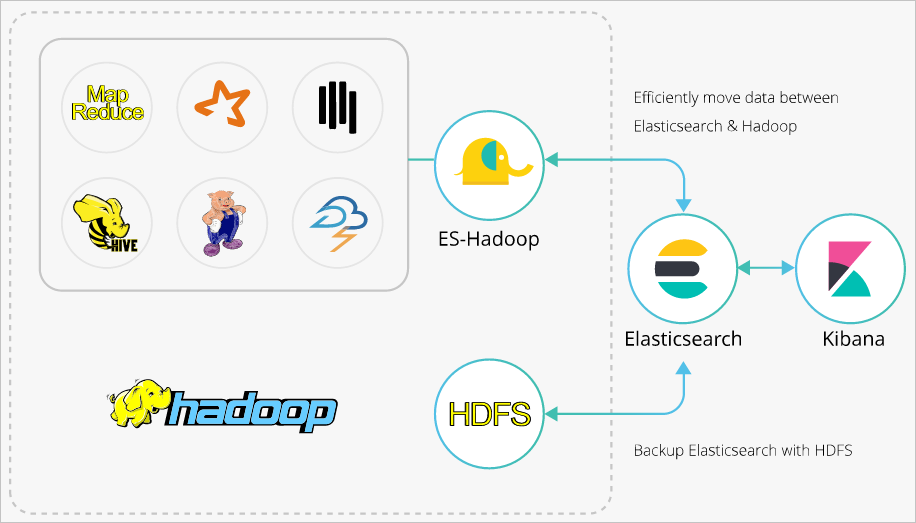
ES-Hadoop と Hive の高度な設定の詳細については、「Elasticsearch 公式ドキュメント」をご参照ください。
手順
-
同じ仮想プライベートクラウド (VPC) に ES クラスターと E-MapReduce (EMR) インスタンスを作成し、ES クラスターの自動インデックス作成機能を無効化してインデックスとマッピングを作成し、ES クラスターのバージョンと互換性のある ES-Hadoop インストールパッケージをダウンロードします。
-
ステップ 1: ES-Hadoop JAR を HDFS にアップロード
EMR マスターノード上の HDFS のディレクトリに ES-Hadoop JAR をアップロードします。
-
Hive 外部テーブルを作成し、そのフィールドを Elasticsearch インデックスのフィールドにマッピングします。
-
ステップ 3: Hive によるインデックスへのデータ書き込み
HiveSQL を使用して Elasticsearch インデックスにデータを書き込みます。
-
ステップ 4: Hive によるインデックスからのデータ読み取り
HiveSQL を使用して Elasticsearch インデックスからデータを読み取ります。
前提条件
-
ES クラスターを作成します。
本トピックでは、バージョン 6.7.0 のクラスターを使用します。詳細については、「ES クラスターの作成」をご参照ください。
-
クラスターの自動インデックス作成機能を無効化し、インデックスとマッピングを作成します。
自動インデックス作成が有効になっている場合、Elasticsearch が誤ったデータ型を推測する可能性があります。たとえば、
ageという名前のフィールドをINTとして定義しても、LONGとしてインデックス化される可能性があります。そのため、インデックスを手動で作成することを推奨します。本トピックで使用するインデックスとマッピングは次のとおりです。PUT company { "mappings": { "_doc": { "properties": { "id": { "type": "long" }, "name": { "type": "text", "fields": { "keyword": { "type": "keyword", "ignore_above": 256 } } }, "birth": { "type": "text" }, "addr": { "type": "text" } } } }, "settings": { "index": { "number_of_shards": "5", "number_of_replicas": "1" } } } -
ES クラスターと同じ仮想プライベートクラウド (VPC) に EMR クラスターを作成します。
重要ES クラスターのプライベート IP アドレスホワイトリストは、デフォルトで 0.0.0.0/0 に設定されています。この設定はセキュリティ設定ページで確認できます。このデフォルト設定を変更する場合は、EMR クラスターの内部 IP アドレスをホワイトリストに追加する必要があります。
-
EMR クラスターの内部 IP アドレスを取得するには、「クラスターリストと詳細の表示」をご参照ください。
-
ES クラスターの VPC プライベート IP アドレスホワイトリストを設定するには、「Elasticsearch クラスターのパブリックまたはプライベート IP アドレスホワイトリストの設定」をご参照ください。
-
ステップ 1: ES-Hadoop JAR を HDFS にアップロード
-
ES クラスターのバージョンに対応するES-Hadoop インストールパッケージをダウンロードします。
本トピックでは、elasticsearch-hadoop-6.7.0.zip を使用します。
-
EMR コンソールにログインし、マスターノードの IP アドレスを取得してから、SSH を使用して対応する ECS インスタンスにログインします。
詳細については、「クラスターへのログイン」をご参照ください。
-
ダウンロードした elasticsearch-hadoop-6.7.0.zip ファイルをマスターノードにアップロードし、解凍して elasticsearch-hadoop-hive-6.7.0.jar を取得します。
-
HDFS ディレクトリを作成し、elasticsearch-hadoop-hive-6.7.0.jar をこのディレクトリにアップロードします。
hadoop fs -mkdir /tmp/hadoop-es
hadoop fs -put elasticsearch-hadoop-6.7.0/dist/elasticsearch-hadoop-hive-6.7.0.jar /tmp/hadoop-es
ステップ 2: Hive 外部テーブルの作成
-
EMR コンソールの データ開発 モジュールで、[HiveSQL] ジョブを作成します。
詳細については、「Hive SQL ジョブの設定」をご参照ください。
[ジョブの作成] ダイアログボックスで、[ジョブ名] を
hivetestに、[フォルダー] をJOB/に設定し、[OK] をクリックします。 -
ジョブを設定して、外部テーブルを作成します。
ジョブの設定は次のとおりです。
-- JAR を追加します。このコマンドは現在のセッションでのみ有効です。
add jar hdfs:///tmp/hadoop-es/elasticsearch-hadoop-hive-6.7.0.jar;
-- Hive 外部テーブルを作成し、Elasticsearch インデックスにマッピングします。
CREATE EXTERNAL table IF NOT EXISTS company(
   id BIGINT,
   name STRING,
   birth STRING,
   addr STRING
)
STORED BY 'org.elasticsearch.hadoop.hive.EsStorageHandler'
TBLPROPERTIES(
    'es.nodes' = 'http://es-cn-mp91kzb8m0009****.elasticsearch.aliyuncs.com',
    'es.port' = '9200',
    'es.net.ssl' = 'true',
    'es.nodes.wan.only' = 'true',
    'es.nodes.discovery'='false',
    'es.input.use.sliced.partitions'='false',
    'es.input.json' = 'false',
    'es.resource' = 'company/_doc',
    'es.net.http.auth.user' = 'elastic',
    'es.net.http.auth.pass' = 'xxxxxx'
);
表 1. ES-Hadoop パラメーターの説明
パラメーター
デフォルト
説明
es.nodes
localhost
ES クラスターのエンドポイント。プライベートエンドポイントの使用を推奨します。エンドポイントは、クラスターの基本情報ページで確認できます。詳細については、「クラスターの基本情報の表示」をご参照ください。
es.port
9200
ES クラスターへのアクセスに使用するポート。
es.net.http.auth.user
elastic
ES クラスターへのアクセスに使用するユーザー名。
説明アプリケーションで
elasticアカウントを指定すると、このアカウントのパスワード変更後、伝播遅延により一時的なサービス中断が発生する可能性があります。そのため、elasticアカウントの使用は推奨されません。代わりに、Kibana コンソールで適切な権限を持つ専用ユーザーを作成してください。詳細については、「Elasticsearch X-Pack の RBAC メカニズムを使用したユーザーアクセスの制御」をご参照ください。es.net.http.auth.pass
/
ES クラスターへのアクセスに使用するパスワード。
es.nodes.wan.only
false
ES クラスターが仮想 IP アドレスを使用して接続する際に、ノードスニッフィングを有効にするかどうかを指定します。
-
true: ノードスニッフィングを無効にします。
-
false: ノードスニッフィングを有効にします。
es.nodes.discovery
true
ノード検出を使用するかどうかを指定します。
-
true: ノード検出を使用します。
-
false: ノード検出を使用しません。
重要Alibaba Cloud ES を使用する場合は、このパラメーターを
falseに設定する必要があります。
es.input.use.sliced.partitions
true
スライスパーティションを使用するかどうかを指定します。
-
true: スライスパーティションを使用します。このパラメーターを
trueに設定すると、インデックスの事前読み取り時間が大幅に増加し、クエリ時間自体よりもはるかに長くなることがあります。クエリパフォーマンスを向上させるため、このパラメーターをfalseに設定することを推奨します。 -
false: スライスパーティションを使用しません。
es.index.auto.create
true
Hadoop コンポーネントから ES クラスターにデータを書き込む際に、インデックスが存在しない場合に自動的に作成するかどうかを指定します。
-
true: インデックスを自動的に作成します。
-
false: インデックスを自動的に作成しません。
es.resource
/
読み取りまたは書き込みを行うインデックスとタイプ。
es.mapping.names
/
テーブルのカラムと ES インデックスフィールド間のマッピング。
es.read.metadata
false
操作に [_id] などの内部 Elasticsearch フィールドが含まれる場合は、このプロパティを有効にします。
ES-Hadoop 設定オプションの詳細については、「公式設定ドキュメント」をご参照ください。
-
-
ジョブを保存して実行します。
add jar hdfs:///tmp/hadoop-es/elasticsearch-hadoop-hive-6.7.0.jar;

CREATE EXTERNAL table IF NOT EXISTS company(
    id BIGINT,
    name STRING,
    birth STRING,
    addr STRING
)
STORED BY 'org.elasticsearch.hadoop.hive.EsStorageHandler'
TBLPROPERTIES(
    'es.nodes' = 'http://es-cn-n6wxxx.elasticsearch.aliyuncs.com',
    'es.port' = '9200',
    'es.net.ssl' = 'true',
    'es.nodes.wan.only' = 'true',
    'es.nodes.discovery'='false',
    'es.input.json' = 'false',
    'es.resource' = 'company/_doc',
    'es.net.http.auth.user' = 'elastic',
    'es.net.http.auth.pass' = 'xxx'
);
[実行記録] タブで、ジョブの実行ステータスを確認します。[ステータス] 列に [OK] と表示されている場合、ジョブは正常に実行されています。
ステップ 3: Hive によるインデックスへのデータ書き込み
-
データを書き込むための [HiveSQL] ジョブを作成します。
ジョブの設定は次のとおりです。
add jar hdfs:///tmp/hadoop-es/elasticsearch-hadoop-hive-6.7.0.jar; INSERT INTO TABLE company VALUES (1, "田中太郎", "1990-01-01","No.969, wenyixi Rd, yuhang, hangzhou"); INSERT INTO TABLE company VALUES (2, "鈴木一郎", "1991-01-01", "No.556, xixi Rd, xihu, hangzhou"); INSERT INTO TABLE company VALUES (3, "佐藤次郎", "1992-01-01", "No.699 wangshang Rd, binjiang, hangzhou"); -
ジョブを保存して実行します。
add jar hdfs:///tmp/hadoop-es/elasticsearch-hadoop-hive-6.7.0.jar; INSERT INTO TABLE company VALUES (1, "田中太郎", "1990-01-01","No.969, wenyixi Rd, yuhang, hangzhou"); INSERT INTO TABLE company VALUES (2, "鈴木一郎", "1991-01-01", "No.556, xixi Rd, xihu, hangzhou"); INSERT INTO TABLE company VALUES (3, "佐藤次郎", "1992-01-01", "No.699 wangshang Rd, binjiang, hangzhou"); -
ジョブが成功したら、クラスターの Kibana コンソールにログインして、
companyインデックス内のデータを表示します。Kibana コンソールへのログイン方法については、「Kibana コンソールへのログイン」をご参照ください。Kibana コンソールで、次のコマンドを実行して
companyインデックス内のデータを表示します。GET company/_searchコマンドが正常に実行されると、結果は次のようになります。
{
  "took" : 2,
  "timed_out" : false,
  "_shards" : {
    "total" : 5,
    "successful" : 5,
    "skipped" : 0,
    "failed" : 0
  },
  "hits" : {
    "total" : 3,
    "max_score" : 1.0,
    "hits" : [
      {
        "_index" : "company",
        "_type" : "_doc",
        "_id" : "T6XkvnQBHw8DvkRwat8M",
        "_score" : 1.0,
        "_source" : {
          "id" : 1,
          "name" : "田中太郎",
          "birth" : "1990-01-01",
          "addr" : "No.969, wenyixi Rd, yuhang, hangzhou"
        }
      },
      {
        "_index" : "company",
        "_type" : "_doc",
        "_id" : "tTPkvnQBNOGEvdaOqoyb",
        "_score" : 1.0,
        "_source" : {
          "id" : 2,
          "name" : "鈴木一郎",
          "birth" : "1991-01-01",
          "addr" : "No.556, xixi Rd, xihu, hangzhou"
        }
      },
      {
        "_index" : "company",
        "_type" : "_doc",
        "_id" : "D33kvnQBbtHntVTN6dAH",
        "_score" : 1.0,
        "_source" : {
          "id" : 3,
          "name" : "佐藤次郎",
          "birth" : "1992-01-01",
          "addr" : "No.699 wangshang Rd, binjiang, hangzhou"
        }
      }
    ]
  }
}
ステップ 4: Hive によるインデックスからのデータ読み取り
-
データを読み取る [HiveSQL] ジョブを作成します。
ジョブの設定は次のとおりです。
add jar hdfs:///tmp/hadoop-es/elasticsearch-hadoop-hive-6.7.0.jar; select * from company; -
ジョブを保存して実行します。
ジョブコードエディターには、
add jar hdfs:///tmp/hadoop-es/elasticsearch-hadoop-hive-6.7.0.jar;とselect * from company;の 2 つの SQL ステートメントが含まれています。ジョブが正常に実行されると、[結果] タブをクリックしてクエリ結果を表示できます。companyテーブルから、company.id、company.name、company.birth、およびcompany.addrの列を含む 3 つのレコードが返されます。これらのレコードには、zhangsan (Yuhang)、lisi (Xihu)、および wangwu (Binjiang) のデータが含まれています。
よくある質問
Q: ES のデータを読み書きする際に、次のエラーが発生した場合はどうすればよいですか。
Error message: FAILED: Execution Error, return code -101 from org.apache.hadoop.hive.ql.exec.mr.MapRedTask. Could not initialize class org.elasticsearch.hadoop.rest.commonshttp.CommonsHttpTransport。A: このエラーは、EMR 5.6.0 の Hive コンポーネントに commons-httpclient-3.1.jar ファイルが不足しているために発生します。この問題を解決するには、不足しているファイルを Hive の lib ディレクトリに手動で追加してください。ファイルのダウンロードリンクについては、「commons-httpclient-3.1」をご参照ください。