クエリプロファイルは、StarRocks インスタンスのクエリの実行詳細を記録します。クエリプロファイルを使用してクエリパフォーマンスを診断し、ボトルネックを特定して解決するための最適化手法を選択します。
クエリプロファイルの概要
クエリプロファイルの可視化
StarRocks Manager はクエリプロファイルの視覚的分析をサポートしています。詳細については、「クエリプロファイルの概要」をご参照ください。
クエリボトルネックの特定
StarRocks Manager のクエリプロファイル可視化では、実行時間が長いオペレーターはより濃い色で表示されます。実行時間が最も長い 3 つのオペレーターがハイライトされるため、クエリボトルネックを簡単に特定できます。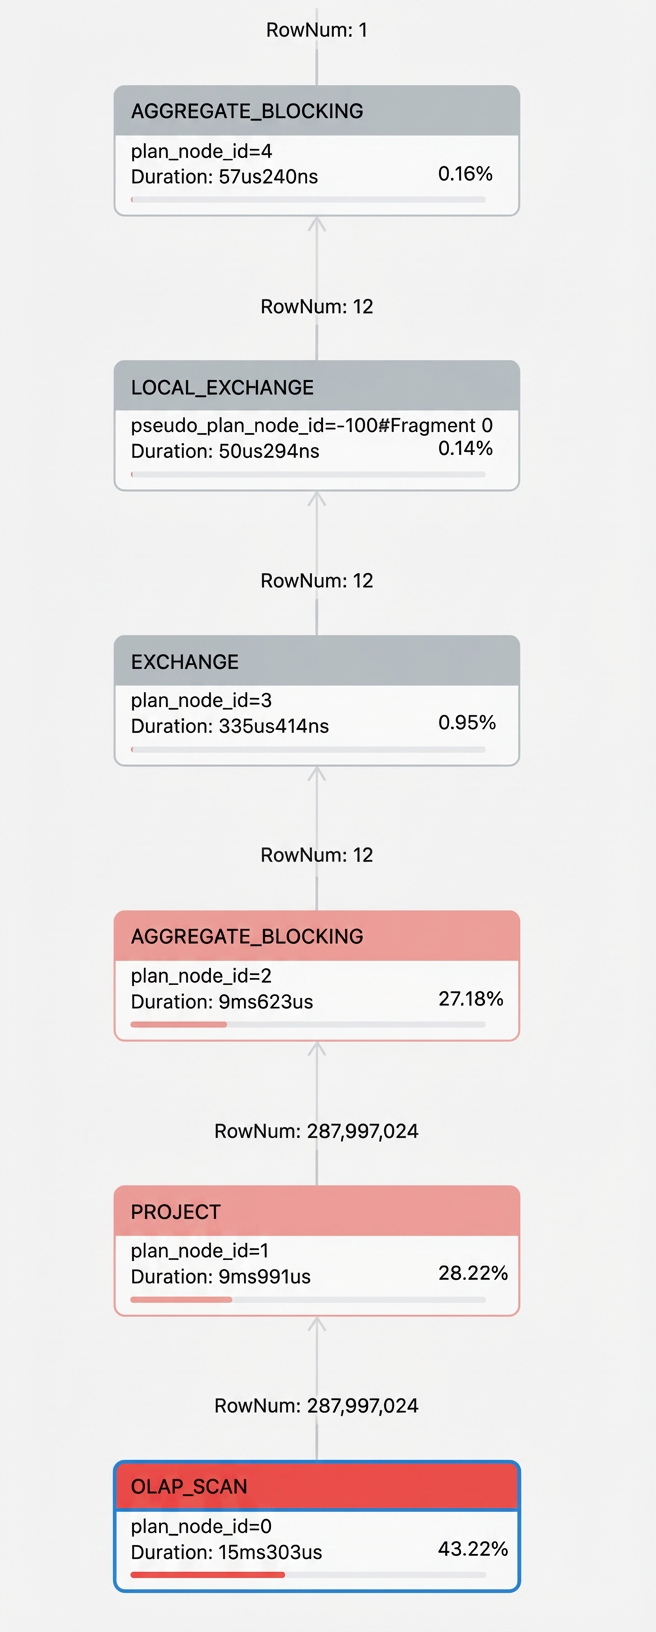
最適化のユースケース
以下のセクションでは、StarRocks での一般的なクエリパフォーマンスの問題を診断および解決する方法について説明します。
メモリ不足 (OOM) エラーを引き起こす大規模フィールドクエリの最適化
TEXT や VARCHAR などの大規模フィールドを含むテーブルをクエリする場合、大規模フィールドデータを過度に読み取ったり計算したりすると、メモリ不足 (OOM) エラーが発生する可能性があります。メモリ消費を削減するには、以下の対策を行ってください。
-
SELECT *の使用は避けてください。スキャンしてメモリにロードするデータ量を削減するために、必要な列のみを明示的に指定してください。 -
GROUP BYやDISTINCTなどの集計操作から大規模フィールドを除外し、中間結果セットが過大になることを防いでください。 -
セッション変数
enable_spill=trueを設定してディスクへのスピル機能を有効にすることで、メモリ負荷を軽減します。 -
大規模なテキストフィールドを別のテーブルに移動し、プライマリテーブルにはインデックスと小さなフィールドのみを保持することで、テーブルスキーマを最適化してください。このテーブル分割アプローチは、集計シナリオでは効果がありません。
ビットマップインデックス
ビットマップインデックスは、ビット配列を使用する特殊なタイプのデータベースインデックスです。配列内の各ビットは、データテーブルの 1 つの行に対応します。ビットの値 (0 または 1) は、対応する行の値によって決定されます。
-
ビットマップインデックスを使用して、
gender列など、カーディナリティが低く繰り返し値が多い列のクエリパフォーマンスを向上させます。 -
クエリがビットマップインデックスにヒットしたかどうかを確認するには、クエリプロファイルの
BitmapIndexFilterRowsフィールドを確認してください。
インデックスの作成
-
テーブル作成時にビットマップインデックスを作成します。
CREATE TABLE `student_info` (
  `s_stukey` bigint(20) NULL COMMENT "",
  `s_name` varchar(65533) NULL COMMENT "",
  `s_gender` varchar(65533) NULL COMMENT "",
  INDEX index1 (s_gender) USING BITMAP COMMENT 'index1'
) ENGINE=OLAP
DUPLICATE KEY(`s_stukey`)
COMMENT "OLAP"
DISTRIBUTED BY HASH(`s_stukey`);
INSERT INTO student_info
VALUES
    (001,'student#000000019','male'),
    (002,'student#000000020','male'),
    (003,'student#000000021','male'),
(004,'student#000000022','female');-
CREATE INDEXを使用して、既存のテーブルにビットマップインデックスを作成します。
CREATE INDEX index_name ON table_name (column_name) [USING BITMAP] [COMMENT ''];インデックス作成の進行状況の確認
以下のコマンドを実行して、インデックス作成タスクの進行状況を確認してください。
SHOW ALTER TABLE COLUMN [FROM db_name];インデックスの表示
以下のコマンドを実行して、テーブル上のインデックスを表示してください。
SHOW {INDEX[ES] | KEY[S] } FROM [db_name.]table_name [FROM db_name];以下の出力が返されます。
MySQL [db_test]> show index from student_info;
+------------------------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+
| Table                  | Non_unique | Key_name | Seq_in_index | Column_name | Collation | Cardinality | Sub_part | Packed | Null | Index_type | Comment |
+------------------------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+
| db_test.student_info   |            | index1   |              | s_gender    |           |             |          |        |      | BITMAP     | index1  |
+------------------------+------------+----------+--------------+-------------+-----------+-------------+----------+--------+------+------------+---------+
1 row in set (0.01 sec)
インデックスの削除
以下のコマンドを実行して、インデックスを削除してください。
DROP INDEX index_name ON [db_name.]table_name;単一列クエリのテスト
-
s_gender列をフィルタリングするクエリを実行します。select * from student_info where s_gender='male'; -
プロファイルを表示します。
OLAP_SCAN をクリックし、右側の [Node Details] タブをクリックします。
Bitmapのメトリクスをフィルタリングして、ビットマップインデックスが有効になっていることを確認してください。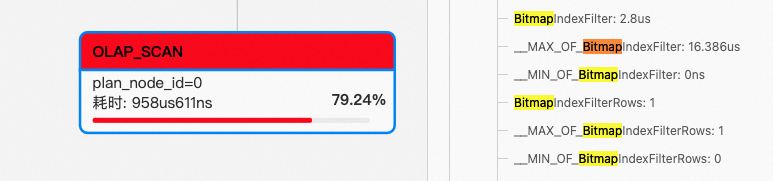
ブルームフィルターインデックス
ブルームフィルターインデックスは、データファイルにターゲットデータが含まれているかどうかを迅速に判定します。含まれていない場合はファイルがスキップされ、スキャンされるデータ量が削減されます。ブルームフィルターは空間効率が高く、ID 列などのカーディナリティが高い列に適しています。
-
プライマリーキーモデルと Duplicate モデルでは、任意の列にブルームフィルターインデックスを作成できます。Aggregate モデルと Update モデルでは、キー列にのみブルームフィルターインデックスを作成できます。
-
ブルームフィルターインデックスは、TINYINT、FLOAT、DOUBLE、DECIMAL データ型の列ではサポートされていません。
-
ブルームフィルターインデックスは、
inまたは=述語を含むクエリ (SELECT ... WHERE ... IN ()やSELECT ... WHERE column = ...など) の場合にのみ、パフォーマンスを向上させます。 -
クエリがブルームフィルターインデックスにヒットしたかどうかを確認するには、クエリプロファイルの
BloomFilterFilterRowsフィールドを確認してください。
インデックスの作成
テーブルを作成する際、bloom_filter_columns を PROPERTIES 句で指定することで、ブルームフィルターインデックスを作成できます。以下に例を示します。
CREATE TABLE table1
(
  k1 BIGINT,
  k2 LARGEINT,
  v1 VARCHAR(2048) REPLACE,
  v2 SMALLINT DEFAULT "10"
)
ENGINE = olap
PRIMARY KEY(k1, k2)
DISTRIBUTED BY HASH (k1, k2) BUCKETS 10
PROPERTIES("bloom_filter_columns" = "k1,k2"); -- 複数のインデックス列はカンマ (,) で区切ります。
インデックスの表示
以下のコマンドを実行して、テーブル上のインデックスを表示してください。
SHOW CREATE TABLE table1;インデックスの変更
例:
-
列
v1にブルームフィルターインデックスを追加します。
ALTER TABLE table1 SET ("bloom_filter_columns" = "k1,k2,v1");-
列
k2のブルームフィルターインデックスを削除します。
ALTER TABLE table1 SET ("bloom_filter_columns" = "k1");-
table1からすべてのブルームフィルターインデックスを削除します。
ALTER TABLE table1 SET ("bloom_filter_columns" = "");例
-
TPC-H の
customerテーブルを例にします。c_phone列など、ソートキーではないカーディナリティの高い列にブルームフィルターインデックスを追加します。ALTER TABLE tpc_h_sf100.customer SET ("bloom_filter_columns" = "c_custkey, c_phone"); -
インデックスを表示して、ブルームフィルターインデックスが追加されたことを確認してください。
SHOW CREATE TABLE tpc_h_sf100.customer;| customer | CREATE TABLE `customer` ( `c_custkey` bigint(20) NULL COMMENT "", `c_name` varchar(65533) NULL COMMENT "", `c_address` varchar(65533) NULL COMMENT "", `c_nationkey` bigint(20) NULL COMMENT "", `c_phone` varchar(65533) NULL COMMENT "", `c_acctbal` double NULL COMMENT "", `c_mktsegment` varchar(65533) NULL COMMENT "", `c_comment` varchar(65533) NULL COMMENT "", `Gender` varchar(65533) NULL DEFAULT "default_value" COMMENT "" ) ENGINE=OLAP DUPLICATE KEY(`c_custkey`) COMMENT "OLAP" DISTRIBUTED BY HASH(`c_custkey`) BUCKETS 24 PROPERTIES ( "replication_num" = "1", "bloom_filter_columns" = "c_custkey, c_phone", "in_memory" = "false", "storage_format" = "DEFAULT", "enable_persistent_index" = "false", "compression" = "LZ4" ); | -
c_phone列をフィルタリングするクエリを実行します。select * from tpc_h_sf100.customer where c_phone = "10-334-921-5346"; -
プロファイルを表示します。
OLAP_SCAN をクリックし、右側の [Node Details] タブをクリックします。
BloomFilterFilterRowsメトリクスを見つけて、ブルームフィルターインデックスが有効であることを確認してください。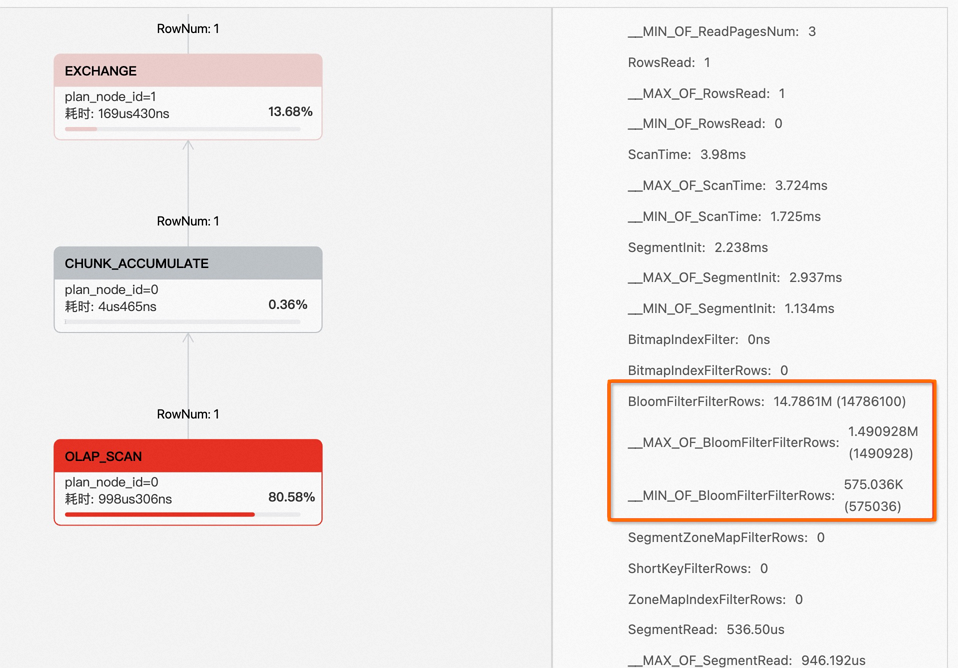
データスキューの最適化
この例では、TPC-H の lineitem テーブルを使用し、値の分布が不均一な列をバケットキーとして選択することで、データスキューの問題を示します。この例では、l_tag 列はすべての行で同じ値を持つため、極端なデータスキューが発生します。
-
テストデータを作成します。TPC-H の
lineitemテーブルに新しい列を追加し、分散キーとして使用します。CREATE TABLE `lineitem_tag` ( `l_orderkey` bigint(20) NULL COMMENT "", `l_partkey` bigint(20) NULL COMMENT "", `l_suppkey` bigint(20) NULL COMMENT "", `l_linenumber` int(11) NULL COMMENT "", `l_quantity` double NULL COMMENT "", `l_extendedprice` double NULL COMMENT "", `l_discount` double NULL COMMENT "", `l_tax` double NULL COMMENT "", `l_returnflag` varchar(65533) NULL COMMENT "", `l_linestatus` varchar(65533) NULL COMMENT "", `l_shipdate` date NULL COMMENT "", `l_commitdate` date NULL COMMENT "", `l_receiptdate` date NULL COMMENT "", `l_shipinstruct` varchar(65533) NULL COMMENT "", `l_shipmode` varchar(65533) NULL COMMENT "", `l_comment` varchar(65533) NULL COMMENT "", `l_tag` varchar(65533) default 'false' COMMENT "" ) ENGINE=OLAP DUPLICATE KEY(`l_orderkey`) COMMENT "OLAP" DISTRIBUTED BY HASH(`l_tag`) BUCKETS 96 PROPERTIES ( "replication_num" = "1", "in_memory" = "false", "storage_format" = "DEFAULT", "enable_persistent_index" = "false" ); insert into lineitem_tag select *, 'false' as l_tag from tpc_h_sf100.lineitem; -
クエリを実行してテーブル全体をスキャンします。
select count(1) from lineitem_tag; -
プロファイルを表示します。
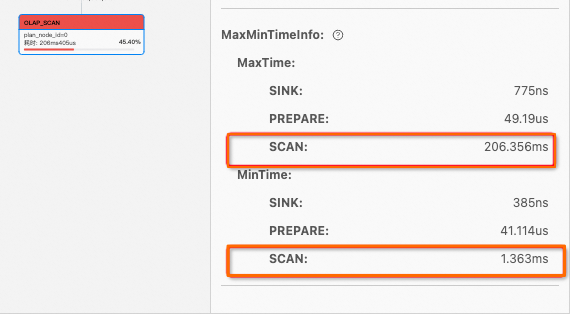
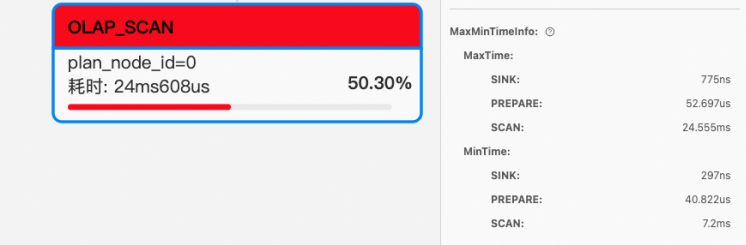
OLAP_SCAN をクリックし、右側の [Node] タブに移動します。SCAN 時間を MaxTime と MinTime で比較します。時間が数桁異なる場合、データスキューが発生している可能性があります。
-
分散キーを再定義してテーブルスキーマを最適化します。
lineitem2という新しいテーブルを作成し、バケットキーをl_tagからl_orderkeyに変更してデータスキューを解決します。以下のステートメントでテーブルを作成します。重要な変更点はDISTRIBUTED BY HASH(`l_orderkey`) BUCKETS 96です。CREATE TABLE `lineitem2` ( `l_orderkey` bigint(20) NULL COMMENT "", `l_partkey` bigint(20) NULL COMMENT "", `l_suppkey` bigint(20) NULL COMMENT "", `l_linenumber` int(11) NULL COMMENT "", `l_quantity` double NULL COMMENT "", `l_extendedprice` double NULL COMMENT "", `l_discount` double NULL COMMENT "", `l_tax` double NULL COMMENT "", `l_returnflag` varchar(65533) NULL COMMENT "", `l_linestatus` varchar(65533) NULL COMMENT "", `l_shipdate` date NULL COMMENT "", `l_commitdate` date NULL COMMENT "", `l_receiptdate` date NULL COMMENT "", `l_shipinstruct` varchar(65533) NULL COMMENT "", `l_shipmode` varchar(65533) NULL COMMENT "", `l_comment` varchar(65533) NULL COMMENT "", `l_tag` varchar(65533) NULL DEFAULT "default_value" COMMENT "" ) ENGINE=OLAP DUPLICATE KEY(`l_orderkey`) COMMENT "OLAP" DISTRIBUTED BY HASH(`l_orderkey`) BUCKETS 96 PROPERTIES ( "replication_num" = "1", "bloom_filter_columns" = "l_orderkey", "in_memory" = "false", "storage_format" = "DEFAULT", "enable_persistent_index" = "false", "compression" = "LZ4" ); -
プロファイルを再度表示します。SCAN 時間を MaxTime と MinTime で比較します。データスキューの問題が軽減されていることがわかります。
単一テーブルマテリアライズドビュー
StarRocks の単一テーブルマテリアライズドビュー (ロールアップとも呼ばれる) は、直接クエリできない特殊なタイプのインデックスです。データウェアハウスに複雑または反復的なクエリが多数含まれている場合は、単一テーブルマテリアライズドビューを作成してそれらを高速化できます。
クエリのテスト
-
TPC-H の
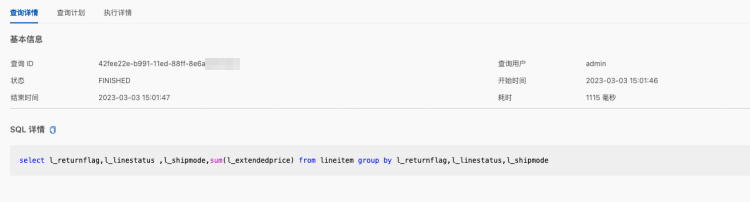
lineitemテーブルを例にし、クエリを実行します。select l_returnflag,l_linestatus,l_shipmode,sum(l_extendedprice) from lineitem group by l_returnflag,l_linestatus,l_shipmode; -
マテリアライズドビューが作成されていないため、最初のクエリは完了までに 1115 ms かかります。
-
プロファイルを表示します。
OLAP_SCAN をクリックし、右側の [Node] タブに移動します。ロールアップが
lineitemテーブル自体をスキャンしたことがわかります。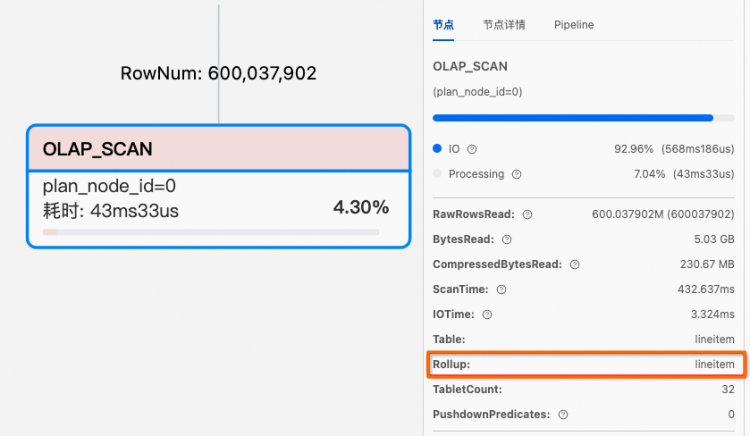
マテリアライズドビューの作成
以下のコマンドを実行して、単一テーブルマテリアライズドビューを作成してください。
CREATE MATERIALIZED VIEW material_test AS select l_returnflag,l_linestatus ,l_shipmode,sum(l_extendedprice) from lineitem group by l_returnflag,l_linestatus,l_shipmode;マテリアライズドビューヒットの確認
-
EXPLAINコマンドを使用して、クエリが単一テーブルマテリアライズドビューにヒットしたかどうかを確認してください。explain select l_returnflag,l_linestatus ,l_shipmode,sum(l_extendedprice) from lineitem group by l_returnflag,l_linestatus,l_shipmode;返された結果では、
rollup: material_testは、クエリがmaterial_testという名前のマテリアライズドビューにヒットしたことを示しています。0:OlapScanNode TABLE: lineitem PREAGGREGATION: OFF. Reason: null partitions=1/1 rollup: material_test tabletRatio=96/96 tabletList=15646,15648,15650,15652,15654,15656,15658,15660,15662,15664 ... cardinality=600037902 avgRowSize=14.285666 numNodes=0 -
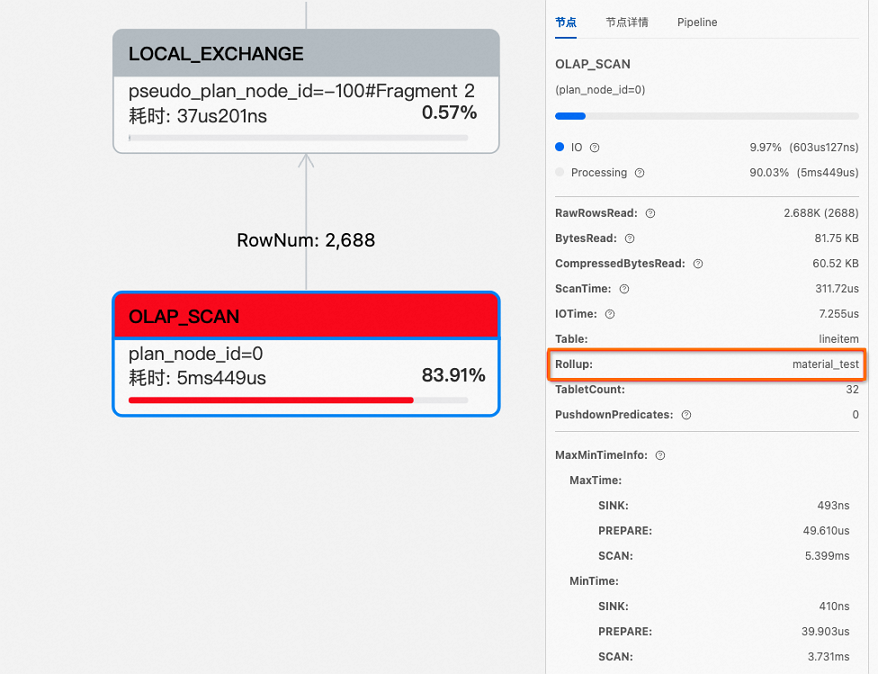
プロファイルを表示します。
OLAP_SCAN をクリックします。右側の [Node] タブでは、クエリがマテリアライズドビューにヒットし、クエリ時間が 0.05 ms に短縮されたことがわかります。
JoinRuntimeFilter が有効かどうかの確認
JOIN 操作の右側のテーブルがハッシュテーブルを構築すると、ランタイムフィルターが作成されます。このフィルターはクエリツリーの左側に送信され、可能な限りスキャンオペレーターにプッシュダウンされます。スキャンオペレーターの Node Details タブで、JoinRuntimeFilter に関連するメトリクスを表示できます。
-
TPC-DS の
query72.sqlを例にします。select i_item_desc, w_warehouse_name, d1.d_week_seq, sum(case when p_promo_sk is null then 1 else 0 end) no_promo, sum(case when p_promo_sk is not null then 1 else 0 end) promo, count(*) total_cnt from inventory join catalog_sales on (cs_item_sk = inv_item_sk) join warehouse on (w_warehouse_sk=inv_warehouse_sk) join item on (i_item_sk = cs_item_sk) join customer_demographics on (cs_bill_cdemo_sk = cd_demo_sk) join household_demographics on (cs_bill_hdemo_sk = hd_demo_sk) join date_dim d1 on (cs_sold_date_sk = d1.d_date_sk) join date_dim d2 on (inv_date_sk = d2.d_date_sk) join date_dim d3 on (cs_ship_date_sk = d3.d_date_sk) left outer join promotion on (cs_promo_sk=p_promo_sk) left outer join catalog_returns on (cr_item_sk = cs_item_sk and cr_order_number = cs_order_number) where d1.d_week_seq = d2.d_week_seq and inv_quantity_on_hand < cs_quantity and d3.d_date > (cast(d1.d_date AS DATE) + interval '5' day) and hd_buy_potential = '>10000' and d1.d_year = 1999 and cd_marital_status = 'D' group by i_item_desc,w_warehouse_name,d1.d_week_seq order by total_cnt desc, i_item_desc, w_warehouse_name, d1.d_week_seq limit 100; -
プロファイルを表示します。
OLAP_SCAN をクリックし、右側の [Node Details] タブをクリックします。スキャンオペレーターが
inventoryテーブルをスキャンした際に JoinRuntimeFilter がトリガーされたことがわかります。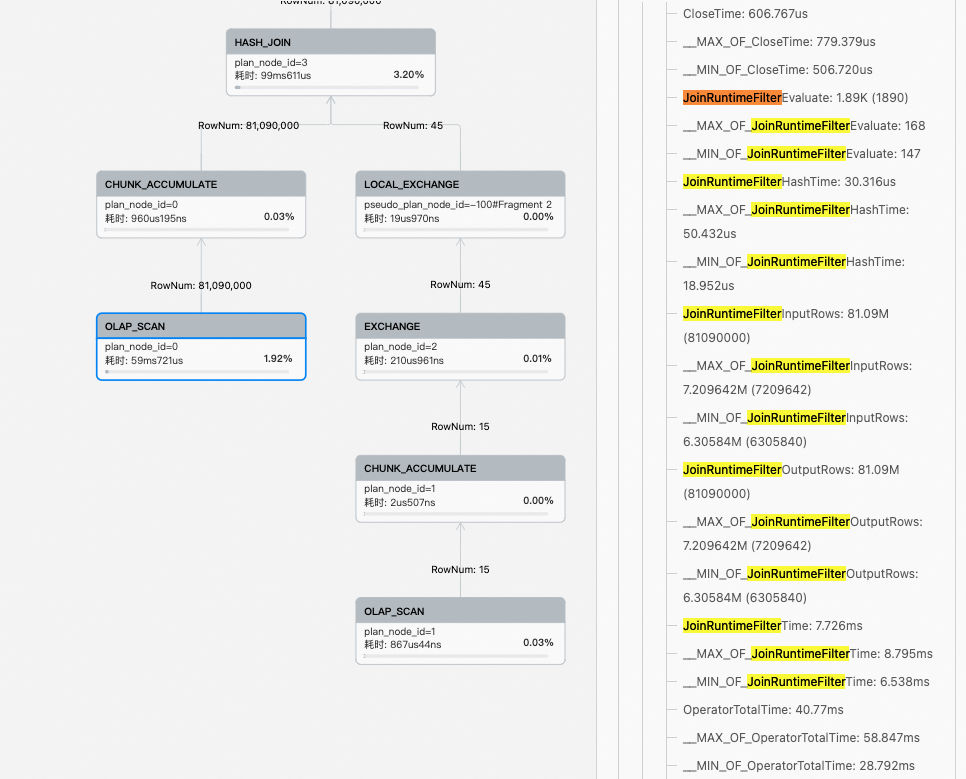
コロケート結合
StarRocks でコロケート結合を使用するには、テーブル作成時にテーブルをコロケーショングループ (CG) に割り当てます。同じ CG 内のテーブルは、同じコロケーショングループスキーマ (CGS) に従う必要があり、データが同じ BE ノードのセット全体に分散されます。結合列がバケットキーでもある場合、コンピュートノードはローカル結合のみを実行すればよく、ノード間のデータ転送時間が削減されます。シャッフル結合やブロードキャスト結合とは異なり、コロケート結合はネットワークデータ転送を回避し、クエリパフォーマンスを向上させます。
コロケートテーブルの作成
StarRocks は、同じデータベース内のテーブル間でのみコロケート結合操作をサポートしています。
以下のステートメントを実行して、コロケーショングループにテーブルを作成してください。
CREATE TABLE tbl (k1 int, v1 int sum)
DISTRIBUTED BY HASH(k1)
BUCKETS 8
PROPERTIES(
    "colocate_with" = "group1"
);
コロケーショングループの自動削除
グループ内の最後のテーブルが完全に削除されると、グループも自動的に削除されます。完全削除とは、テーブルがごみ箱から削除されることを意味します。DROP TABLE コマンドを使用してテーブルを削除した後、テーブルは完全に削除されるまでデフォルトで 1 日間ごみ箱に残ります。
グループ情報の表示
たとえば、以下のコマンドを実行してグループ情報を表示してください。
SHOW PROC '/colocation_group';コマンドは以下の情報を返します。
+-------------+--------------+----------+------------+----------------+----------+----------+
| GroupId     | GroupName    | TableIds | BucketsNum | ReplicationNum | DistCols | IsStable |
+-------------+--------------+----------+------------+----------------+----------+----------+
| 11912.11916 | 11912_group1 | 11914    | 8          | 3              | int(11)  | true     |
+-------------+--------------+----------+------------+----------------+----------+----------+
以下の表では、各列について説明します。
|
列 |
説明 |
|
GroupId |
クラスター全体でグループを一意に識別する ID です。最初の部分はデータベース ID、2 番目の部分はグループ ID です。 |
|
GroupName |
グループのフルネームです。 |
|
TableIds |
このグループに含まれるテーブル ID のリストです。 |
|
BucketsNum |
バケット数です。 |
|
ReplicationNum |
レプリカ数です。 |
|
DistCols |
分散列のデータ型です。 |
|
IsStable |
グループが安定しているかどうかを示します。 |
以下のコマンドを実行して、特定のグループのデータ分散を表示できます。
SHOW PROC '/colocation_group/GroupId';
SHOW PROC '/colocation_group/11912.11916';
コマンドは以下の情報を返します。
+-------------+---------------------+
| BucketIndex | BackendIds          |
+-------------+---------------------+
| 0           | 10002, 10004, 10003 |
| 1           | 10002, 10004, 10003 |
| 2           | 10002, 10004, 10003 |
| 3           | 10002, 10004, 10003 |
| 4           | 10002, 10004, 10003 |
| 5           | 10002, 10004, 10003 |
| 6           | 10002, 10004, 10003 |
| 7           | 10002, 10004, 10003 |
+-------------+---------------------+
8 rows in set (0.00 sec)
グループプロパティの変更
以下のステートメントを実行して、テーブルを別のコロケーショングループに移動してください。
ALTER TABLE tbl SET ("colocate_with" = "group_name");例
-
TPC-H データセットの
ordersテーブルとlineitemテーブルを同じコロケーショングループに割り当てます。use tpc_h_sf100; ALTER TABLE orders SET ("colocate_with" = "cg_tpc_orders"); ALTER TABLE lineitem SET ("colocate_with" = "cg_tpc_orders"); -
以下のクエリを実行します。
select count(1) from orders as o join lineitem as l on o.o_orderkey = l.l_orderkey; -
StarRocks Manager UI のクエリの [Query Plan] タブで、コロケート結合が有効かどうかを確認してください。
colocateが true の場合、コロケート結合が有効になっています。実行プランでは、colocate: trueとして表示されます。対応するクエリプランフラグメントは次のとおりです。
2:HASH JOIN
|  join op: INNER JOIN (COLOCATE)
|  colocate: true
|  equal join conjunct: 10: l_orderkey = 1: o_orderkey
|
|----1:OlapScanNode
|       TABLE: orders
|       PREAGGREGATION: ON
|       PREDICATES: 1: o_orderkey IS NOT NULL
|       partitions=1/1
|       rollup: orders
|       tabletRatio=96/96
|       tabletList=12403,12405,12407,12409,12411,12413,12415,12417,12419,12421 ...
|       cardinality=135000000
|       avgRowSize=1.0
|       numNodes=0
バケットプルーニングとパーティションプルーニングの確認
StarRocks Manager UI のクエリの [Query Plan] タブで、partition または tabletRatio パラメータを表示して、パーティションプルーニングまたはバケットプルーニングが有効かどうかを確認できます。
FE メモリが継続的に増加してメモリアラートがトリガーされる場合のトラブルシューティング方法
FE メモリが増加し続けてメモリアラートがトリガーされる場合は、以下の順序で問題をトラブルシューティングしてください。
-
メタデータの肥大化を確認 —
SHOW PROC '/statistic'を実行し、合計TabletNumを確認してください。合計TabletNumが 1,000,000 を超える場合は、メタデータの肥大化を示しています。 -
リソース集約的なクエリを特定 —
TabletNumが正常な場合は、監査ログテーブル_starrocks_audit_db_.starrocks_audit_tblをクエリし、CPU またはメモリ消費量でレコードをソートして、高負荷の SQL ステートメントを最適化してください。 -
不均衡な負荷の解決 — SLB とクライアント側接続プールを設定して、FE ノード全体で負荷分散を有効にしてください。これにより、リクエストが単一の FE Leader に集中することを防ぎ、メモリスパイクと頻繁な GC を回避できます。
-
書き込み方法の最適化 — 大規模な
VALUES挿入を Stream Load に置き換えて、FE 解析のホットスポットを根本から排除してください。