Apache Paimon は、高スループットの書き込みと低レイテンシーのクエリをサポートする、ストリーミングおよびバッチ処理のための統合データレイクフォーマットです。このトピックでは、EMR Serverless Spark で Paimon テーブルを読み書きする方法について説明します。
前提条件
ワークスペースが作成済みであること。「ワークスペースの作成」をご参照ください。
手順
ステップ1: SQL セッションの作成
-
[セッション] ページに移動します。
-
EMR コンソールにログインします。
-
左側のナビゲーションウィンドウで、[EMR Serverless] > [Spark] を選択します。
-
[Spark] ページで、対象のワークスペースの名前をクリックします。
-
EMR Serverless Spark ページで、左側のナビゲーションウィンドウの Sessions をクリックします。
-
-
SQL Session ページで、Connect to SQL Session をクリックします。
-
Create SQL Session ページで、Spark Configuration セクションのパラメーターを設定し、Create をクリックします。詳細については、「SQL セッションの管理」をご参照ください。
Spark はカタログを介して Paimon テーブルの読み書きを行います。シナリオに基づいてカタログタイプを選択します。詳細については、「データカタログの管理」をご参照ください。
データカタログ
Add Catalog ページで Catalog をクリックし、Spark SQL 開発環境でデータカタログを選択することで、データカタログを使用できます。この場合、セッションパラメーターは不要です。
説明EMR エンジンバージョン esr-4.3.0 以降、esr-3.3.0 以降、または esr-2.7.0 以降を推奨します。
カスタムカタログ
Data Lake Formation (DLF)
spark.sql.catalog.<catalogName>                                 org.apache.paimon.spark.SparkCatalog
spark.sql.catalog.<catalogName>.metastore                       rest
spark.sql.catalog.<catalogName>.uri                             http://cn-hangzhou-vpc.dlf.aliyuncs.com
spark.sql.catalog.<catalogName>.warehouse                       <catalog_name>
spark.sql.catalog.<catalogName>.token.provider                  dlf
spark.sql.catalog.<catalogName>.dlf.access-key-id               <access_key_id>
spark.sql.catalog.<catalogName>.dlf.access-key-secret           <access_key_secret>
パラメーター:
パラメーター
説明
値の例
spark.sql.catalog.<catalogName>カタログの実装。
固定値:
org.apache.paimon.spark.SparkCatalogspark.sql.catalog.<catalogName>.metastoreメタデータのストレージメソッド。DLF REST API を使用するには、
restに設定します。固定値:
restspark.sql.catalog.<catalogName>.uriDLF URI。形式:
http://<endpoint>-vpc.dlf.aliyuncs.com。http://cn-hangzhou-vpc.dlf.aliyuncs.comspark.sql.catalog.<catalogName>.warehouseウェアハウスパス。DLF の場合、これをカタログ名に設定します。
<catalog_name>spark.sql.catalog.<catalogName>.token.provider認証プロバイダー。DLF の場合は
dlfに設定します。固定値:
dlfspark.sql.catalog.<catalogName>.dlf.access-key-idAlibaba Cloud アカウントまたは RAM ユーザーの AccessKey ID。
<access_key_id>spark.sql.catalog.<catalogName>.dlf.access-key-secretAlibaba Cloud アカウントまたは RAM ユーザーの AccessKey シークレット。
<access_key_secret>DLF-Legacy
メタデータは DLF 1.0 に保存されます。
spark.sql.catalog.<catalogName>                          org.apache.paimon.spark.SparkCatalog
spark.sql.catalog.<catalogName>.metastore                dlf
spark.sql.catalog.<catalogName>.dlf.catalog.id           <catalog_name>
spark.sql.catalog.<catalogName>.dlf.catalog.endpoint     dlf-vpc.cn-hangzhou.aliyuncs.com
パラメーター:
パラメーター
説明
値の例
spark.sql.catalog.<catalogName>カタログの実装。
固定値:
org.apache.paimon.spark.SparkCatalogspark.sql.catalog.<catalogName>.metastoreメタデータのストレージメソッド。DLF をメタストアとして使用するには、
dlfに設定します。固定値:
dlfspark.sql.catalog.<catalogName>.dlf.catalog.idDLF 内のカタログの名前。
<catalog_name>spark.sql.catalog.<catalogName>.dlf.catalog.endpointDLF エンドポイント。リージョンに基づいて DLF エンドポイントを選択します。
dlf-vpc.cn-hangzhou.aliyuncs.comHive メタストア
メタデータは、指定された Hive メタストアに保存されます。
spark.sql.catalog.<catalogName>                 org.apache.paimon.spark.SparkCatalog
spark.sql.catalog.<catalogName>.metastore       hive
spark.sql.catalog.<catalogName>.uri             thrift://<yourHMSUri>:<port>
パラメーター:
パラメーター
説明
値の例
spark.sql.catalog.<catalogName>カタログの実装。
固定値:
org.apache.paimon.spark.SparkCatalogspark.sql.catalog.<catalogName>.metastoreメタストアタイプ。Hive メタストアを使用するには、
hiveに設定します。固定値:
hivespark.sql.catalog.<catalogName>.uriHive メタストア URI。形式:
thrift://<IP address of Hive metastore>:9083。<IP address of Hive metastore>は、Hive メタストアサービスの内部 IP アドレスです。外部メタストアを使用する方法の詳細については、「外部 Hive メタストアサービスへの接続」をご参照ください。thrift://192.168.**.**:9083ファイルシステム
メタデータはファイルシステムに保存されます。
spark.sql.catalog.<catalogName>                 org.apache.paimon.spark.SparkCatalog
spark.sql.catalog.<catalogName>.metastore       filesystem
spark.sql.catalog.<catalogName>.warehouse       oss://<yourBucketName>/warehouse
パラメーター:
パラメーター
説明
値の例
spark.sql.catalog.<catalogName>カタログの実装。
固定値:
org.apache.paimon.spark.SparkCatalogspark.sql.catalog.<catalogName>.metastoreメタストアタイプ。ファイルシステムをメタストアとして使用するには、
filesystemに設定します。固定値:
filesystemspark.sql.catalog.<catalogName>.warehouseウェアハウスパス。この例では、
<yourBucketName>は OSS バケットの名前です。oss://my-bucket/warehouseDLF、DLF 1.0、Hive など、複数のカタログを同時に設定できます。例:
# DLF カタログの設定
spark.sql.catalog.dlf                                 org.apache.paimon.spark.SparkCatalog
spark.sql.catalog.dlf.metastore                       rest
spark.sql.catalog.dlf.uri                             http://cn-hangzhou-vpc.dlf.aliyuncs.com
spark.sql.catalog.dlf.warehouse                       <catalog_name>
spark.sql.catalog.dlf.token.provider                  dlf
spark.sql.catalog.dlf.dlf.access-key-id               <access_key_id>
spark.sql.catalog.dlf.dlf.access-key-secret           <access_key_secret>

# DLF 1.0 カタログの設定
spark.sql.catalog.dlf1                                 org.apache.paimon.spark.SparkCatalog
spark.sql.catalog.dlf1.metastore                       dlf
spark.sql.catalog.dlf1.dlf.catalog.id                  <catalog_name>
spark.sql.catalog.dlf1.dlf.catalog.endpoint            dlf-vpc.cn-hangzhou.aliyuncs.com


# hive1 カタログの設定
spark.sql.catalog.hive1                                 org.apache.paimon.spark.SparkCatalog
spark.sql.catalog.hive1.metastore                       hive
spark.sql.catalog.hive1.uri                             thrift://<yourHMSUri-1>:<port>

# hive2 カタログの設定
spark.sql.catalog.hive2                                 org.apache.paimon.spark.SparkCatalog
spark.sql.catalog.hive2.metastore                       hive
spark.sql.catalog.hive2.uri                             thrift://<yourHMSUri-2>:<port>
ステップ2: Paimon テーブルの読み書き
-
SQL 開発ページに移動します。
EMR Serverless Spark ページで、左側のナビゲーションペインにある Development をクリックします。
-
Development タブで、
 アイコンをクリックします。
-
Create ダイアログボックスで、users_task などの名前を入力し、[タイプ] をデフォルトの [SparkSQL] に設定してから、OK をクリックします。
-
新しい Spark SQL タブ (
users_task) に、次のコードをコピーします。Paimon カタログ
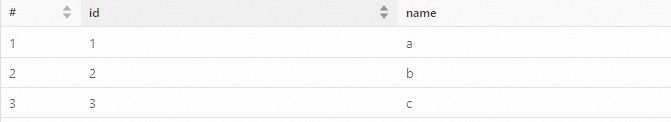
-- データベースを作成します。 CREATE DATABASE IF NOT EXISTS paimon.ss_paimon_db; -- Paimon テーブルを作成します。 CREATE TABLE paimon.ss_paimon_db.paimon_tbl (id INT, name STRING) USING paimon; -- Paimon テーブルにデータを書き込みます。 INSERT INTO paimon.ss_paimon_db.paimon_tbl VALUES (1, "a"), (2, "b"), (3, "c"); -- Paimon テーブルから書き込み結果をクエリします。 SELECT * FROM paimon.ss_paimon_db.paimon_tbl ORDER BY id; -- データベースを削除します。 DROP DATABASE paimon.ss_paimon_db CASCADE; -
データベースのドロップダウンリストからデータベースを選択し、セッションのドロップダウンリストから作成した SQL セッションを選択します。
-
Run をクリックしてジョブを実行します。ジョブから次の出力が返されます。
よくある質問
関連ドキュメント
-
Paimon の使用方法と設定の詳細については、「Paimon 公式ドキュメント」をご参照ください。
-
外部メタストアサービスを使用する方法の詳細については、「外部 Hive メタストアサービスへの接続」をご参照ください。