すべてのプロダクト
Search
ドキュメントセンター

E-MapReduce:Flume の概要

最終更新日:Aug 22, 2026

Apache Flume は、分散型で信頼性が高く、高可用性 (HA) を備えたシステムで、さまざまなデータソースから大量のログデータを効率的に収集、集約し、中央データストアに移動します。

シナリオ

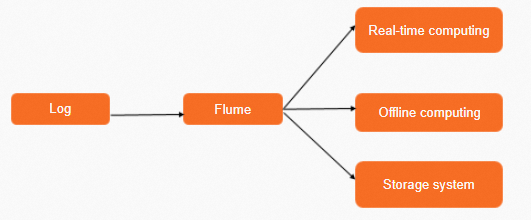
Flume は、ログ収集に最も一般的に使用されています。カスタムのソースを介して、他の種類のデータを転送することもできます。

Flume は、Flink、Spark Streaming、Storm などのリアルタイムコンピューティングプラットフォームや、MapReduce (MR)、Hive、Presto などのオフラインコンピューティングプラットフォームにデータを送信します。Flume は、Hadoop Distributed File System (HDFS)、OSS、Kafka、Elasticsearch などのストレージシステムにデータを直接送信することもできます。これにより、後続の分析やトラフィックスクラビングのためにデータが準備されます。flume2
アーキテクチャ

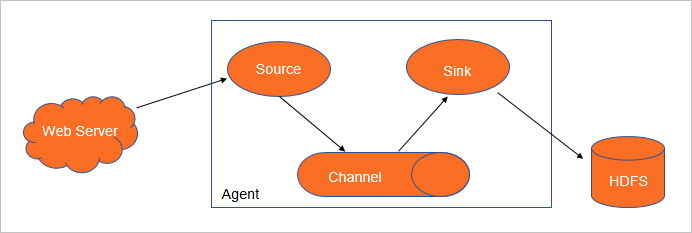
Flume エージェントは Flume のインスタンスです。これは、プロデューサーからコンシューマーへのイベントのデータストリームを制御する Java 仮想マシン (JVM) プロセスです。Flume エージェントは、ソース、チャネル、およびシンクで構成されています。1 つのソースは複数のチャネルに書き込むことができ、複数のシンクが単一のチャネルから読み取ることができます。flume
用語

名前

説明

イベント

イベントは、Flume エージェントを通過するデータの基本単位です。イベントは、オプションのヘッダーマップとデータを含むバイト配列で構成されています。

以下に例を示します:

--------------------------------
| ヘッダー (Map) | ボディ (byte[]) |
--------------------------------
               Flume Event

ソース

ソースはデータコレクターです。外部データソースからデータを収集し、バッチで 1 つ以上のチャネルに送信します。

一般的なソースは、次のとおりです:

  • Avro ソース: Avro ポートをリッスンして、Avro クライアントから送信されたイベントを受信します。Avro は、データシリアル化のために Hadoop によって提供されるプロトコルです。

  • Exec ソース: tail -f /var/log/messages などのコマンドラインの出力をリッスンしてデータを取得します。

  • NetCat TCP ソース: 指定された TCP ポートをリッスンしてデータを取得します。Netcat UDP ソースに似ています。

  • Taildir ソース: ディレクトリ内の複数のファイルを監視し、オフセットを記録してデータ損失を防ぎます。このソースは一般的に使用されています。

チャネル

ソースとシンクの間のバッファーキューとして機能します。

一般的なチャネルは、次のとおりです:

  • Memory チャネル: データをメモリにキャッシュします。高いパフォーマンスを提供し、一般的に使用されています。

  • File チャネル: データをファイルにキャッシュします。チェックポイントファイルと DATA ファイルを記録し、高い信頼性を提供しますが、パフォーマンスは低くなります。

  • JDBC チャネル: データをリレーショナルデータベースにキャッシュします。

  • Kafka チャネル: Kafka を使用してデータをキャッシュします。

シンク

シンクはチャネルからイベントを取得し、トランザクションで外部ストレージにコミットします。トランザクションが正常にコミットされると、イベントはチャネルから削除されます。

一般的なシンクは、次のとおりです:

  • Logger シンク: テスト用です。

  • Avro シンク: データを Avro イベントに変換します。主に複数の Flume エージェントを接続するために使用されています。

  • HDFS シンク: HDFS にデータを書き込みます。このシンクは一般的に使用されています。

  • Hive シンク: Hive テーブルまたはパーティションにデータを書き込みます。Hive トランザクションを使用してイベントを書き込みます。

  • Kafka シンク: Kafka にデータを書き込みます。