Celeborn は中間データを処理し、ビッグデータエンジンの安定性、柔軟性、パフォーマンスを向上させます。このトピックでは、Celeborn サービスの使用方法について説明します。
背景情報
既存のシャッフルソリューションには、次のような欠点があります。
-
大量のデータを処理するシナリオでは、シャッフル書き込みによってデータスピルが発生し、書き込み増幅につながります。
-
シャッフル読み取りプロセスでは、大量の小さなネットワークパケットが接続リセットエラーを引き起こす可能性があります。
-
シャッフル読み取りプロセスでは、多数の小さな I/O リクエストとランダム読み取りが生成され、ディスクと CPU に高い負荷がかかります。
-
マッパー (M) とリデューサー (N) の数が数千に達すると、M × N の接続数によってジョブの完了がほぼ不可能になります。
-
NodeManager と Spark 外部シャッフルサービスは同じプロセスで実行されます。シャッフルデータ量が非常に大きい場合、NodeManager が頻繁に再起動され、YARN のスケジューリングが不安定になります。
Celeborn は、これらのシャッフルプロセスにおける問題に対処し、次の利点を提供します。
-
プル型シャッフルではなくプッシュ型シャッフルを使用して、マッパーのメモリ負荷を軽減します。
-
I/O 集約をサポートし、シャッフル読み取り接続数を M × N から N に削減し、ランダム読み取りをシーケンシャル読み取りに変換します。
-
2 レプリカメカニズムをサポートし、フェッチ失敗の確率を低減します。
-
コンピューティングとストレージの分離アーキテクチャをサポートし、シャッフルサービスを専用のハードウェア環境にデプロイして、コンピューティングクラスターから分離できます。
-
Spark on Kubernetes で実行する際に、ローカルディスクへの依存を排除します。
次の図は、Celeborn のアーキテクチャを示しています。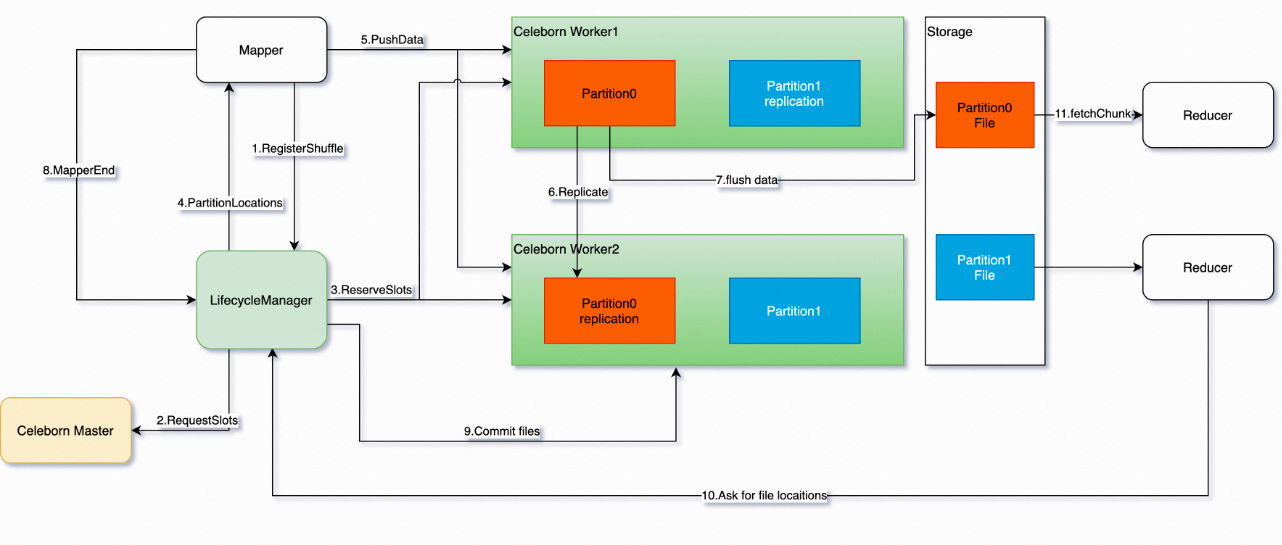
前提条件
EMR DataLake クラスターまたはカスタムクラスターを作成し、Celeborn サービスを選択している必要があります。クラスターの作成方法の詳細については、「クラスターの作成」をご参照ください。
制限事項
このトピックは、次のバージョンのクラスターにのみ適用されます。
|
クラスター |
バージョン |
|
DataLake クラスター |
EMR-3.45.0 以降、および EMR-5.11.0 以降 |
|
カスタムクラスター |
EMR-3.45.0 以降、および EMR-5.11.0 以降 |
操作手順
Spark の設定
|
パラメーター |
説明 |
|
spark.shuffle.manager |
|
|
spark.serializer |
値を org.apache.spark.serializer.KryoSerializer に設定する必要があります。 |
|
spark.celeborn.push.replicate.enabled |
2 レプリカメカニズムを有効にするかどうかを指定します。有効な値:
|
|
spark.shuffle.service.enabled |
Celeborn を使用するには、このパラメーターを false に設定します。 Celeborn を使用するには、既存の External Shuffle Service を無効にする必要があります。Celeborn が有効になっている場合、Spark の動的割り当て機能は期待どおりに動作します。 説明
|
|
spark.celeborn.shuffle.writer |
Celeborn は次のライターモードをサポートします。
|
|
spark.celeborn.master.endpoints |
エンドポイントを <celeborn-master-ip>:<celeborn-master-port> の形式で指定します。 パラメーター:
高可用性クラスターの場合、すべてのマスターノードの IP アドレスを設定します。 |
|
spark.sql.adaptive.enabled |
Celeborn は適応的クエリ実行 (AQE) をサポートします。最適なシャッフルパフォーマンスを得るには、ローカルシャッフルリーダーを無効にします。 これらのパラメーターをそれぞれ true、false、true に設定します。 |
|
spark.sql.adaptive.localShuffleReader.enabled |
|
|
spark.sql.adaptive.skewJoin.enabled |
Spark サービスは、Celeborn サービスを使用するためのワンクリック設定をサポートしています。
-
EMR-5.11.1 以降、および EMR-3.45.1 以降の場合:
Spark サービスの Status ページの サービスの概要 セクションで、[enableCeleborn] スイッチを切り替えることができます。
-
EMR-5.11.0 および EMR-3.45.0 の場合:
Spark サービスの Status ページの Components セクションで、SparkThriftServer を見つけます。[アクション] 列で、
 > [enableCeleborn] または > [disableCeleborn] を選択します。この操作により、上記の Spark 設定パラメーターが自動的に変更され、SparkThriftServer が再起動され、spark-defaults.conf ファイルと spark-thriftserver.conf ファイルの両方が更新されます。
-
> [enableCeleborn]を選択した場合、すべての Spark ジョブは Celeborn サービスを使用します。
-
> [Celeborn の無効化]を選択した場合、Spark ジョブで Celeborn サービスが使用されなくなります。
-
Celeborn の設定
Celeborn サービスの設定ページで、すべての Celeborn 設定パラメーターを表示および変更できます。
パラメーター値は、ノードグループ (CORE や TASK など) によって異なります。
|
パラメーター |
説明 |
デフォルト |
|
celeborn.worker.flusher.threads |
ディスク (HDD または SSD) にデータをフラッシュするスレッドの数。 |
|
|
CELEBORN_WORKER_OFFHEAP_MEMORY |
ワーカーのオフヒープメモリのサイズ。 |
クラスター設定に基づいて自動的に計算されます。 |
|
celeborn.application.heartbeat.timeout |
アプリケーションのハートビートタイムアウト。タイムアウトに達すると、システムはアプリケーションのリソースを解放します。 |
120 秒 |
|
celeborn.worker.flusher.buffer.size |
フラッシュバッファーサイズ。このサイズを超えると、フラッシュがトリガーされます。 |
256 KB |
|
celeborn.metrics.enabled |
モニタリングを有効にするかどうかを指定します。有効な値:
|
true |
|
CELEBORN_WORKER_MEMORY |
ワーカーのヒープメモリのサイズ。 |
1 GB |
|
CELEBORN_MASTER_MEMORY |
マスターのヒープメモリのサイズ。 |
2 GB |
Celeborn コンポーネントの再起動
-
Celeborn サービスの Status ページで、CelebornMaster コンポーネントのアクション列から
> [restart_clean_meta] を選択します。説明非高可用性クラスターでは、CelebornMaster コンポーネントのアクション列で再起動をクリックすることもできます。
-
ダイアログボックスで、Rolling Execution スイッチをオフにし、実行理由を入力して、OK をクリックします。
-
確認ダイアログボックスで、OK をクリックします。