Airflow GUI は、オープンソースの Airflow 上に構築された、DMS が提供するビジュアルオーケストレーションツールです。ドラッグアンドドロップインターフェイスを使用して Airflow Directed Acyclic Graph (DAG) タスクを作成および管理できるため、Python コードを記述する必要がありません。このトピックでは、Airflow GUI へのアクセス方法、グローバル設定とノードの構成方法、およびタスクの公開方法について説明します。
前提条件
Airflow 環境を設定済みです。Airflow 環境を設定する。
メールアラート機能を使用するには、まず Airflow でメールを構成する必要があります。カスタムメールサービスを使用するをご参照ください。
クイックスタート
機能エントリポイント
ワークスペースリストページで、ターゲットワークスペースの ID をクリックして開きます。
左側のナビゲーションウィンドウで、[リソースマネージャー] をクリックします。[CODE] モジュールの空白領域で右クリックし、[新規 Airflow ファイル] を選択します。
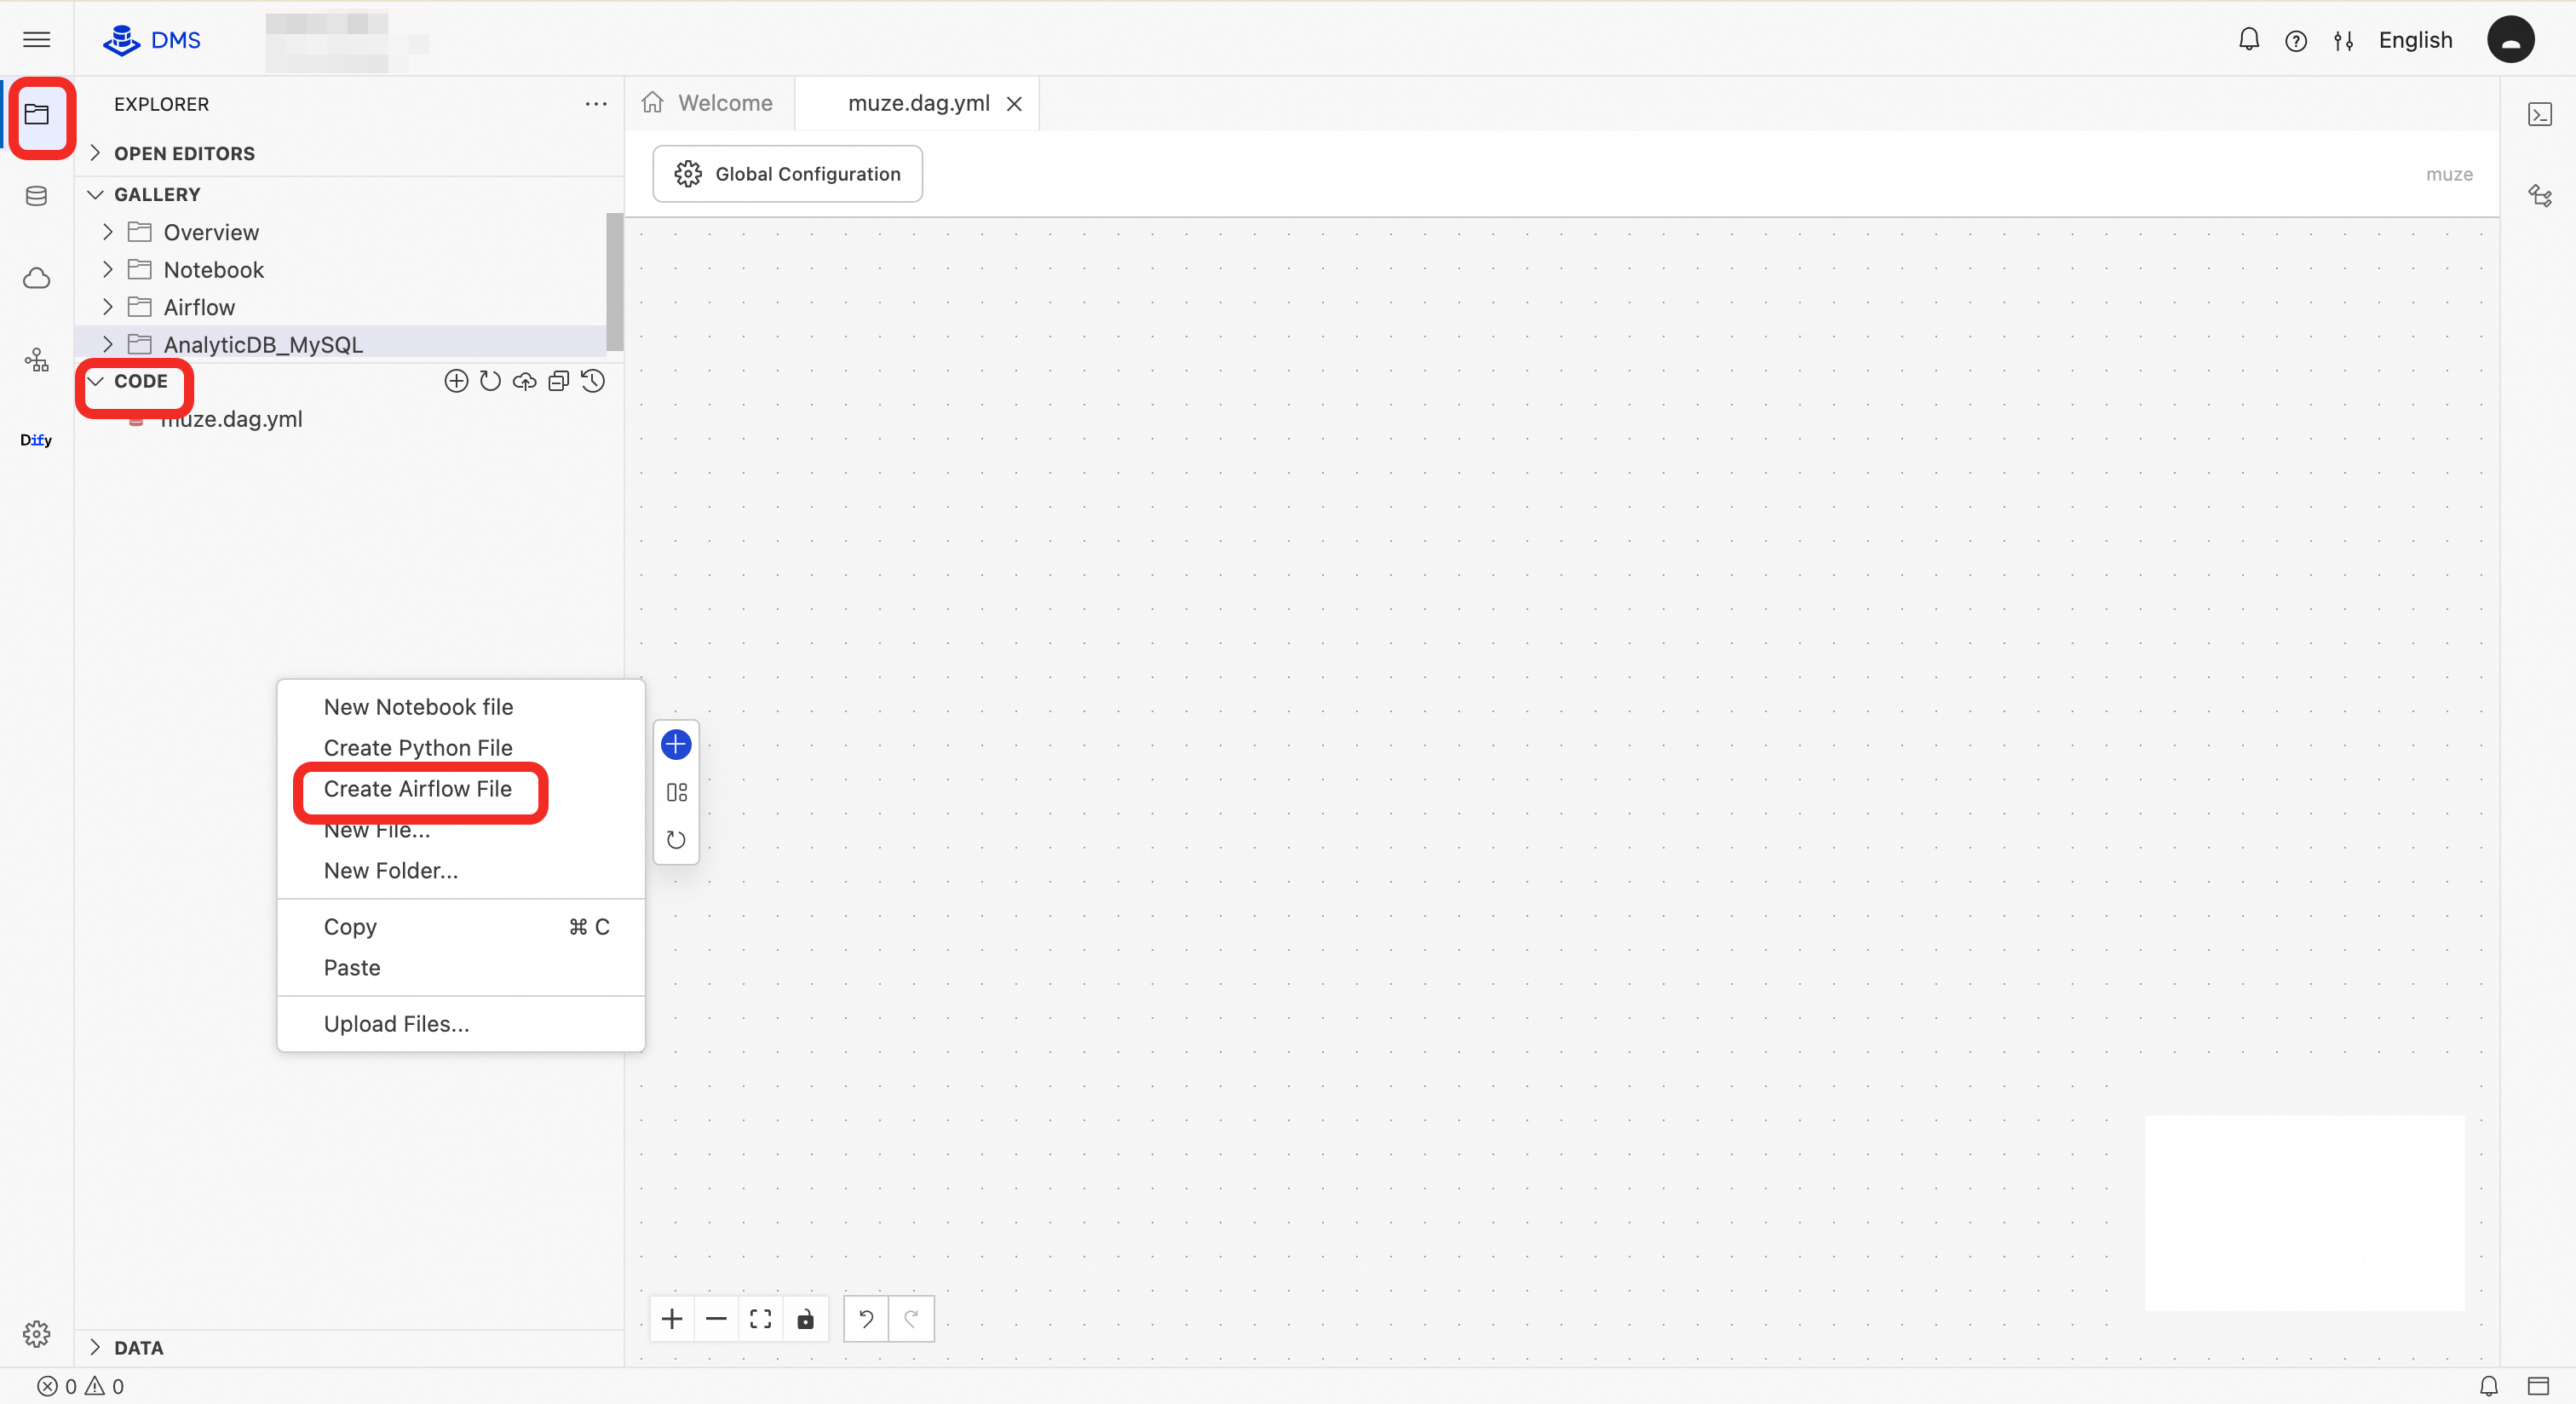
ワークフローキャンバスの概要
GUI エディターは、直感的なビジュアルキャンバスを提供します。
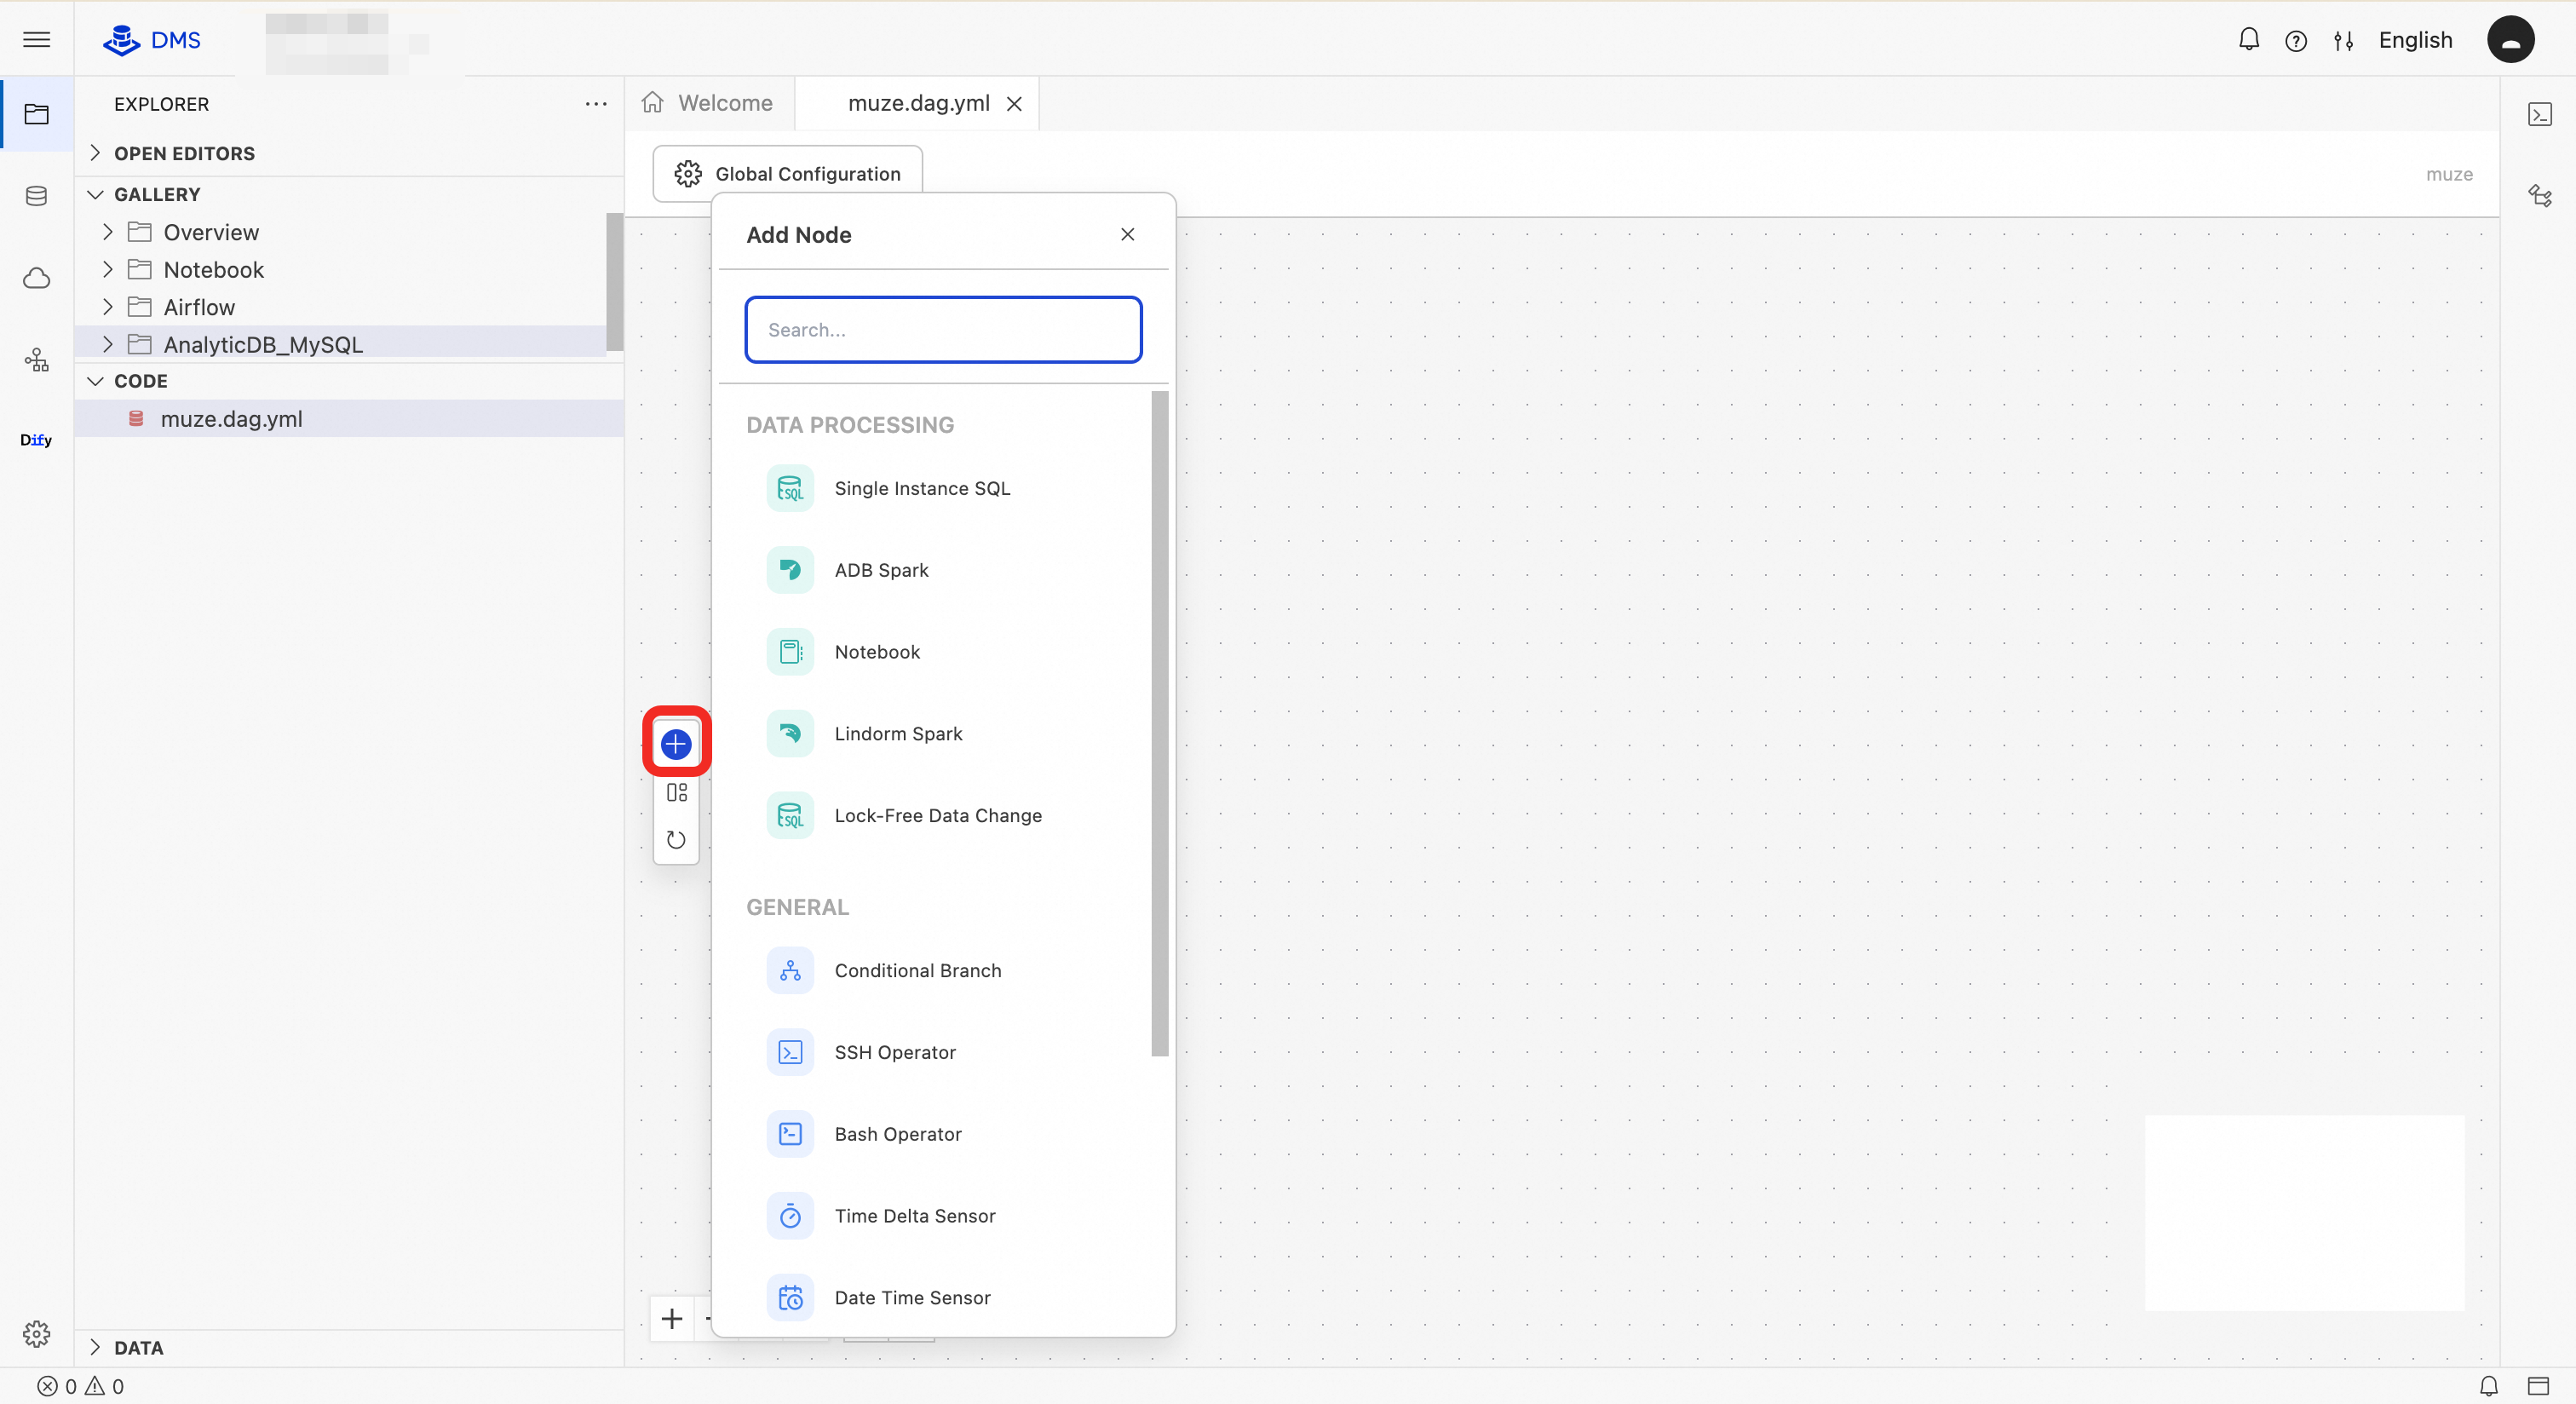
左側: ノードパネルです。
 ボタンをクリックして、さまざまなタイプのタスクノードを選択および追加できます。
中央: メインキャンバスです。ノードをドラッグし、依存関係を接続して、キャンバス上でワークフローを構築できます。
右側: 構成パネルです。ノードまたはキャンバス上の空白領域を選択すると、対応する設定項目がこのパネルに表示されます。
コア操作
グローバル構成: 右側のパネルで、DAG の名前、スケジューリングポリシー、アラートなどのグローバル設定を構成します。
ノードの追加と構成: 必要なノードを左側のパネルからキャンバスにドラッグし、右側のパネルで基本設定と詳細設定を構成します。
依存関係の設定: ノード間のアンカーポイントをドラッグして、アップストリームおよびダウンストリームの依存関係を確立します。
保存して公開: ワークフローを設計した後、それを Airflow 環境に保存して公開します。
主要概念と構成の詳細
グローバル設定
トップナビゲーションバーで、[グローバル構成] ボタンをクリックして、DAG のグローバル構成を表示します。
基本情報:
名前:Airflow の
DAG IDを指定します。この ID は、ご利用の Airflow 環境で一意である必要があります。
スケジューリング設定:
Cron Expression:DAG の定期的なスケジューリングポリシーを定義します。
開始/終了日:DAG をスケジュールできる期間を定義します。
アラート設定:
タスクの失敗、成功、またはリトライに対してメールアラートを構成します。複数のメールアドレスはコンマで区切ることができます。
前提条件:メールアラートを使用する前に、Airflow でメールサービスを構成する必要があります。
テンプレートのサポート:アラートのタイトルと本文は Jinja テンプレートをサポートしています。
dagやtiなどの組み込み変数を動的に挿入できます。メール本文は HTML 形式をサポートしています。
変数:
DAG 内のすべてのタスクで使用できるグローバル変数を定義します。変数値も Jinja テンプレートをサポートしています。
リトライ設定:
グローバルデフォルトの[リトライ回数]および[再試行間隔]を、失敗したタスクに対して設定できます。
ノード構成
左側のパネルから追加する各ノードには、基本構成と詳細構成があります。詳細構成はすべてのノードに共通ですが、基本構成はノードタイプによって異なります。
詳細構成 (一般)
アラート構成:グローバルアラート設定を上書きして、現在のノードの独立したアラートポリシーを定義します。
リトライ:グローバルリトライ設定を上書きして、現在のノードの独立したリトライポリシーを定義します。
リソースプール構成:タスクが実行される Airflow リソースプール (Pool) を指定して、タスクの同時実行を制御します。
トリガールール:「すべてのアップストリームタスクが成功」や「少なくとも1つのアップストリームタスクが成功」など、現在のタスクの実行条件を定義します。
基本構成 (ノードタイプ別)
次のセクションでは、いくつかの一般的なノードの基本構成について説明します。
Single-Instance SQL
機能:指定されたデータベースインスタンスで単一の SQL 文を実行します。
構成:インスタンスとデータベースを選択し、SQL 文を直接記述するか、ワークスペース内の既存の
.sqlファイルを選択します。コールバックコード (オプション):SQL 文が正常に実行された後に実行される Python コードを指定します。主な用途は次のとおりです。
データを受け渡す (XCom):組み込みの
result変数 (dataキーを含む辞書) を使用して SQL クエリ結果を取得し、結果をダウンストリームタスクに渡します。たとえば、result['data'][0]['co']は、結果セットの最初の行にあるcoという名前の列の値を取得します。結果の検証:SQL 結果をチェックします。条件が満たされない場合、例外をスローしてタスクを失敗させることができます。
if len(result["data"]) > 10:
    raise Exception("too many data")
ADB Spark
機能:AnalyticDB for MySQL の Spark エンジンにジョブを送信します。
構成:AnalyticDB for MySQL インスタンスとリソースグループを選択し、タスクタイプ (SQL または BATCH) に基づいてジョブを構成します。
SQL タスク:Spark SQL 文を直接記述するか、
.sqlファイルを選択します。BATCH タスク:Spark ジョブ構成を JSON 形式で提供します。
{
  "args": [
    "1000"
  ],
  "className": "org.apache.spark.examples.SparkPi",
  "comments": [
    "-- Here is just an example of SparkPi. Modify the content and run your spark program."
  ],
  "conf": {
    "spark.driver.resourceSpec": "medium",
    "spark.executor.instances": 2,
    "spark.executor.resourceSpec": "medium"
  },
  "file": "local:///tmp/spark-examples.jar",
  "name": "SparkPi"
}
Notebook
機能:ワークスペースで Notebook ファイルを実行します。
構成:
Notebook セッションを選択します。
Notebook ファイルのパスを選択します。ファイルはワークスペースで構成されている必要があり、パスはワークスペースファイルパスである必要があります。
Lindorm Spark
機能:Lindorm Spark ジョブを送信します。
構成:
Lindorm インスタンスを選択します。
ジョブタイプを選択し、ジョブパラメーターを構成します。
Lock-Free Data Change
機能:指定されたインスタンスとデータベースでロックフリー方式でデータ変更 SQL 文を実行します。構成方法は Single-Instance SQL ノードと同じです。このノードは、実行結果を処理するためのコールバックコードもサポートしています。
Conditional Branch
機能:異なる条件に基づいてワークフローパスを決定します。
構成:複数のブランチ条件を追加します。各条件は
TrueまたはFalseを返す Python 式です。式は Jinja テンプレートをサポートし、Airflow 変数を参照できます。Conditional Branch には複数のダウンストリームエッジがあります。エッジをドラッグアンドドロップして設定できます。
SSH Operations
機能:SSH 経由でリモートサーバーに接続し、コマンドを実行します。
構成:
Airflow の
Connectionsで SSH 接続情報を事前構成し、そのConnection IDを取得します。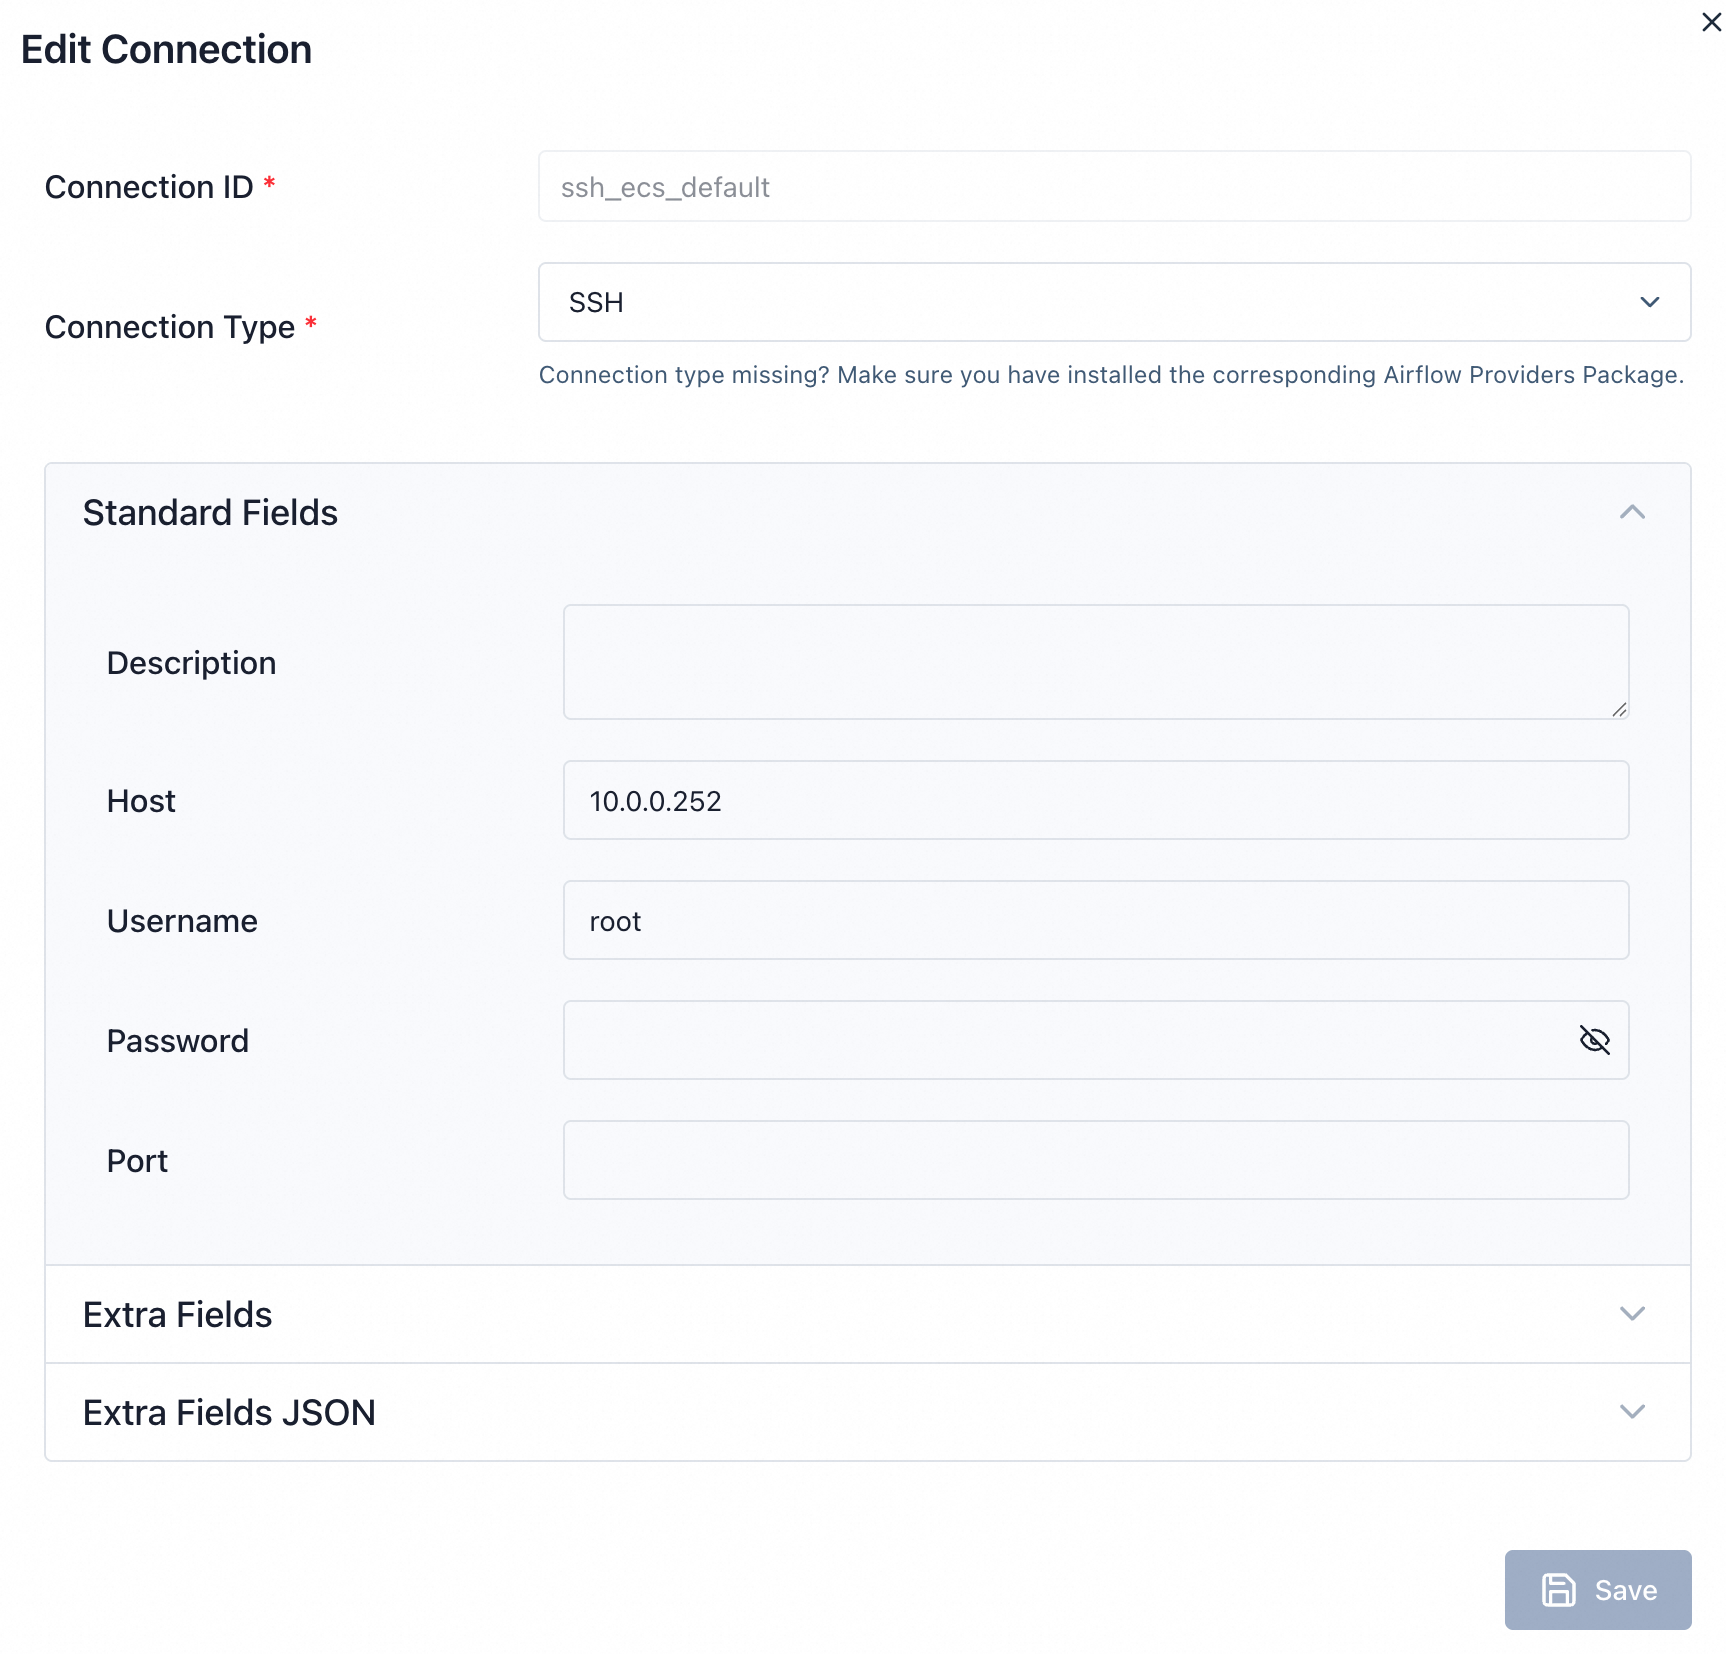
ノード構成で、
Connection IDと実行するシェルコマンドを入力します。
Bash Task
機能:ローカル環境で Bash コマンドを実行します。
構成:
実行する Bash コマンドを構成します。
コマンド実行の環境変数を構成します。
Time Interval
機能:指定された期間、ワークフローを一時停止し、その後、後続のノードの実行を続行します。
Wait for Specified Time
機能:指定された時間まで待機し、その後、後続のノードの実行を続行します。ターゲット時間は、Airflow Jinja テンプレート構文を使用して動的に設定できます。
External Task Sensor
機能:外部タスクの依存関係チェックを構成します。ワークフローは、同じ Airflow インスタンス内の外部 DAG またはタスクが完了するまで待機し、その後、実行を続行します。
構成:
アップストリーム DAG 名:現在の DAG が依存する DAG の ID です。
アップストリームノード名 (オプション):現在のタスクが依存するタスクの ID です。このパラメーターを空のままにすると、ワークフローはアップストリーム DAG 全体が完了するまで待機します。
Empty Task
機能:何も操作を実行しないプレースホルダーノードです。複数のアップストリームブランチを集約したり、ワークフロー構造を明確化するための論理的な開始点または終了点として使用できます。
構成:なし。
Data Lake Integration
機能:ソースデータベースからターゲットデータレイクにデータを統合します。
構成:
ソースデータベースとターゲットデータベースを選択します。
データ統合タスクのその他のパラメーターを構成します。
依存関係の設定
依存関係の追加:マウスポインターをノードのエッジに重ねると、アンカーポイントが表示されます。アンカーポイントをあるノードから別のノードにドラッグして、依存関係を表すエッジを作成します。
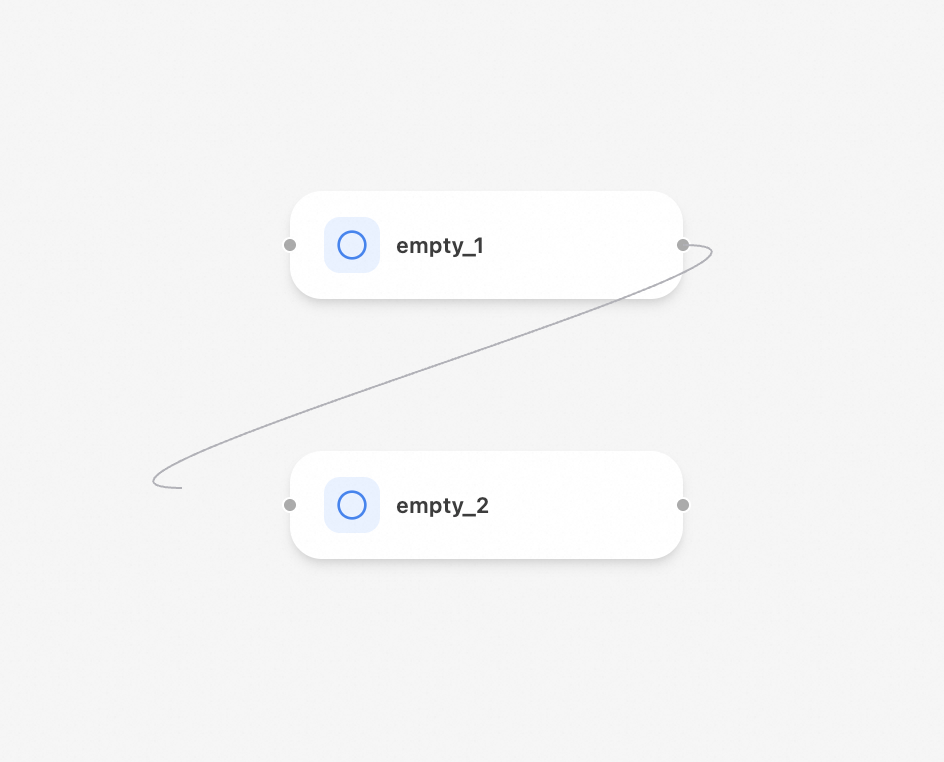
依存関係の削除:エッジをクリックして選択し、
Deleteキーを押します。
公開と検証
Git 統合 (オプション)
ご利用のワークスペースが Git リポジトリに関連付けられている場合、コードを公開する前に Git にコミットする必要があります。
コミット:Git パネルで変更をコミットします。
プッシュ:コミットをリモートリポジトリにプッシュします。
Airflow へのデプロイ
エディターの右上隅にある [デプロイ ボタン] をクリックします。システムは、GUI で設計したワークフローを Python コードに変換し、そのコードを Airflow 環境に公開します。

Airflowで確認
デプロイメントが成功した後、Airflow UI にログインします。新しい DAG が表示されます。新しい DAG の DAG ID は、GUI で構成した名前と同じです。この DAG には generated タグも付いており、これは DAG が GUI によって生成されたことを示します。Airflow UI で DAG の実行をトリガー、モニター、管理できます。