DataWorks OpenAPI (2024-05-18) を使用して、テーブルとカラムのデータリネージをプログラムでクエリする方法を説明します。このトピックでは、自動化された大規模なリネージ分析のための API 呼び出しの例と SDK コードを紹介します。
基本概念
四半期売上が大幅に増加したことを示すビジネスレポートを確認しているとします。データアナリストまたはマネージャーとして、次のような疑問が生じるかもしれません:
-
この「売上」メトリクスは、どのように計算されていますか?
-
その生のビジネスデータのソースは何ですか?注文テーブルですか、それとも支払いトランザクションテーブルですか?
-
データは生の状態から最終レポートに至るまで、クリーニング、変換、集約など、どのような処理ステップを経ていますか?
-
このメトリクスのデータが正しくない場合、どのダウンストリームのレポートやアプリケーションが影響を受けますか?
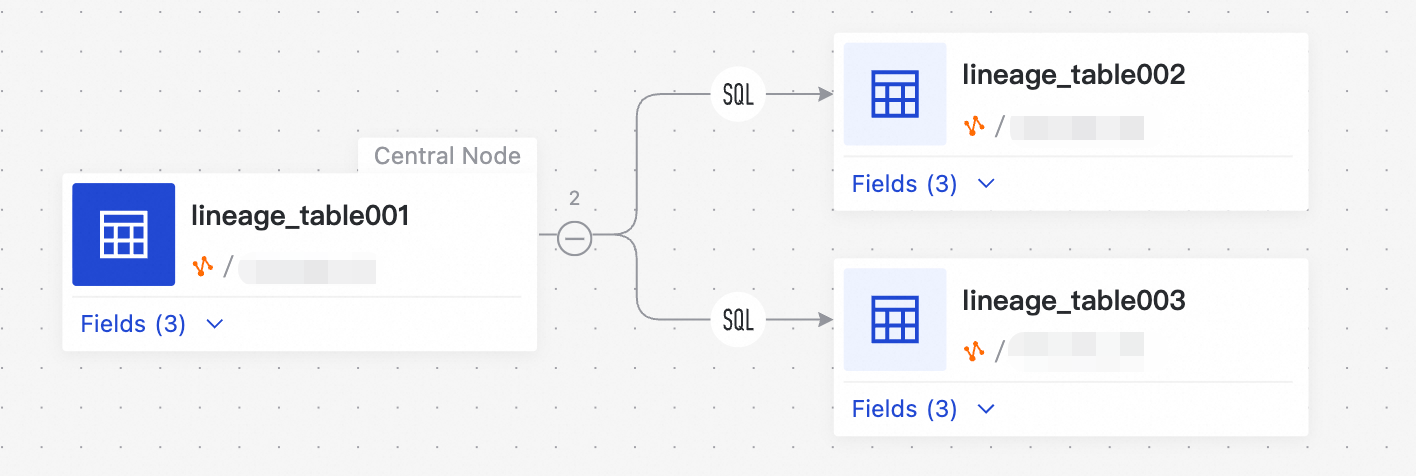
明確なデータリネージは、以下の主要な利点をもたらします:
-
データの追跡とトラブルシューティング
データの異常やエラーを発見した場合、データリネージをアップストリームにたどることで、問題の原因となった計算ロジックやソースデータを迅速に特定できます。これにより、トラブルシューティングの時間が大幅に短縮されます。 -
影響分析
データテーブルの構造、カラム、または計算ロジックを変更する必要がある場合、ダウンストリームリネージを分析して、どのデータやビジネスレポートが影響を受けるかを正確に評価できます。これにより、変更による予期せぬ結果を回避できます。 -
データガバナンスと信頼性
明確なデータリネージは、データ資産管理、データ標準の実装、データ品質監視の基盤です。これにより、データのライフサイクルが透明になり、データに対するステークホルダーの信頼が高まります。 -
コスト最適化と資産インベントリ
データリネージを分析することで、ダウンストリームで利用されていないデータテーブルやコンピューティングタスクを特定できます。これにより、データウェアハウスのコストを最適化し、不要になった資産を整理できます。
DataWorks は、MaxCompute SQL や EMR Spark などのコンピューティングタスクからリネージを自動的に解析し、記録します。DataWorks OpenAPI を使用すると、このリネージにプログラムでアクセスして、リネージ分析をデータ管理プラットフォームや自動化された O&M ワークフローに統合できます。
前提条件:エンティティ ID の取得
データリネージをクエリするには、対象のテーブルまたはカラムの一意の識別子が必要です。この エンティティ ID は、すべてのメタデータおよびリネージ関連の API 呼び出しに必要です。
エンティティ ID は、以下のいずれかの方法で取得できます。
1. コンソールからのエンティティ ID の取得
少数の既知のテーブルやカラムの場合、コンソールから直接 ID をコピーするのが最も速い方法です。
テーブルのエンティティ ID の取得
-
DataWorks コンソールで、**[データマップ]** モジュールに移動します。
-
対象のテーブルを検索し、その詳細ページに移動します。
-
左側のテーブルの基本情報 パネルで、エンティティID を探し、コピーします。
エンティティ ID の形式は
maxcompute-table:::<project_name>::<table_name>です。
カラムのエンティティ ID の取得
-
対象テーブルの詳細ページで、[リネージ] タブに切り替え、[カラムリネージ] を選択します。
-
カラムリネージグラフで、調査したいカラムノードをクリックします。
-
右側に詳細パネルが表示されます。パネルでエンティティIDを見つけ、コピーします。
エンティティ ID の形式は
maxcompute-column:::<project_name>::<table_name>::<column_name>です。
2. API を使用したエンティティ ID の一括取得
一括取得の場合は、手動での検索ではなく OpenAPI を使用します。
-
テーブル ID の一括取得:
ListTablesAPI を呼び出します。詳細については、「ListTables」をご参照ください。 -
カラム ID の一括取得:
ListColumnsAPI を呼び出します。詳細については、「ListColumns」をご参照ください。
ListLineages API によるリネージのクエリ
エンティティ ID を取得した後、ListLineages API を呼び出して、アップストリームリネージとダウンストリームリネージをクエリします。
1. 主要なパラメータ
ListLineages API の主要なリクエストパラメータを以下に示します。OpenAPI Portal で API をオンラインでデバッグすることもできます。
|
パラメータ |
タイプ |
説明 |
|
|
String |
ダウンストリームリネージのクエリに使用します。ソース (アップストリーム) のエンティティ ID を渡すと、API はそのエンティティのすべてのダウンストリームリネージを返します。 |
|
|
String |
アップストリームリネージのクエリに使用します。デスティネーション (ダウンストリーム) のエンティティ ID を渡すと、API はそのエンティティのすべてのアップストリームリネージを返します。 |
|
|
String |
|
|
|
String |
|
|
|
Boolean |
レスポンスに詳細なリネージ関係情報を含めるかどうか。完全なコンテキストを取得するには、 |
-
If you specify both
SrcEntityIdandDstEntityId, the API returns the lineage relationship between the specified upstream and downstream entities. -
If
SrcEntityIdandDstEntityIdare the same ID, the API returns the self-referencing lineage relationship of that entity.
2. 例
エンティティ ID が maxcompute-table:::test_project::test_table の MaxCompute テーブルがあるとします。
例1:テーブルのダウンストリームリネージのクエリ
このテーブルのすべてのダウンストリームテーブルをクエリするには、このテーブルをソースとして指定します。
-
SrcEntityId:maxcompute-table:::test_project::test_table -
NeedAttachRelationship:true
名前に "report" を含む下流テーブルのみを検索するには、DstEntityName パラメーターを追加します:
-
DstEntityName:report
例2:テーブルのアップストリームリネージのクエリ
どのテーブルまたはタスクがこのテーブルを生成するかをクエリするには、このテーブルをデスティネーションとして指定します。
-
DstEntityId:maxcompute-table:::test_project::test_table -
NeedAttachRelationship:true
同様に、SrcEntityName パラメーターを使用してアップストリームソースをフィルターできます。
3. API レスポンスの理解
ListLineages の呼び出しが成功すると、それぞれにソースエンティティ、宛先エンティティ、およびそれらの関連付けの詳細を含むリネージ関係のリストが返されます。
単一のリネージ関係におけるレスポンスのサンプル (JSON):
{
  "SrcEntity": {
    "Id": "maxcompute-table:::test_project::table_from",
    "Name": "table_from",
    "Attributes": {
      "rawEntityId": "maxcompute-table:::test_project::table_from"
    }
  },
  "DstEntity": {
    "Id": "maxcompute-table:::test_project::table_to",
    "Name": "table_to",
    "Attributes": {
      "project": "test_project",
      "region": "cn-shanghai",
      "table": "table_to"
    }
  },
  "Relationships": [
    {
      "Id": "123456789:maxcompute-table.test_project.table_from:maxcompute-table.test_project.table_to:maxcompute.SQL.76543xxx",
      "CreateTime": 1761089163548,
      "Task": {
        "Id": "76543xxx",
        "Type": "dataworks-sql",
        "Attributes": {
          "engine": "maxcompute",
          "channel": "1st",
          "taskInstanceId": "12345xxx",
          "projectId": "123456",
          "taskId": "76543xxx"
        }
      }
    }
  ]
}
レスポンスの解釈:
-
SrcEntityとDstEntityは、それぞれリネージの上流エンティティと下流エンティティを表します。これらのエンティティのIdを使用して GetTable API または GetColumn API を呼び出すと、より詳細なメタデータを取得できます。 -
Relationships:SrcEntityとDstEntityがどのように関連付けられているかを記述します。-
Task: このリネージ関係を生成したタスクを示します。 これが DataWorks のスケジュールされたタスクである場合、Task.AttributesにはtaskIdとtaskInstanceIdが含まれます。 これらの ID を使用して GetTask API を呼び出し、タスクの詳細な定義と実行ステータスを取得できます。
-
Java SDK のウォークスルー
この例では、Java SDK を使用して、完全なリネージクエリワークフローを実装します。
1. 環境の準備
-
JDK バージョン: JDK 8 以降がインストールされていることを確認してください。
-
Maven 依存関係: プロジェクトの
pom.xmlファイルに次の依存関係を追加します。${latest.version}を最新の SDK バージョン に置き換えます。
<dependency>
    <groupId>com.aliyun</groupId>
    <artifactId>dataworks_public20240518</artifactId>
    <version>${latest.version}</version>
</dependency>
2. 完全なコード例
このコードは、クライアントを初期化し、指定されたテーブルのアップストリームリネージとダウンストリームリネージをクエリし、主要な情報を出力します。
import java.util.List;
import java.util.Map;
import com.aliyun.dataworks_public20240518.Client;
import com.aliyun.dataworks_public20240518.models.GetTableRequest;
import com.aliyun.dataworks_public20240518.models.GetTableResponse;
import com.aliyun.dataworks_public20240518.models.LineageEntity;
import com.aliyun.dataworks_public20240518.models.LineageRelationship;
import com.aliyun.dataworks_public20240518.models.LineageTask;
import com.aliyun.dataworks_public20240518.models.ListLineagesRequest;
import com.aliyun.dataworks_public20240518.models.ListLineagesResponse;
import com.aliyun.dataworks_public20240518.models.ListLineagesResponseBody.ListLineagesResponseBodyPagingInfo;
import com.aliyun.dataworks_public20240518.models.ListLineagesResponseBody.ListLineagesResponseBodyPagingInfoLineages;
import com.aliyun.dataworks_public20240518.models.Table;
import com.aliyun.tea.TeaException;
public class LineageQuerySample {
  /**
     * <b>description</b> :
     * <p>資格情報を使用してクライアントを初期化します。</p>
     *
     * @return Client
     * @throws Exception
     */
  public static com.aliyun.dataworks_public20240518.Client createClient() throws Exception {
    com.aliyun.teaopenapi.models.Config config = new com.aliyun.teaopenapi.models.Config()
      // お使いの AccessKey ID
      .setAccessKeyId(System.getenv("ALIBABA_CLOUD_ACCESS_KEY_ID"))
      // お使いの AccessKey Secret
      .setAccessKeySecret(System.getenv("ALIBABA_CLOUD_ACCESS_KEY_SECRET"));
    // エンドポイントについては、https://api.alibabacloud.com/product/dataworks-public をご参照ください
    config.endpoint = "dataworks.cn-hangzhou.aliyuncs.com";
    return new com.aliyun.dataworks_public20240518.Client(config);
  }
  public static void main(String[] args_) throws Exception {
    Client client = LineageQuerySample.createClient();
    // クエリ対象のテーブルのエンティティ ID。クエリしたい MaxCompute テーブルのエンティティ ID に置き換えてください。
    String tableId = "maxcompute-table:::test_project::test_table";
    try {
      // 1. アップストリームリネージのクエリ
      ListLineagesRequest listLineagesRequest = new ListLineagesRequest()
        .setDstEntityId(tableId)
        .setNeedAttachRelationship(true)
        .setPageNumber(1)
        // 1ページあたりのデフォルトのレコード数は 10 です。最大値は 100 です。
        .setPageSize(10);
      // テーブル名でのキーワードマッチングにより、アップストリームテーブルをフィルタリングします
      listLineagesRequest.setSrcEntityName("demo");
      ListLineagesResponse listLineagesResponse = client.listLineages(listLineagesRequest);
      String requestId = listLineagesResponse.getBody().getRequestId();
      System.out.println("\nQuery upstream lineage");
      // トラブルシューティングのためにリクエスト ID を出力します
      System.out.println(requestId);
      ListLineagesResponseBodyPagingInfo pagingInfo = listLineagesResponse.getBody().getPagingInfo();
      if (pagingInfo.getTotalCount() > 0 && pagingInfo.getLineages() != null) {
        for (ListLineagesResponseBodyPagingInfoLineages lineage : pagingInfo.getLineages()) {
          // 単一のリネージレコードを取得し、対応するアップストリームテーブルをクエリします
          LineageEntity srcEntity = lineage.getSrcEntity();
          System.out.println("============================================");
          System.out.println("ID: " + srcEntity.getId());
          System.out.println("Name: " + srcEntity.getName());
          // アップストリームテーブルの情報を取得します
          Table table = getTable(client, srcEntity.getId());
          if (table != null) {
            System.out.println("Comment: " + table.getComment());
            System.out.println("Create Time: " + table.getCreateTime());
            System.out.println("Modify Time: " + table.getModifyTime());
          }
        }
      }
            // 2. ダウンストリームリネージのクエリ
            listLineagesRequest = new ListLineagesRequest()
                    .setSrcEntityId(tableId)
                    .setNeedAttachRelationship(true)
                    .setPageNumber(1)
                    // 1ページあたりのデフォルトのレコード数は 10 です。最大値は 100 です。
                    .setPageSize(10);
            listLineagesResponse = client.listLineages(listLineagesRequest);
            requestId = listLineagesResponse.getBody().getRequestId();
            System.out.println("\nQuery downstream lineage");
            // トラブルシューティングのためにリクエスト ID を出力します
            System.out.println(requestId);
            pagingInfo = listLineagesResponse.getBody().getPagingInfo();
            if (pagingInfo.getTotalCount() > 0 && pagingInfo.getLineages() != null) {
                for (ListLineagesResponseBodyPagingInfoLineages lineage : pagingInfo.getLineages()) {
                    // 単一のリネージレコードを取得し、対応するダウンストリームテーブルをクエリします
                    LineageEntity dstEntity = lineage.getDstEntity();
                    System.out.println("============================================");
                    System.out.println("ID: " + dstEntity.getId());
                    System.out.println("Name: " + dstEntity.getName());
                    // ダウンストリームテーブルの情報を取得します
                    Table table = getTable(client, dstEntity.getId());
                    if (table != null) {
                        System.out.println("Comment: " + table.getComment());
                        System.out.println("Create Time: " + table.getCreateTime());
                        System.out.println("Modify Time: " + table.getModifyTime());
                    }
                    // リネージ関係を解析します
                    List<LineageRelationship> relationships = lineage.getRelationships();
                    if (relationships != null) {
                        for (LineageRelationship relationship : relationships) {
                            System.out.println("\n\tRelationshipId: " + relationship.getId());
                            System.out.println("\tRelationshipCreateTime: " + relationship.getCreateTime());
                            // タスク詳細を解析します
                            LineageTask task = relationship.getTask();
                            Map<String, String> attributes = task.getAttributes();
                            // DataWorks のスケジュールタスクの場合、属性からタスク ID とタスクインスタンス ID を取得できます
                            if (attributes != null && attributes.containsKey("taskId") && attributes.containsKey("taskInstanceId")) {
                                System.out.println("\tTaskId: " + attributes.get("taskId"));
                                System.out.println("\tTaskInstanceId: " + attributes.get("taskInstanceId"));
                            }
                        }
                    }
                }
            }
        } catch (TeaException error) {
            // これはデモンストレーション用です。本番環境では例外を無視せず、慎重に処理してください。
            // エラーメッセージ
            System.out.println(error.getMessage());
            // 診断 URL
            System.out.println(error.getData().get("Recommend"));
            com.aliyun.teautil.Common.assertAsString(error.message);
        } catch (Exception _error) {
            TeaException error = new TeaException(_error.getMessage(), _error);
            // これはデモンストレーション用です。本番環境では例外を無視せず、慎重に処理してください。
            // エラーメッセージ
            System.out.println(error.getMessage());
            // 診断 URL
            System.out.println(error.getData().get("Recommend"));
            com.aliyun.teautil.Common.assertAsString(error.message);
        }
    }
    public static Table getTable(Client client, String tableId) {
        // ID でテーブル情報をクエリします
        GetTableRequest getTableRequest = new GetTableRequest()
                .setId(tableId)
                .setIncludeBusinessMetadata(true);
        try {
            GetTableResponse getTableResponse = client.getTable(getTableRequest);
            return getTableResponse.getBody().getTable();
        } catch (Exception e) {
            System.out.println(e.getMessage());
        }
        return null;
    }
}
Python SDK のウォークスルー
この例では、Python SDK を使用して、完全なリネージクエリワークフローを実装します。
1. 環境の準備
-
Python バージョン: Python 3.6 以降がインストールされていることを確認してください。
-
SDK のインストール: pip を使用して DataWorks Python SDK をインストールします。
${latest.version}は、最新の SDK バージョン に置き換えてください。
pip install alibabacloud_dataworks_public20240518==${latest.version}2. 完全なコード例
このコードは、クライアントを初期化し、指定されたテーブルのアップストリームリネージとダウンストリームリネージをクエリし、主要な情報を出力します。
# -*- coding: utf-8 -*-
import os
import sys
from alibabacloud_dataworks_public20240518.client import Client as dataworks_public20240518Client
from alibabacloud_tea_openapi import models as open_api_models
from alibabacloud_dataworks_public20240518 import models as dataworks_public_20240518_models
from alibabacloud_tea_util import models as util_models
from alibabacloud_tea_util.client import Client as UtilClient


class LineageQuerySample:

    @staticmethod
    def create_client():
        """AccessKey を使用してクライアントを初期化します。"""
        config = open_api_models.Config(
            # お使いの AccessKey ID
            access_key_id=os.environ.get('ALIBABA_CLOUD_ACCESS_KEY_ID'),
            # お使いの AccessKey Secret
            access_key_secret=os.environ.get('ALIBABA_CLOUD_ACCESS_KEY_SECRET')
        )
        # エンドポイントについては、https://api.alibabacloud.com/product/dataworks-public をご参照ください
        config.endpoint = 'dataworks.cn-hangzhou.aliyuncs.com'
        return dataworks_public20240518Client(config)

    @staticmethod
    def get_table(client, table_id):
        """エンティティ ID でテーブル情報を取得します。"""
        get_table_request = dataworks_public_20240518_models.GetTableRequest(
            id=table_id,
            include_business_metadata=True
        )
        try:
            response = client.get_table(get_table_request)
            return response.body.table
        except Exception as e:
            print(e)
            return None

    @staticmethod
    def main():
        client = LineageQuerySample.create_client()
        # クエリ対象のテーブルのエンティティ ID。クエリしたい MaxCompute テーブルのエンティティ ID に置き換えてください。
        table_id = 'maxcompute-table:::test_project::test_table'
        runtime = util_models.RuntimeOptions()

        try:
            # 1. アップストリームリネージのクエリ
            upstream_request = dataworks_public_20240518_models.ListLineagesRequest(
                dst_entity_id=table_id,
                need_attach_relationship=True,
                page_number=1,
                # 1ページあたりのデフォルトのレコード数は 10 です。最大値は 100 です。
                page_size=10,
                # テーブル名でのキーワードマッチングにより、アップストリームテーブルをフィルタリングします
                src_entity_name='demo'
            )
            upstream_response = client.list_lineages_with_options(upstream_request, runtime)
            print('\nQuery upstream lineage')
            print(upstream_response.body.request_id)
            paging_info = upstream_response.body.paging_info
            if paging_info.total_count > 0 and paging_info.lineages:
                for lineage in paging_info.lineages:
                    src_entity = lineage.src_entity
                    print('============================================')
                    print(f'ID: {src_entity.id}')
                    print(f'Name: {src_entity.name}')
                    table = LineageQuerySample.get_table(client, src_entity.id)
                    if table:
                        print(f'Comment: {table.comment}')
                        print(f'Create Time: {table.create_time}')
                        print(f'Modify Time: {table.modify_time}')

            # 2. ダウンストリームリネージのクエリ
            downstream_request = dataworks_public_20240518_models.ListLineagesRequest(
                src_entity_id=table_id,
                need_attach_relationship=True,
                page_number=1,
                page_size=10
            )
            downstream_response = client.list_lineages_with_options(downstream_request, runtime)
            print('\nQuery downstream lineage')
            print(downstream_response.body.request_id)
            paging_info = downstream_response.body.paging_info
            if paging_info.total_count > 0 and paging_info.lineages:
                for lineage in paging_info.lineages:
                    dst_entity = lineage.dst_entity
                    print('============================================')
                    print(f'ID: {dst_entity.id}')
                    print(f'Name: {dst_entity.name}')
                    table = LineageQuerySample.get_table(client, dst_entity.id)
                    if table:
                        print(f'Comment: {table.comment}')
                        print(f'Create Time: {table.create_time}')
                        print(f'Modify Time: {table.modify_time}')
                    # リネージ関係を解析します
                    if lineage.relationships:
                        for relationship in lineage.relationships:
                            print(f'\n\tRelationshipId: {relationship.id}')
                            print(f'\tRelationshipCreateTime: {relationship.create_time}')
                            task = relationship.task
                            attributes = task.attributes
                            if attributes and 'taskId' in attributes and 'taskInstanceId' in attributes:
                                print(f'\tTaskId: {attributes["taskId"]}')
                                print(f'\tTaskInstanceId: {attributes["taskInstanceId"]}')

        except Exception as error:
            # これはデモンストレーション用です。本番環境では例外を無視せず、慎重に処理してください。
            print(error)
            UtilClient.assert_as_string(str(error))


if __name__ == '__main__':
    LineageQuerySample.main()