Container Compute Service (ACS) 向けの training-nv-pytorch 25.11 AI コンテナイメージは、コアとなるトレーニングおよび推論コンポーネントがアップグレードされ、CUDA 13.0.2 イメージおよび CUDA 12.8 イメージとして利用可能です。GPU ノード用のイメージを選択する前に、コンポーネントのバージョン、ドライバー要件、および使用制限を確認してください。
本リリースでの変更点
機能とアップグレード
アーキテクチャと CUDA のサポート — リリース 25.11 は、amd64 および aarch64 アーキテクチャと、CUDA 13.0.2 と CUDA 12.8 の両方をサポートするとともに。
PyTorch — CUDA 13.0.2 イメージでは、PyTorch がコミュニティのリリースに合わせて 2.9 にアップグレードされました。
コアトレーニングコンポーネント — コミュニティのリリースに合わせて、Transformers は 4.57.1 に、DeepSpeed は 0.18.1 に、TransformerEngine は 2.9.0 にアップグレードされ、Qwen3-VL がサポートされるようになりました。
コア推論コンポーネント — vLLM は 0.11.2 にアップグレードされました。
アーキテクチャのサポートとコンポーネントのバージョンは、2 つのイメージバリアントで異なります。詳細については、「イメージのバリアントと仕様」をご参照ください。
バグ修正
このリリースでは修正されたバグはありません。
イメージのバリアントと仕様
リリース 25.11 は 2 つのイメージバリアントを提供します。ノードにインストールされている NVIDIA ドライバーのリリース、ノードの CPU アーキテクチャ、およびワークロードで FlashAttention 3 (fa3) が必要かどうかに基づいてバリアントを選択してください。次の表に、各バリアントの仕様を示します。
項目 | CUDA 13.0.2 イメージ | CUDA 12.8 イメージ |
一般的なシナリオ | トレーニングと推論 | トレーニング/推論 |
フレームワーク | PyTorch | PyTorch |
NVIDIA ドライバーリリース | 580 以降 | 575 以降 |
アーキテクチャ | amd64 および aarch64 | amd64 |
CUDA 13.0.2 イメージで fa3 を直接コンパイルするとエラーが発生します。ワークロードで fa3 が必要な場合は、flash_attn_3 3.0.0b1 を含む CUDA 12.8 イメージをご検討ください。詳細については、「既知の問題」をご参照ください。
CUDA 13.0.2 イメージのコアコンポーネント
Ubuntu: 24.04
Python: 3.12.7+gc
CUDA: 13.0
perf: 5.4.30
gdb: 15.0.50
torch: 2.9.0+ali.10.nv25.10
triton: 3.5.0
transformer_engine: 2.9.0+70f53666
deepspeed: 0.18.1+ali
flash_attn: 2.8.3
transformers: 4.57.1+ali
grouped_gemm: 1.1.4
accelerate: 1.11.0+ali
diffusers: 0.34.0
mmengine: 0.10.3
mmcv: 2.1.0
mmdet: 3.3.0
opencv-python-headless: 4.11.0.86
ultralytics: 8.3.96
timm: 1.0.22
vllm: 0.11.2+cu130
flashinfer-python: 0.5.2
pytorch-dynamic-profiler: 0.24.11
peft: 0.16.0
ray: 2.52.0
megatron-core: 0.14.0
CUDA 12.8 イメージのコアコンポーネント
Ubuntu: 24.04
Python: 3.12.7+gc
CUDA: 12.8
perf: 5.4.30
gdb: 15.0.50
torch: 2.8.0.9+nv25.3
triton: 3.4.0
transformer_engine: 2.9.0
deepspeed: 0.18.1+ali
flash_attn: 2.8.3
flash_attn_3: 3.0.0b1
transformers: 4.57.1+ali
grouped_gemm: 1.1.4
accelerate: 1.11.0+ali
diffusers: 0.34.0
mmengine: 0.10.3
mmcv: 2.1.0
mmdet: 3.3.0
opencv-python-headless: 4.11.0.86
ultralytics: 8.3.96
timm: 1.0.22
vllm: 0.11.2
flashinfer-python: 0.5.2
pytorch-dynamic-profiler: 0.24.11
peft: 0.16.0
ray: 2.52.0
megatron-core: 0.14.0
パフォーマンスの最適化
PyTorch コンパイルの最適化
PyTorch 2.0 で導入された torch.compile() は、小規模なシングル GPU のワークロードで大きな効果を発揮することがよくあります。しかし、LLM のトレーニングは GPU メモリの最適化と FSDP や DeepSpeed などの分散フレームワークに依存するため、torch.compile() では限定的な利点しか得られないか、パフォーマンスを低下させる可能性があります。
-
DeepSpeed フレームワークでの通信粒度の制御。これにより、コンパイラがより完全な計算グラフをキャプチャし、より広範なコンパイル最適化を適用できます。
-
最適化された PyTorch ビルドの使用:
-
PyTorch コンパイラのフロントエンドが改善され、計算グラフでグラフブレークが発生した場合でもコンパイルが成功するようになりました。
-
パターンマッチングと動的シェイプのサポートが強化され、コンパイル後のパフォーマンスが向上しました。
-
これらの最適化により、8B パラメーターの LLM トレーニングでは、通常、エンドツーエンドのスループットが約 20% 向上します。
再計算のための GPU メモリの最適化
大規模なパフォーマンスデータ (さまざまなモデル、クラスター、トレーニングパラメーター設定、ベンチマーク中に収集された GPU メモリ使用率などのシステムメトリクスを含む) に基づいて構築された GPU メモリオーバーヘッドの予測モデルは、最適なアクティベーション再計算レイヤー数を推奨します。このアプローチは PyTorch に統合されており、最小限の労力で GPU メモリの最適化によるパフォーマンス向上を実現できます。この機能は、DeepSpeed フレームワークでサポートされるようになりました。
アセット
パブリックイメージ
次の表に、各 25.11 イメージバリアントのアセット URI を示します。
イメージバリアント | アセット URI |
CUDA 13.0.2 イメージ |
|
CUDA 12.8 イメージ |
|
VPC イメージ
ACS コンソールの YAML ファイルで指定されている AI コンテナイメージのアセット URI egslingjun-registry.cn-wulanchabu.cr.aliyuncs.com/egslingjun/{image:tag} を acs-registry-vpc.{region-id}.cr.aliyuncs.com/egslingjun/{image:tag} に置き換えることで、VPC 経由で PG1 AI コンテナイメージを迅速にプルできます。
ここで、
{region-id}は、ACS を有効化した利用可能なリージョン (cn-beijing、cn-wulanchabu など) です。{image:tag}は、イメージの名前とタグです。
前提条件と使用制限
training-nv-pytorch 25.11 イメージは ACS およびマルチテナント Lingjun に適しています。シングルテナント Lingjun には適していません。シングルテナント Lingjun のシナリオでは使用しないでください。
training-nv-pytorch 25.11 イメージをプルまたはデプロイする前に、次の要件と使用制限を確認してください:
NVIDIA ドライバーリリース — リリース 25.11 は、NVIDIA ドライバーのリリースに応じて CUDA 12.8 と CUDA 13.0.2 をサポートします。CUDA 13.0.2 には NVIDIA ドライバーリリース 580 以降が必要で、CUDA 12.8 には NVIDIA ドライバーリリース 575 以降が必要です。サポートされているドライバーの完全なリストについては、「CUDA Application Compatibility」をご参照ください。ドライバーのアップグレードに関する詳細については、「CUDA Compatibility and Upgrades」をご参照ください。
プリインストールされたライブラリ — このイメージには、PyTorch や DeepSpeed など、変更が加えられたライブラリが含まれています。再インストールしないでください。
DeepSpeed 設定 — DeepSpeed 設定では、
zero_optimization.stage3_prefetch_bucket_sizeを空白にするか、autoに設定してください。NCCL のネットワークインターフェイス — シナリオに基づいて、このイメージに組み込まれている環境変数
NCCL_SOCKET_IFNAMEを調整してください:単一の Pod がトレーニングまたは推論 Job に 1、2、4、または 8 個の GPU のみを要求する場合は、
NCCL_SOCKET_IFNAME=eth0を設定してください。これはこのイメージのデフォルト設定です。単一の Pod がトレーニングまたは推論 Job のためにノード上の全 16 個の GPU を要求し、これにより高性能ネットワーク (HPN) を使用できる場合は、
NCCL_SOCKET_IFNAME=hpn0を設定してください。
クイックスタート
training-nv-pytorch イメージは、次のいずれかの方法で使用できます:
ACS ワークロード — コンソールのワークロード作成ページの [Artifact Center] ページでイメージを選択するか、YAML ファイルでイメージ参照を指定します。
Docker — イメージをプルして Docker で実行します。次の手順では、この方法のみを説明します。
開始する前に、「前提条件と使用制限」を確認してください。
ステップ 1:イメージのプル
次のコマンドを実行して training-nv-pytorch イメージをプルします:
docker pull egslingjun-registry.cn-wulanchabu.cr.aliyuncs.com/egslingjun/training-nv-pytorch:[tag][tag] を選択したイメージバリアントのタグで置き換えます。利用可能なタグについては、「パブリックイメージ」をご参照ください。
ステップ 2:コンテナの起動とトレーニング Job の実行
このイメージには、組み込みのモデルトレーニングツール ljperf が含まれています。 次の例では、コンテナを起動し、このツールを使用して LLM のトレーニングデモを実行します:
# コンテナを起動して中に入ります。
docker run --rm -it --ipc=host --net=host --privileged egslingjun-registry.cn-wulanchabu.cr.aliyuncs.com/egslingjun/training-nv-pytorch:[tag]
# トレーニングデモを実行します。
ljperf benchmark --model deepspeed/llama3-8b
ステップ 3:コンパイラ最適化と再計算のための GPU メモリ最適化の有効化
Transformers Trainer API を介してコンパイラ最適化を有効にします:
training_args = TrainingArguments(
    bf16=True,
    gradient_checkpointing=True,
    torch_compile=True
)
次の環境変数を設定して、再計算のための GPU メモリ最適化を有効にします:
export CHECKPOINT_OPTIMIZATION=trueエンドツーエンドのパフォーマンス評価
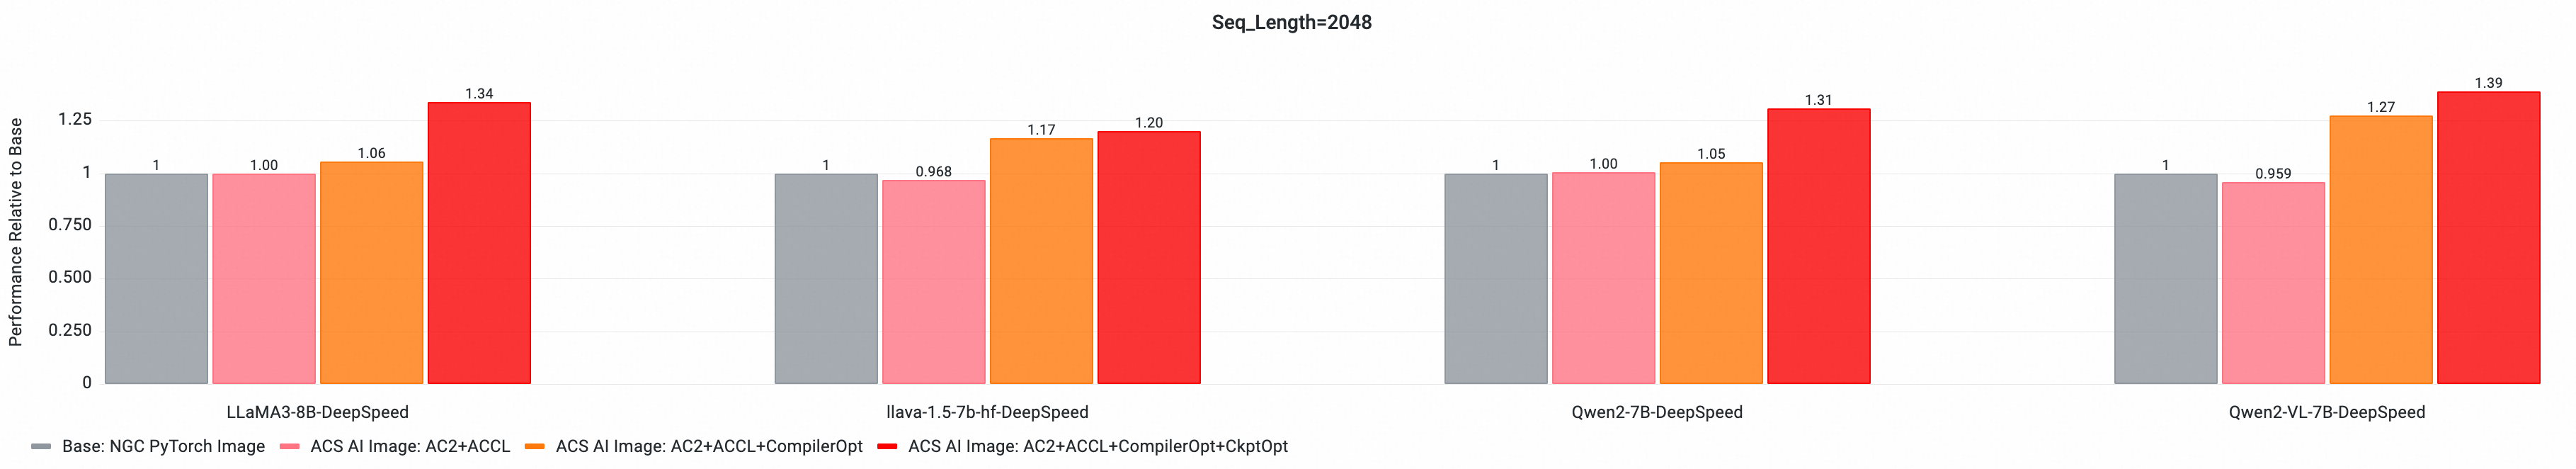
主流のオープンソースモデルとフレームワーク構成を使用して、クラウドネイティブ AI パフォーマンスベンチマークツール (CNP) は、標準のベースイメージとの包括的なエンドツーエンド (E2E) パフォーマンス比較を実行しました。また、アブレーションスタディを使用して、各最適化コンポーネントがモデル全体のトレーニングパフォーマンスにどの程度貢献しているかをさらに評価しました。
ベースイメージとのイメージ比較と反復評価
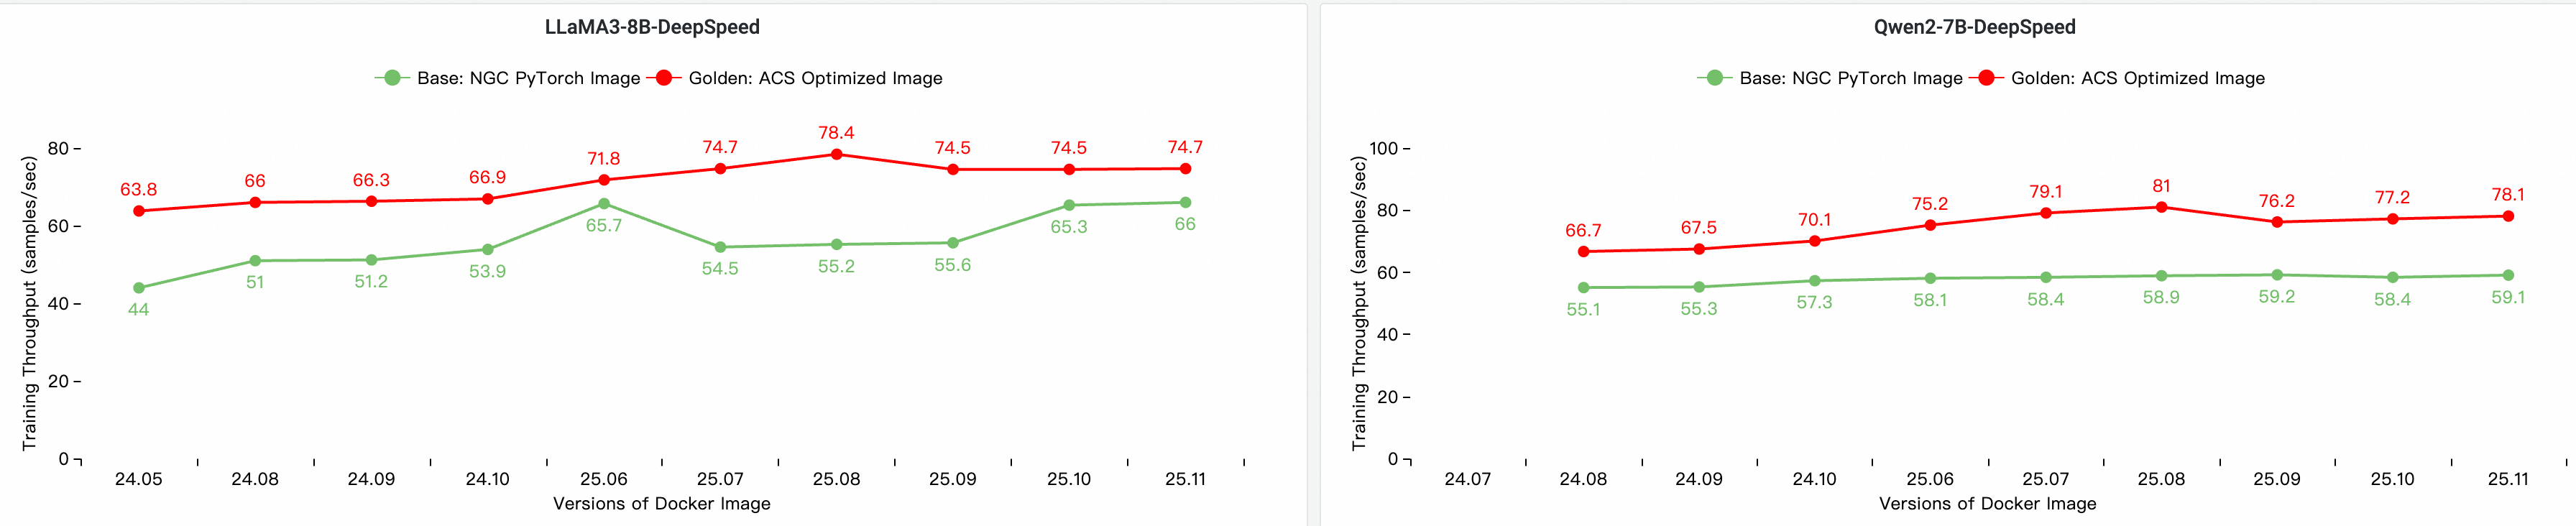
コア GPU コンポーネントの E2E パフォーマンス貢献度分析
以下のテストは training-nv-pytorch 25.11 イメージに基づいており、マルチノード GPU クラスターでのエンドツーエンドのトレーニングパフォーマンスを評価および比較します。比較項目は次のとおりです:
Base:NGC PyTorch イメージ。
ACS AI Image: Base+ACCL:このイメージは ACCL 通信ライブラリを使用します。
ACS AI Image: AC2+ACCL:AC2 BaseOS を使用しますが、最適化は有効になっていません。
ACS AI Image: AC2+ACCL+CompilerOpt:AC2 BaseOS を使用し、torch コンパイル最適化のみが有効にされています。
ACS AI Image: AC2+ACCL+CompilerOpt+CkptOpt:AC2 BaseOS を使用し、torch コンパイルと選択的勾配チェックポイント最適化の両方が有効にされています。
既知の問題
リリース 25.11 の CUDA 13.0.2 イメージで fa3 を直接コンパイルするとエラーが発生します。これは既知のコミュニティの問題です。CUDA 13.0.2 イメージと CUDA 12.8 イメージの選択に関するガイダンスについては、「イメージのバリアントと仕様」をご参照ください。