Alibaba Cloud Service Mesh (ASM) でタイムアウト、リトライ、バルクヘッドパターン、サーキットブレーキングを設定することで、依存するサービスの障害を許容できるようになります。安定性のリスクは、インフラストラクチャ、アプリケーションロジック、および運用プロセスに存在する可能性があり、そのいずれかがビジネスシステムを停止させる可能性があります。
背景情報
フォールトトレランスとは、システムの一部に障害が発生しても、システム全体の稼働を継続できる能力のことです。信頼性が高く、回復力のあるシステムでは、それに含まれるすべてのサービスにフォールトトレランスが求められます。クラウド環境の動的な性質により、サービスはこのような障害を予測し、予期せぬ状況に適切に対応する必要があります。
どのサービスでもリクエストの失敗は起こり得ます。リクエストが失敗した場合、適切なフォールバックアクションが重要です。1 つのサービスが中断すると、深刻なビジネス上の影響を伴う連鎖反応が引き起こされる可能性があります。ASM はそのフォールトトレランスメカニズムをサイドカープロキシに適用するため、アプリケーションコードを変更する必要はありません。
フォールトトレランスメカニズムの選択
次の表は、ASM が提供するフォールトトレランスメカニズム、各メカニズムが対応する障害モード、およびそれを設定するリソースについて説明しています。
メカニズム |
対応する障害モード |
設定リソース |
主要フィールド |
アップストリームサービスからの応答が遅い、または応答がなく、クライアントが待機し続ける。 |
仮想サービス |
|
|
リクエストタイムアウト、接続タイムアウト、サービス停止時間などのエラーにより、単一のリクエストが失敗する。 |
仮想サービス |
|
|
クライアントがターゲットサービスで処理できる以上の接続やリクエストを送信する。 |
宛先ルール |
|
|
アップストリームサービスの個々のホストが連続してエラーを返す。 |
宛先ルール |
|
タイムアウトとリトライは単一のリクエストパスを制御しますが、バルクヘッドパターンと外れ値検出は、ターゲットサービスが受信する負荷と、どのホストが負荷分散プールに残るかを制御します。任意のリトライポリシーと同じルートにタイムアウトを設定してください。ルートのタイムアウトは、サイドカープロキシがリトライに費やす合計時間を制限します。
このトピックの例の値は、各フィールドの構文を示すものです。本番メッシュにこれらの値をコピーするのではなく、サービスの測定されたレイテンシ、キャパシティ、およびエラー動作から独自に値を導出してください。
前提条件
このトピックで説明するメカニズムには、次の要件が適用されます。
ASM インスタンスのバージョン — デフォルトの HTTP リクエストリトライポリシーを設定するには、バージョン 1.15.3.120 以降の ASM インスタンスが必要です。インスタンスのアップグレード方法の詳細については、「ASM インスタンスのアップグレード」をご参照ください。
メトリクスのレポートと収集 — ホストレベルのサーキットブレーキングメトリクスは、サイドカープロキシがレポートし、Prometheus が収集した後にのみ利用可能になります。これらのメトリクスに依存する前に、「ホストレベルのサーキットブレーキングメトリクスの表示」および「ホストレベルのサーキットブレーキングメトリクスの収集とアラートの設定」で説明されている設定を完了してください。
タイムアウト
タイムアウトの仕組み
サービスがアップストリームサービスにリクエストを送信する際、アップストリームサービスが応答しない場合があります。リクエストの待機時間を設定します。待機時間が経過してもアップストリームサービスが応答しない場合、リクエストはアップストリームサービスを待ち続けるのではなく、即座に失敗します。
タイムアウトは、バックエンドサービスが応答しない場合にアプリケーションがエラーを確実に受け取れるようにし、アプリケーションが適切なフォールバック動作で障害を処理できるようにします。タイムアウトは、リクエストを送信するクライアントが応答を待つ時間を変更するものであり、ターゲットサービスがリクエストを処理する方法には影響しません。したがって、タイムアウトはリクエストされた操作が失敗したことを意味するわけではありません。
ルートタイムアウトの設定
ASM では、仮想サービスのルートにタイムアウトポリシーを設定することで、タイムアウト値を変更できます。サイドカープロキシが設定された時間内に応答を受信しない場合、リクエストは失敗します。このようにタイムアウトを調整すると、そのルートを使用するすべてのリクエストにそのタイムアウト設定が適用されます。
次の仮想サービスは、httpbin アプリケーションへのルートのタイムアウトを設定します。
apiVersion: networking.istio.io/v1beta1
kind: VirtualService
metadata:
  name: httpbin
spec:
  hosts:
  - 'httpbin'
  http:
  - route:
    - destination:
        host: httpbin
    timeout: 5s
フィールド |
説明 |
|
ルートのタイムアウト期間を設定します。リクエストされたサービスが設定された時間内に応答しない場合、エラー結果が即座に返され、クライアントは待機を停止します。 |
ルートタイムアウトは、そのルートでのリトライも制限します。リクエストが最大リトライ回数に達していなくても、すべてのリトライに費やされた合計時間がタイムアウトを超えた場合、サイドカープロキシはリクエストのリトライを停止し、タイムアウトを返します。リトライポリシーの詳細については、「リトライ」をご参照ください。
リトライ
リトライの仕組み
他のサービスへのリクエストが、リクエストタイムアウト、接続タイムアウト、サービス停止時間などのエラーで失敗した場合、リトライポリシーを設定すると、サイドカープロキシはそのサービスにリクエストを再送信します。
連鎖的なシステム障害を避けるため、リトライの頻度が高すぎたり、時間が長すぎたりしないようにしてください。perTryTimeout フィールドで各試行を制限し、同じルートにタイムアウトを設定してリトライに費やす合計時間を制限してください。詳細については、「タイムアウト」をご参照ください。
ルートのリトライポリシーの設定
ASM は、仮想サービスを使用して HTTP リクエストのリトライポリシーを定義することをサポートしています。次の例では、メッシュ内のサービスが httpbin アプリケーションをリクエストしたときに、httpbin が応答しないか接続が確立できない場合に、サイドカープロキシはリクエストを 3 回リトライし、試行ごとに 5 秒のタイムアウトを適用します。
apiVersion: networking.istio.io/v1beta1
kind: VirtualService
metadata:
  name: httpbin
spec:
  hosts:
  - 'httpbin'
  http:
  - route:
    - destination:
        host: httpbin
    retries:
      attempts: 3
      perTryTimeout: 5s
      retryOn: connect-failure,reset
retries フィールド内の以下のフィールドを設定して、サイドカープロキシがリクエストをリトライする方法をカスタマイズします。
フィールド |
説明 |
attempts |
リクエストの最大リトライ回数です。リトライメカニズムの設定中にサービスルートにタイムアウトが設定されている場合、実際のリトライ回数はタイムアウト設定に依存します。詳細については、「タイムアウト」をご参照ください。 |
perTryTimeout |
各リトライのタイムアウト時間。ミリ秒 (ms)、秒 (s)、分 (m)、または時間 (h) で指定します。 |
retryOn |
リトライが実行される条件を指定します。複数のリトライ条件はカンマ (,) で区切ります。詳細については、「HTTP リトライ条件」および「gRPC リトライ条件」をご参照ください。 |
HTTP リトライ条件
次の表は、retryOn フィールドに設定できる一般的な HTTP リクエストのリトライ条件について説明しています。
リトライ条件 |
説明 |
|
アップストリームサービスへの接続が確立できない (接続タイムアウトなど) ためにリクエストが失敗した場合にリトライします。 |
|
アップストリームサービスがストリームをリセットするために REFUSED_STREAM フレームを返した場合にリトライします。 |
|
アップストリームサービスが応答する前に、切断、リセット、または読み取りタイムアウトイベントが発生した場合にリトライします。 |
|
アップストリームサービスが 500 や 503 などの 5xx 応答コードを返すか、アップストリームサービスが応答しない場合にリトライします。 説明
|
|
アップストリームサービスが 502、503、または 504 ステータスコードを返した場合にリトライします。 |
|
リクエストに |
|
アップストリームサービスが 409 ステータスコードを返した場合にリトライします。 |
|
アップストリームサービスから返されたステータスコードがリトライ可能と判断された場合にリトライします。 説明 有効なステータスコードを retryOn フィールドに直接追加できます。追加されたステータスコードはリトライ可能と見なされます。例: |
|
アップストリームサービスから返されたレスポンスヘッダーに、リトライが可能であることを示すヘッダーが含まれている場合にリトライします。 説明
|
gRPC リトライ条件
gRPC リクエストは HTTP/2 に基づいているため、HTTP リクエストのリトライポリシーの retryOn フィールドに gRPC のリトライ条件を設定することもできます。次の表は、一般的な gRPC リクエストのリトライ条件について説明しています。
リトライ条件 |
説明 |
|
アップストリーム gRPC サービスのレスポンスヘッダーの gRPC ステータスコードが cancelled (1) の場合にリトライします。 |
|
アップストリーム gRPC サービスのレスポンスヘッダーの gRPC ステータスコードが unavailable (14) の場合にリトライします。 |
|
アップストリーム gRPC サービスのレスポンスヘッダーの gRPC ステータスコードが deadline-exceeded (4) の場合にリトライします。 |
|
アップストリーム gRPC サービスのレスポンスヘッダーの gRPC ステータスコードが internal (13) の場合にリトライします。 |
|
アップストリーム gRPC サービスのレスポンスヘッダーの gRPC ステータスコードが resource-exhausted (8) の場合にリトライします。 |
デフォルトの HTTP リクエストリトライポリシーの設定
デフォルトでは、仮想サービスで HTTP リクエストのリトライポリシーを定義していなくても、メッシュ内のサービスは他の HTTP サービスにアクセスする際にデフォルトの HTTP リクエストリトライポリシーを適用します。デフォルトのリトライポリシーは、リトライ回数が 2、リトライタイムアウトなしで、デフォルトのリトライ条件として connect-failure、refused-stream、unavailable、cancelled、retriable-status-codes を使用します。インスタンスのデフォルトポリシーを上書きするには、ASM コンソールの [基本情報] ページでデフォルトの HTTP リクエストリトライポリシーを設定してください。
この機能には、サポートされている ASM インスタンスのバージョンが必要です。詳細については、「前提条件」をご参照ください。
ASM コンソール にログインします。左側のナビゲーションウィンドウで、 を選択します。
[メッシュ管理] ページで、ASM インスタンスの名前をクリックします。左側のナビゲーションウィンドウで、 を選択します。
-
基本情報 ページの 設定情報 セクションで、デフォルトの HTTP リクエストリトライポリシー の横にある 編集 をクリックします。
-
デフォルトの HTTP リクエストリトライポリシー ダイアログボックスで、次の表に従って設定を構成し、OK をクリックします。
設定を送信すると、新しい HTTP リクエストリトライポリシーがメッシュ内のサービスのデフォルトリトライポリシーを上書きします。
設定項目 |
説明 |
[リトライ回数] |
上記の attempts に対応します。デフォルトの HTTP リクエストリトライポリシーでは、このフィールドを 0 に設定できます。これにより、デフォルトで HTTP リクエストのリトライが無効になります。 |
[リトライタイムアウト] |
上記の perTryTimeout に対応します。 |
[リトライ条件] |
上記の retryOn に対応します。 |
バルクヘッド
バルクヘッドパターンの仕組み
バルクヘッドパターンは、クライアントがターゲットサービスに対して行うことができる接続数とアクセスリクエスト数を制限し、単一のクライアントがそのサービスに過負荷をかけるのを防ぎます。設定されたしきい値を超えると、リクエストはドロップされます。バルクヘッドパターンは、サービスが使用するリソースを分離し、連鎖障害を回避するのに役立ちます。
最大接続数と接続タイムアウトは、TCP と HTTP の両方に有効な一般的な接続設定ですが、接続あたりの最大リクエスト数と保留中のリクエストの最大数は、HTTP/1.1、HTTP/2、および gRPC 接続にのみ有効です。

接続プールの制限の設定
ASM は、宛先ルールを使用してバルクヘッドパターンを設定することをサポートしています。次の宛先ルールでは、他のサービスから httpbin アプリケーションへのリクエストは、1 つの TCP 接続、接続あたり 1 つのリクエスト、および 1 つの保留中のリクエストに制限されます。これらの接続プールのしきい値を超えるリクエストは、503 応答で拒否されます。サイドカープロキシは、サービスのホストへの接続を確立するために最大 10 秒間待機します。
apiVersion: networking.istio.io/v1beta1
kind: DestinationRule
metadata:
  name: httpbin
spec:
  host: httpbin
  trafficPolicy:
    connectionPool:
      http:
        http1MaxPendingRequests: 1
        maxRequestsPerConnection: 1
      tcp:
        connectTimeout: 10s
        maxConnections: 1
フィールド |
説明 |
|
保留中のリクエストの最大数。HTTP/1.1、HTTP/2、および gRPC 接続にのみ有効です。 |
|
接続あたりの最大リクエスト数。HTTP/1.1、HTTP/2、および gRPC 接続にのみ有効です。 |
|
接続タイムアウト。サイドカープロキシがターゲットサービスのホストへの接続を確立するために待機する最大時間です。TCP と HTTP の両方に有効です。 |
|
最大接続数。TCP と HTTP の両方に有効です。 |
サーキットブレーキング
このセクションでは、宛先ルールを使用して設定する外れ値検出について説明します。ASM は、別のサーキットブレーキングメカニズムである ASMCircuitBreaker も提供します。外れ値検出では、クライアント上のサイドカープロキシが各アップストリームサービスホストのエラー率を個別に検出し、そのホストが連続してエラーを生成した場合に、サービスの負荷分散プールからホストを除外します。
外れ値検出の仕組み
サーキットブレーキングとは、応答しないサービスにリクエストを繰り返し送信しないようにする仕組みです。代わりに、特定の期間内に発生する障害の数が監視されます。
エラー率がしきい値を超えると、サーキットブレーカーはリクエストをドロップし、サーキットブレーカーが閉じるまですべての後続リクエストは失敗します。
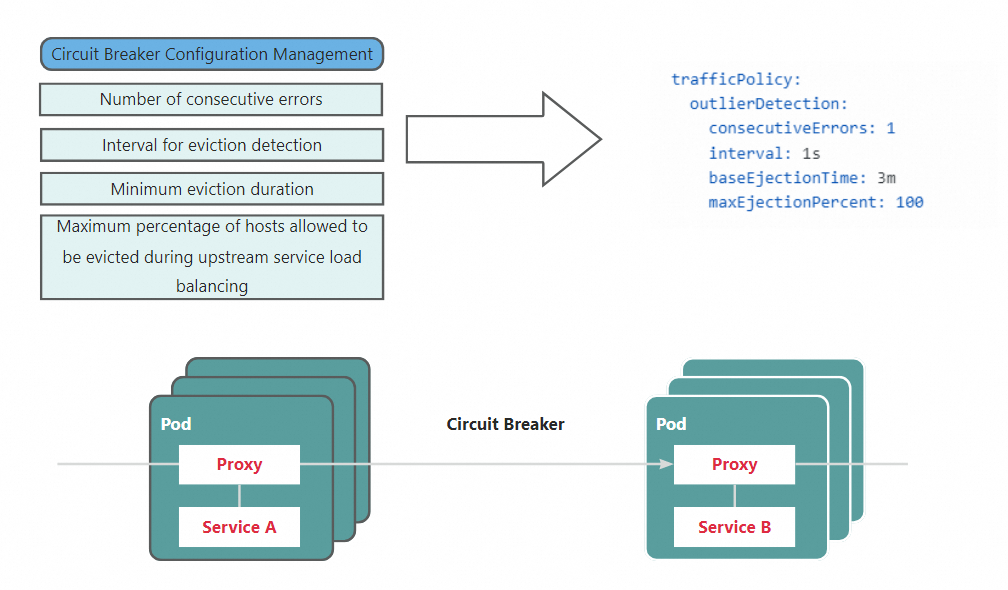
外れ値検出の設定
ASM は、宛先ルールを使用して外れ値検出を設定することをサポートしています。次の宛先ルールでは、サイドカープロキシは 5 秒ごとに httpbin アプリケーションのホストをスキャンして除外対象を検出します。3 回連続でエラーを生成したホストは、httpbin の負荷分散プールから少なくとも 5 分間除外されます。除外されなかったホストは、maxEjectionPercent が設定する除外制限内で、他のサービスからのリクエストを引き続き処理します。この例で使用されている値のリスクについては、次の表の maxEjectionPercent の行をご参照ください。
apiVersion: networking.istio.io/v1beta1
kind: DestinationRule
metadata:
  name: httpbin
spec:
  host: httpbin
  trafficPolicy:
    outlierDetection:
      consecutiveErrors: 3
      interval: 5s
      baseEjectionTime: 5m
      maxEjectionPercent: 100
フィールド |
説明 |
|
ホストがサービスの負荷分散プールから除外される原因となる連続エラーの数。 |
|
除外検出の時間間隔。 |
|
最小除外期間。 |
|
負荷分散プール内で除外が許可されるホストの最大パーセンテージ。 重要 値 100 を設定すると、サービスのすべてのホストが同時に除外される可能性があり、リクエストを処理するホストがなくなります。 |
ホストレベルのサーキットブレーキングメトリクスの表示
ASM のホストレベルのサーキットブレーキングは、サーキットブレーキングが発生したかどうかを判断するのに役立つ一連の関連メトリクスを生成します。次の表は、これらのメトリクスの一部を示しています。
メトリクス |
メトリクスタイプ |
説明 |
|
ゲージ |
現在除外されているホストの数。 |
|
カウンター |
発生したホスト除外イベントの数。 |
|
カウンター |
最大除外パーセンテージを超えたためにホストの除外が中止された回数。 |
|
カウンター |
ホストが連続して 5xx エラーを生成したことが検出された回数。 |
これらのメトリクスを利用可能にするには、サイドカープロキシの proxyStatsMatcher 設定を構成して、サイドカープロキシが関連メトリクスをレポートするようにし、その後 Prometheus を使用してサーキットブレーキングに関連するメトリクスを収集および表示します。次の手順を順番に実行してください。
proxyStatsMatcherを使用して、サーキットブレーキングメトリクスをレポートするようにサイドカープロキシを設定します。proxyStatsMatcherを設定する際は、[Regular Expression Match] を選択し、値を.*outlier_detection.*に設定します。詳細については、「proxyStatsMatcher」をご参照ください。httpbinステートレスワークロードを再デプロイします。詳細については、「ワークロードの再デプロイ」をご参照ください。
ホストレベルのサーキットブレーキングメトリクスの収集とアラートの設定
ホストレベルのサーキットブレーキングメトリクスのレポートを設定した後、関連するメトリクスを Prometheus に収集し、主要なメトリクスに基づいてアラートルールを設定することで、サーキットブレーキングが発生した際に迅速にアラートを受け取ることができます。以下の手順では、Managed Service for Prometheus を使用して、ホストレベルのサーキットブレーキングメトリクスの収集とアラートの設定方法について説明します。
Managed Service for Prometheus で、データプレーンクラスター用の [Alibaba Cloud ASM] コンポーネントを統合するか、最新バージョンにアップグレードして、Managed Service for Prometheus が公開されたサーキットブレーキングメトリクスを収集できるようにします。統合コンポーネントの更新方法の詳細については、「統合コンポーネントの管理」をご参照ください。(「メッシュモニタリングのためのセルフマネージド Prometheus の統合」に従ってサービスメッシュメトリクスを収集するセルフマネージド Prometheus インスタンスを設定している場合は、この手順を実行する必要はありません。)
ホストレベルのサーキットブレーキングのアラートルールを作成します。詳細については、「カスタム PromQL クエリを使用した Prometheus アラートルールの作成」をご参照ください。次の表に、アラートルールの主要なパラメーターの入力例を示します。残りのパラメーターは、前述のドキュメントを参照して、独自の要件に基づいて入力できます。
パラメーター |
例 |
説明 |
カスタム PromQL クエリ |
|
この例では、 |
アラート内容 |
ホストレベルのサーキットブレーキングがトリガーされました。ワークロードが連続してエラーを生成し、サービスの負荷分散プールから除外されました。名前空間: {{$labels.namespace}}、除外が発生したサービス: {{$labels.cluster_name}}。除外数: {{ $value }} |
このアラートメッセージの例では、サーキットブレーキングをトリガーしたサービスの名前空間とサービス名、およびそのサービスの現在の除外数が表示されます。 |