AnalyticDB for MySQL はクエリを受信すると、そのクエリを複数のステージに分割します。これらのステージは、ワーカーノードとエグゼキュータノードに分散され、データの読み取りと計算を行います。一部のステージは並行して実行できますが、他のステージには依存関係があり、順次実行する必要があります。この複雑さにより、複雑な SQL ステートメントの持続時間を分析することが困難になります。コンソールまたは API のステージとタスクの詳細を使用して、低速クエリを分析できます。
操作手順
AnalyticDB for MySQL コンソールにログインします。コンソール左上の隅でリージョンを選択します。左側のナビゲーションウィンドウで、クラスターリスト をクリックします。管理するクラスターを見つけ、そのクラスター ID をクリックします。
-
左側のナビゲーションウィンドウで、診断の最適化 をクリックします。
-
Sqlリスト セクションで、対象のクエリの 診断 をクリックします。
-
[ステージとタスク] タブをクリックします。ページ上部の [クエリプロパティ] セクションには、開始時刻と終了時刻、ユーザー名、キューイング時間、合計時間、ピークメモリ、スキャンされたデータ量、返されたデータ量、ステータス、リソースグループなどの情報が表示されます。[ステージとタスク] タブには、ステージ ID、ステータス、入出力行とデータ量、ピークメモリ、累積時間など、各ステージの実行詳細が一覧表示されます。ステージクエリ結果の説明については、「ステージのパラメーター」をご参照ください。
-
スロークエリをトラブルシューティングするには、stageID をクリックして、そのステージ内のすべてのタスクの詳細を表示します。タスククエリ結果の説明については、「タスクのパラメーター」をご参照ください。
重要タスクの詳細は、完了までに 1 秒以上かかるクエリでのみ利用可能です。
パラメーター
ステージのパラメーター
|
パラメーター |
説明 |
|
ステージ ID |
ステージの一意の識別子。この ID は、実行計画ツリーのステージ ID に対応します。 |
|
ステータス |
ステージの実行ステータス。有効値:
|
|
入力行数 |
ステージの入力データの行数。 |
|
入力データサイズ |
ステージの入力データのサイズ。 |
|
出力行 |
ステージの出力データの行数。 |
|
出力データサイズ |
ステージの出力データのサイズ。 |
|
ピークメモリ |
ステージの最大メモリ使用量。 |
|
累積時間 |
ステージ内のすべてのオペレーターが消費した時間の合計。 このパラメーターは、時間のかかるステージや CPU 使用率の高いステージを特定するのに役立ちます。累積時間はクエリの持続時間と直接比較することはできません。クエリの持続時間と累積時間の関係を判断するには、ステージの並列度も考慮する必要があります。 |
タスクのパラメーター
|
パラメーター |
説明 |
|
タスク ID |
タスクの一意の識別子。 たとえば、 |
|
ステータス |
タスクの実行ステータス。有効値:
|
|
入力データ |
タスクの入力データの行数とサイズ。 この値でタスクをソートして、ステージの入力データにデータスキューがあるかどうかを確認できます。データスキューが存在する場合、GROUP BY 句または JOIN 句の分散キーが非効率であることを示しています。問題を解決するには、上流ステージに遡って調査する必要があります。 説明
データスキューは、非効率的な分散キーによってデータがワーカーノード間で不均等に分散される場合に発生します。 |
|
出力データ |
タスクの出力データの行数とサイズ。 現在のステージのオペレータープランで Aggregation ノードまたは Join ノードのプロパティを調べることで、それを SQL ステートメントにマッピングし、結合されたフィールドがパーティションキーまたは JOIN 条件で使用されているかどうかを確認できます。たとえば、 |
|
ピークメモリ |
タスクの実行中に使用された最大メモリ。 ピークメモリは入力データのサイズに比例します。特定のノードでメモリ使用量が著しく不均衡なためにクエリが失敗したかどうかを判断するのに役立ちます。 |
|
テーブル読み取り時間 |
ステージのオペレーターツリーに TableScan オペレーターが含まれている場合、このパラメーターは、ステージ内のすべての TableScan オペレーターがテーブルデータの読み取りに費やした合計時間を示します。 この持続時間は、複数のマシンとスレッドからの累積値であり、クエリの持続時間と直接比較することはできません。累積時間と比較することで、ステージの実行時間が主にデータスキャンに費やされているかどうかを判断できます。 |
|
テーブルから読み取られたデータ |
ステージのオペレーターツリーに TableScan オペレーターが含まれている場合、このパラメーターは、ステージ内のすべての TableScan オペレーターがソーステーブルから読み取った行数とデータ量を示します。 このフィールドをソートすることで、ソーステーブルにデータスキューが存在するかどうかを判断できます。存在する場合、コンソールを使用して分散キーのスキューを診断できます。詳細については、「データモデリング診断」をご参照ください。 |
|
作成時刻 |
タスクが作成された時刻。 |
|
キューイング時間 |
タスクが実行開始前にキューで待機していた時間。 |
|
終了時刻 |
タスクの実行が終了した時刻。 |
|
開始時刻と終了時刻の間隔 |
タスクの作成時刻から終了時刻までの経過時間。たとえば、タスクが 2022-12-12 12:00:00 に作成され、2022-12-12 12:00:04 に終了した場合、間隔は 4 秒です。 この間隔をクエリの持続時間と比較することで、パフォーマンスボトルネックがどこで発生しているかを特定できます。たとえば、クエリの持続時間が 6 秒で間隔が 4 秒の場合、ボトルネックは現在のステージにあります。詳細な計算方法については、「例:タスクの持続時間と同時実行数の計算」をご参照ください。 |
|
累積時間 |
このタスク内のすべてのスレッドの実行時間の合計。詳細な計算方法については、「例:タスクの持続時間と同時実行数の計算」をご参照ください。 |
|
計算時間比率 |
サブタスクのライフサイクルに対する実際のデータ処理時間の比率。 数式:計算時間比率 = (累積時間 / サブタスクの同時実行数) / 開始時刻と終了時刻の間隔。この数式では、(累積時間 / サブタスクの同時実行数) は各スレッドがデータ処理に費やした平均時間を表し、間隔には実際の処理時間、サブタスクのキューイング時間、ネットワーク遅延が含まれます。詳細な計算方法については、「例:タスクの持続時間と同時実行数の計算」をご参照ください。 説明
計算時間比率が小さいほど、開始時刻と終了時刻の間隔が長いことを示唆しており、時間のかかるオペレーターを特定する必要があります。逆に、比率が大きいほど、間隔が短いことを示唆しており、リソース待機やネットワーク遅延などの問題を指し示します。 |
|
サブタスクの同時実行数 |
各タスクは、単一のマシン上で複数の並行スレッドによって実行されます。計算タスクを同時に実行するスレッドの数が、サブタスクの同時実行数です。詳細な計算方法については、「例:タスクの持続時間と同時実行数の計算」をご参照ください。 |
|
実行ノード |
タスクが実行されたノードの内部 IP アドレス。複数のクエリが同じノードでロングテールを示している場合は、その特定のノードを調査する必要があります。 説明
ロングテールは、分散された AnalyticDB for MySQL の実行において、一部のタスクが他のタスクよりも完了までに著しく長い時間がかかる場合に発生します。 |
例:タスクの持続時間と同時実行数の計算
この例では、Task 2.1 という名前のタスクについて、開始時刻と終了時刻の間隔、累積時間、計算時間比率、およびサブタスクの同時実行数を計算する方法を示します。
Task 2.1 は stage[2] に属し、StageOutput、Join、TableScan、RemoteSource の 4 つのオペレーターが含まれていると仮定します。次の図は、オペレーターツリーを示しています。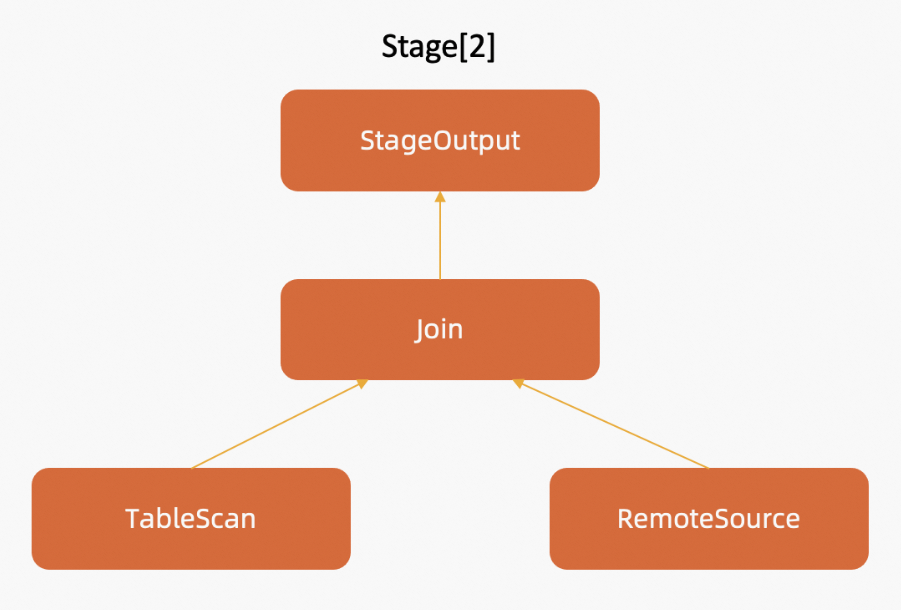
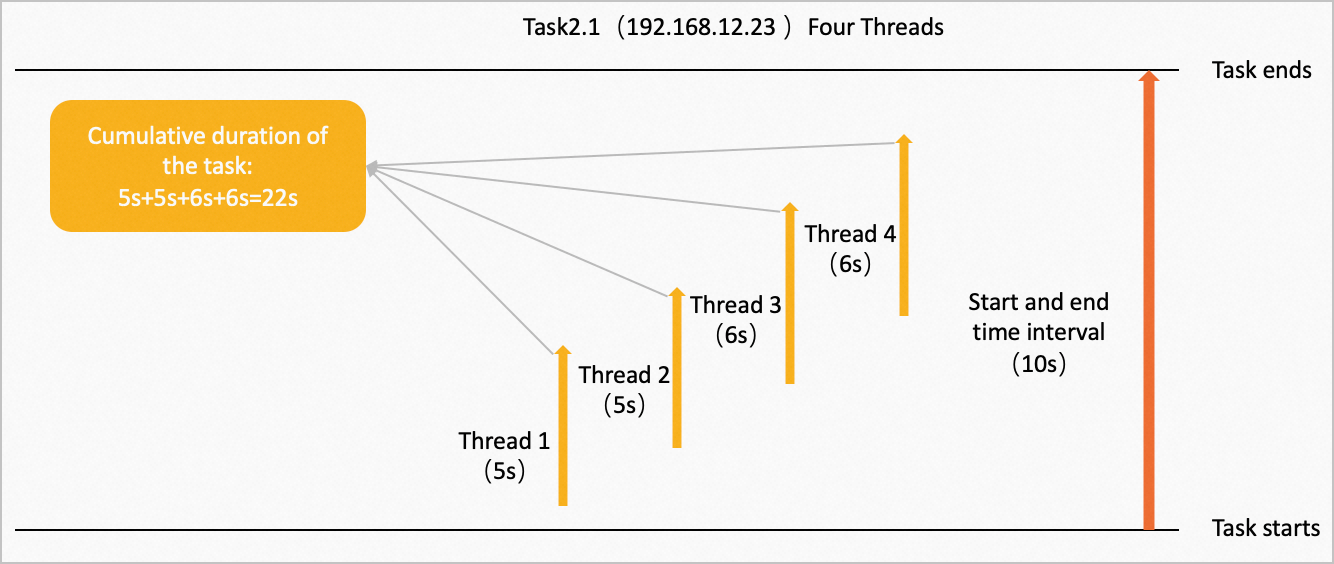
ツリー内のオペレーターは、矢印の方向に沿って複数のノードで並列に実行されます。Task 2.1 は、IP アドレス 192.168.12.23 のノードで 4 つの並行スレッドで実行されます。データ処理時間は、スレッド 1 とスレッド 2 が 5 秒、スレッド 3 とスレッド 4 が 6 秒です。次の図は、そのプロセスを示しています。
-
タスクの累積時間は、すべてのスレッドの実行時間の合計です:5 + 5 + 6 + 6 = 22 秒。
-
開始時刻と終了時刻の間隔は 10 秒です。
-
計算時間比率は (累積時間 / サブタスクの同時実行数) / 開始時刻と終了時刻の間隔です:(22 秒 / 4) / 10 秒 = 0.55。
関連 API
|
API |
説明 |
|
SQL ステートメントの実行詳細を取得します。 |
|
|
指定されたクエリ ID とステージ ID の分散サブタスクの実行詳細を取得します。 |