Sebagai database key-value berkinerja tinggi, Tair (Redis OSS-compatible) sering menyimpan sejumlah besar data kritis untuk bisnis Anda. Untuk menjamin keamanan data, Tair (Redis OSS-compatible) menyediakan berbagai solusi pemulihan bencana.
Evolusi arsitektur pemulihan bencana
Mekanisme pemulihan bencana menjamin konsistensi data dan ketersediaan layanan jika suatu instans mengalami kegagalan akibat kejadian tak terduga, seperti kerusakan perangkat keras atau pemadaman listrik di pusat data.
Gambar 1. Evolusi arsitektur pemulihan bencana
Solusi pemulihan bencana | Tingkat perlindungan | Deskripsi |
★★★☆☆ | Node master dan node replika ditempatkan pada mesin yang berbeda dalam zona yang sama. Jika suatu node gagal, sistem high availability (HA) secara otomatis melakukan failover untuk mencegah gangguan layanan akibat single point of failure (SPOF). | |
★★★★☆ | Node master dan node replika ditempatkan di dua zona berbeda dalam wilayah yang sama. Jika suatu zona tidak tersedia karena faktor seperti pemadaman listrik atau kegagalan jaringan, sistem HA melakukan failover untuk memastikan instans tetap tersedia. | |
★★★★★ | Instans Global Distributed Cache terdiri dari beberapa instans anak yang menyinkronkan data secara real time melalui saluran khusus. Channel manager memantau kondisi instans anak dan menangani pengecualian, seperti failover. Solusi ini ideal untuk skenario seperti geo-disaster recovery, active geo-redundancy, mengarahkan pengguna ke titik akses aplikasi terdekat, dan mendistribusikan beban. |
Solusi HA zona tunggal
Semua arsitektur instans mendukung arsitektur HA zona tunggal. Sistem HA memantau kondisi node master dan replika, serta secara otomatis melakukan failover untuk mencegah gangguan layanan akibat SPOF.
Arsitektur Penyebaran | Deskripsi |
Gambar 2. Arsitektur HA untuk instans dual-replica standard Instans dengan arsitektur standard menggunakan konfigurasi master-replika dua node. Jika sistem HA mendeteksi kegagalan pada node master, sistem tersebut secara otomatis memulai failover dengan menjadikan node replika sebagai node master baru. Ketika node master asli pulih, node tersebut terhubung kembali sebagai node replika baru. | |
Gambar 3. Arsitektur HA untuk instans kluster multi-replica Pada arsitektur kluster multi-replica, data disimpan pada shard data. Setiap shard data memiliki konfigurasi multi-replica dengan node yang ditempatkan pada mesin berbeda untuk menjamin ketersediaan tinggi. Jika node master gagal, sistem secara otomatis melakukan failover untuk menjaga ketersediaan layanan. | |
Gambar 4. Arsitektur HA untuk instans read/write splitting
|
Solusi HA zona tunggal hanya menyediakan pemulihan kegagalan tingkat mesin dan tidak tahan terhadap kegagalan tingkat zona. Jika zona tempat instans berada mengalami kegagalan menyeluruh (seperti pemadaman listrik atau gangguan jaringan), instans menjadi tidak tersedia. Anda harus menunggu zona tersebut pulih atau membuat instans baru di zona lain dari backup historis. Jika bisnis Anda memerlukan keandalan data tinggi atau ketersediaan berkelanjutan, kami menyarankan Anda memilih solusi pemulihan bencana multi-zona atau solusi pemulihan bencana cross-region.
Pemulihan bencana multi-zona
Tair (Redis OSS-compatible) menyediakan arsitektur pemulihan bencana antar zona. Jika layanan Anda diterapkan dalam satu wilayah dan memerlukan tingkat pemulihan bencana yang tinggi, Anda dapat memilih opsi multi-zona saat membuat instans. Untuk petunjuknya, lihat Buat instans.
Gambar 5. Buat instans pemulihan bencana antar zona
Setelah instans dibuat, instans replika dengan spesifikasi yang sama dengan instans utama dibuat di zona sekunder. Data disinkronkan antara zona utama dan zona sekunder melalui saluran replikasi khusus.
Jika zona utama mengalami kegagalan listrik atau jaringan, sistem menjadikan instans replika sebagai instans master dan memanggil API Config Server untuk memperbarui informasi routing untuk proxy. Selain itu, Tair (Redis OSS-compatible) mengoptimalkan mekanisme sinkronisasi Redis. Mirip dengan fitur GTID di MySQL, Tair menggunakan Opid global untuk mengelola titik sinkronisasi. Thread latar belakang tanpa lock melakukan pencarian Opid, dan binlog AOF dikirim secara asinkron dengan pembatasan laju, yang menjamin performa layanan Redis.
Gambar 6. Proses sinkronisasi data instans pemulihan bencana antar zona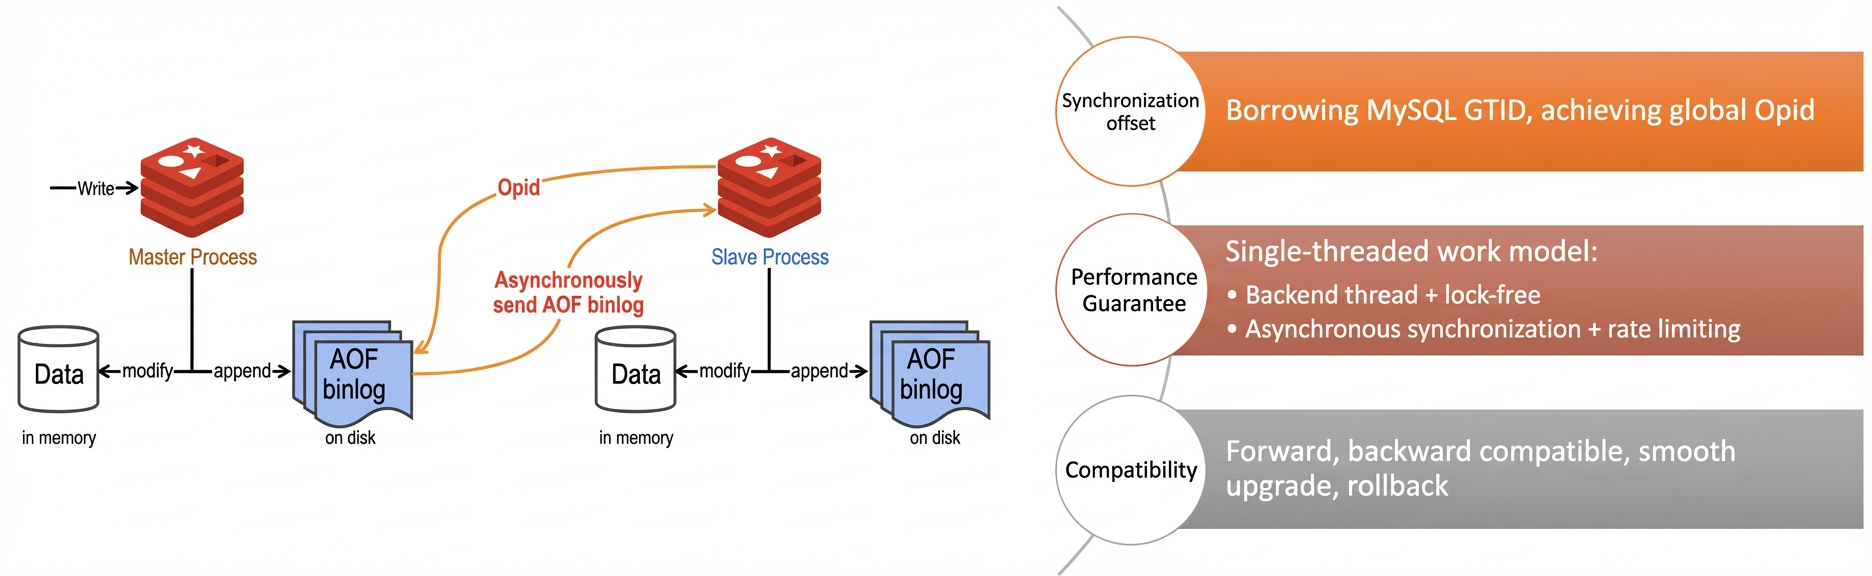
Pemulihan bencana cross-region
Saat bisnis Anda berkembang secara global, arsitektur akses cross-region dapat menyebabkan latensi tinggi dan pengalaman pengguna yang buruk. Fitur Tair Global Distributed Cache mengurangi latensi cross-region tersebut. Fitur ini menawarkan keunggulan berikut:
Anda dapat langsung membuat atau menentukan instans anak untuk sinkronisasi. Hal ini menghilangkan desain redundansi tingkat aplikasi yang kompleks, sehingga secara signifikan menyederhanakan pengembangan dan memungkinkan Anda fokus pada logika bisnis inti.
Fitur ini memungkinkan Anda menerapkan geo-disaster recovery dan active geo-redundancy dengan cepat.
Fitur ini cocok untuk sinkronisasi data cross-region dan penerapan global di industri seperti multimedia, gaming, dan e-commerce. Untuk informasi selengkapnya, lihat Global Distributed Cache.
Gambar 7. Arsitektur Tair Global Distributed Cache
Menanggapi kegagalan
Kegagalan, seperti kerusakan perangkat keras, pemadaman listrik di pusat data, dan bencana alam, dapat diklasifikasikan sebagai kegagalan node master atau kegagalan tingkat zona. Meskipun jarang terjadi, kegagalan dapat sementara mencegah penulisan data, menyebabkan gangguan koneksi sementara, atau bahkan menyebabkan downtime atau kehilangan data. Keandalan instans sangat terkait dengan arsitekturnya. Arsitektur kluster umumnya menawarkan keandalan lebih tinggi. Untuk meminimalkan dampak kegagalan, instans dengan penerapan multi-replica dan multi-zona secara otomatis melakukan failover, sehingga secara signifikan mengurangi downtime. Bagian berikut menjelaskan bagaimana instans dengan solusi pemulihan bencana berbeda menanggapi kegagalan.
Menanggapi kegagalan node
Saat node master gagal:
Jika instans memiliki beberapa replika dalam satu zona (misalnya, satu node master dan satu node replika): Sistem menjadikan node replika dengan latensi replikasi terendah sebagai node master baru dan memperbarui informasi routing.
Jika instans diterapkan di beberapa zona: Sistem menjadikan node replika di zona lain sebagai node master baru dan memperbarui informasi routing. Namun, hal ini dapat menyebabkan akses lintas zona antara instans Anda dan layanan lainnya.
CatatanPada arsitektur kluster multi-zona, jika node replika ada di kedua zona (utama dan sekunder), failover akan memprioritaskan menjadikan node replika dari zona utama sebagai master baru. Hal ini menghindari akses lintas zona untuk aplikasi Anda.
Failover memprioritaskan pemulihan layanan. Saat node master gagal, sistem menjadikan node replika dengan latensi replikasi terkecil sebagai node master baru. Penulisan data yang belum disinkronkan ke node replika selama failover mungkin hilang, dan jumlah data yang hilang bergantung pada latensi replikasi master-replika pada saat failover terjadi. Jika node master gagal lagi saat node replika tidak tersedia, skenario ini melebihi kemampuan pemulihan bencana otomatis dan memerlukan pemulihan manual oleh engineer.
Menanggapi kegagalan tingkat zona
Saat terjadi kegagalan tingkat zona, seperti pemadaman listrik atau kebakaran yang menyebabkan seluruh pusat data tidak tersedia:
Jika instans diterapkan di satu zona: Instans menjadi tidak tersedia. Anda harus menunggu zona tersebut pulih. Selama waktu ini, Anda dapat membuat instans baru di zona lain menggunakan data backup historis.
Jika instans diterapkan di beberapa zona: Sistem memicu failover otomatis.
Untuk keandalan maksimal, penerapan di beberapa zona dan pembuatan beberapa replika di setiap zona dapat secara signifikan meminimalkan downtime. Namun, Anda harus menyeimbangkan probabilitas kegagalan, pentingnya data Anda, dan biaya yang terkait.
Prinsip-prinsip di atas juga berlaku untuk instans anak Global Distributed Cache. Kegagalan satu instans anak tidak memengaruhi ketersediaan instans anak lainnya. Kami menyarankan agar instans anak diterapkan di beberapa zona untuk mencegah kegagalan penulisan data jika satu instans anak gagal.
Menanggapi kegagalan tingkat wilayah
Data backup otomatis disimpan di wilayah yang sama dengan instans. Jika terjadi bencana tingkat wilayah, data backup tersebut juga menjadi tidak tersedia. Untuk menerapkan pemulihan bencana cross-region, konfigurasikan instans Tair (Redis OSS-compatible) Global Distributed Cache atau gunakan Data Transmission Service (DTS) untuk menyinkronkan data lintas wilayah. Untuk informasi selengkapnya tentang Global Distributed Cache, lihat Global Distributed Cache.
Dokumen terkait
Hindari Failover Lintas Zona dengan Menyesuaikan Jumlah Node