Pengaturan Ketersediaan Tinggi (HA) aktif/standby tradisional memerlukan intervensi manual selama failover dan tidak dapat menjamin zero data loss. PolarDB-X Standard Edition menggantikan model tersebut dengan arsitektur multi-replika berbasis Paxos yang menyediakan Recovery Point Objective (RPO) nol dan pergantian HA otomatis di semua mode penyebaran.
Mode penyebaran
PolarDB-X mendukung tiga mode penyebaran untuk memenuhi berbagai kebutuhan ketersediaan dan disaster recovery.
| Mode penyebaran | Deskripsi |
|---|---|
| Single zone | Menyebarkan semua node dalam satu zona. Cocok untuk pengembangan, pengujian, atau beban kerja yang toleran terhadap gangguan tingkat zona. |
| Three zones | Menyebarkan node di tiga zona dalam satu wilayah. Cocok untuk beban kerja produksi yang memerlukan redundansi tingkat zona. |
| Three data centers across two regions | Menyebarkan node di tiga pusat data di dua wilayah. Cocok untuk sistem mission-critical yang memerlukan cross-region disaster recovery. |
Ketiga mode tersebut menggunakan konsensus Paxos untuk menjamin RPO nol. Pilih mode berdasarkan cakupan disaster recovery dan topologi jaringan Anda.
Cara kerja
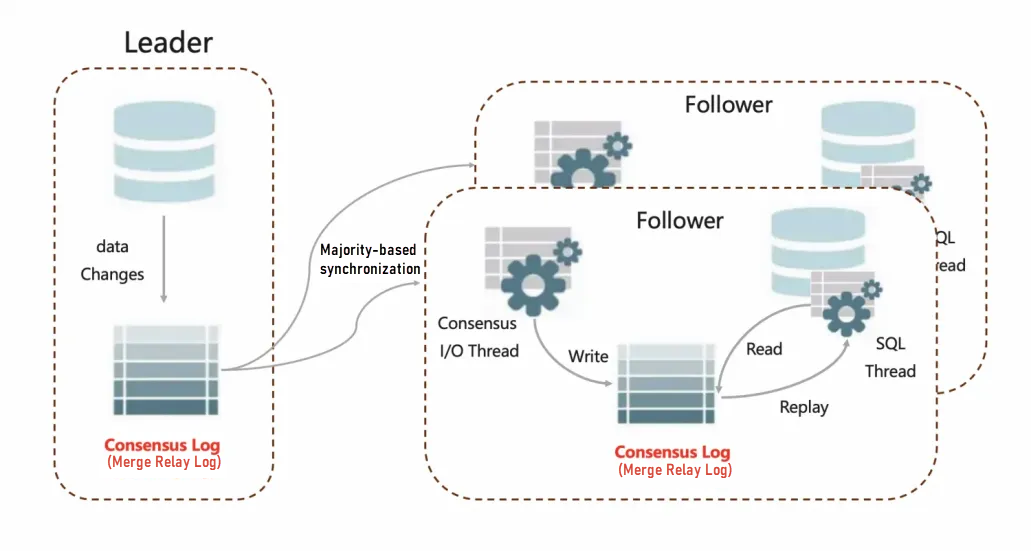
Saat sebuah node gagal dalam kluster database multi-node, muncul dua masalah: operasi write yang sedang berjalan mungkin hilang, dan kluster harus memilih leader baru tanpa campur tangan manusia. Paxos, sebuah algoritma konsensus, mengatasi keduanya dengan mewajibkan mayoritas node mengonfirmasi setiap operasi write sebelum dikomit, serta mengotomatiskan pemilihan leader melalui mekanisme heartbeat dan timeout.
Kluster PolarDB-X Standard Edition beroperasi dalam model single-leader:
Leader node: Satu-satunya node yang menerima operasi write. Node ini menambahkan event konsensus ke protokol log biner sebelum menyebarkan entri log ke follower.
Follower nodes: Berpartisipasi dalam voting mayoritas dan melakukan sinkronisasi data. Alih-alih menggunakan MySQL relay log tradisional, node follower menggunakan log konsensus Paxos yang mengintegrasikan konten log biner MySQL. Thread SQL memutar ulang log ini ke file data.
Pemilihan leader: Saat node follower mendeteksi bahwa leader tidak tersedia, mereka secara otomatis memilih leader baru. Leader baru tersebut tidak melayani traffic hingga thread SQL menyelesaikan pemutaran ulang semua log yang ada ke file data, sehingga konsistensi terjamin sebelum operasi write dilanjutkan.
Manfaat
| Manfaat | Cara kerja |
|---|---|
| Zero RPO | Mekanisme sinkronisasi berbasis mayoritas memastikan setiap operasi write yang dikomit telah dikonfirmasi oleh kuorum node sebelum berhasil. Tidak ada data yang dikomit hilang saat failover. |
| Automatic HA | Node follower terus-menerus memantau leader melalui heartbeat. Saat terjadi kegagalan, mereka memilih leader baru tanpa intervensi manual, menggantikan model HA aktif/standby tradisional. |
| High performance | Model write single-leader memberikan performa yang sebanding dengan replikasi semi-sync MySQL, dengan jaminan tambahan zero data loss. |
Tip: Untuk meningkatkan efisiensi pemilihan leader selama failover lintas pusat data, atur nilai ELECTION_WEIGHT yang lebih tinggi untuk replica di pusat data yang sama guna meningkatkan peluang mereka memenangkan pemilihan.Memantau status replica
Tiga tampilan sistem memungkinkan Anda memeriksa kluster Paxos pada tingkat detail yang berbeda.
Meminta informasi replica global
Mengembalikan status semua replica dalam kluster. Hanya node leader yang mengembalikan hasil; node non-leader tidak mengembalikan baris apa pun.
SELECT * FROM INFORMATION_SCHEMA.ALISQL_CLUSTER_GLOBAL;Contoh output:
+-----------+------------------+-------------+------------+----------+-----------+------------+-----------------+----------------+---------------+------------+--------------+
| SERVER_ID | IP_PORT          | MATCH_INDEX | NEXT_INDEX | ROLE     | HAS_VOTED | FORCE_SYNC | ELECTION_WEIGHT | LEARNER_SOURCE | APPLIED_INDEX | PIPELINING | SEND_APPLIED |
+-----------+------------------+-------------+------------+----------+-----------+------------+-----------------+----------------+---------------+------------+--------------+
|         1 | 10.0.3.244:14886 |           1 |          0 | Leader   | Yes       | No         |               5 |              0 |             0 | No         | No           |
|         2 | 10.0.3.245:14886 |           1 |          2 | Follower | Yes       | No         |               5 |              0 |             1 | Yes        | No           |
|         3 | 10.0.3.246:14886 |           1 |          2 | Follower | No        | No         |               5 |              0 |             1 | Yes        | No           |
+-----------+------------------+-------------+------------+----------+-----------+------------+-----------------+----------------+---------------+------------+--------------+
3 rows in set (0.00 sec)
Kolom utama:
| Kolom | Deskripsi |
|---|---|
IP_PORT | Alamat IP dan Port replica |
ROLE | Peran replica: Leader, Follower, atau Learner |
ELECTION_WEIGHT | Bobot pemilihan. Berlaku untuk skenario disaster recovery lintas data center. Atur nilai yang lebih tinggi untuk replica di data center yang sama guna meningkatkan peluang mereka memenangkan pemilihan. |
MATCH_INDEX / NEXT_INDEX / APPLIED_INDEX | Indeks log konsensus |
Meminta status node lokal
Mengembalikan status Paxos dari sistem lokal.
SELECT * FROM INFORMATION_SCHEMA.ALISQL_CLUSTER_LOCAL\GContoh output:
*************************** 1. row ***************************
          SERVER_ID: 1
       CURRENT_TERM: 6
     CURRENT_LEADER: 10.0.3.244:14886
       COMMIT_INDEX: 1
      LAST_LOG_TERM: 6
     LAST_LOG_INDEX: 1
               ROLE: Leader
          VOTED_FOR: 1
   LAST_APPLY_INDEX: 0
SERVER_READY_FOR_RW: Yes
      INSTANCE_TYPE: Normal
Kolom utama:
| Kolom | Deskripsi |
|---|---|
CURRENT_LEADER | Alamat IP dan port node leader saat ini |
ROLE | Peran node ini: Leader, Follower, atau Learner |
SERVER_READY_FOR_RW | Apakah node ini siap melayani traffic baca/tulis. Selama pemilihan leader, leader baru mengembalikan No hingga pemutaran ulang log selesai. |
INSTANCE_TYPE | Jenis replica. Nilai yang valid: Normal dan Log |
Meminta kesehatan replikasi
Mengembalikan status sinkronisasi antara leader dan setiap follower. Hanya node leader yang mengembalikan hasil.
SELECT * FROM INFORMATION_SCHEMA.ALISQL_CLUSTER_HEALTH;Contoh output:
+-----------+------------------+----------+-----------+---------------+-----------------+
| SERVER_ID | IP_PORT          | ROLE     | CONNECTED | LOG_DELAY_NUM | APPLY_DELAY_NUM |
+-----------+------------------+----------+-----------+---------------+-----------------+
|         1 | 10.0.3.244:14886 | Follower | YES       |             0 |              22 |
|         2 | 10.0.3.245:14886 | Leader   | YES       |             0 |               0 |
|         3 | 10.0.3.246:14886 | Follower | YES       |             0 |              11 |
+-----------+------------------+----------+-----------+---------------+-----------------+
Kolom utama:
| Kolom | Deskripsi |
|---|---|
CONNECTED | Apakah node dapat dijangkau dan beroperasi secara normal |
LOG_DELAY_NUM | Latensi sinkronisasi log konsensus dalam Paxos, yang mirip dengan latensi sinkronisasi relay log dalam MySQL |
APPLY_DELAY_NUM | Delay pemutaran ulang log konsensus Paxos pada node follower, yang mirip dengan delay pemutaran ulang thread SQL relay dalam MySQL |