Fitur Indeks Kolom (IMCI) pada PolarDB for PostgreSQL Distributed Edition mengintegrasikan mesin analitik DuckDB untuk meningkatkan performa kueri analitik lebih dari 60 kali lipat. Dikombinasikan dengan mekanisme sharding transparan dari arsitektur terdistribusinya, kueri dapat didorong ke beberapa node data (DNs) untuk pemrosesan paralel, sehingga performa analitik dapat diskalakan secara linear seiring peningkatan jumlah node. Untuk set data berskala terabyte hingga petabyte, kombinasi arsitektur terdistribusi dan IMCI dapat meningkatkan performa analitik keseluruhan hampir 100 kali lipat dibandingkan implementasi row-store, menjadikannya ideal untuk skenario HTAP (Hybrid Transactional and Analytical Processing).
Architecture
Arsitektur terdistribusi dengan IMCI mencakup komponen inti berikut:
Coordinator node (CN): Menerima permintaan, menghasilkan rencana eksekusi terdistribusi, mendorong kueri SQL ke node data, serta mengagregasi hasil dari semua DN sebelum mengembalikannya ke klien.
Data node (DN): Menyimpan data dalam format row-store maupun column-store (IMCI). Data dari row-store ditulis secara asinkron ke column-store melalui replikasi logis. Proses ini memastikan bahwa akselerasi analitik kompatibel dengan penulisan data real-time.
Contoh berikut menggambarkan alur kerja untuk kueri agregasi analitik tipikal:
CN menghasilkan rencana terdistribusi dan mengirimkan kueri SQL. CN menerima permintaan SQL bisnis, menghasilkan rencana eksekusi terdistribusi berdasarkan metadata global, lalu menentukan cara membagi dan mendorong kueri ke node data yang relevan.
DN melakukan kueri paralel pada data IMCI. CN mendorong kueri ke DN target. Setiap DN menjalankan kueri paralel yang efisien dan melakukan agregasi awal pada data IMCI lokalnya, kemudian mengembalikan hasil antara ke CN.
CN melakukan agregasi akhir dan mengembalikan hasil. CN mengumpulkan hasil kueri dari semua DN, melakukan agregasi akhir atau pengurutan jika diperlukan, lalu mengembalikan hasil akhir ke pengguna atau aplikasi.
Use cases
Fitur ini ideal untuk skenario database multi-tenant, terutama ketika Anda perlu melakukan rollup dan agregasi global secara efisien lintas data tenant. Fitur ini berlaku untuk dua skenario sharding berikut:
Horizontal sharding (berdasarkan tenant_id)
Pertimbangkan tabel bisnis bernama orders yang menggunakan tenant_id sebagai kunci sharding.
Agregasi data untuk satu tenant: Hitung total dan rata-rata jumlah pesanan untuk tenant tertentu.
SELECT SUM(amount) AS total_amount, AVG(amount) AS avg_amount
FROM orders
WHERE tenant_id = 1001;
Agregasi data lintas semua tenant: Hitung total dan rata-rata jumlah pesanan untuk semua tenant, dikelompokkan berdasarkan tenant.
SELECT tenant_id, SUM(amount) AS total_amount, AVG(amount) AS avg_amount
FROM orders
GROUP BY tenant_id;
Vertical sharding (berdasarkan schema)
Pertimbangkan bahwa data setiap tenant disimpan dalam schema terpisah, dan nama tabelnya adalah orders di semua schema.
Agregasi data untuk satu schema: Hitung total dan rata-rata jumlah pesanan dalam schema tertentu.
SELECT SUM(amount) AS total_amount, AVG(amount) AS avg_amount
FROM tenant_a.orders;
Agregasi data lintas semua tenant: Hitung total dan rata-rata jumlah pesanan untuk semua tenant dengan menggunakan
UNION ALL.SELECT 'tenant_a' AS tenant, SUM(amount) AS total_amount, AVG(amount) AS avg_amount FROM tenant_a.orders UNION ALL SELECT 'tenant_b' AS tenant, SUM(amount) AS total_amount, AVG(amount) AS avg_amount FROM tenant_b.orders;
Prerequisites
Pastikan sharding telah dikonfigurasi untuk tabel tenant. Untuk informasi selengkapnya, lihat Buat dan kelola tabel terdistribusi serta tabel referensi.
Versi kluster:
PostgreSQL 16 dengan versi minor kernel 2.0.16.11.14.0 atau lebih baru.
PostgreSQL 14 dengan versi minor kernel 2.0.14.20.43.0 atau lebih baru.
Konfigurasikan indeks kolom terdistribusi
Langkah 1: Aktifkan IMCI terdistribusi
Anda dapat mengubah parameter berikut di Konsol PolarDB atau dalam sesi database:
Parameter | Deskripsi |
| Mengaktifkan atau menonaktifkan fitur indeks kolom terdistribusi.
|
| Mengontrol apakah ekspresi IN dalam klausa WHERE dapat menggunakan indeks kolom terdistribusi.
|
| Mengaktifkan atau menonaktifkan fitur hint terdistribusi.
|
SET polar_cluster_enable_imci = on;
SET polar_csi.enable_anyall_to_in = on;
SET pg_hint_plan.polar_enable_distributed_hint = on;
Langkah 2: Buat slot replikasi
Gunakan akun dengan hak istimewa tinggi untuk menjalankan perintah berikut pada CN primary. Ini akan membuat slot replikasi di semua node untuk sinkronisasi antara row-store dan column-store.
SELECT run_command_on_all_nodes($$ SELECT polar_csi_start_sync() $$);Operasi ini bersifat idempoten, artinya dapat dijalankan berulang kali tanpa efek samping.
Langkah 3: Buat dan shard tabel tenant
Horizontal sharding
Buat tabel terdistribusi menggunakan tenant_id sebagai kunci sharding:
Jika Anda menggunakan tenant_id sebagai kunci sharding, kunci tersebut harus menjadi primary key atau bagian dari primary key.
-- Buat tabel bisnis awal dengan tenant_id sebagai bagian dari primary key
CREATE TABLE orders (
  order_id   bigint,
  tenant_id  int NOT NULL,
  amount     numeric(20,2),
  status     text,
  create_time timestamp,
  PRIMARY KEY (tenant_id, order_id)
);

-- Ubah menjadi tabel sharded terdistribusi
SELECT create_distributed_table('orders', 'tenant_id');
Vertical sharding
Simpan data setiap tenant dalam schema terpisah:
-- Buat schema untuk tenant
CREATE SCHEMA tenant1;

-- Aktifkan manajemen terdistribusi untuk schema
SELECT polar_cluster_schema_distribute('tenant1');

-- Buat tabel bisnis
SET search_path TO tenant1;

CREATE TABLE orders (
  order_id   bigint,
  tenant_id  int NOT NULL,
  amount     numeric(20,2),
  status     text,
  create_time timestamp,
  PRIMARY KEY (tenant_id, order_id)
);
Langkah 4: Buat indeks kolom
Buat indeks kolom (CSI) pada tabel:
-- Buat indeks kolom pada semua kolom
CREATE INDEX csi_orders ON orders USING CSI;

-- Buat indeks kolom pada kolom tertentu (misalnya, untuk kueri pada tenant_id, order_id, dan amount)
CREATE INDEX csi_orders_part ON orders1 USING CSI(tenant_id, order_id, amount);

-- Buat indeks kolom tanpa mengunci tabel (Direkomendasikan)
CREATE INDEX CONCURRENTLY csi_orders ON orders USING CSI;Kami merekomendasikan membuat CSI pada semua kolom untuk mencegah kueri column-store gagal karena kolom yang tidak tersedia.
Langkah 5: Jalankan kueri dengan indeks kolom
Dua parameter mengontrol apakah kueri menggunakan indeks kolom:
Parameter | Deskripsi |
| Mengontrol apakah kueri dapat menggunakan indeks kolom.
|
| Menetapkan ambang batas biaya untuk kueri. Jika estimasi biaya melebihi ambang batas ini, kueri akan menggunakan mesin column-store. Jika tidak, kueri akan menggunakan mesin row-store.
|
Kami merekomendasikan menggunakan hint untuk memaksa kueri tertentu menggunakan indeks kolom:
/*+SET (polar_csi.enable_query on) SET(polar_csi.cost_threshold 0)*/
SELECT tenant_id, SUM(amount) AS total_amount, AVG(amount) AS avg_amount
FROM orders
GROUP BY tenant_id;
Anda juga dapat mengatur parameter ini secara global atau per akun pengguna. Untuk mengaturnya secara global, ubah parameter di Konsol PolarDB. Untuk mengaturnya per pengguna, jalankan pernyataan berikut pada CN primary:
-- Prioritaskan penggunaan indeks kolom untuk pengguna 'test'
ALTER ROLE test SET polar_csi.enable_query = ON;
ALTER ROLE test SET polar_csi.cost_threshold = 0;
Langkah 6: Verifikasi penggunaan indeks kolom
Anda dapat menggunakan EXPLAIN untuk analisis. Jika CSI Executor muncul dalam rencana eksekusi, hal ini menunjukkan bahwa indeks kolom berhasil digunakan:
/*+SET (polar_csi.enable_query on) SET(polar_csi.cost_threshold 0)*/
EXPLAIN (COSTS OFF) SELECT tenant_id, SUM(amount) AS total_amount, AVG(amount) AS avg_amount
FROM orders
GROUP BY tenant_id;
Cuplikan output contoh (Kemunculan CSI Executor menunjukkan bahwa kueri menggunakan mesin column-store):
                       QUERY PLAN
---------------------------------------------------------
 Custom Scan (PolarCluster Adaptive)
   Task Count: 32
   Tasks Shown: One of 32
   ->  Task
         Node: host=127.0.0.1 port=45719 dbname=postgres
         ->  CSI Executor:
             ┌───────────────────────────┐
             │       HASH_GROUP_BY       │
             │    ────────────────────   │
             │        Aggregates:        │
             │          sum(#1)          │
             │          avg(#2)          │
             └─────────────┬─────────────┘
             ┌─────────────┴─────────────┐
             │         SEQ_SCAN          │
             │    ────────────────────   │
             │    Table: orders_102008   │
             │   Type: Sequential Scan   │
             └───────────────────────────┘
Performance
Pengujian berikut menunjukkan skalabilitas horizontal dan performa arsitektur terdistribusi yang dikombinasikan dengan IMCI dalam berbagai skenario pemrosesan data. Setiap DN dalam lingkungan pengujian memiliki 16 core dan memori 64 GB.
Pengujian Sysbench Online Transaction Processing (OLTP): Pengujian ini mengevaluasi performa database di bawah operasi transaksional berkonkurensi tinggi seperti insert, update, dan delete. Seiring peningkatan jumlah node data (DNs), throughput write sistem meningkat hampir secara linear untuk mendukung pertumbuhan trafik bisnis.
Pengujian TPC-H Online Analytical Processing (OLAP): Pengujian ini berfokus pada performa agregasi data skala besar dan kueri analitik kompleks. IMCI secara signifikan meningkatkan performa analitik single-node, sedangkan arsitektur terdistribusi memaralelkan kueri lintas beberapa DN. Kombinasi ini memungkinkan performa kueri meningkat secara linear seiring peningkatan jumlah node, sehingga cocok untuk menganalisis dan mendapatkan insight dari dataset masif.
Pengujian performa TPC-H
Menggunakan dataset TPC-H 1 TB, kami mengukur latensi kueri dengan konfigurasi 1, 2, 4, 8, dan 12 DN.
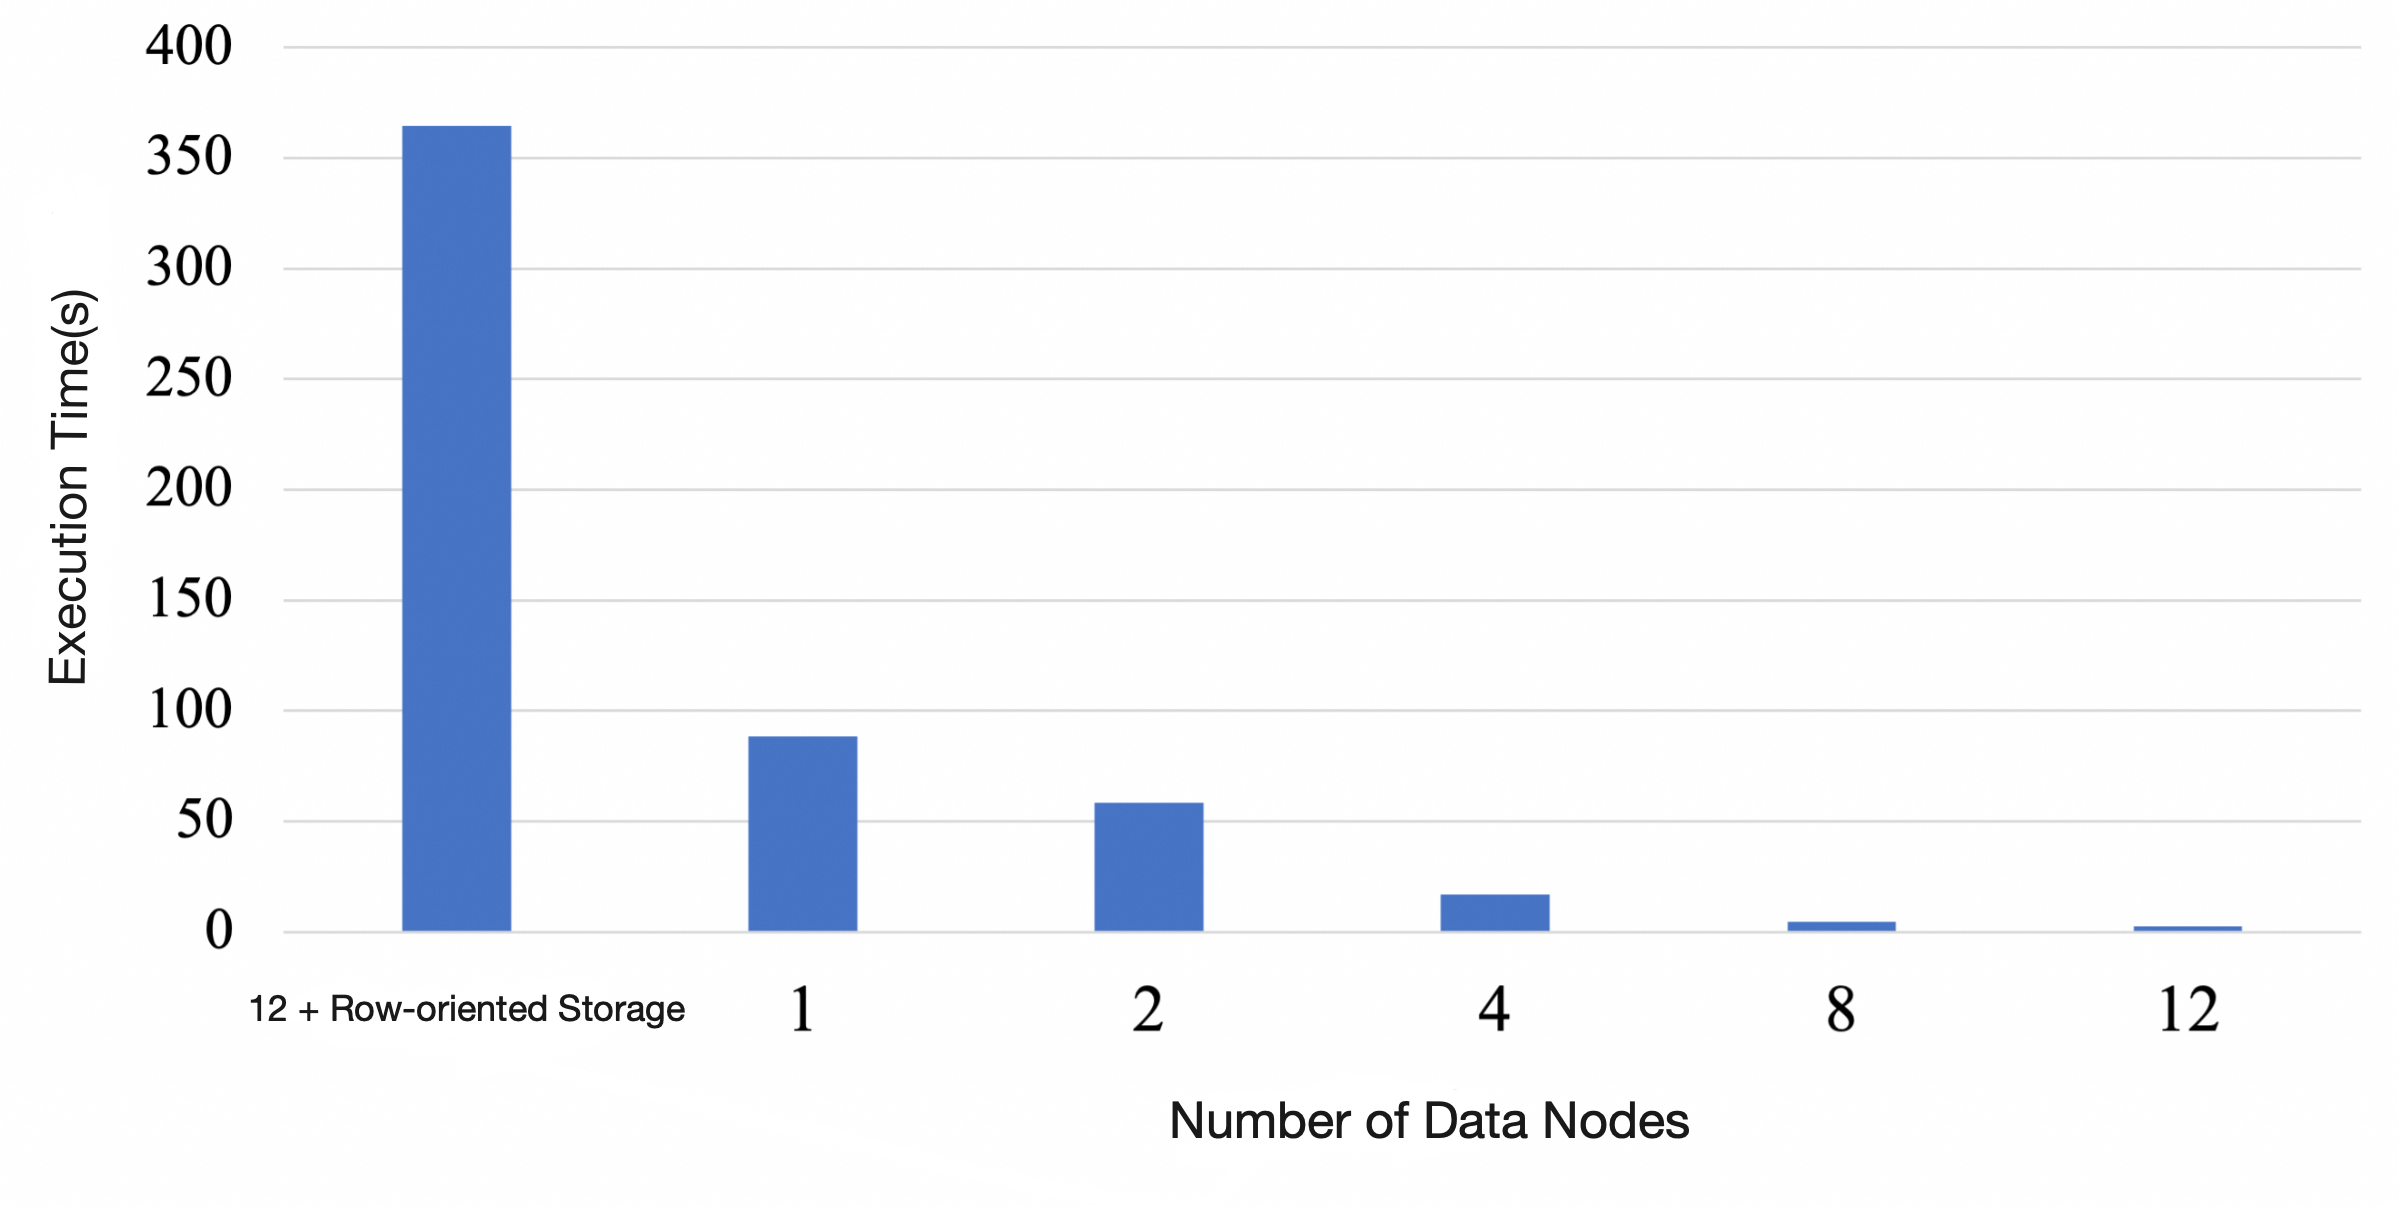
Hasil pengujian menunjukkan bahwa:
Latensi kueri column-store terdistribusi lebih dari 100 kali lebih rendah dibandingkan row-store terdistribusi, dan performanya meningkat secara linear.
Dibandingkan kueri kolom single-node, arsitektur terdistribusi dengan IMCI juga mencapai peningkatan performa linear seiring peningkatan jumlah DN. Konfigurasi 12-DN memberikan peningkatan performa sepuluh kali lipat dibandingkan setup single-node.
Pengujian Sysbench OLTP_INSERT
Kami mengukur QPS write kluster terdistribusi dengan konfigurasi 1, 2, 4, 8, dan 12 DN.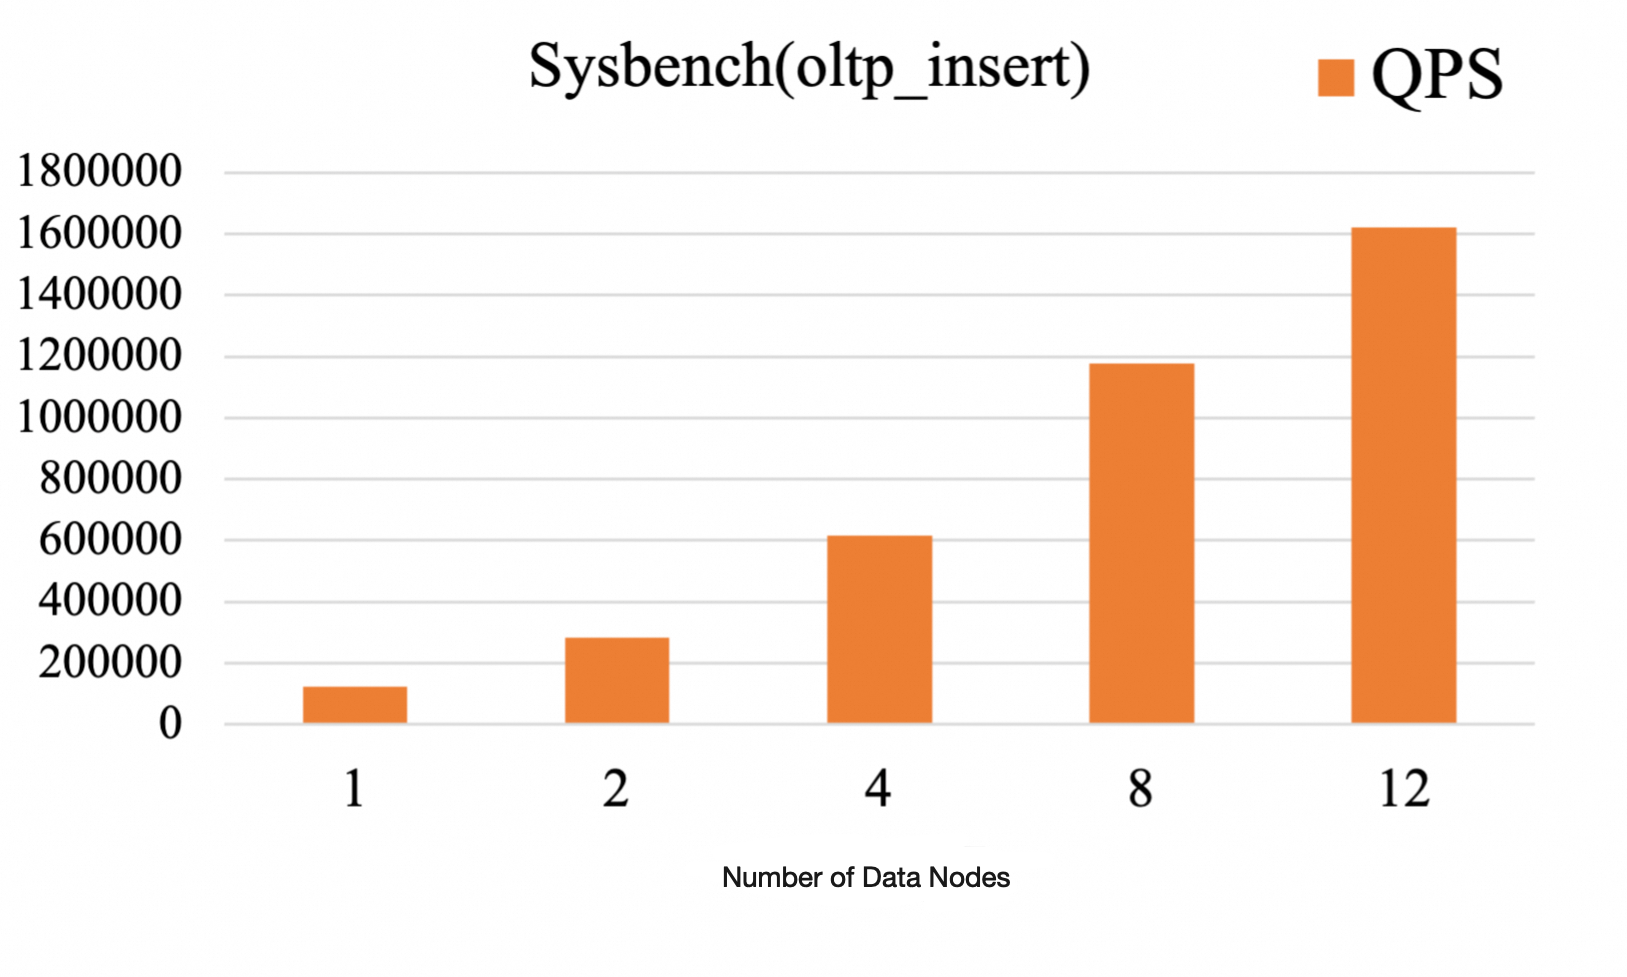
Hasil pengujian menunjukkan bahwa:
QPS write meningkat secara linear seiring peningkatan jumlah DN: Saat jumlah DN meningkat dari 1 ke 12, QPS write menunjukkan pertumbuhan hampir linear, mencapai maksimum 1,6 juta QPS dengan 12 DN.
Arsitektur terdistribusi menskalakan sinkronisasi data secara horizontal: Arsitektur multi-DN paralel meningkatkan performa write dan memperkuat replay replikasi logis. Hal ini memungkinkan sinkronisasi data dari row-store ke column-store (IMCI) secara near real-time.