Untuk meningkatkan kemampuan In-Memory Column Index (IMCI) dalam menangani kueri kompleks, pengoptimal IMCI menggabungkan aturan transformasi kueri dengan statistik dari kolom tabel dan menggunakan optimasi berbasis biaya untuk menghasilkan rencana eksekusi yang efisien. Topik ini menjelaskan cara kerja fitur optimasi kueri IMCI, penggunaannya, serta batasannya.
Cara kerja
SQL adalah bahasa deklaratif, artinya ia menentukan hasil yang harus dikembalikan tetapi tidak menentukan cara menghitungnya. Untuk setiap pernyataan SQL tertentu, beberapa rencana kueri yang valid dapat menghasilkan hasil yang benar. Contohnya:
SELECT * FROM t0, t1, t2, t3 WHERE t0.a = t1.a AND t1.a = t2.a AND t2.a = t3.a AND t3.b = t1.b;Untuk pernyataan SQL di atas, kedua rencana kueri berikut dapat mengembalikan hasil yang benar.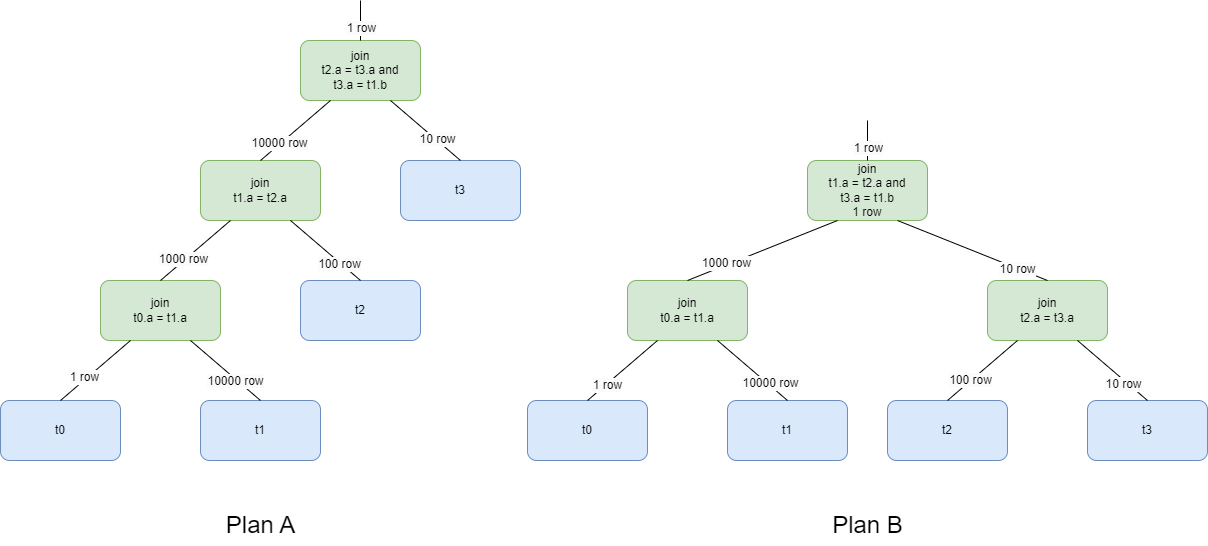 Rencana A dan Rencana B dikenal sebagai equivalent query plans. Pengoptimal mengeksplorasi rencana kueri yang setara untuk suatu pernyataan SQL dengan menerapkan transformasi. Misalnya,
t1 INNER JOIN t2 dan t2 INNER JOIN t1 merupakan sepasang rencana kueri yang setara. Pengoptimal dapat menghasilkan t2 INNER JOIN t1 dari t1 INNER JOIN t2. Jenis transformasi ini disebut query transformation rule.
Pengoptimal kueri mengikuti alur kerja berikut:
-
Pengoptimal menerima rencana kueri awal yang dihasilkan oleh database melalui penguraian pernyataan SQL.
-
Kemudian, pengoptimal menerapkan aturan transformasi kueri pada rencana awal untuk menghasilkan rencana kueri yang setara.
-
Menggunakan statistik dan model biaya, pengoptimal memilih rencana dengan estimasi biaya eksekusi terendah dan meneruskannya ke mesin eksekusi sebagai rencana eksekusi akhir.
Fitur optimasi kueri bergantung pada statistik untuk melakukan estimasi kardinalitas dan perhitungan biaya guna menentukan rencana kueri terbaik. Di IMCI, statistik tabel mencakup hal-hal berikut:
-
Histogram menggambarkan distribusi nilai suatu kolom dan terutama digunakan untuk memperkirakan selektivitas rentang nilai dan predikat kesetaraan pada satu tabel.
-
Jumlah nilai unik dalam suatu kolom terutama digunakan untuk memperkirakan jumlah kelompok dalam klausa
Group Bydan juga dapat membantu memperkirakan selektivitas predikat kesetaraan. -
Kendala lainnya, seperti apakah kolom memiliki indeks unik atau kendala kunci asing.
Pengoptimal kueri menghitung biaya setiap operator dalam rencana kueri berdasarkan dua faktor:
-
Jumlah total baris yang diproses oleh operator, yang dapat diperkirakan dari statistik.
-
Kompleksitas algoritmik setiap operator yang digunakan dalam rencana kueri.
Jumlah total baris yang diproses oleh suatu operator merupakan parameter dalam fungsi kompleksitasnya. Total biaya eksekusi suatu rencana kueri adalah jumlah biaya semua operatornya. Untuk dua rencana kueri pada gambar sebelumnya, jika kita mengasumsikan algoritma hash join digunakan, rumus biayanya adalah:
Costjoin=Cardinner+Cardouter
Biaya kedua rencana eksekusi tersebut adalah sebagai berikut:
CostA=10000+1+1000+100+10000+10=21111
CostB=10000+1+100+10+1000+10=11121
Perhitungan tersebut menunjukkan bahwa Rencana B memiliki biaya eksekusi lebih rendah. Oleh karena itu, pengoptimal memilih Rencana B sebagai rencana eksekusi akhir.
Prasyarat
Kluster PolarDB Anda harus memenuhi salah satu persyaratan versi berikut:
-
PolarDB for MySQL 8.0.1 dengan revisi 8.0.1.1.31 atau yang lebih baru.
-
PolarDB for MySQL 8.0.2 dengan revisi 8.0.2.2.12 atau yang lebih baru.
Anda dapat melihat nomor versi kluster Anda untuk memastikan versi kluster Anda.
Batasan
Skenario berikut dapat menyebabkan kesalahan signifikan dalam estimasi kardinalitas, yang mungkin membuat pengoptimal memilih rencana kueri suboptimal. Anda dapat menggunakan sintaks HINT untuk mengarahkan pengoptimal ke rencana kueri yang lebih baik.
-
Kueri dengan predikat yang menggunakan operator perbandingan pada kolom berbeda dalam tabel yang sama, seperti
t1.c1>t1.c2. -
Kueri dengan predikat yang menggunakan operator yang tidak dapat diperkirakan menggunakan statistik, seperti
t1.c1 MOD 2=1ataut1.c2 LIKE '%ABC%'. -
Kueri dengan predikat yang berisi ekspresi yang tidak dapat dihitung selama optimasi, seperti
t1.c1+t1.c3>100. -
Kueri di mana kolom yang terlibat dalam suatu operator tidak memiliki statistik yang diperlukan untuk memperkirakan selektivitas predikat, seperti
SELECT a, SUM(b) FROM t1 HAVING SUM(b) > 10. -
Beberapa predikat dihubungkan oleh operator
AND, sepertit1.c1>10 AND t1.c3<5. -
Kueri memiliki terlalu banyak lapisan bersarang.
-
Kueri melakukan join terhadap terlalu banyak tabel. Anda dapat menyesuaikan jumlah join yang dicari oleh pengoptimal IMCI dengan mengubah parameter
loose_imci_max_enum_join_pairs.
Parameter
Anda dapat mengonfigurasi parameter berikut di Konsol untuk mengaktifkan dan menggunakan fitur optimasi kueri IMCI. Untuk petunjuk cara mengatur parameter, lihat Tentukan parameter kluster dan node.
|
Parameter |
Deskripsi |
|
loose_imci_optimizer_switch |
Mengontrol fitur optimasi kueri IMCI. Terdiri dari flag berikut:
|
|
loose_imci_auto_update_statistic |
Menentukan apakah pengoptimal IMCI secara otomatis mengumpulkan ulang statistik saat statistik tersebut sudah usang. Nilai yang valid:
|
|
loose_imci_max_enum_join_pairs |
Menentukan jumlah maksimum rencana kueri yang setara yang dicari oleh pengoptimal IMCI saat join reorder diaktifkan. Nilai yang valid: 0 hingga 4294967295. Nilai default: 2000. |
Prosedur
Untuk menggunakan fitur optimasi IMCI, Anda harus terlebih dahulu mengumpulkan statistik berdasarkan strategi yang Anda pilih. Setelah mengumpulkan statistik, aktifkan fitur tersebut, lalu jalankan kueri Anda.
-
Kumpulkan statistik.
Anda dapat menggunakan salah satu dari dua strategi berikut untuk mengumpulkan statistik:
-
Jalankan perintah
ANALYZE TABLEsecara berkala pada tabel yang memerlukan optimasi IMCI untuk mengumpulkan statistik terbaru. -
(Direkomendasikan) Untuk tabel yang baru saja diaktifkan IMCI-nya, jalankan perintah
ANALYZE TABLEpada node read-only untuk membangun statistik awal. Kemudian, atur parameterloose_imci_auto_update_statisticke ASYNC agar statistik diperbarui secara otomatis.
-
-
Aktifkan fitur optimasi kueri IMCI.
Anda dapat mengaktifkan fitur optimasi kueri IMCI dengan mengatur parameter
loose_imci_optimizer_switchdi Konsol. -
Jalankan kueri Anda.
Perbandingan performa
Contoh berikut menggunakan TPC-H Q8, yaitu kueri multi-tabel yang mencakup fungsi agregat.
SELECT
  o_year,
  SUM(
    CASE
      WHEN nation = 'BRAZIL' THEN volume
      ELSE 0
    END
  ) / SUM(volume) AS mkt_share
FROM
  (
    SELECT
      EXTRACT(
        year
        FROM
          o_orderdate
      ) AS o_year,
      l_extendedprice * (1 - l_discount) AS volume,
      n2.n_name AS nation
    FROM
      lineitem,
      orders,
      part,
      supplier,
      customer,
      nation n1,
      nation n2,
      region
    WHERE
      p_partkey = l_partkey
      AND s_suppkey = l_suppkey
      AND l_orderkey = o_orderkey
      AND o_custkey = c_custkey
      AND c_nationkey = n1.n_nationkey
      AND n1.n_regionkey = r_regionkey
      AND r_name = 'AMERICA'
      AND s_nationkey = n2.n_nationkey
      AND o_orderdate BETWEEN DATE '1995-01-01'
      AND DATE '1996-12-31'
      AND p_type = 'ECONOMY ANODIZED STEEL'
  ) AS all_nations
GROUP By
  o_year
ORDER BY
o_year;-
Rencana kueri dengan optimasi IMCI dinonaktifkan adalah sebagai berikut:
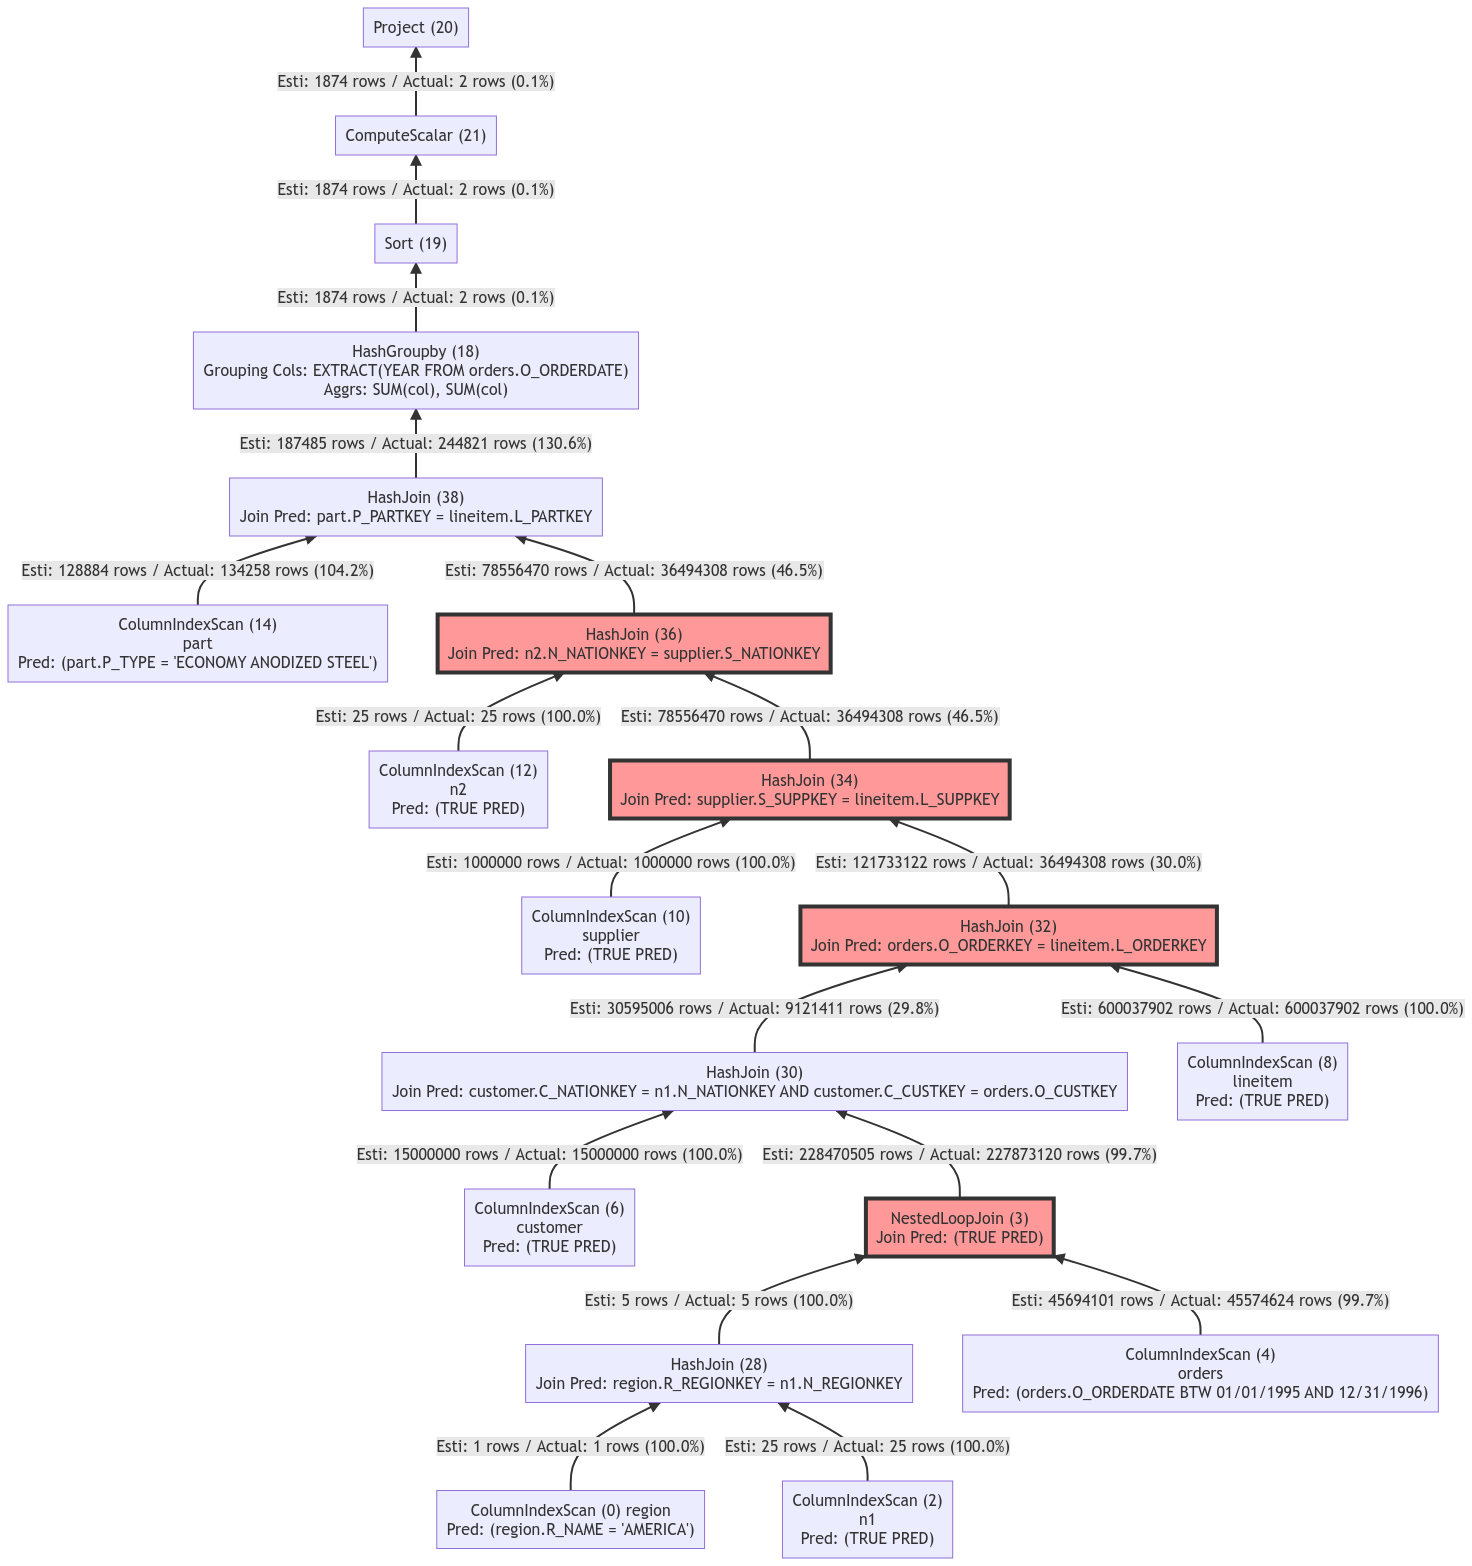 Dalam rencana ini, banyak join menghasilkan set hasil antara yang besar, sehingga meningkatkan volume data dan biaya pemrosesan untuk operator selanjutnya, yang berakibat pada latensi kueri lebih lama. Pada mesin 32-core dengan dataset TPC-H SF100, kueri ini membutuhkan waktu 7.017 ms untuk diselesaikan.
-
Rencana kueri dengan optimasi IMCI diaktifkan adalah sebagai berikut:
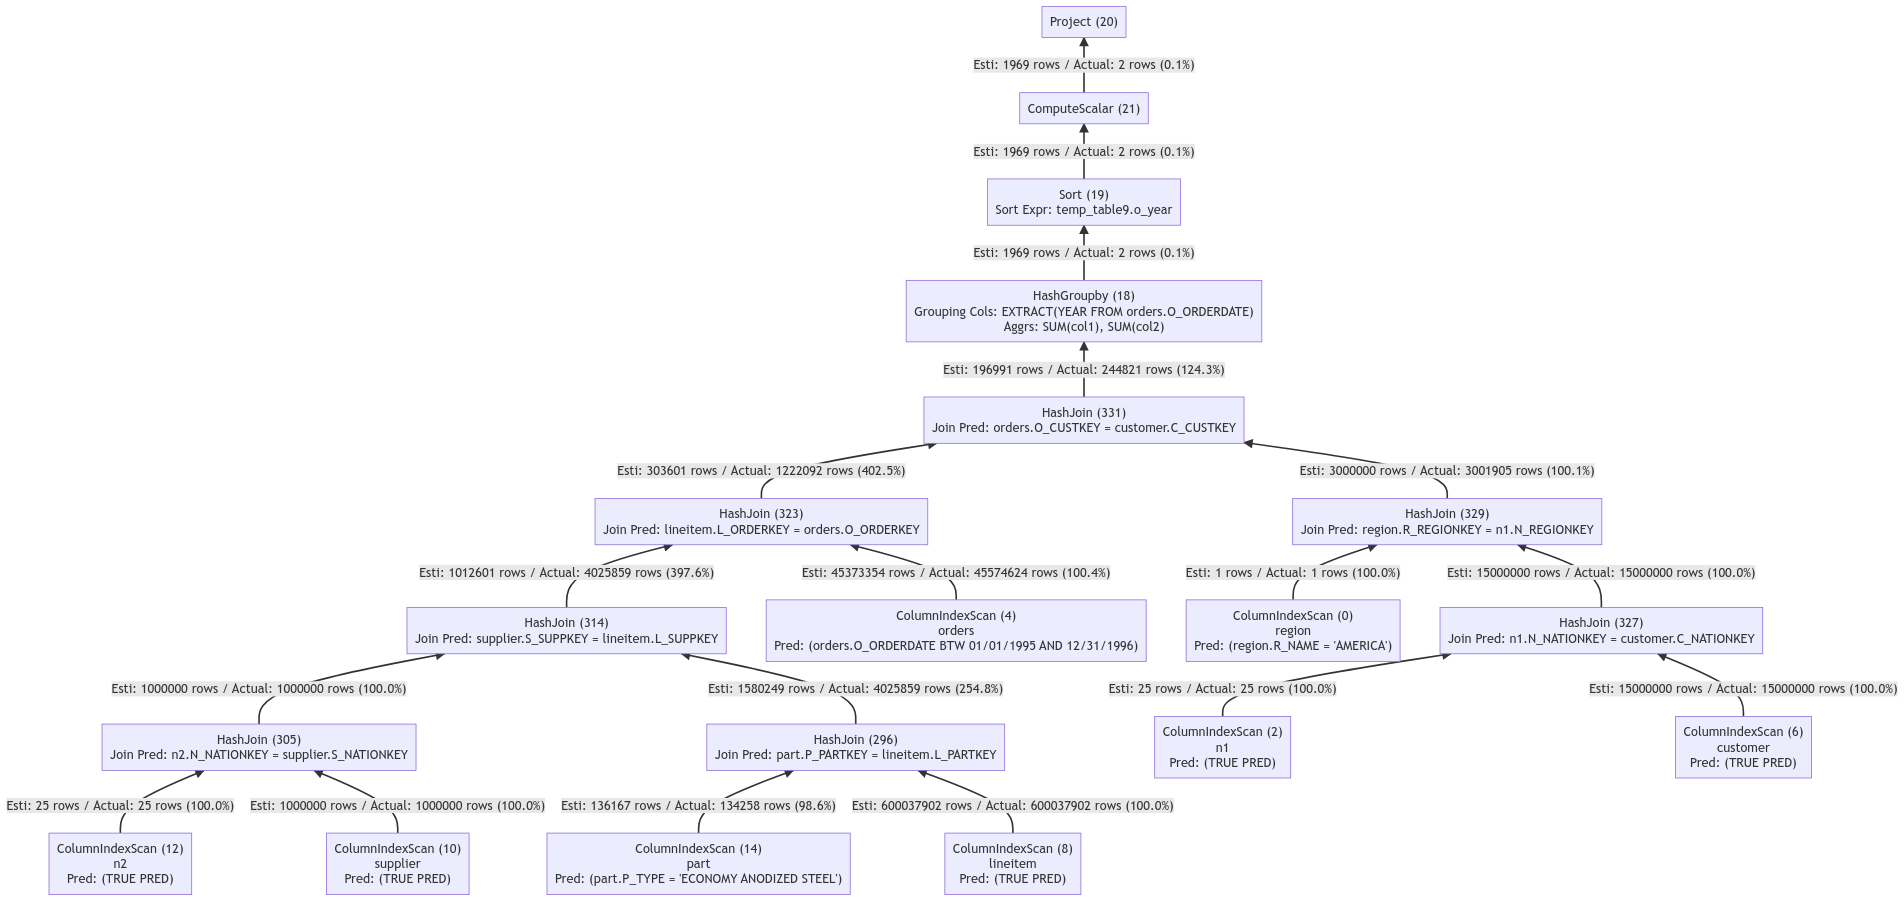 Pengoptimal IMCI mengatur ulang urutan join, sehingga mengurangi ukuran output sebagian besar operator join menjadi jutaan baris. Hal ini secara efektif mengurangi biaya pemrosesan untuk operator selanjutnya. Pada mesin 32-core yang sama dengan dataset TPC-H SF100, kueri ini hanya membutuhkan waktu 1.900 ms untuk diselesaikan, menghasilkan pengurangan waktu kueri sebesar 73%.