Topik ini menjelaskan cara mengelola risiko opini publik dengan menganalisis ulasan pesan antar.
Latar Belakang
Banyak bisnis menggunakan platform daring untuk mengumpulkan umpan balik dari pelanggan. Umpan balik tersebut dapat berupa pujian (positif) atau kritik (negatif). Untuk memastikan kualitas produk sesuai ekspektasi pelanggan, bisnis perlu memahami opini publik. Analisis konten ulasan juga membantu mengidentifikasi tren dan mengarahkan pengembangan produk.
Platform umpan balik daring menghasilkan volume besar ulasan setiap hari. Menganalisis data ulasan dalam jumlah besar secara manual tidak efisien dan seringkali tidak akurat. Oleh karena itu, otomatisasi proses ini sangat penting untuk mengumpulkan dan menilai opini publik secara efektif. Platform PAI menyediakan serangkaian algoritma berbasis vektorisasi dan klasifikasi teks yang memanfaatkan ulasan historis berlabel untuk membangun model klasifikasi guna memprediksi sentimen ulasan baru secara otomatis. Kerangka kerja lengkap tersedia sebagai templat preset di Designer. Berdasarkan set data dunia nyata yang terdiri dari 11.987 ulasan pesan antar berlabel, solusi ini mengotomatiskan manajemen risiko opini publik untuk sentimen positif maupun negatif dengan akurasi sekitar 75%.
Anda dapat menggunakan templat pipeline preset di Designer untuk menyiapkan solusi manajemen risiko opini publik dalam waktu satu hingga dua hari, sehingga memungkinkan analisis ulasan secara cerdas dan berskala besar. Akurasi model meningkat seiring bertambahnya data ulasan yang dikumpulkan. Solusi ini juga dapat diterapkan pada berbagai skenario analisis teks lainnya, seperti penyaringan spam dan klasifikasi sentimen artikel berita.
Set Data
Set data untuk pipeline ini berisi data anonim berlabel dari platform pesan antar dunia nyata. Tabel berikut menjelaskan bidang-bidangnya.
|
Field |
Type |
Description |
|
label |
DOUBLE |
Sentimen label. Nilai yang valid:
|
|
review |
STRING |
Konten ulasan. |
Berikut adalah contoh dari set data tersebut. Ulasan positif (label: 1) meliputi "Makanannya sangat lezat dan luar biasa, saya merasa senang, dan pengirimannya cepat" serta "Pengiriman cepat, makanan tetap enak, jempol!". Ulasan negatif (label: 0) meliputi "Rasanya buruk sekali" dan "Makanannya jelas sisa kemarin, benar-benar berbeda dari yang saya beli sebelumnya."
Membangun pipeline pengendalian risiko
Buka halaman Machine Learning Designer.
Masuk ke Konsol PAI.
Di panel navigasi sebelah kiri, klik Workspaces. Di halaman Workspaces, klik nama ruang kerja yang ingin Anda kelola.
Di panel navigasi sebelah kiri, pilih .
-
Bangun pipeline.
-
Di halaman Designer, klik tab Preset Templates.
-
Di daftar templat, pilih templat Public Opinion Risk Control Based on Takeaway Reviews dan klik Create.
-
Di kotak dialog Create Pipeline, konfigurasikan parameter. Anda dapat menggunakan pengaturan default untuk semua parameter.
Parameter Data Storage menentukan path OSS Bucket untuk menyimpan data sementara dan model yang dihasilkan selama eksekusi pipeline.
-
Klik Confirm.
Pembuatan pipeline memerlukan waktu sekitar 10 detik.
-
Di daftar pipeline, klik ganda pipeline Public Opinion Risk Control Based on Takeaway Reviews.
-
Designer secara otomatis membangun pipeline dari templat preset, seperti yang ditunjukkan di bawah ini.
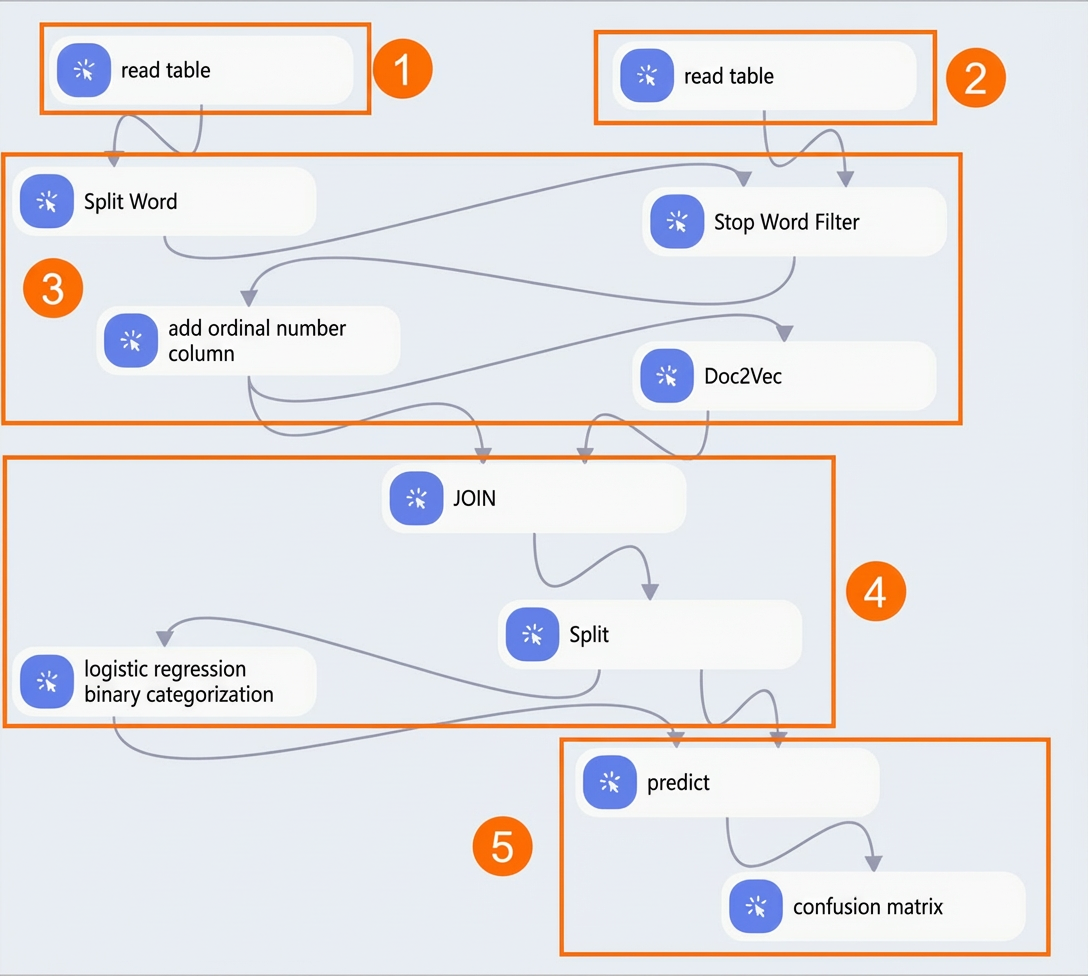
Section
Description
①
Sumber data, yaitu data ulasan.
②
Stopwords. Bagian ini menyaring kata-kata seperti kata bantu dan tanda baca. Anda harus mengunggah daftar stopword secara manual. Misalnya, daftar stop_word berisi entri seperti
$,0hingga9,?, dan_.③
Vektorisasi teks. Algoritma Doc2Vec mengonversi setiap ulasan menjadi vektor semantik. Setiap baris vektor merepresentasikan makna sebuah ulasan. Setelah pipeline dijalankan, Anda dapat mengklik kanan Doc2Vec di kanvas dan memilih untuk melihat tabel vektor teks.
④
Membuat model klasifikasi. Pertama, komponen Pemisahan membagi teks yang telah divectorisasi menjadi set data pelatihan dan set data uji. Kemudian, algoritma regresi logistik menggunakan set data pelatihan untuk melatih model klasifikasi biner. Model ini dapat menentukan apakah suatu ulasan bersifat positif atau negatif.
⑤
Matriks kebingungan mengevaluasi kinerja model.
-
-
Jalankan pipeline dan lihat hasilnya.
-
Klik ikon Run
 di bagian atas kanvas.
-
Setelah pipeline selesai dijalankan, klik kanan komponen Confusion Matrix di kanvas dan klik Visual Analysis dari menu pintasan.
-
Di bagian Confusion Matrix, klik tab Summary untuk melihat statistik evaluasi model.
-