OpenSearch Edisi Algoritma Industri menyediakan text analyzer bawaan untuk berbagai bahasa, industri, dan skenario pencarian. Setiap analyzer mengontrol cara konten bidang ditokenisasi saat pengindeksan dan dicocokkan saat kueri.
Ikhtisar analyzer
Tabel berikut merangkum semua analyzer yang tersedia. "Dedicated only" berarti analyzer tersebut memerlukan instans aplikasi spesifikasi khusus.
| Analyzer | Bahasa / domain | Jenis bidang yang didukung | Dedicated only |
|---|---|---|---|
| N-gram | Apa pun | SHORT_TEXT | Ya |
| Keyword | Semua | LITERAL, INT, LITERAL_ARRAY, INT_ARRAY | Tidak |
| General analyzer for Chinese | Chinese | TEXT, SHORT_TEXT | Tidak |
| E-commerce analyzer for Chinese | Chinese / E-dagang | TEXT, SHORT_TEXT | Tidak |
| Single-character analyzer for Chinese | Chinese | TEXT, SHORT_TEXT | Tidak |
| Character analyzer for Chinese | Chinese | TEXT, SHORT_TEXT | Ya |
| Fuzzy analyzer | Chinese / Pinyin | SHORT_TEXT | Tidak |
| Full pinyin spelling analyzer | Pinyin | SHORT_TEXT | Tidak |
| Abbreviated pinyin analyzer | Pinyin | SHORT_TEXT | Tidak |
| Word stemming analyzer for English | English | TEXT, SHORT_TEXT | Tidak |
| Unstemmed word analyzer for English | English | TEXT, SHORT_TEXT | Tidak |
| Fine-grained analyzer for English | English | TEXT, SHORT_TEXT | Ya |
| General analyzer for Thai | Thai | TEXT, SHORT_TEXT | Ya |
| E-commerce analyzer for Thai | Thai / E-dagang | TEXT, SHORT_TEXT | Ya |
| General analyzer for Vietnamese | Vietnamese | TEXT, SHORT_TEXT | Ya |
| General analyzer for Indonesian | Indonesian | TEXT, SHORT_TEXT | Ya |
| General analyzer for Korean | Korean | TEXT, SHORT_TEXT | Ya |
| E-commerce analyzer for Korean | Korean / E-dagang | TEXT, SHORT_TEXT | Ya |
| General analyzer for Japanese | Japanese | TEXT, SHORT_TEXT | Ya |
| E-commerce analyzer for Japanese | Japanese / E-dagang | TEXT, SHORT_TEXT | Ya |
| Simple analyzer | Apa pun | TEXT, SHORT_TEXT | Tidak |
| Numeric analyzer | Numeric | INT, TIMESTAMP | Tidak |
| Geo-location analyzer | Geographic | geo_point | Tidak |
| IT content analyzer | IT industry | TEXT, SHORT_TEXT | Tidak |
| General E-commerce analysis | E-dagang | TEXT | Ya (Edisi Peningkatan Spesifik Industri untuk E-dagang) |
| General analysis for the gaming industry | Gaming | TEXT, SHORT_TEXT | Ya (Edisi Peningkatan Spesifik Industri untuk Gaming) |
| General analyzer for English E-commerce | English / E-dagang | TEXT | Ya (Edisi Peningkatan Spesifik Industri untuk E-dagang) |
| Custom text analyzer | Apa pun | TEXT, SHORT_TEXT | Tidak |
N-gram analyzer
Menokenisasi teks menjadi rangkaian N karakter berurutan. Mendukung tokenisasi 2-gram dan 3-gram. Gunakan analyzer ini untuk skenario pencarian non-semantis yang memerlukan pencocokan substring tingkat karakter.
Hanya tersedia untuk aplikasi spesifikasi khusus. Jenis bidang harus SHORT_TEXT.
Contoh — 2-gram
Input: Open Search
Tokens: op, pe, en, n , s, se, ea, ar, rc, ch
Contoh — 3-gram
Input: Open Search
Tokens: ope, pen, en , n s, se, sea, ear, arc, rch
Keyword analyzer
Tidak menokenisasi nilai bidang. Seluruh nilai diperlakukan sebagai satu token. Gunakan analyzer ini untuk skenario pencocokan eksak — tag, pengenal, kode string, dan nilai numerik yang tidak boleh dipisah.
Jenis bidang yang didukung: LITERAL, INT, LITERAL_ARRAY, INT_ARRAY
Contoh
Input: chrysanthemum tea
Dokumen hanya diambil ketika kuerinya persis chrysanthemum tea.
Untuk mengonfigurasi bidang agar mendukung pengambilan dengan pencocokan eksak di OpenSearch:
-
Pada skema aplikasi perubahan offline, atur jenis bidang ke LITERAL.
-
Pada skema indeks, buat indeks untuk bidang tersebut. Metode analisis akan otomatis diatur ke analisis keyword.
-
Kirimkan perubahan offline dan tunggu hingga pergantian layanan selesai.
-
Gunakan
query=field_name:"search_term"untuk menjalankan pencocokan eksak. Misalnya,query=id:"云搜索"hanya mengembalikan dokumen yang bidangid-nya sama persis dengan云搜索.
Untuk bidang TEXT, masukkan frasa dalam tanda kutip ganda untuk menjalankan phrase query yang mencocokkan seluruh frasa tanpa menokenisasinya. Misalnya, gunakan query=default:"开放搜索". Untuk mencocokkan hanya bagian dari frasa, atau mencari berdasarkan pinyin, awalan, atau akhiran, lihat Fuzzy searches.
General analyzer for Chinese
Analyzer semantis umum untuk teks berbahasa Mandarin. Menokenisasi konten menjadi unit pencarian bermakna berdasarkan semantik bahasa Mandarin. Cocok untuk sebagian besar industri.
Jenis bidang yang didukung: TEXT, SHORT_TEXT
Contoh
Input: juhuacha
Dokumen diambil oleh kueri juhuacha, juhua, cha, atau huacha.
E-commerce analyzer for Chinese
Analyzer semantis yang dioptimalkan untuk nama dan deskripsi produk e-dagang berbahasa Mandarin. Menghasilkan token lebih detail dibandingkan analyzer umum untuk terminologi produk umum.
Jenis bidang yang didukung: TEXT, SHORT_TEXT
Contoh
Input: Dabao SOD lotion
Dokumen diambil oleh kueri Dabao, sod, sod lotion, SOD lotion, atau lotion.
Single-character analyzer for Chinese
Menokenisasi teks Mandarin menjadi karakter dan kata individual. Gunakan analyzer ini untuk skenario pencarian Mandarin non-semantis — nama penulis, nama toko, atau bidang apa pun di mana recall karakter individual lebih penting daripada pengelompokan semantis.
Jenis bidang yang didukung: TEXT, SHORT_TEXT
Analyzer ini memperlakukan angka dan kata berbahasa Inggris sebagai satu token. Pencarianhetidak mengambil dokumen yang berisihello world. Gunakan fuzzy analyzer jika Anda memerlukan pencocokan parsial pada angka atau teks berbahasa Inggris.
Jika ringkasan hasil pencarian dikonfigurasi untuk bidang TEXT, beberapa token tambahan seperti huacha tidak disorot.
Contoh
Input: juhuacha
Dokumen diambil oleh kueri juhuacha, juhua, cha, huacha, hua, atau jucha.
Character analyzer for Chinese
Menokenisasi teks menjadi karakter Mandarin individual, angka, huruf Inggris, dan tanda baca. Cocok untuk skenario pencarian non-semantis yang memerlukan granularitas maksimum.
Jenis bidang yang didukung: TEXT, SHORT_TEXT
Hanya tersedia untuk aplikasi spesifikasi khusus.
Contoh
Input: kaifang sousuo OpenSearch123.
Dokumen diambil dengan mencari karakter tunggal apa pun: kai, fang, sou, suo, O, p, e, n, S, e, a, r, c, h, atau .
Fuzzy analyzer
Mendukung pencarian berdasarkan pinyin, karakter tunggal, dan huruf, termasuk pencocokan awalan dan akhiran untuk angka, huruf, dan pinyin. Teks Mandarin tidak mendukung pencocokan awalan atau akhiran. Panjang bidang dibatasi hingga 100 byte.
Jenis bidang yang didukung: Hanya SHORT_TEXT
Untuk detailnya, lihat Fuzzy searches.
Contoh — Mandarin dan pinyin
Input: chrysanthemum tea
Dokumen diambil oleh kueri termasuk chrysanthemum tea, chrysanthemum, tea, flower tea, flower, ju, juhua, juhuacha, j, jh, atau jhc.
Contoh — Pencocokan awalan dan akhiran
Input: 138****5678
-
Gunakan
^138untuk mencocokkan nomor telepon yang diawali138. -
Gunakan
5678$untuk mencocokkan nomor telepon yang diakhiri5678.
Contoh — Kombinasi huruf Inggris
Input: OpenSearch
Dokumen diambil oleh huruf tunggal atau kombinasi huruf apa pun dari kata tersebut.
Full pinyin spelling analyzer
Mencari karakter Mandarin dalam bidang SHORT_TEXT menggunakan ejaan pinyin lengkap atau huruf pertama setiap suku kata. Cocok untuk pencarian berdasarkan pinyin lengkap atau pinyin singkat — misalnya, judul film atau nama penulis.
Untuk mencari berdasarkan pinyin lengkap, masukkan pinyin lengkap dari karakter Mandarin tersebut. Ejaan suku kata parsial tidak didukung.
Jenis bidang yang didukung: Hanya SHORT_TEXT
Contoh
Input: Da Nei Mi Tan 007
Dokumen diambil oleh d, dn, dnm, dnmt, dnmt007, da, danei, daneimi, atau daneimitan.
Dokumen tidak diambil oleh an atau anei.
Abbreviated pinyin analyzer
Mengambil karakter Mandarin dalam bidang SHORT_TEXT menggunakan huruf pertama setiap suku kata pinyin. Gunakan analyzer ini untuk skenario yang memerlukan pencarian berdasarkan inisial pinyin — nama orang, judul film, dan konten pendek serupa.
Jenis bidang yang didukung: SHORT_TEXT
Contoh
Input: Da Nei Mi Tan 007
Dokumen diambil oleh d, dn, dnm, dnmt, dnmt0, dnmt007, m, mt, mt007, atau 007.
Word stemming analyzer for English
Analyzer semantis berbahasa Inggris yang mengubah setiap token ke bentuk dasarnya dan menangani bentuk jamak. Gunakan analyzer ini ketika Anda ingin pencarian seperti analyzing atau analyzers mencocokkan dokumen yang berisi analyze.
Jenis bidang yang didukung: TEXT, SHORT_TEXT
Analyzer ini tidak mendukung konfigurasi analisis query. Karakter Mandarin berurutan diperlakukan sebagai satu token.
Contoh
Input: English tokenizer english analyzer
Dokumen diambil oleh English tokenizer, english, analyz, analyzer, analyzers, analyze, analyzed, atau analyzing.
Unstemmed word analyzer for English
Menokenisasi teks berbahasa Inggris berdasarkan spasi dan tanda baca tanpa menerapkan stemming. Gunakan analyzer ini untuk skenario pencarian Inggris non-semantis — judul buku, nama penulis, atau bidang apa pun yang memerlukan pencocokan kata eksak.
Jenis bidang yang didukung: TEXT, SHORT_TEXT
Analyzer ini tidak mendukung konfigurasi analisis query. Karakter Mandarin berurutan diperlakukan sebagai satu token.
Contoh
Input: English tokenizer english analyzer
Dokumen diambil oleh English tokenizer, english, atau analyzer.
Fine-grained analyzer for English
Menokenisasi teks berbahasa Inggris berdasarkan semantik dengan granularitas lebih detail dibandingkan analyzer Inggris standar. Cocok untuk aplikasi industri umum di mana kata majemuk perlu dipisah menjadi istilah komponennya.
Jenis bidang yang didukung: TEXT, SHORT_TEXT
Hanya tersedia untuk aplikasi spesifikasi khusus.
Contoh
Input: dataprocess
Hasil tokenisasi: data process
Dokumen diambil oleh dataprocess, data process, data, atau process.
General analyzer for Thai
Analyzer umum yang menokenisasi teks Thailand menjadi unit pencarian. Cocok untuk aplikasi industri umum.
Jenis bidang yang didukung: TEXT, SHORT_TEXT
Hanya tersedia untuk aplikasi spesifikasi khusus.
Contoh
Input: แหล่งดึงดูดนักท่องเที่ยว
Hasil tokenisasi: แหล่ง ดึง ดูด นักท่องเที่ยว
Dokumen diambil oleh นักท่องเที่ยว atau แหล่งดึงดูดนักท่องเที่ยว.
E-commerce analyzer for Thai
Analyzer semantis yang dirancang untuk skenario e-dagang berbahasa Thailand.
Jenis bidang yang didukung: TEXT, SHORT_TEXT
Hanya tersedia untuk aplikasi terdedikasi.
Contoh
Input: หน้าจอโทรศัพท์
Hasil tokenisasi: หน้าจอ โทรศัพท์
Dokumen diambil oleh หน้าจอโทรศัพท์, หน้าจอ, atau โทรศัพท์.
General analyzer for Vietnamese
Analyzer umum untuk teks Vietnam dalam aplikasi industri umum.
Jenis bidang yang didukung: TEXT, SHORT_TEXT
Hanya tersedia untuk aplikasi spesifikasi khusus.
General analyzer for Indonesian
Analyzer umum untuk teks Indonesia dalam aplikasi industri umum.
Jenis bidang yang didukung: TEXT, SHORT_TEXT
Hanya tersedia untuk aplikasi spesifikasi khusus.
General analyzer for Korean
Analyzer umum untuk teks Korea dalam aplikasi industri umum.
Jenis bidang yang didukung: TEXT, SHORT_TEXT
Hanya tersedia untuk aplikasi spesifikasi khusus.
Contoh
Input: 인제군의교육
Hasil tokenisasi: 인제군 의 교육
Dokumen diambil oleh 인제군의교육, 의, atau 교육.
E-commerce analyzer for Korean
Analyzer semantis yang dirancang untuk teks Korea dalam skenario e-dagang.
Jenis bidang yang didukung: TEXT, SHORT_TEXT
Hanya tersedia untuk aplikasi spesifikasi khusus.
Contoh
Input: 스포츠캐주얼신발
Hasil tokenisasi: 스포츠 캐주얼 신발
Dokumen diambil oleh 스포츠, 캐주얼, atau 신발.
General analyzer for Japanese
Analyzer umum untuk teks Jepang dalam aplikasi industri umum.
Jenis bidang yang didukung: TEXT, SHORT_TEXT
Hanya tersedia untuk aplikasi spesifikasi khusus.
Contoh
Input: メキシコアグーチ
Hasil tokenisasi: メキシコ アグーチ
Dokumen diambil oleh メキシコ atau アグーチ.
E-commerce analyzer for Japanese
Analyzer semantis yang dirancang untuk teks Jepang dalam skenario e-dagang.
Jenis bidang yang didukung: TEXT, SHORT_TEXT
Hanya tersedia untuk aplikasi tertentu.
Contoh
Input: ラウンドネックスーツ
Hasil tokenisasi: ラウンド ネック スーツ
Dokumen diambil oleh ラウンド, ネック, atau スーツ.
Simple analyzer
Memberikan kontrol penuh atas tokenisasi. Gunakan analyzer ini untuk skenario khusus di mana tidak ada analyzer bawaan yang memenuhi kebutuhan Anda. Saat mendorong dokumen atau melakukan pencarian, gunakan karakter tab (\t) untuk memisahkan token. Konten bidang dan kueri pencarian harus ditokenisasi dengan cara yang sama — jika tidak, dokumen tidak dapat diambil.
Jenis bidang yang didukung: TEXT, SHORT_TEXT
Analyzer ini tidak mendukung konfigurasi analisis query.
Contoh
Nilai bidang: chrysanthemum\tflower tea\thao
Dokumen diambil oleh chrysanthemum, flower tea, chrysanthemum\tflower tea, flower tea\thao, chrysanthemum\thao, atau chrysanthemum\tflower tea\thao.
Numeric analyzer
Mendukung pencarian berdasarkan interval waktu atau rentang numerik. Gunakan analyzer ini pada bidang INT dan TIMESTAMP yang memerlukan kueri rentang.
Jenis bidang yang didukung: INT, TIMESTAMP
Contoh
query=default:'OpenSearch' AND index:[number1,number2]Pada contoh ini, index adalah nama bidang indeks yang dikonfigurasi dengan numeric analyzer.
Geo-location analyzer
Mendukung kueri rentang lokasi geografis.
Jenis bidang yang didukung: Hanya geo_point
Contoh
query=spatial_index:'circle(116.5806 39.99624, 1000)'Kueri ini menemukan titik dalam lingkaran untuk menentukan lokasi terdekat dalam jarak beberapa kilometer.
IT content analyzer
Analyzer spesifik industri yang dirancang untuk konten IT. Analyzer ini menokenisasi istilah terkait IT secara berbeda dibandingkan analyzer umum — misalnya, menangani nama bahasa pemrograman dan singkatan teknis dengan presisi lebih tinggi.
Jenis bidang yang didukung: TEXT, SHORT_TEXT
Contoh
Konten asli: C++ array usage notes
Analisis umum: C++ array usage notes
Analisis konten IT: C++ array usage notes
General E-commerce analysis
Analyzer spesifik industri untuk e-dagang, didukung oleh teknologi Pemrosesan bahasa alami (NLP) dari Akademi DAMO Alibaba. Analyzer ini mengatasi tantangan umum dalam pencarian e-dagang, termasuk penguraian atribut produk dan pengenalan merek.
Jenis bidang yang didukung: Hanya TEXT
Hanya tersedia untuk aplikasi khusus yang menggunakan spesifikasi Enhanced E-commerce.
Contoh
Input: Small Gold Tube Concealer Cream
Output analisis e-dagang: Small Gold Tube, Concealer, Cream
General analysis for the gaming industry
Analyzer spesifik industri yang dirancang untuk konten gaming.
Jenis bidang yang didukung: TEXT, SHORT_TEXT
Hanya tersedia untuk aplikasi spesifikasi khusus yang ditingkatkan untuk industri gaming.
Contoh
Input: Genshin equipment
Hasil tokenisasi: Genshin, equipment
Dokumen diambil oleh Genshin equipment, Genshin, atau equipment.
General analyzer for English E-commerce
Analyzer semantis untuk teks berbahasa Inggris dalam skenario e-dagang.
Jenis bidang yang didukung: Hanya TEXT
Hanya tersedia untuk aplikasi spesifikasi khusus dari Edisi Peningkatan Spesifik Industri untuk E-dagang.
Custom text analyzer
Menggabungkan analyzer spesifik industri — seperti analyzer umum, analyzer e-dagang, atau analyzer nama orang — dengan entri intervensi kustom. Gunakan analyzer ini untuk memperluas perilaku tokenisasi bawaan dengan kosakata khusus domain.
Jenis bidang yang didukung: Hanya TEXT, SHORT_TEXT
Untuk detail konfigurasi, lihat Custom text analyzers.
Test analyzers
Uji hasil tokenisasi analyzer spesifik industri dan kustom di Konsol OpenSearch. Buka Search Algorithm Center > Retrieval Configuration > Analyzer Management, lalu klik tab Analysis Test.
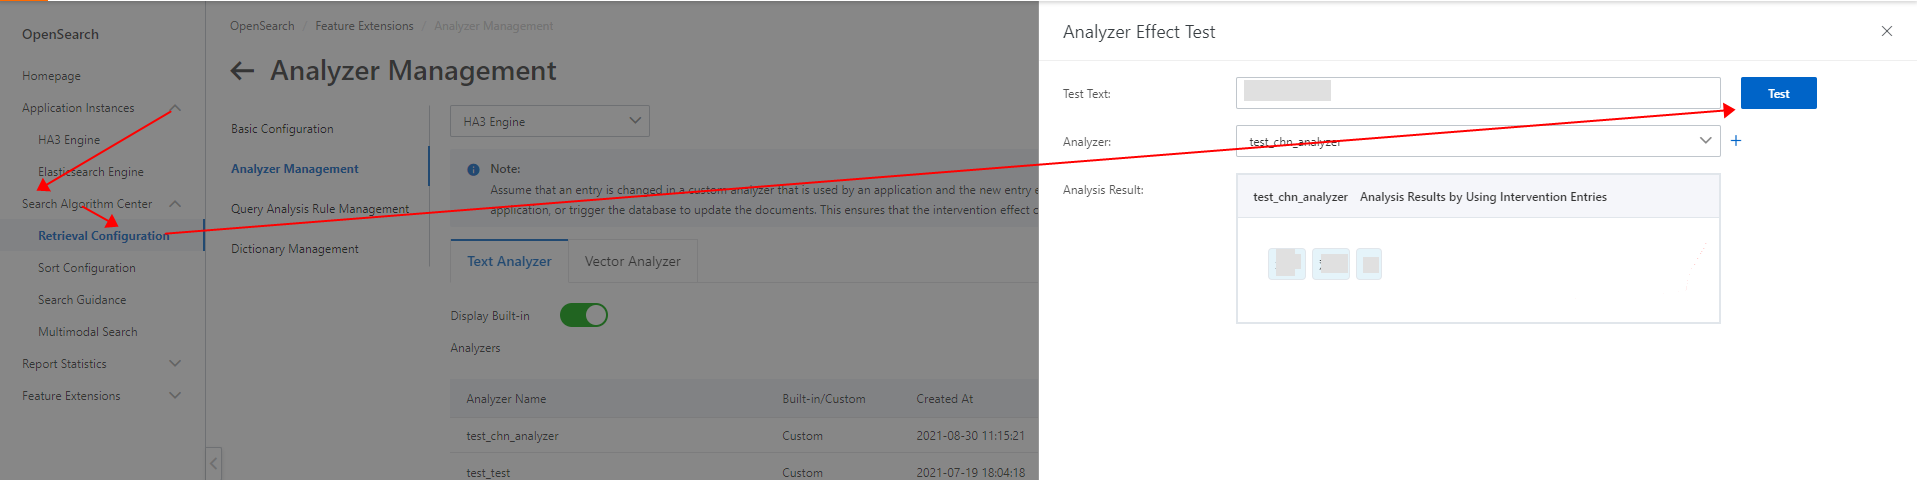
Pilih analyzer yang tepat
Gunakan panduan berikut untuk memilih analyzer yang sesuai dengan skenario Anda.
| Skenario | Analyzer yang direkomendasikan |
|---|---|
| Pencarian Mandarin semantis (sebagian besar industri) | General analyzer for Chinese |
| Pencarian Mandarin non-semantis atau teks pendek dengan kebutuhan recall tinggi | Single-character analyzer for Chinese |
| Pencarian Mandarin yang memerlukan granularitas karakter maksimum | Character analyzer for Chinese |
| Pencarian pinyin (lengkap atau singkat) | Fuzzy analyzer |
| Pencarian hanya berdasarkan inisial pinyin | Abbreviated pinyin analyzer |
| Pencarian berdasarkan ejaan pinyin lengkap | Full pinyin spelling analyzer |
| Pencarian semantis Inggris dengan stemming | Word stemming analyzer for English |
| Pencarian kata eksak Inggris (judul, nama) | Unstemmed word analyzer for English |
| Pemisahan kata majemuk Inggris | Fine-grained analyzer for English |
| Pencarian produk e-dagang (Mandarin) | E-commerce analyzer for Chinese atau General E-commerce analysis |
| Konten industri IT | IT content analyzer |
| Kueri rentang numerik atau waktu | Numeric analyzer |
| Kueri kedekatan geografis | Geo-location analyzer |
| Tag, pengenal, atau string non-tokenisasi | Keyword analyzer |
| Pencocokan substring tingkat karakter | N-gram analyzer |
| Logika tokenisasi kustom | Simple analyzer |
Menggabungkan analyzer untuk recall dan presisi lebih baik
Untuk pencarian Mandarin, gabungkan general analyzer dengan single-character analyzer untuk mengambil dokumen yang berisi karakter individual sekaligus memberi peringkat lebih tinggi pada frasa eksak. Misalnya:
query=title_index:'juhuacha' OR sws_title_index:'juhuacha'Pasangkan kueri ini dengan ekspresi pengurutan text_relevance(title)×5+field_proximity(sws_title). Kombinasi ini mengambil dokumen yang berisi karakter individual untuk juhuacha meskipun terpisah, sekaligus memberi peringkat lebih tinggi pada dokumen yang berisi frasa eksak juhuacha.
Catatan penggunaan
Jenis bidang yang didukung untuk bidang indeks
| Didukung | Tidak didukung |
|---|---|
| INT, INT_ARRAY, TEXT, SHORT_TEXT, LITERAL, LITERAL_ARRAY, TIMESTAMP, GEO_POINT | FLOAT, FLOAT_ARRAY, DOUBLE, DOUBLE_ARRAY |
Batasan tambahan:
-
Kunci utama default tabel utama dalam skema aplikasi diatur sebagai bidang indeks bernama
id. Konfigurasi ini tidak dapat diubah. -
Jika ringkasan hasil pencarian dikonfigurasi untuk bidang TEXT, beberapa frasa unit pencarian tambahan (seperti
huachayang berasal darijuhuacha) tidak disorot dalam hasil pencarian. -
Analyzer single-character Mandarin memperlakukan angka dan kata berbahasa Inggris sebagai satu token. Pencarian
hetidak mengambil dokumen yang berisihello world. Gunakan fuzzy analyzer untuk pencocokan parsial pada angka atau teks berbahasa Inggris.