Lakukan koneksi ke layanan sintesis suara real-time Qwen-TTS melalui WebSocket. Dokumen ini mencakup titik akhir layanan, header permintaan, dan alur interaksi.
Untuk ikhtisar model dan panduan pemilihan, lihat Sintesis suara real-time.
API Realtime Qwen-TTS menggunakan protokol WebSocket. Aplikasi Java dan Python dapat memanfaatkan SDK DashScope untuk menghindari penanganan WebSocket secara manual, sedangkan bahasa lain dapat terhubung langsung menggunakan pustaka WebSocket.
Titik akhir layanan
Gunakan URL berikut dan tetapkan model melalui parameter kueri model:
Singapura
URL WebSocket: wss://dashscope-intl.aliyuncs.com/api-ws/v1/realtime?model=qwen3-tts-flash-realtime
Tiongkok (Beijing)
URL WebSocket: wss://dashscope-intl.aliyuncs.com/api-ws/v1/realtime?model=qwen3-tts-flash-realtime
PentingURL harus menggunakan protokol wss://. Tetapkan header Authorization (lihat Header permintaan) dan tentukan model menggunakan parameter kueri model.
Header permintaan
Tetapkan header permintaan berikut:
Parameter | Tipe | Wajib | Deskripsi |
|---|---|---|---|
Authorization | string | Ya | Format: |
user-agent | string | Tidak | Identifikasi klien untuk pelacakan sumber di sisi server. |
X-DashScope-WorkSpace | string | Tidak | ID ruang kerja Alibaba Cloud Model Studio. |
PentingOtorisasi diverifikasi selama handshake WebSocket. Kunci API yang tidak valid atau tidak ada akan menyebabkan handshake gagal dengan kode HTTP 401/403.
Alur interaksi
Untuk penjelasan rinci mengenai event klien dan event server, lihat Event klien dan Event server.
API ini mendukung dua mode:
- Mode ServerCommit: Server menentukan segmentasi teks dan waktu sintesis secara otomatis.
- Mode Commit: Klien mengontrol kapan setiap segmen teks dikirimkan. Panggil
input_text_buffer.commitsecara eksplisit untuk memicu sintesis.
Detail mode
- Pada mode ServerCommit, panggil
input_text_buffer.appenduntuk menyimpan teks ke buffer. Sistem menentukan waktu sintesis secara otomatis. - Memanggil
input_text_buffer.commitpada mode ServerCommit akan segera mensintesis buffer saat ini. Sesi kemudian kembali ke mode ServerCommit. - Pada mode Commit,
input_text_buffer.appendsaja tidak memicu sintesis. Panggilinput_text_buffer.commituntuk memulai sintesis.
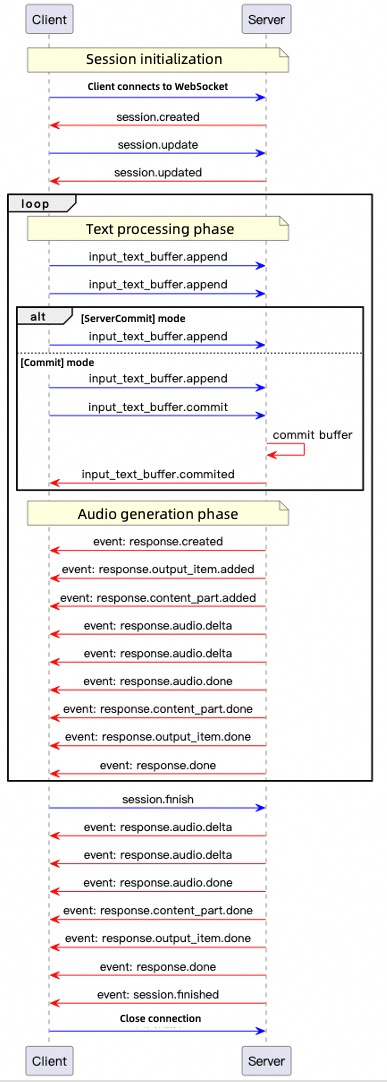
-
Koneksi: Klien membuka koneksi WebSocket. Server mengembalikan event
session.createdketika siap. -
Konfigurasi sesi: Klien mengirim
session.updateuntuk mengatur voice, format, dan mode. -
Input teks: Klien mengirim
input_text_buffer.appenduntuk menambahkan teks ke buffer. -
Pemicu sintesis:
- Pada mode ServerCommit, sintesis dimulai secara otomatis. Klien dapat memanggil
input_text_buffer.commituntuk memaksa sintesis segera. - Pada mode Commit, hanya
input_text_buffer.commityang memicu sintesis.
- Pada mode ServerCommit, sintesis dimulai secara otomatis. Klien dapat memanggil
-
Generasi audio: Server mengirim event
response.created, lalu mengalirkan audio dalam bentuk base64 sebagai eventresponse.audio.deltahingga eventresponse.audio.done. -
Pengakhiran sesi: Klien mengirim
session.finishuntuk melepaskan sumber daya. Server mengembalikansession.finisheddan menutup koneksi.
Setelah koneksi terbentuk, server mengembalikan event session.created berikut:
{
    "event_id": "event_xxx",
    "type": "session.created",
    "session": {
        "object": "realtime.session",
        "mode": "server_commit",
        "model": "qwen3-tts-flash-realtime",
        "voice": "Cherry",
        "response_format": "pcm",
        "sample_rate": 24000,
        "id": "sess_xxx"
    }
}
Contoh kode
Contoh menyediakan klien Python dan Java serta kedua mode commit. Atur DASHSCOPE_API_KEY sesuai wilayah endpoint contoh. Python memerlukan websockets dan pyaudio; Java memerlukan Java-WebSocket dan Gson serta menggunakan Java Sound untuk pemutaran. Setiap peristiwa klien memakai UUID unik.
<dependencies>
    <dependency>
        <groupId>org.java-websocket</groupId>
        <artifactId>Java-WebSocket</artifactId>
        <version>1.5.3</version>
    </dependency>
    <dependency>
        <groupId>com.google.code.gson</groupId>
        <artifactId>gson</artifactId>
        <version>2.10.1</version>
    </dependency>
</dependencies>
pip install websockets pyaudio
-
Buat klien
Java
Buat file Java bernama
TTSRealtimeClient.javadan salin kode berikut ke dalam file tersebut:import com.google.gson.Gson; import com.google.gson.JsonObject; import org.java_websocket.client.WebSocketClient; import org.java_websocket.handshake.ServerHandshake; import java.net.URI; import java.util.Base64; import java.util.HashMap; import java.util.Map; import java.util.concurrent.CountDownLatch; import java.util.function.Consumer; /** * Klien untuk berinteraksi dengan API Realtime TTS. * * Kelas ini menyediakan metode untuk menghubungkan ke API Realtime TTS, mengirim data teks, mengambil output audio, dan mengelola koneksi WebSocket. */ public class TTSRealtimeClient { public enum SessionMode { SERVER_COMMIT("server_commit"), COMMIT("commit"); private final String value; SessionMode(String value) { this.value = value; } public String getValue() { return value; } } /** * Antarmuka callback audio */ public interface AudioCallback { void onAudio(byte[] audioData); } private final String baseUrl; private final String apiKey; private final String voice; private final SessionMode mode; private final String languageType; private final AudioCallback audioCallback; private final Gson gson = new Gson(); private WebSocketClient ws; private CountDownLatch responseDoneLatch; private CountDownLatch sessionFinishedLatch; public TTSRealtimeClient(String baseUrl, String apiKey, String voice, SessionMode mode, AudioCallback audioCallback, String languageType) { this.baseUrl = baseUrl; this.apiKey = apiKey; this.voice = voice; this.mode = mode; this.audioCallback = audioCallback; this.languageType = languageType; } public TTSRealtimeClient(String baseUrl, String apiKey, String voice, SessionMode mode, AudioCallback audioCallback) { this(baseUrl, apiKey, voice, mode, audioCallback, "Auto"); } /** * Buat koneksi WebSocket ke API Realtime TTS. */ public void connect() throws Exception { Map<String, String> headers = new HashMap<>(); headers.put("Authorization", "Bearer " + apiKey); responseDoneLatch = new CountDownLatch(0); sessionFinishedLatch = new CountDownLatch(1); ws = new WebSocketClient(new URI(baseUrl), headers) { @Override public void onOpen(ServerHandshake handshake) { System.out.println("Koneksi WebSocket berhasil"); // Kirim konfigurasi sesi default JsonObject session = new JsonObject(); session.addProperty("mode", mode.getValue()); session.addProperty("voice", TTSRealtimeClient.this.voice); session.addProperty("language_type", languageType); session.addProperty("response_format", "pcm"); session.addProperty("sample_rate", 24000); updateSession(session); } @Override public void onMessage(String message) { JsonObject event = gson.fromJson(message, JsonObject.class); String eventType = event.has("type") ? event.get("type").getAsString() : ""; if (!"response.audio.delta".equals(eventType)) { System.out.println("Event diterima: " + eventType); } switch (eventType) { case "error": System.err.println("Error: " + event.get("error")); break; case "session.created": System.out.println("Sesi dibuat, ID: " + event.getAsJsonObject("session").get("id").getAsString()); break; case "session.updated": System.out.println("Sesi diperbarui, ID: " + event.getAsJsonObject("session").get("id").getAsString()); break; case "input_text_buffer.committed": System.out.println("Buffer teks di-commit, ID item: " + event.get("item_id")); break; case "input_text_buffer.cleared": System.out.println("Buffer teks dihapus"); break; case "response.created": System.out.println("Respons dibuat, ID: " + event.getAsJsonObject("response").get("id").getAsString()); responseDoneLatch = new CountDownLatch(1); break; case "response.output_item.added": System.out.println("Item output ditambahkan, ID: " + event.getAsJsonObject("item").get("id").getAsString()); break; case "response.audio.delta": if (audioCallback != null) { byte[] audioBytes = Base64.getDecoder().decode( event.get("delta").getAsString()); audioCallback.onAudio(audioBytes); } break; case "response.audio.done": System.out.println("Generasi audio selesai"); break; case "response.done": System.out.println("Respons selesai"); responseDoneLatch.countDown(); break; case "session.finished": System.out.println("Sesi selesai"); sessionFinishedLatch.countDown(); break; } } @Override public void onClose(int code, String reason, boolean remote) { System.out.println("Koneksi ditutup: " + reason); } @Override public void onError(Exception ex) { System.err.println("Error WebSocket: " + ex.getMessage()); } }; ws.connectBlocking(); } /** * Kirim event ke server. */ public void sendEvent(JsonObject event) { String eventId = "event_" + java.util.UUID.randomUUID().toString(); event.addProperty("event_id", eventId); System.out.println("Mengirim event: type=" + event.get("type").getAsString() + ", event_id=" + eventId); ws.send(gson.toJson(event)); } /** * Perbarui konfigurasi sesi. */ public void updateSession(JsonObject config) { JsonObject event = new JsonObject(); event.addProperty("type", "session.update"); event.add("session", config); System.out.println("Memperbarui konfigurasi sesi: " + event); sendEvent(event); } /** * Kirim data teks ke API. */ public void appendText(String text) { JsonObject event = new JsonObject(); event.addProperty("type", "input_text_buffer.append"); event.addProperty("text", text); sendEvent(event); } /** * Commit buffer teks untuk memicu pemrosesan. */ public void commitTextBuffer() { JsonObject event = new JsonObject(); event.addProperty("type", "input_text_buffer.commit"); sendEvent(event); } /** * Hapus buffer teks. */ public void clearTextBuffer() { JsonObject event = new JsonObject(); event.addProperty("type", "input_text_buffer.clear"); sendEvent(event); } /** * Akhiri sesi. */ public void finishSession() { JsonObject event = new JsonObject(); event.addProperty("type", "session.finish"); sendEvent(event); } /** * Tunggu event response.done. */ public void waitForResponseDone() throws InterruptedException { responseDoneLatch.await(); } /** * Tunggu event session.finished. */ public void waitForSessionFinished() throws InterruptedException { sessionFinishedLatch.await(); } /** * Tutup koneksi WebSocket. */ public void close() { if (ws != null) { ws.close(); } } }Python
Buat file Python bernama
tts_realtime_client.pydan salin kode berikut ke dalam file tersebut:# -- coding: utf-8 -- import asyncio import websockets import json import base64 import time import uuid from typing import Optional, Callable, Dict, Any from enum import Enum class SessionMode(Enum): SERVER_COMMIT = "server_commit" COMMIT = "commit" class TTSRealtimeClient: """ Klien untuk berinteraksi dengan API Realtime TTS. Kelas ini menyediakan metode untuk menghubungkan ke API Realtime TTS, mengirim data teks, menerima output audio, dan mengelola koneksi WebSocket. Atribut: base_url (str): URL dasar API Realtime. api_key (str): API Key untuk otentikasi. voice (str): Suara yang digunakan untuk sintesis suara di sisi server. mode (SessionMode): Mode sesi, baik server_commit maupun commit. audio_callback (Callable[[bytes], None]): Fungsi callback untuk menerima data audio. language_type(str) Bahasa untuk sintesis suara. Opsi: Chinese, English, German, Italian, Portuguese, Spanish, Japanese, Korean, French, Russian, Auto """ def __init__( self, base_url: str, api_key: str, voice: str = "Cherry", mode: SessionMode = SessionMode.SERVER_COMMIT, audio_callback: Optional[Callable[[bytes], None]] = None, language_type: str = "Auto"): self.base_url = base_url self.api_key = api_key self.voice = voice self.mode = mode self.ws = None self.audio_callback = audio_callback self.language_type = language_type # Status respons saat ini self._current_response_id = None self._current_item_id = None self._is_responding = False self._response_done_future = None async def connect(self) -> None: """Buat koneksi WebSocket dengan API Realtime TTS.""" headers = { "Authorization": f"Bearer {self.api_key}" } self.ws = await websockets.connect(self.base_url, additional_headers=headers) # Atur konfigurasi sesi default await self.update_session({ "mode": self.mode.value, "voice": self.voice, "language_type": self.language_type, "response_format": "pcm", "sample_rate": 24000 }) async def send_event(self, event) -> None: """Kirim event ke server.""" event['event_id'] = "event_" + uuid.uuid4().hex print(f"Mengirim event: type={event['type']}, event_id={event['event_id']}") await self.ws.send(json.dumps(event)) async def update_session(self, config: Dict[str, Any]) -> None: """Perbarui konfigurasi sesi.""" event = { "type": "session.update", "session": config } print("Memperbarui konfigurasi sesi: ", event) await self.send_event(event) async def append_text(self, text: str) -> None: """Kirim data teks ke API.""" event = { "type": "input_text_buffer.append", "text": text } await self.send_event(event) async def commit_text_buffer(self) -> None: """Commit buffer teks untuk memicu pemrosesan.""" event = { "type": "input_text_buffer.commit" } await self.send_event(event) async def clear_text_buffer(self) -> None: """Hapus buffer teks.""" event = { "type": "input_text_buffer.clear" } await self.send_event(event) async def finish_session(self) -> None: """Akhiri sesi.""" event = { "type": "session.finish" } await self.send_event(event) async def wait_for_response_done(self): """Tunggu event response.done""" if self._response_done_future: await self._response_done_future async def handle_messages(self) -> None: """Tangani pesan dari server.""" try: async for message in self.ws: event = json.loads(message) event_type = event.get("type") if event_type != "response.audio.delta": print(f"Event diterima: {event_type}") if event_type == "error": print("Error: ", event.get('error', {})) continue elif event_type == "session.created": print("Sesi dibuat, ID: ", event.get('session', {}).get('id')) elif event_type == "session.updated": print("Sesi diperbarui, ID: ", event.get('session', {}).get('id')) elif event_type == "input_text_buffer.committed": print("Buffer teks di-commit, ID item: ", event.get('item_id')) elif event_type == "input_text_buffer.cleared": print("Buffer teks dihapus") elif event_type == "response.created": self._current_response_id = event.get("response", {}).get("id") self._is_responding = True # Buat future baru untuk menunggu response.done self._response_done_future = asyncio.Future() print("Respons dibuat, ID: ", self._current_response_id) elif event_type == "response.output_item.added": self._current_item_id = event.get("item", {}).get("id") print("Item output ditambahkan, ID: ", self._current_item_id) # Tangani delta audio elif event_type == "response.audio.delta" and self.audio_callback: audio_bytes = base64.b64decode(event.get("delta", "")) self.audio_callback(audio_bytes) elif event_type == "response.audio.done": print("Generasi audio selesai") elif event_type == "response.done": self._is_responding = False self._current_response_id = None self._current_item_id = None # Tandai future sebagai selesai if self._response_done_future and not self._response_done_future.done(): self._response_done_future.set_result(True) print("Respons selesai") elif event_type == "session.finished": print("Sesi selesai") except websockets.exceptions.ConnectionClosed: print("Koneksi ditutup") except Exception as e: print("Error menangani pesan: ", str(e)) async def close(self) -> None: """Tutup koneksi WebSocket.""" if self.ws: await self.ws.close() -
Pilih mode sintesis suara
API Realtime mendukung dua mode:
-
server_commit mode
Server menangani segmentasi teks dan waktu sintesis secara otomatis. Klien hanya mengirim teks. Cocok untuk skenario latensi rendah (seperti navigasi GPS).
-
commit mode
Klien menambahkan teks ke buffer dan secara eksplisit memicu sintesis. Cocok untuk skenario yang memerlukan kontrol segmentasi kalimat yang tepat (seperti siaran berita).
mode server_commit
Java
Di direktori yang sama dengan
TTSRealtimeClient.java, buat file Java lain bernamaServerCommit.javadan salin kode berikut ke dalam file tersebut:import javax.sound.sampled.*; import java.io.*; import java.util.ArrayList; import java.util.List; import java.util.concurrent.ConcurrentLinkedQueue; import java.util.concurrent.atomic.AtomicBoolean; public class ServerCommit { // Berikut ini adalah konfigurasi untuk wilayah Singapura. private static final String URL = "wss://dashscope-intl.aliyuncs.com/api-ws/v1/realtime?model=qwen3-tts-flash-realtime"; // API Key berbeda antara wilayah Singapura dan Beijing. Dapatkan API Key Anda: https://www.alibabacloud.com/help/zh/model-studio/get-api-key // Jika Anda belum mengonfigurasi variabel lingkungan, ganti baris berikut dengan API Key Model Studio China Anda: private static final String API_KEY = "sk-xxx"; private static final String API_KEY = System.getenv("DASHSCOPE_API_KEY"); private static final int SAMPLE_RATE = 24000; // Cache data audio private static final List<byte[]> audioChunks = new ArrayList<>(); // Antrian pemutaran real-time private static final ConcurrentLinkedQueue<byte[]> playbackQueue = new ConcurrentLinkedQueue<>(); private static final AtomicBoolean playing = new AtomicBoolean(true); public static void main(String[] args) throws Exception { if (API_KEY == null || API_KEY.isEmpty()) { throw new IllegalStateException("Harap atur variabel lingkungan DASHSCOPE_API_KEY"); } // Inisialisasi pemutaran audio AudioFormat format = new AudioFormat(SAMPLE_RATE, 16, 1, true, false); DataLine.Info info = new DataLine.Info(SourceDataLine.class, format); SourceDataLine audioLine = (SourceDataLine) AudioSystem.getLine(info); audioLine.open(format); audioLine.start(); // Mulai thread pemutaran Thread playerThread = new Thread(() -> { while (playing.get() || !playbackQueue.isEmpty()) { byte[] chunk = playbackQueue.poll(); if (chunk != null) { audioLine.write(chunk, 0, chunk.length); } else { try { Thread.sleep(10); } catch (InterruptedException ignored) {} } } }); playerThread.start(); // Buat klien TTS TTSRealtimeClient client = new TTSRealtimeClient( URL, API_KEY, "Cherry", TTSRealtimeClient.SessionMode.SERVER_COMMIT, audioData -> { playbackQueue.add(audioData); audioChunks.add(audioData); System.out.println("Data audio diterima: " + audioData.length + " byte"); } ); client.connect(); // Kirim fragmen teks String[] textFragments = { "Alibaba Cloud's large language model platform, Model Studio, is an all-in-one platform for developing and building large language model applications.", "Both developers and business users can deeply participate in the design and development of large language model applications.", "You can develop a large language model application in five minutes using a simple interface,", "or train a dedicated model in a few hours, allowing you to focus more energy on application innovation." }; System.out.println("Mulai mengirim teks..."); for (String text : textFragments) { System.out.println("Mengirim fragmen: " + text); client.appendText(text); Thread.sleep(100); } Thread.sleep(1000); client.finishSession(); // Tunggu respons selesai client.waitForResponseDone(); client.waitForSessionFinished(); client.close(); // Tunggu pemutaran selesai playing.set(false); playerThread.join(); audioLine.drain(); audioLine.close(); // Simpan file audio saveWav("output.wav"); System.out.println("Selesai"); } private static void saveWav(String filename) throws IOException { if (audioChunks.isEmpty()) { System.out.println("Tidak ada data audio untuk disimpan"); return; } ByteArrayOutputStream bos = new ByteArrayOutputStream(); for (byte[] chunk : audioChunks) { bos.write(chunk); } byte[] allAudio = bos.toByteArray(); AudioFormat format = new AudioFormat(SAMPLE_RATE, 16, 1, true, false); AudioInputStream ais = new AudioInputStream( new ByteArrayInputStream(allAudio), format, allAudio.length / 2); new File("outputs").mkdirs(); AudioSystem.write(ais, AudioFileFormat.Type.WAVE, new File("outputs/" + filename)); System.out.println("Audio disimpan ke: outputs/" + filename); } }Kompilasi dan jalankan
ServerCommit.javauntuk mendengar audio yang dihasilkan oleh API Realtime secara real-time.Python
Di direktori yang sama dengan
tts_realtime_client.py, buat file Python lain bernamaserver_commit.pydan salin kode berikut ke dalam file tersebut:import os import asyncio import logging import wave from tts_realtime_client import TTSRealtimeClient, SessionMode import pyaudio # Konfigurasi layanan QwenTTS # Berikut ini adalah konfigurasi untuk wilayah Singapura. URL = "wss://dashscope-intl.aliyuncs.com/api-ws/v1/realtime?model=qwen3-tts-flash-realtime" # API Key berbeda antara wilayah Singapura dan Beijing. Dapatkan API Key Anda: https://www.alibabacloud.com/help/zh/model-studio/get-api-key # Jika Anda belum mengonfigurasi variabel lingkungan, ganti baris berikut dengan API Key Model Studio China Anda: API_KEY="sk-xxx" API_KEY = os.getenv("DASHSCOPE_API_KEY") if not API_KEY: raise ValueError("Harap atur variabel lingkungan DASHSCOPE_API_KEY") # Kumpulkan data audio _audio_chunks = [] # Terkait pemutaran real-time _AUDIO_SAMPLE_RATE = 24000 _audio_pyaudio = pyaudio.PyAudio() _audio_stream = None # Akan dibuka saat runtime def _audio_callback(audio_bytes: bytes): """Callback audio TTSRealtimeClient: pemutaran real-time dan caching""" global _audio_stream if _audio_stream is not None: try: _audio_stream.write(audio_bytes) except Exception as exc: logging.error(f"Error pemutaran PyAudio: {exc}") _audio_chunks.append(audio_bytes) logging.info(f"Chunk audio diterima: {len(audio_bytes)} byte") def _save_audio_to_file(filename: str = "output.wav", sample_rate: int = 24000) -> bool: """Simpan data audio yang dikumpulkan sebagai file WAV""" if not _audio_chunks: logging.warning("Tidak ada data audio untuk disimpan") return False try: audio_data = b"".join(_audio_chunks) with wave.open(filename, 'wb') as wav_file: wav_file.setnchannels(1) # Mono wav_file.setsampwidth(2) # 16-bit wav_file.setframerate(sample_rate) wav_file.writeframes(audio_data) logging.info(f"Audio disimpan ke: {filename}") return True except Exception as exc: logging.error(f"Gagal menyimpan audio: {exc}") return False async def _produce_text(client: TTSRealtimeClient): """Kirim fragmen teks ke server""" text_fragments = [ "Alibaba Cloud's large language model platform, Model Studio, is an all-in-one platform for developing and building large language model applications.", "Both developers and business users can deeply participate in the design and development of large language model applications.", "You can develop a large language model application in five minutes using a simple interface,", "or train a dedicated model in a few hours, allowing you to focus more energy on application innovation.", ] logging.info("Mengirim fragmen teks…") for text in text_fragments: logging.info(f"Mengirim fragmen: {text}") await client.append_text(text) await asyncio.sleep(0.1) # Penundaan singkat antar fragmen # Tunggu server menyelesaikan pemrosesan internal sebelum mengakhiri sesi await asyncio.sleep(1.0) await client.finish_session() async def _run_demo(): """Jalankan demo lengkap""" global _audio_stream # Buka aliran output PyAudio _audio_stream = _audio_pyaudio.open( format=pyaudio.paInt16, channels=1, rate=_AUDIO_SAMPLE_RATE, output=True, frames_per_buffer=1024 ) client = TTSRealtimeClient( base_url=URL, api_key=API_KEY, voice="Cherry", mode=SessionMode.SERVER_COMMIT, audio_callback=_audio_callback ) # Buat koneksi await client.connect() # Jalankan penanganan pesan dan pengiriman teks secara paralel consumer_task = asyncio.create_task(client.handle_messages()) producer_task = asyncio.create_task(_produce_text(client)) await producer_task # Tunggu pengiriman teks selesai # Tunggu response.done await client.wait_for_response_done() # Tutup koneksi dan batalkan tugas konsumen await client.close() consumer_task.cancel() # Tutup aliran audio if _audio_stream is not None: _audio_stream.stop_stream() _audio_stream.close() _audio_pyaudio.terminate() # Simpan data audio os.makedirs("outputs", exist_ok=True) _save_audio_to_file(os.path.join("outputs", "qwen_tts_output.wav")) def main(): """Titik masuk sinkron""" logging.basicConfig( level=logging.INFO, format='%(asctime)s [%(levelname)s] %(message)s', datefmt='%Y-%m-%d %H:%M:%S' ) logging.info("Memulai demo Klien Realtime QwenTTS…") asyncio.run(_run_demo()) if __name__ == "__main__": main()Jalankan
server_commit.pyuntuk mendengar audio yang dihasilkan oleh API Realtime secara real-time.commit mode
Java
Di direktori yang sama dengan
TTSRealtimeClient.java, buat file Java lain bernamaCommit.javadan salin kode berikut ke dalam file tersebut:import javax.sound.sampled.*; import java.io.*; import java.util.ArrayList; import java.util.List; import java.util.Scanner; import java.util.concurrent.ConcurrentLinkedQueue; import java.util.concurrent.atomic.AtomicBoolean; public class Commit { // Berikut ini adalah konfigurasi untuk wilayah Singapura. private static final String URL = "wss://dashscope-intl.aliyuncs.com/api-ws/v1/realtime?model=qwen3-tts-flash-realtime"; // API Key berbeda antara wilayah Singapura dan Beijing. Dapatkan API Key Anda: https://www.alibabacloud.com/help/zh/model-studio/get-api-key // Jika Anda belum mengonfigurasi variabel lingkungan, ganti baris berikut dengan API Key Model Studio China Anda: private static final String API_KEY = "sk-xxx"; private static final String API_KEY = System.getenv("DASHSCOPE_API_KEY"); private static final int SAMPLE_RATE = 24000; private static final List<byte[]> audioChunks = new ArrayList<>(); private static final ConcurrentLinkedQueue<byte[]> playbackQueue = new ConcurrentLinkedQueue<>(); private static final AtomicBoolean playing = new AtomicBoolean(true); public static void main(String[] args) throws Exception { if (API_KEY == null || API_KEY.isEmpty()) { throw new IllegalStateException("Harap atur variabel lingkungan DASHSCOPE_API_KEY"); } // Inisialisasi pemutaran audio AudioFormat format = new AudioFormat(SAMPLE_RATE, 16, 1, true, false); DataLine.Info info = new DataLine.Info(SourceDataLine.class, format); SourceDataLine audioLine = (SourceDataLine) AudioSystem.getLine(info); audioLine.open(format); audioLine.start(); // Mulai thread pemutaran Thread playerThread = new Thread(() -> { while (playing.get() || !playbackQueue.isEmpty()) { byte[] chunk = playbackQueue.poll(); if (chunk != null) { audioLine.write(chunk, 0, chunk.length); } else { try { Thread.sleep(10); } catch (InterruptedException ignored) {} } } }); playerThread.start(); // Buat klien TTS (mode commit) TTSRealtimeClient client = new TTSRealtimeClient( URL, API_KEY, "Cherry", TTSRealtimeClient.SessionMode.COMMIT, audioData -> { playbackQueue.add(audioData); audioChunks.add(audioData); System.out.println("Data audio diterima: " + audioData.length + " byte"); } ); client.connect(); // Input interaktif System.out.println("Masukkan teks (tekan Enter langsung untuk mengirim event commit dan mengakhiri sesi, tekan Ctrl+D untuk keluar dari program):"); Scanner scanner = new Scanner(System.in); while (true) { System.out.print("> "); if (!scanner.hasNextLine()) { client.finishSession(); break; } String userText = scanner.nextLine(); if (userText.isEmpty()) { // Input kosong: commit buffer dan akhiri sesi System.out.println("Input kosong, mengirim event commit dan mengakhiri sesi"); client.commitTextBuffer(); Thread.sleep(300); client.finishSession(); break; } else { System.out.println("Mengirim teks: " + userText); client.appendText(userText); } } scanner.close(); // Tunggu respons selesai client.waitForResponseDone(); client.waitForSessionFinished(); client.close(); // Tunggu pemutaran selesai playing.set(false); playerThread.join(); audioLine.drain(); audioLine.close(); // Simpan file audio saveWav("output.wav"); System.out.println("Selesai"); } private static void saveWav(String filename) throws IOException { if (audioChunks.isEmpty()) { System.out.println("Tidak ada data audio untuk disimpan"); return; } ByteArrayOutputStream bos = new ByteArrayOutputStream(); for (byte[] chunk : audioChunks) { bos.write(chunk); } byte[] allAudio = bos.toByteArray(); AudioFormat format = new AudioFormat(SAMPLE_RATE, 16, 1, true, false); AudioInputStream ais = new AudioInputStream( new ByteArrayInputStream(allAudio), format, allAudio.length / 2); new File("outputs").mkdirs(); AudioSystem.write(ais, AudioFileFormat.Type.WAVE, new File("outputs/" + filename)); System.out.println("Audio disimpan ke: outputs/" + filename); } }Kompilasi dan jalankan
Commit.java. Anda dapat memasukkan teks untuk disintesis beberapa kali. Tekan Enter tanpa memasukkan teks untuk mendengar audio yang dikembalikan oleh API Realtime melalui speaker.Python
Di direktori yang sama dengan
tts_realtime_client.py, buat file Python lain bernamacommit.pydan salin kode berikut ke dalam file tersebut:import os import asyncio import logging import wave from tts_realtime_client import TTSRealtimeClient, SessionMode import pyaudio # Konfigurasi layanan QwenTTS # Berikut ini adalah konfigurasi untuk wilayah Singapura. URL = "wss://dashscope-intl.aliyuncs.com/api-ws/v1/realtime?model=qwen3-tts-flash-realtime" # Kunci API berbeda antara wilayah Singapura dan Beijing. Dapatkan Kunci API Anda: https://www.alibabacloud.com/help/zh/model-studio/get-api-key # Jika Anda belum mengonfigurasi variabel lingkungan, ganti baris berikut dengan Kunci API Model Studio China Anda: API_KEY="sk-xxx" API_KEY = os.getenv("DASHSCOPE_API_KEY") if not API_KEY: raise ValueError("Harap atur variabel lingkungan DASHSCOPE_API_KEY") # Mengumpulkan data audio _audio_chunks = [] _AUDIO_SAMPLE_RATE = 24000 _audio_pyaudio = pyaudio.PyAudio() _audio_stream = None def _audio_callback(audio_bytes: bytes): """Callback audio TTSRealtimeClient: pemutaran real-time dan caching""" global _audio_stream if _audio_stream is not None: try: _audio_stream.write(audio_bytes) except Exception as exc: logging.error(f"Kesalahan pemutaran PyAudio: {exc}") _audio_chunks.append(audio_bytes) logging.info(f"Menerima chunk audio: {len(audio_bytes)} byte") def _save_audio_to_file(filename: str = "output.wav", sample_rate: int = 24000) -> bool: """Menyimpan data audio yang dikumpulkan sebagai file WAV""" if not _audio_chunks: logging.warning("Tidak ada data audio untuk disimpan") return False try: audio_data = b"".join(_audio_chunks) with wave.open(filename, 'wb') as wav_file: wav_file.setnchannels(1) # Mono wav_file.setsampwidth(2) # 16-bit wav_file.setframerate(sample_rate) wav_file.writeframes(audio_data) logging.info(f"Audio disimpan ke: {filename}") return True except Exception as exc: logging.error(f"Gagal menyimpan audio: {exc}") return False async def _user_input_loop(client: TTSRealtimeClient): """Terus-menerus mendapatkan input pengguna dan mengirim teks. Ketika pengguna memasukkan teks kosong, kirim event commit dan akhiri sesi saat ini""" print("Masukkan teks (tekan Enter langsung untuk mengirim event commit dan mengakhiri sesi saat ini, tekan Ctrl+C atau Ctrl+D untuk keluar dari program):") while True: try: user_text = input("> ") if not user_text: # Input pengguna kosong # Input kosong dianggap sebagai akhir percakapan: buffer commit -> akhiri sesi -> hentikan loop logging.info("Input kosong, mengirim event commit dan mengakhiri sesi saat ini") await client.commit_text_buffer() # Tunggu sebentar agar server memproses commit, mencegah pengakhiran sesi prematur yang dapat menyebabkan kehilangan audio await asyncio.sleep(0.3) await client.finish_session() break # Keluar dari loop input pengguna langsung, tidak perlu menekan Enter lagi else: logging.info(f"Mengirim teks: {user_text}") await client.append_text(user_text) except EOFError: # Pengguna menekan Ctrl+D break except KeyboardInterrupt: # Pengguna menekan Ctrl+C break # Akhiri sesi logging.info("Mengakhiri sesi...") async def _run_demo(): """Menjalankan demo lengkap""" global _audio_stream # Buka aliran output PyAudio _audio_stream = _audio_pyaudio.open( format=pyaudio.paInt16, channels=1, rate=_AUDIO_SAMPLE_RATE, output=True, frames_per_buffer=1024 ) client = TTSRealtimeClient( base_url=URL, api_key=API_KEY, voice="Cherry", mode=SessionMode.COMMIT, # Diubah ke mode COMMIT audio_callback=_audio_callback ) # Membuat koneksi await client.connect() # Menjalankan penanganan pesan dan input pengguna secara paralel consumer_task = asyncio.create_task(client.handle_messages()) producer_task = asyncio.create_task(_user_input_loop(client)) await producer_task # Menunggu input pengguna selesai # Menunggu response.done await client.wait_for_response_done() # Menutup koneksi dan membatalkan tugas consumer await client.close() consumer_task.cancel() # Menutup aliran audio if _audio_stream is not None: _audio_stream.stop_stream() _audio_stream.close() _audio_pyaudio.terminate() # Menyimpan data audio os.makedirs("outputs", exist_ok=True) _save_audio_to_file(os.path.join("outputs", "qwen_tts_output.wav")) def main(): logging.basicConfig( level=logging.INFO, format='%(asctime)s [%(levelname)s] %(message)s', datefmt='%Y-%m-%d %H:%M:%S' ) logging.info("Memulai demo Klien Realtime QwenTTS…") asyncio.run(_run_demo()) if __name__ == "__main__": main()Jalankan
commit.py. Anda dapat memasukkan teks untuk disintesis beberapa kali. Tekan Enter tanpa memasukkan teks untuk mendengar audio yang dikembalikan oleh API Realtime melalui speaker. -
server_commit mode