Topik ini menjelaskan skenario umum kesenjangan data di MaxCompute dan solusinya.
MapReduce
Untuk memahami kesenjangan data, Anda harus terlebih dahulu memahami MapReduce. MapReduce adalah framework komputasi terdistribusi yang menerapkan strategi bagi-dan-taklukkan (divide-and-conquer). Framework ini membagi masalah besar atau kompleks menjadi submasalah yang lebih kecil dan dapat dikelola, memproses submasalah tersebut, lalu menggabungkan hasilnya untuk menghasilkan output akhir. Dibandingkan dengan framework pemrograman paralel tradisional, MapReduce menawarkan toleransi kesalahan tinggi, kemudahan penggunaan, serta skalabilitas yang sangat baik. Saat menggunakan MapReduce untuk mengimplementasikan program paralel, Anda tidak perlu mempertimbangkan isu-isu non-pemrograman dalam kluster terdistribusi, seperti penyimpanan data atau mekanisme pertukaran dan transmisi informasi antar node. Hal ini sangat menyederhanakan pemrograman terdistribusi.
Gambar berikut menunjukkan alur kerja MapReduce.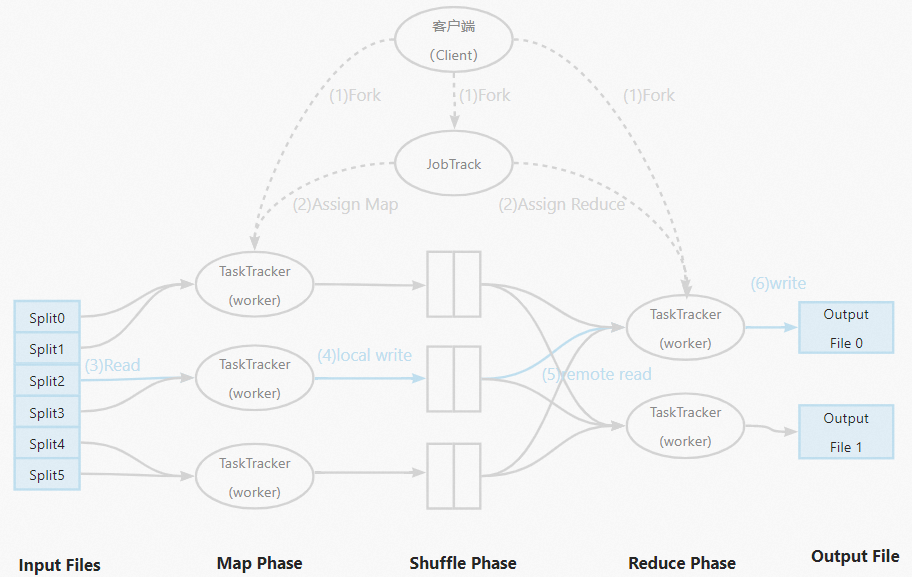
Kesenjangan data
Kesenjangan data sering terjadi pada tahap reducer. Meskipun mapper biasanya membagi file input secara merata, kesenjangan data muncul ketika data didistribusikan secara tidak merata di antara worker. Distribusi yang tidak merata ini menyebabkan sebagian worker selesai dengan cepat, sementara yang lain membutuhkan waktu jauh lebih lama. Di lingkungan produksi, sebagian besar data bersifat skewed (miring), mengikuti prinsip Pareto atau aturan 80/20. Misalnya, 20% pengguna aktif di sebuah forum mungkin menghasilkan 80% postingan, atau 20% pengguna menghasilkan 80% traffic ke sebuah situs web. Di era data besar, kesenjangan data dapat berdampak signifikan terhadap kinerja program terdistribusi. Gejala umumnya adalah pekerjaan (job) yang tampak macet di progres 99%.
Cara mengidentifikasi kesenjangan data
Prosedur
Untuk mengidentifikasi kesenjangan data di MaxCompute, gunakan Logview sebagai berikut:
Di tab Fuxi Jobs, urutkan job berdasarkan Latency secara menurun dan pilih tahap job dengan waktu proses terlama.
Di daftar Fuxi instance untuk tahap tersebut, urutkan instance berdasarkan Latency secara menurun. Pilih instance dengan waktu proses yang jauh lebih lama dari rata-rata (biasanya yang pertama dalam daftar). Lihat log output-nya di kolom StdOut.
Gunakan informasi dalam log StdOut untuk melihat graf eksekusi job yang sesuai.
Gunakan informasi kunci dalam graf eksekusi job untuk menemukan cuplikan SQL yang menyebabkan kesenjangan data.
Contoh
Temukan URL Logview di log jalannya task. Untuk informasi selengkapnya, lihat Titik masuk Logview.
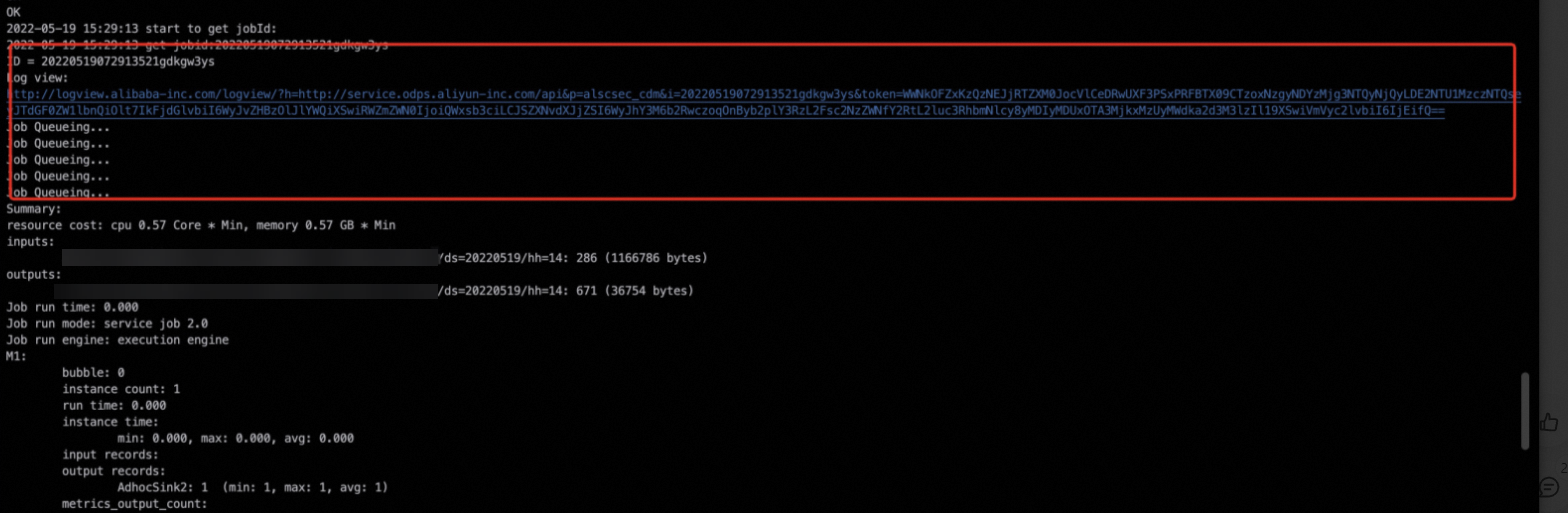
Untuk mengidentifikasi masalah dengan cepat, urutkan task Fuxi di halaman Logview berdasarkan Latency secara menurun dan pilih yang memiliki waktu proses terlama.
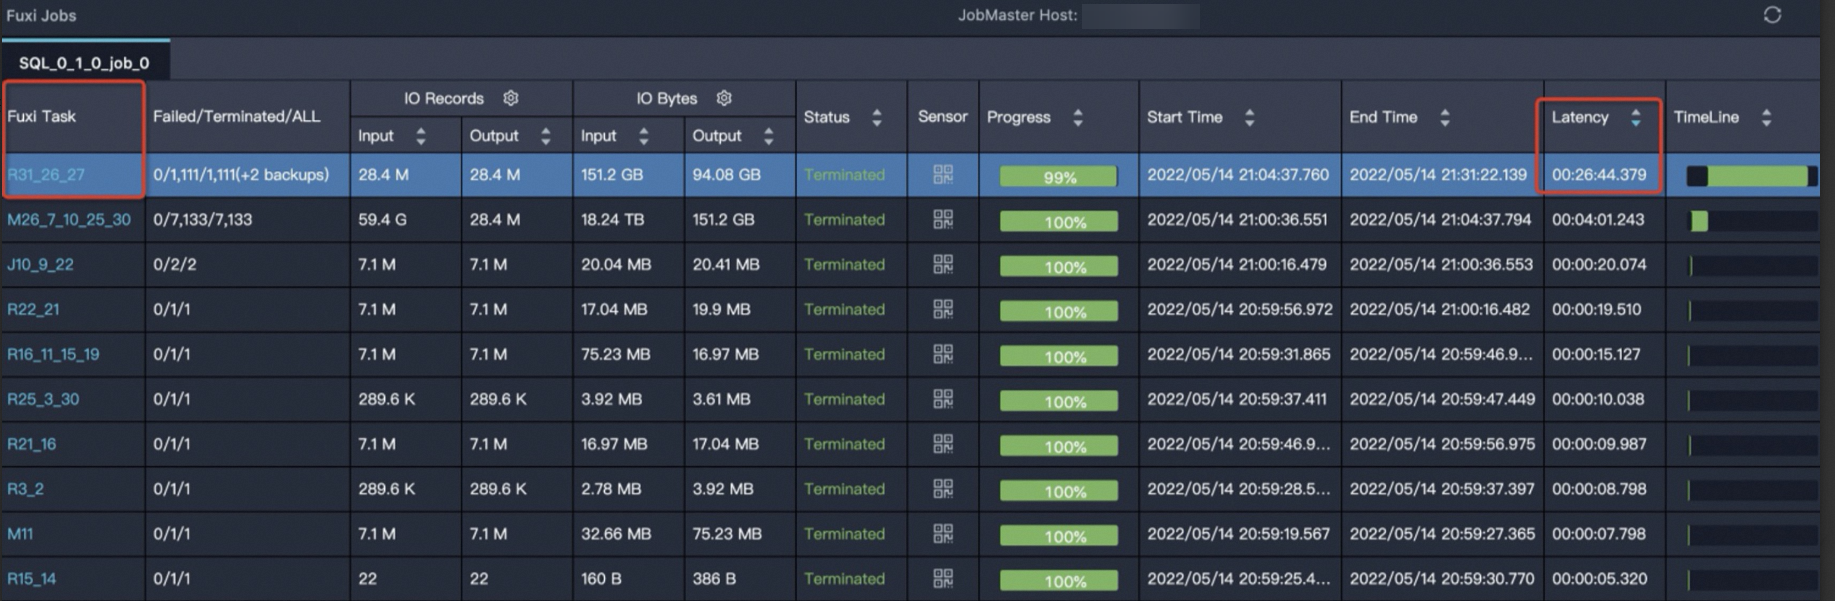
Task
R31_26_27memiliki waktu proses terlama. Klik taskR31_26_27untuk membuka halaman detail instance, seperti yang ditunjukkan pada gambar berikut.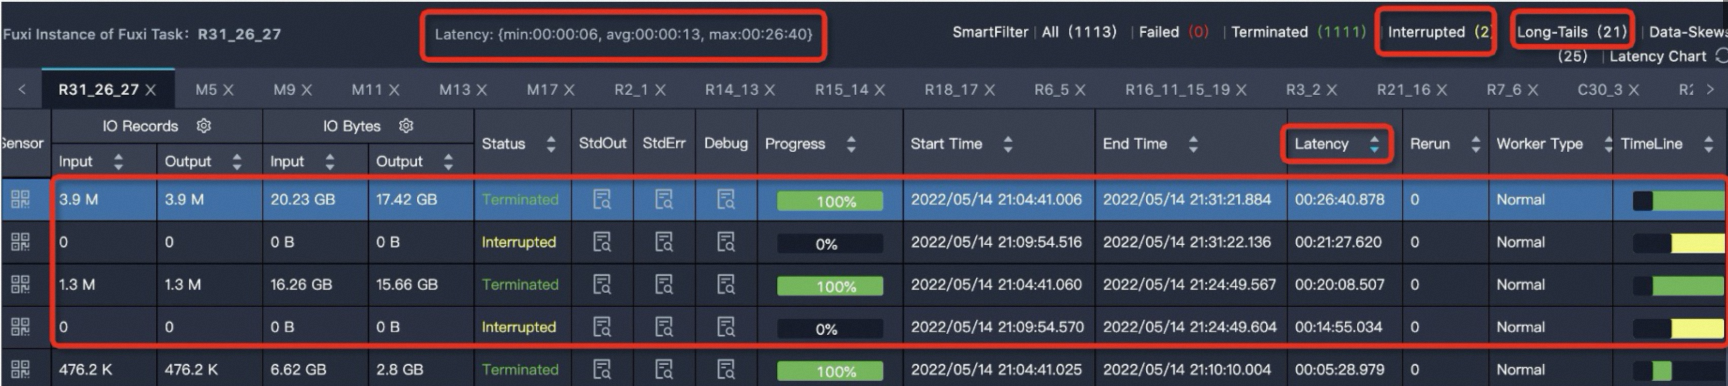 Baris
Latency: {min:00:00:06, avg:00:00:13, max:00:26:40}menunjukkan bahwa waktu proses minimum suatu instance adalah6 detik, rata-rata13 detik, dan maksimum26 menit 40 detik.Urutkan instance berdasarkan
Latencysecara menurun. Anda dapat melihat bahwa empat instance memiliki waktu proses yang panjang.MaxCompute menganggap suatu instance Fuxi sebagai long tail jika waktu prosesnya lebih dari dua kali rata-rata. Artinya, instance task dengan waktu proses lebih dari
26 detikdiidentifikasi sebagai long tail. Dalam kasus ini, 21 instance memiliki waktu proses lebih dari26 detik. Namun, keberadaan instance long tail belum tentu menandakan adanya kesenjangan data. Anda juga perlu membandingkan nilaiavgdanmaxdari waktu proses instance. Suatu task dianggap mengalami kesenjangan data parah dan memerlukan optimasi jika nilaimax-nya jauh lebih besar daripada nilaiavg-nya.Klik ikon
 di kolom StdOut untuk melihat log output, seperti pada contoh berikut.
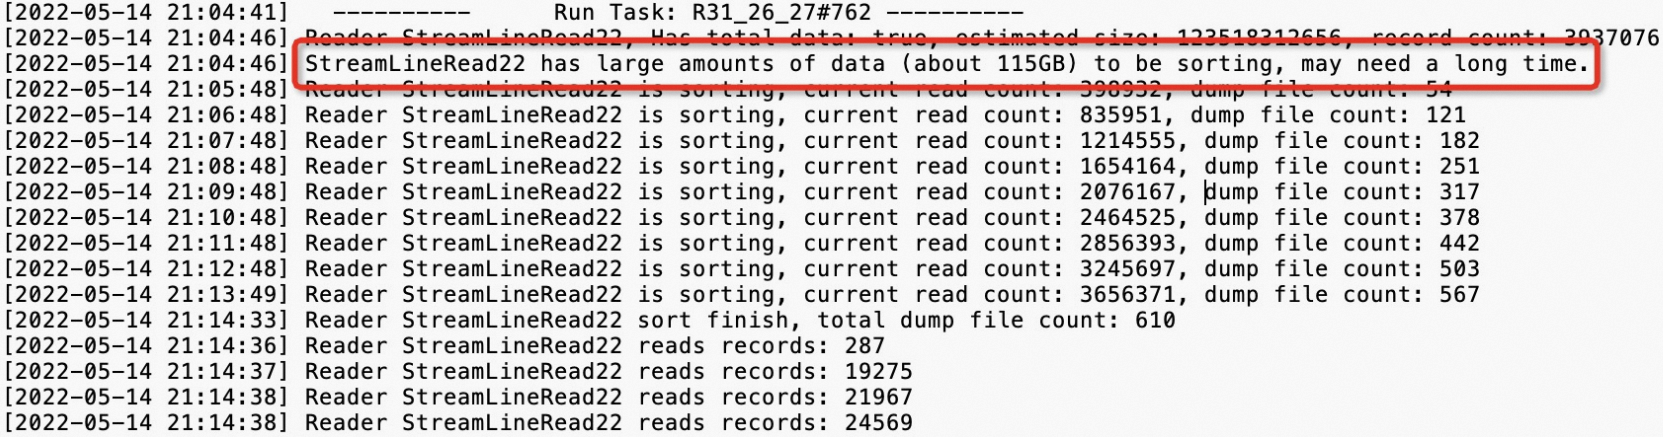
Setelah mengidentifikasi masalahnya, buka tab Job Details, klik kanan
R31_26_27, lalu pilih Expand All untuk memperluas task. Untuk informasi selengkapnya, lihat Menggunakan Logview 2.0 untuk melihat informasi job.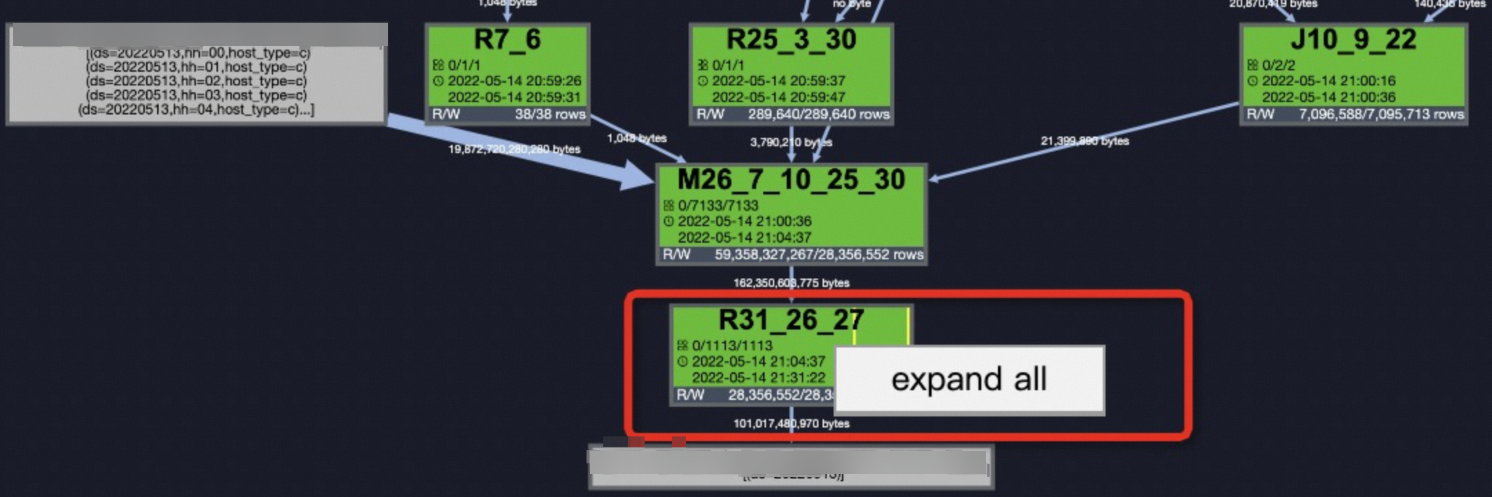 Periksa langkah sebelum
StreamLineRead22, yaituStreamLineWriter21. Hal ini memungkinkan Anda mengidentifikasi kunci yang skewed (new_uri_path_structure,cookie_x5check_userid, dancookie_userid) serta menemukan cuplikan SQL yang menyebabkan kesenjangan data.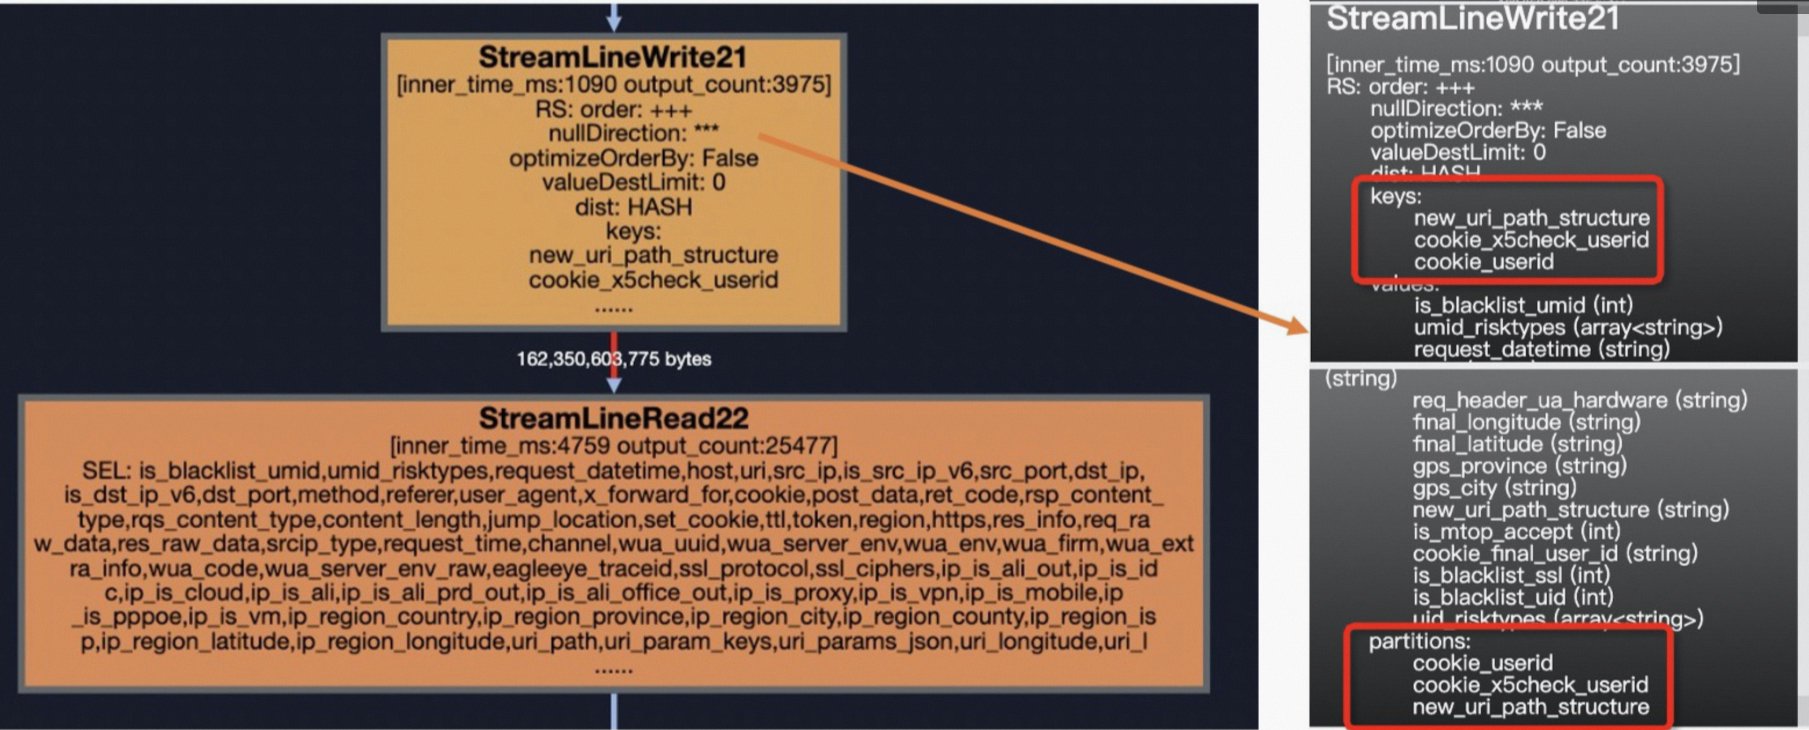
Pemecahan masalah dan penyelesaian kesenjangan data
Penyebab paling umum kesenjangan data tercantum di bawah ini berdasarkan frekuensi kejadiannya:
JOIN
GROUP BY
COUNT(DISTINCT)
ROW_NUMBER (TopN)
dynamic partition
JOIN
Kesenjangan data yang terjadi pada operasi JOIN dapat disebabkan oleh berbagai skenario, seperti menggabungkan tabel besar dengan tabel kecil, tabel besar dengan tabel menengah, atau hot key yang menyebabkan long tail.
Tabel besar dan kecil
Contoh kesenjangan data
Pada contoh berikut,
t1adalah tabel besar, sedangkant2dant3adalah tabel kecil.SELECT t1.ip ,t1.is_anon ,t1.user_id ,t1.user_agent ,t1.referer ,t2.ssl_ciphers ,t3.shop_province_name ,t3.shop_city_name FROM <viewtable> t1 LEFT OUTER JOIN <other_viewtable> t2 ON t1.header_eagleeye_traceid = t2.eagleeye_traceid LEFT OUTER JOIN ( SELECT shop_id ,city_name AS shop_city_name ,province_name AS shop_province_name FROM <tenanttable> WHERE ds = MAX_PT('<tenanttable>') AND is_valid = 1 ) t3 ON t1.shopid = t3.shop_idSolusi
Gunakan sintaks MAPJOIN hint, seperti pada kode berikut.
SELECT  /*+ mapjoin(t2,t3)*/
        t1.ip
        ,t1.is_anon
        ,t1.user_id
        ,t1.user_agent
        ,t1.referer
        ,t2.ssl_ciphers
        ,t3.shop_province_name
        ,t3.shop_city_name
FROM    <viewtable> t1
LEFT OUTER JOIN (<other_viewtable>) t2
ON t1.header_eagleeye_traceid = t2.eagleeye_traceid
LEFT OUTER JOIN (  SELECT  shop_id
                            ,city_name AS shop_city_name
                            ,province_name AS shop_province_name
                    FROM    <tenanttable>
                    WHERE   ds = MAX_PT('<tenanttable>')
                    AND     is_valid = 1
                ) t3
ON t1.shopid = t3.shop_id
Catatan penggunaan
Saat mereferensikan tabel kecil atau subkueri, Anda harus menggunakan alias-nya.
MAPJOIN mendukung subkueri sebagai tabel kecil.
Dalam MAPJOIN, Anda dapat menggunakan non-equi-join atau menggabungkan beberapa kondisi dengan
OR. Anda dapat menghitung Produk Kartesius dengan menghilangkan klausaONdan menggunakanmapjoin on 1 = 1. Contohnya:select /*+ mapjoin(a) */ a.id from shop a join table_name b on 1=1;. Namun, operasi ini dapat menyebabkan pembengkakan data (data bloat).Dalam MAPJOIN, pisahkan beberapa tabel kecil dengan koma (
,), misalnya/*+ mapjoin(a,b,c)*/.MAPJOIN memuat semua data tabel yang ditentukan ke dalam memori selama tahap map. Oleh karena itu, tabel yang ditentukan harus berukuran kecil. Ukuran data di memori untuk setiap tabel tidak boleh melebihi 512 MB. Batas ini berlaku untuk ukuran data setelah dimuat ke memori, yang bisa jauh lebih besar daripada ukuran penyimpanannya yang terkompresi. Anda dapat meningkatkan batas memori ini hingga 8.192 MB dengan mengatur parameter berikut:
SET odps.sql.mapjoin.memory.max=2048;Batasan operasi JOIN dalam MAPJOIN:
Untuk
LEFT OUTER JOIN, tabel kiri harus merupakan tabel besar.Untuk
RIGHT OUTER JOIN, tabel kanan harus merupakan tabel besar.FULL OUTER JOINtidak didukung.Untuk
INNER JOIN, baik tabel kiri maupun kanan dapat menjadi tabel besar.MAPJOIN mendukung maksimal 128 tabel kecil. Jika melebihi batas ini, akan muncul error sintaks.
Tabel besar dan menengah
Contoh kesenjangan data
Pada contoh berikut,
t0adalah tabel besar dant1adalah tabel berukuran menengah.SELECT request_datetime ,host ,URI ,eagleeye_traceid FROM <viewtable> t0 LEFT JOIN ( SELECT traceid, eleme_uid, isLogin_is FROM <servicetable> WHERE ds = '${today}' AND hh = '${hour}' ) t1 ON t0.eagleeye_traceid = t1.traceid WHERE ds = '${today}' AND hh = '${hour}'Solusi
Gunakan DISTRIBUTED MAPJOIN hint untuk mengatasi kesenjangan data, seperti pada kode berikut.
SELECT  /*+distmapjoin(t1)*/
        request_datetime
        ,host
        ,URI
        ,eagleeye_traceid
FROM <viewtable>
    t0
LEFT JOIN (
    SELECT
    traceid,
    eleme_uid,
    isLogin_is
    FROM <servicetable>
    WHERE ds = '${today}'
    AND     hh = '${hour}'
) t1 ON t0.eagleeye_traceid = t1.traceid
WHERE   ds = '${today}'
AND     hh = '${hour}'
Hot key join
Contoh kesenjangan data
Pada tabel berikut, kolom
eleme_uidberisi banyak hot key, yang dapat dengan mudah menyebabkan kesenjangan data.SELECT eleme_uid, ... FROM ( SELECT eleme_uid, ... FROM <viewtable> )t1 LEFT JOIN( SELECT eleme_uid, ... FROM <customertable> ) t2 ON t1.eleme_uid = t2.eleme_uid;Solusi
Anda dapat mengatasi masalah ini dengan salah satu dari tiga metode berikut.
Metode
Nama
Deskripsi
Metode 1
Pembagian manual hot key
Identifikasi hot key, filter dari tabel utama, lalu proses dengan MAPJOIN. Proses catatan non-hot key yang tersisa dengan MergeJoin. Terakhir, gabungkan hasil kedua JOIN tersebut.
Metode 2
SkewJoin hint
Gunakan hint
/*+ skewJoin(<table_name>[(<column1_name>[,<column2_name>,...])][((<value11>,<value12>)[,(<value21>,<value22>)...])]*/. Penggunaan SkewJoin hint menambahkan langkah tambahan untuk menemukan kunci skewed, yang meningkatkan waktu proses kueri. Jika Anda sudah mengetahui kunci skewed-nya, Anda dapat mengatur parameter SkewJoin untuk menghemat waktu.Metode 3
Modulo-equi join
Gunakan tabel multiplier untuk mendistribusikan hot key.
Pembagian manual hot key.
Setelah nilai hot diidentifikasi, catatan yang memuatnya difilter dari tabel utama untuk MapJoin. Catatan yang tersisa tanpa nilai hot diproses dengan MergeJoin. Terakhir, hasil kedua join digabungkan. Untuk detailnya, lihat contoh kode berikut:
SELECT
/*+ MAPJOIN (t2) */
eleme_uid,
...
FROM (
    SELECT
    eleme_uid,
    ...
    FROM <viewtable>
    WHERE eleme_uid = <skewed_value>
)t1
LEFT JOIN(
    SELECT
    eleme_uid,
    ...
    FROM <customertable>
    WHERE eleme_uid = <skewed_value>
)  t2
ON t1.eleme_uid = t2.eleme_uid
UNION ALL
SELECT
eleme_uid,
...
FROM (
    SELECT
    eleme_uid,
    ...
    FROM <viewtable>
    WHERE eleme_uid != <skewed_value>
)t3
LEFT JOIN(
    SELECT
    eleme_uid,
    ...
    FROM <customertable>
    WHERE eleme_uid != <skewed_value>
)  t4
ON t3.eleme_uid = t4.eleme_uid
SkewJoin hint.
Dalam pernyataan
SELECT, gunakan hint/*+ skewJoin(<table_name>[(<column1_name>[,<column2_name>,...])][((<value11>,<value12>)[,(<value21>,<value22>)...])]*/untuk menangani skew. Dalam hint ini,table_nameadalah nama tabel yang skewed,column_nameadalah nama kolom yang skewed, danvalueadalah nilai kunci skewed. Kode berikut memberikan contohnya.-- Metode 1: Beri hint nama tabel. Perhatikan bahwa Anda memberi hint alias tabel. SELECT /*+ skewjoin(a) */ * FROM T0 a JOIN T1 b ON a.c0 = b.c0 AND a.c1 = b.c1; -- Metode 2: Beri hint nama tabel dan kolom yang Anda curigai skewed. Misalnya, kolom c0 dan c1 di tabel 'a' mengalami kesenjangan data. SELECT /*+ skewjoin(a(c0, c1)) */ * FROM T0 a JOIN T1 b ON a.c0 = b.c0 AND a.c1 = b.c1 AND a.c2 = b.c2; -- Metode 3: Beri hint nama tabel dan kolom, serta berikan nilai kunci skewed. Jika nilai kunci bertipe STRING, sertakan dalam tanda kutip. Misalnya, nilai untuk (a.c0=1 dan a.c1="2") dan (a.c0=3 dan a.c1="4") keduanya skewed. SELECT /*+ skewjoin(a(c0, c1)((1, "2"), (3, "4"))) */ * FROM T0 a JOIN T1 b ON a.c0 = b.c0 AND a.c1 = b.c1 AND a.c2 = b.c2;CatatanMetode SkewJoin hint yang langsung menentukan nilai lebih efisien dibandingkan pembagian manual hot key atau penggunaan hint tanpa menentukan nilai.
Jenis JOIN yang didukung oleh SkewJoin hint:
Untuk
INNER JOIN, Anda dapat memberi hint pada salah satu tabel dalam join.Untuk
LEFT JOIN,SEMI JOIN, atauANTI JOIN, Anda hanya dapat memberi hint pada tabel kiri.Untuk
RIGHT JOIN, Anda hanya dapat memberi hint pada tabel kanan.FULL JOINtidak mendukung SkewJoin hint.
Kami menyarankan Anda hanya menambahkan hint pada JOIN yang dipastikan mengalami kesenjangan data, karena hint tersebut menjalankan agregasi yang memerlukan biaya.
Tipe data kunci join di sisi kiri JOIN yang diberi hint harus sama dengan tipe data kunci join di sisi kanan. Jika tidak, SkewJoin hint tidak berlaku. Misalnya, tipe data
a.c0harus sama dengan tipe datab.c0, dan tipe dataa.c1harus sama dengan tipe datab.c1. Anda dapat menggunakan fungsi CAST dalam subkueri untuk memastikan konsistensi tipe data. Berikut contohnya:CREATE TABLE T0(c0 int, c1 int, c2 int, c3 int); CREATE TABLE T1(c0 string, c1 int, c2 int); -- Metode 1: SELECT /*+ skewjoin(a) */ * FROM T0 a JOIN T1 b ON cast(a.c0 AS string) = b.c0 AND a.c1 = b.c1; -- Metode 2: SELECT /*+ skewjoin(b) */ * FROM (SELECT cast(a.c0 AS string) AS c00 FROM T0 a) b JOIN T1 c ON b.c00 = c.c0;Setelah menambahkan SkewJoin hint, pengoptimal menjalankan agregasi untuk mendapatkan 20 hot key teratas.
20adalah nilai default, yang dapat diubah denganset odps.optimizer.skew.join.topk.num = xx;.SkewJoin hint hanya mendukung pemberian hint pada satu sisi JOIN.
JOIN yang diberi hint harus memiliki kondisi
left_key = right_key. JOIN Produk Kartesius tidak didukung.Anda tidak dapat menambahkan SkewJoin hint pada JOIN yang sudah memiliki hint MAPJOIN.
Modulo-equi join dengan tabel multiplier.
Pendekatan ini secara logis berbeda dari tiga solusi sebelumnya. Pendekatan ini tidak menggunakan strategi bagi-dan-taklukkan. Sebaliknya, pendekatan ini menggunakan tabel multiplier yang berisi satu kolom integer dengan nilai dari 1 hingga N, di mana N ditentukan oleh tingkat skew. Tabel ini digunakan untuk memperluas tabel perilaku pengguna sebanyak N kali. Operasi JOIN selanjutnya kemudian menggunakan dua kunci join: ID pengguna dan
number. Dengan menambahkan kondisi joinnumber, kesenjangan data yang disebabkan oleh distribusi data berdasarkan hanya ID pengguna berkurang menjadi1/Ndari tingkat awalnya. Namun, kelemahan pendekatan ini adalah data juga mengembang sebanyak N kali.SELECT eleme_uid, ... FROM ( SELECT eleme_uid, ... FROM <viewtable> )t1 LEFT JOIN( SELECT /*+mapjoin(<multipletable>)*/ eleme_uid, number ... FROM <customertable> JOIN <multipletable> ) t2 ON t1.eleme_uid = t2.eleme_uid AND mod(t1.<value_col>,10)+1 = t2.number;Untuk mengatasi pembengkakan data, Anda dapat membatasi ekspansi hanya pada catatan hot key di kedua tabel, sementara catatan non-hot key lainnya tetap tidak berubah. Pertama, temukan catatan hot key. Kemudian, proses tabel traffic dan tabel perilaku pengguna secara terpisah dengan menambahkan kolom baru
eleme_uid_join. Jika ID pengguna adalah hot key,CONCATbilangan bulat positif yang ditetapkan secara acak (misalnya, dari 0 hingga 1.000). Jika tidak, pertahankan ID pengguna asli. Saat menggabungkan kedua tabel, gunakan kolomeleme_uid_join. Hal ini mendistribusikan hot key untuk mengurangi skew sekaligus menghindari ekspansi yang tidak perlu pada catatan non-hot key. Namun, logika ini sangat mengubah ulang SQL logika bisnis asli sehingga tidak direkomendasikan.
GROUP BY
Kode berikut memberikan contoh pseudo-code dengan klausa GROUP BY.
SELECT  shop_id
        ,sum(is_open) AS open_days
FROM    table_xxx_di
WHERE   dt BETWEEN '${bizdate_365}' AND '${bizdate}'
GROUP BY shop_id;
Saat terjadi kesenjangan data, Anda dapat menggunakan salah satu dari tiga solusi berikut:
Metode | Nama | Deskripsi |
Metode 1 | Atur parameter anti-skew untuk GROUP BY | Atur |
Metode 2 | Tambahkan bilangan acak | Pisahkan kunci yang menyebabkan long tail. |
Metode 3 | Buat tabel bergulir | Kurangi biaya dan tingkatkan efisiensi. |
Metode 1: Atur parameter anti-skew untuk GROUP BY.
SET odps.sql.groupby.skewindata=true;Metode 2: Tambahkan bilangan acak.
Solusi ini menulis ulang SQL dengan menambahkan bilangan acak, memisahkan kunci yang menyebabkan long tail. Ini adalah metode efektif untuk mengatasi long tail dalam operasi GROUP BY.
Untuk kueri SQL
Select Key,Count(*) As Cnt From TableName Group By Key;, tanpa combiner, node mapper melakukan shuffle data ke node reducer, yang kemudian melakukan operasi COUNT. Rencana eksekusi yang sesuai adalahM->R.Dengan asumsi kunci long-tail telah diidentifikasi, Anda dapat mendistribusikan ulang pekerjaan untuk kunci tersebut sebagai berikut:
-- Asumsikan kunci long-tail adalah KEY001.
SELECT  a.Key
        ,SUM(a.Cnt) AS Cnt
FROM(SELECT  Key
            ,COUNT(*) AS Cnt
            FROM    <TableName>
            GROUP BY Key
            ,CASE WHEN KEY = 'KEY001' THEN Hash(Random()) % 50
             ELSE 0
            END
        ) a
GROUP BY a.Key;
Rencana eksekusi yang dimodifikasi menjadi
M->R->R. Meskipun jumlah langkah eksekusi bertambah, waktu proses keseluruhan mungkin berkurang karena kunci long-tail diproses dalam dua tahap. Konsumsi resource dan efisiensi waktu mirip dengan Metode 1. Namun, dalam skenario dunia nyata, sering kali ada lebih dari satu kunci long-tail. Mengingat upaya untuk menemukan kunci long-tail dan menulis ulang SQL, Metode 1 sering kali lebih hemat biaya.Metode 3: Buat tabel rolling.
Untuk mengurangi biaya dan meningkatkan efisiensi, Anda mungkin perlu mengambil data dari tahun lalu. Untuk task online, membaca semua partisi dari
T-1hinggaT-365setiap kali merupakan pemborosan resource yang signifikan. Membuat tabel rolling dapat mengurangi jumlah partisi yang dibaca tanpa memengaruhi pengambilan data untuk tahun lalu. Kode berikut memberikan contohnya.Pertama, inisialisasi data bisnis merchant selama 365 hari dengan agregasi GROUP BY, tandai tanggal pembaruan data, dan simpan sebagai tabel
a. Task online berikutnya kemudian dapat menggabungkan tabelT-2adengan tabeltable_xxx_didan melakukan GROUP BY lagi. Hal ini mengurangi jumlah partisi yang dibaca setiap hari dari 365 menjadi 2. Duplikasi primary keyshop_idsangat berkurang, yang juga menurunkan konsumsi resource.-- Buat tabel rolling. CREATE TABLE IF NOT EXISTS m_xxx_365_df ( shop_id STRING, last_update_ds STRING, `365d_open_days` BIGINT ) PARTITIONED BY ( ds STRING COMMENT 'Partisi tanggal' )LIFECYCLE 7; -- Asumsikan periode 365 hari adalah 2021-05-01 hingga 2022-05-01. Lakukan inisialisasi satu kali. INSERT OVERWRITE TABLE m_xxx_365_df PARTITION(ds = '20220501') SELECT shop_id, max(ds) as last_update_ds, sum(is_open) AS `365d_open_days` FROM table_xxx_di WHERE dt BETWEEN '20210501' AND '20220501' GROUP BY shop_id; -- Kemudian, task online harian yang dijalankan adalah: INSERT OVERWRITE TABLE m_xxx_365_df PARTITION(ds = '${bizdate}') SELECT aa.shop_id, aa.last_update_ds, `365d_open_days` - COALESCE(is_open, 0) AS `365d_open_days` -- Cegah rolling tak terbatas hari buka. FROM ( SELECT shop_id, max(last_update_ds) AS last_update_ds, sum(`365d_open_days`) AS `365d_open_days` FROM ( SELECT shop_id, ds AS last_update_ds, sum(is_open) AS `365d_open_days` FROM table_xxx_di WHERE ds = '${bizdate}' GROUP BY shop_id UNION ALL SELECT shop_id, last_update_ds, `365d_open_days` FROM m_xxx_365_df WHERE dt = '${bizdate_2}' AND last_update_ds >= '${bizdate_365}' -- Tidak perlu GROUP BY di sini jika sumber sudah dikelompokkan. ) GROUP BY shop_id ) AS aa LEFT JOIN ( SELECT shop_id, is_open FROM table_xxx_di WHERE ds = '${bizdate_366}' ) AS bb ON aa.shop_id = bb.shop_id;
COUNT(DISTINCT)
Asumsikan sebuah tabel memiliki distribusi data sebagai berikut.
ds (partisi) | cnt (jumlah catatan) |
20220416 | 73.025.514 |
20220415 | 2.292.806 |
20220417 | 2.319.160 |
Menggunakan pernyataan berikut dapat dengan mudah menyebabkan kesenjangan data:
SELECT  ds
        ,COUNT(DISTINCT shop_id) AS cnt
FROM    demo_data0
GROUP BY ds;
Solusinya adalah sebagai berikut:
Metode | Nama | Deskripsi |
Metode 1 | Penyetelan parameter | Atur |
Metode 2 | Agregasi dua tahap generik | Tambahkan bilangan acak ke nilai field partisi. |
Metode 3 | Agregasi mirip dua tahap | Pertama, kelompokkan berdasarkan field |
Metode 1: Penyetelan parameter.
Atur parameter berikut:
SET odps.sql.groupby.skewindata=true;Metode 2: Agregasi dua tahap generik.
Jika data di field
shop_iddidistribusikan secara tidak merata, Metode 1 tidak efektif. Metode yang lebih generik adalah menambahkan bilangan acak ke nilai field partisi.-- Metode A: Gabungkan bilangan acak. CONCAT(ROUND(RAND(),1)*10,'_', ds) AS rand_ds SELECT SPLIT_PART(rand_ds, '_', 2) AS ds ,COUNT(DISTINCT shop_id) AS id_cnt FROM ( SELECT CONCAT(CAST(FLOOR(RAND() * 10) AS STRING), '_', ds) AS rand_ds ,shop_id FROM demo_data0 ) GROUP BY rand_ds; -- Metode B: Tambahkan field bilangan acak. ROUND(RAND(),1)*10 AS randint10 SELECT ds ,COUNT(DISTINCT shop_id) AS id_cnt FROM (SELECT ds ,shop_id FROM demo_data0 ) GROUP BY ds, FLOOR(RAND() * 10);Metode 3: Agregasi mirip dua tahap.
Jika data untuk field GROUP BY dan DISTINCT didistribusikan secara merata, Anda dapat mengoptimalkan kueri dengan terlebih dahulu menerapkan GROUP BY pada dua field pengelompokan (ds dan shop_id), lalu menggunakan perintah
count(distinct).SELECT ds ,COUNT(shop_id) AS cnt FROM(SELECT ds ,shop_id FROM demo_data0 GROUP BY ds ,shop_id ) GROUP BY ds;
ROW_NUMBER (TopN)
Kode berikut memberikan contoh Top-10.
SELECT  main_id
        ,type
FROM    (SELECT  main_id
                 ,type
                 ,ROW_NUMBER() OVER(PARTITION BY main_id ORDER BY type DESC ) rn
            FROM <data_demo2>
        ) A
WHERE   A.rn <= 10;
Saat terjadi kesenjangan data, Anda dapat mengatasinya dengan salah satu metode berikut:
Metode | Nama | Deskripsi |
Metode 1 | Agregasi dua tahap berbasis SQL | Tambahkan kolom acak atau tambahkan bilangan acak dan gunakan sebagai parameter dalam klausa PARTITION BY. |
Metode 2 | Agregasi dua tahap berbasis UDAF | Gunakan UDAF untuk mengoptimalkan kueri dengan antrian prioritas min-heap. |
Metode 1: Agregasi dua tahap berbasis SQL.
Untuk mendistribusikan data di setiap grup partisi se-merata mungkin selama tahap map, tambahkan kolom acak dan gunakan sebagai parameter dalam klausa PARTITION BY.
-- Metode 1: Gunakan modulo pada bilangan acak.
SELECT  main_id
        ,type
  FROM  (SELECT  main_id
                 ,type
                 ,ROW_NUMBER() OVER(PARTITION BY main_id ORDER BY type DESC ) rn
            FROM (SELECT  main_id
                          ,type
                        FROM (SELECT  main_id
                                      ,type
                                      ,ROW_NUMBER() OVER(PARTITION BY main_id,src_pt ORDER BY type DESC ) rn
                                 FROM (SELECT  main_id
                                               ,type
                                               ,ceil(110 * rand()) % 11 AS src_pt
                                         FROM  data_demo2
                                      )
                                ) B
                        WHERE   B.rn <= 10
                    )
        ) A
WHERE   A.rn <= 10;
-- Metode 2: Gunakan bilangan acak kustom.
SELECT  main_id
        ,type
  FROM  (SELECT  main_id
                 ,type
                 ,ROW_NUMBER() OVER(PARTITION BY main_id ORDER BY type DESC ) rn
            FROM (SELECT  main_id
                          ,type
                    FROM(SELECT  main_id
                                 ,type
                                 ,ROW_NUMBER() OVER(PARTITION BY main_id,src_pt ORDER BY type DESC ) rn
                           FROM  (SELECT  main_id
                                          ,type
                                          ,ceil(10 * rand()) AS src_pt
                                          FROM    data_demo2
                                  )
                                ) B
                        WHERE B.rn <= 10
                    )
        ) A
WHERE   A.rn <= 10;
Metode 2: Agregasi dua tahap berbasis UDAF.
Metode SQL dapat menghasilkan kode yang panjang dan sulit dipelihara. Sebagai alternatif, Anda dapat menggunakan UDAF dengan antrian prioritas min-heap untuk optimasi. Pada fase
iterate, hanya elemen Top-N yang disimpan, dan pada fasemerge, hanya N elemen yang digabungkan. Prosesnya sebagai berikut:iterate: Dorong K elemen pertama. Untuk elemen setelah K, terus-menerus bandingkan dengan elemen teratas min-heap dan tukar elemen jika diperlukan.merge: Setelah menggabungkan dua heap, kembalikan K elemen teratas di tempatnya.terminate: Kembalikan heap sebagai array.Dalam kueri SQL, pisahkan array menjadi baris-baris terpisah.
@annotate('* -> array<string>')
class GetTopN(BaseUDAF):
    def new_buffer(self):
        return [[], None]
    def iterate(self, buffer, order_column_val, k):
        # heapq.heappush(buffer, order_column_val)
        # buffer = [heapq.nlargest(k, buffer), k]
        if not buffer[1]:
            buffer[1] = k
        if len(buffer[0]) < k:
            heapq.heappush(buffer[0], order_column_val)
        else:
            heapq.heappushpop(buffer[0], order_column_val)
    def merge(self, buffer, pbuffer):
        first_buffer, first_k = buffer
        second_buffer, second_k = pbuffer
        k = first_k or second_k
        merged_heap = first_buffer + second_buffer
        merged_heap.sort(reverse=True)
        merged_heap = merged_heap[0: k] if len(merged_heap) > k else merged_heap
        buffer[0] = merged_heap
        buffer[1] = k
    def terminate(self, buffer):
        return buffer[0]

SET odps.sql.python.version=cp37;
SELECT main_id,type_val FROM (
  SELECT  main_id ,get_topn(type, 10) AS type_array
  FROM data_demo2
  GROUP BY main_id
)
LATERAL VIEW EXPLODE(type_array)type_ar AS type_val;
Dynamic partition
Dynamic partition memungkinkan Anda memasukkan data ke tabel berpartisi dengan menentukan nama kolom partisi dalam klausa PARTITION tanpa memberikan nilai spesifik. Sebaliknya, nilai partisi disediakan oleh kolom yang sesuai dalam klausa SELECT. Oleh karena itu, partisi yang tepat untuk dibuat tidak diketahui hingga kueri SQL selesai dijalankan dan nilai kolom partisi ditentukan. Untuk informasi selengkapnya, lihat Memasukkan atau menimpa data ke partisi dinamis (DYNAMIC PARTITION). Kode berikut memberikan contoh SQL.
CREATE TABLE total_revenues (revenue bigint) partitioned BY (region string);

INSERT overwrite TABLE total_revenues PARTITION(region)
SELECT total_price AS revenue,region
FROM sale_detail;
Dynamic partition digunakan dalam banyak skenario dan dapat dengan mudah menyebabkan kesenjangan data. Saat terjadi kesenjangan data, Anda dapat mengatasinya dengan salah satu solusi berikut.
Metode | Nama | Deskripsi |
Metode 1 | Konfigurasi parameter | Optimalkan kueri dengan mengonfigurasi parameter. |
Metode 2 | Optimasi pruning | Temukan partisi dengan jumlah catatan besar, lakukan pruning, lalu masukkan secara terpisah. |
Metode 1: Konfigurasi parameter.
Partisi dinamis dapat menempatkan data yang memenuhi kondisi berbeda ke partisi berbeda, yang menghindari kebutuhan beberapa pernyataan INSERT OVERWRITE. Hal ini sangat menyederhanakan kode, terutama saat ada banyak partisi. Namun, partisi dinamis juga dapat menyebabkan jumlah file kecil yang berlebihan.
Contoh kesenjangan data
Ambil SQL sederhana berikut sebagai contoh:
INSERT INTO TABLE part_test PARTITION(ds) SELECT * FROM part_test;Asumsikan ada K instance Map dan N partisi target.
                            ds=1
cfile1                      ds=2
...             X           ds=3
cfilek                      ...
                            ds=n
Dalam kasus paling ekstrem,
K*Nfile kecil dapat dihasilkan. Jumlah file kecil yang berlebihan dapat memberikan tekanan manajemen besar pada sistem file. Oleh karena itu, MaxCompute menangani partisi dinamis dengan memperkenalkan level tambahan task reducer. Data untuk partisi target yang sama diarahkan untuk ditulis oleh instance reducer yang sama (atau beberapa), yang menghindari pembuatan terlalu banyak file kecil. Reducer ini selalu menjadi task terakhir dalam job. Di MaxCompute, fitur ini diaktifkan secara default, artinya parameter berikut diatur ke true:SET odps.sql.reshuffle.dynamicpt=true;Mengaktifkan fitur ini secara default menyelesaikan masalah terlalu banyak file kecil dan mencegah task gagal karena jumlah file yang dihasilkan oleh satu instance berlebihan. Namun, hal ini juga memperkenalkan masalah baru: kesenjangan data. Selain itu, memperkenalkan tahap reducer tambahan mengonsumsi resource komputasi. Oleh karena itu, Anda harus mempertimbangkan trade-off-nya dengan hati-hati.
Solusi
Tujuan awal memperkenalkan tahap reducer tambahan dengan mengaktifkan parameter
set odps.sql.reshuffle.dynamicpt=true;adalah untuk menyelesaikan masalah terlalu banyak file kecil. Namun, jika jumlah partisi target kecil dan tidak ada risiko memiliki terlalu banyak file kecil, mengaktifkan fitur ini secara default tidak hanya memboroskan resource komputasi tetapi juga mengurangi kinerja. Dalam kasus ini, menonaktifkan fitur ini dengan mengaturset odps.sql.reshuffle.dynamicpt=false;dapat secara signifikan meningkatkan kinerja. Kode berikut memberikan contohnya.INSERT overwrite TABLE ads_tb_cornucopia_pool_d PARTITION (ds, lv, tp) SELECT /*+ mapjoin(t2) */ '20150503' AS ds, t1.lv AS lv, t1.type AS tp FROM (SELECT ... FROM tbbi.ads_tb_cornucopia_user_d WHERE ds = '20150503' AND lv IN ('flat', '3rd') AND tp = 'T' AND pref_cat2_id > 0 ) t1 JOIN (SELECT ... FROM tbbi.ads_tb_cornucopia_auct_d WHERE ds = '20150503' AND tp = 'T' AND is_all = 'N' AND cat2_id > 0 ) t2 ON t1.pref_cat2_id = t2.cat2_id;Jika parameter default digunakan untuk kode di atas, waktu proses total job sekitar 1 jam 30 menit. Tahap reducer terakhir memakan waktu sekitar 1 jam 20 menit, yang menyumbang sekitar
90%dari total waktu proses. Pengenalan tahap reducer tambahan membuat distribusi data setiap instance reducer sangat tidak merata, yang menyebabkan long tail.
Untuk contoh di atas, dengan menganalisis jumlah historis partisi dinamis yang dihasilkan, kami menemukan bahwa hanya sekitar dua partisi dinamis yang dihasilkan setiap hari. Oleh karena itu, Anda dapat dengan aman mengatur
set odps.sql.reshuffle.dynamicpt=false;. Job kemudian dapat diselesaikan hanya dalam 9 menit. Dalam kasus ini, mengatur parameter ini kefalsedapat secara signifikan meningkatkan kinerja serta menghemat waktu dan resource komputasi. Perubahan parameter tunggal ini memberikan peningkatan signifikan dengan usaha minimal.Optimasi ini tidak hanya untuk job besar yang berjalan lama dan mengonsumsi banyak resource, tetapi juga untuk job biasa yang berjalan singkat dan mengonsumsi sedikit resource. Selama menggunakan partisi dinamis dan jumlah partisi dinamis kecil, Anda dapat mengatur parameter
odps.sql.reshuffle.dynamicptkefalseuntuk menghemat resource dan meningkatkan kinerja.Node yang memenuhi ketiga kondisi berikut dapat dioptimalkan, terlepas dari durasi job:
Job menggunakan partisi dinamis.
Jumlah partisi dinamis 50 atau kurang.
Job tidak memiliki
set odps.sql.reshuffle.dynamicpt=false;.
Waktu proses instance Fuxi terakhir dapat digunakan untuk menentukan urgensi pengaturan parameter ini untuk node tersebut. Hal ini diidentifikasi oleh field
diag_level. Aturannya sebagai berikut:Last_Fuxi_Inst_Timelebih dari 30 menit:Diag_Level=4 ('Critical').Last_Fuxi_Inst_Timeantara 20 dan 30 menit:Diag_Level=3 ('High').Last_Fuxi_Inst_Timeantara 10 dan 20 menit:Diag_Level=2 ('Medium').Last_Fuxi_Inst_Timekurang dari 10 menit:Diag_Level=1 ('Low').
Metode 2: Optimasi pruning.
Untuk mengatasi kesenjangan data yang sudah ada di tahap map saat memasukkan data ke partisi dinamis, Anda dapat menemukan dan melakukan pruning pada partisi dengan banyak catatan, lalu memasukkannya secara terpisah. Berdasarkan kasus penggunaan aktual, Anda dapat memodifikasi konfigurasi parameter tahap map sebagai berikut:
SET odps.sql.mapper.split.size=128;
INSERT OVERWRITE TABLE data_demo3 partition(ds,hh)
SELECT  *
FROM    dwd_alsc_ent_shop_info_hi;
Hasilnya menunjukkan bahwa pemindaian tabel penuh dilakukan. Untuk optimasi lebih lanjut, Anda dapat menonaktifkan job Reduce yang diperkenalkan oleh sistem, sebagai berikut:
SET odps.sql.reshuffle.dynamicpt=false ;
INSERT OVERWRITE TABLE data_demo3 partition(ds,hh)
SELECT *
FROM dwd_alsc_ent_shop_info_hi;
Untuk mengatasi kesenjangan data di tahap map saat memasukkan data ke partisi dinamis, temukan partisi dengan banyak catatan, lakukan pruning, lalu masukkan secara terpisah. Langkah-langkah spesifiknya adalah sebagai berikut:
Gunakan perintah berikut untuk mencari partisi spesifik dengan jumlah catatan besar.
SELECT  ds
        ,hh
        ,COUNT(*) AS cnt
FROM    dwd_alsc_ent_shop_info_hi
GROUP BY ds
         ,hh
ORDER BY cnt DESC;
Beberapa partisi tersebut adalah sebagai berikut:
ds
hh
cnt
20200928
17
1.052.800
20191017
17
1.041.234
20210928
17
1.034.332
20190328
17
1.000.321
20210504
1
19
20191003
20
18
20200522
1
18
20220504
1
18
Filter partisi dengan jumlah catatan besar, masukkan data yang tersisa, lalu masukkan secara terpisah data untuk partisi dengan catatan banyak.
SET odps.sql.reshuffle.dynamicpt=false ;
-- Masukkan data untuk partisi yang tidak memiliki jumlah catatan besar.
INSERT OVERWRITE TABLE data_demo3 partition(ds,hh)
SELECT  *
FROM    dwd_alsc_ent_shop_info_hi
WHERE   CONCAT(ds,hh) NOT IN ('2020092817','2019101717','2021092817','2019032817');

-- Masukkan data untuk partisi yang memiliki jumlah catatan besar.
set odps.sql.reshuffle.dynamicpt=false ;
INSERT OVERWRITE TABLE data_demo3 partition(ds,hh)
SELECT  *
FROM    dwd_alsc_ent_shop_info_hi
WHERE   CONCAT(ds,hh) IN ('2020092817','2019101717','2021092817','2019032817');

-- Verifikasi hasilnya.
SELECT  ds
  ,hh,COUNT(*) AS cnt
 FROM dwd_alsc_ent_shop_info_hi
 GROUP BY ds,hh ORDER BY cnt desc;