Topik ini menjelaskan permasalahan bisnis yang dapat diatasi oleh solusi gudang data near real-time serta fitur arsitektur utamanya.
Informasi latar belakang
Seiring skenario pemrosesan data menjadi semakin kompleks, banyak skenario bisnis tidak lagi memerlukan tampilan data yang diperbarui dalam hitungan detik atau pembaruan tingkat baris. Sebaliknya, yang dibutuhkan adalah pemrosesan data near real-time pada tingkat menit atau jam, serta pemrosesan batch sejumlah besar data. MaxCompute menyediakan tabel Delta untuk memenuhi kebutuhan bisnis Anda terkait penyimpanan dan pemrosesan data penuh (full) maupun data inkremental secara near real-time.
Analisis situasi saat ini
Pada skenario bisnis dengan ketepatan waktu rendah yang memerlukan pemrosesan batch sejumlah besar data, Anda dapat menggunakan MaxCompute. Pada skenario bisnis dengan ketepatan waktu tinggi yang memerlukan pemrosesan data real-time tingkat detik atau pemrosesan streaming, Anda perlu menggunakan sistem pemrosesan data real-time atau sistem streaming. Namun, pada skenario bisnis komprehensif—seperti kombinasi antara pemrosesan data near real-time tingkat menit atau jam dan pemrosesan batch sejumlah besar data—masalah tertentu dapat muncul baik saat menggunakan satu mesin komputasi maupun beberapa mesin federasi.

Masalah tertentu dapat muncul jika Anda hanya menggunakan MaxCompute untuk pemrosesan batch dalam skenario tertentu, seperti yang ditunjukkan pada gambar di atas. Misalnya, jika Anda menggunakan MaxCompute dalam skenario yang memerlukan penggabungan dan penyimpanan berkelanjutan antara data inkremental tingkat menit dan data penuh pengguna, biaya komputasi dan penyimpanan tambahan akan timbul. Jika Anda menggunakan MaxCompute dalam skenario yang memerlukan konversi rantai dan logika pemrosesan data kompleks menjadi pemrosesan batch data dalam periode T+1 hari, kompleksitas rantai pemrosesan data meningkat dan ketepatan waktunya tidak memenuhi kebutuhan bisnis. Di sisi lain, jika Anda hanya menggunakan sistem pemrosesan data real-time dalam skenario tersebut, biaya sumber daya menjadi tinggi, efisiensi biaya rendah, dan pemrosesan batch data berskala besar menjadi tidak stabil. Dalam kebanyakan kasus, arsitektur Lambda digunakan sebagai solusi. Dalam arsitektur Lambda, MaxCompute digunakan untuk pemrosesan batch data penuh, sedangkan sistem pemrosesan data real-time digunakan untuk pemrosesan data inkremental guna memenuhi kebutuhan ketepatan waktu tinggi. Namun, arsitektur Lambda dapat menimbulkan masalah yang sudah diketahui, seperti inkonsistensi data antara beberapa set mesin pemrosesan dan penyimpanan, biaya tambahan akibat penyimpanan dan komputasi redundan dari beberapa salinan data, arsitektur yang kompleks, serta siklus pengembangan jangka panjang.
Untuk mengatasi masalah-masalah tersebut, ekosistem open source data besar telah meluncurkan berbagai solusi dalam beberapa tahun terakhir. Solusi paling populer adalah integrasi mendalam antara mesin pemrosesan data open source seperti Spark, Flink, atau Presto dengan data lake open source seperti Hudi, Delta Lake, dan Iceberg guna mewujudkan mesin komputasi dan penyimpanan data yang terpadu. Solusi ini dapat membantu mengatasi serangkaian masalah yang disebabkan oleh arsitektur Lambda. Berdasarkan arsitektur MaxCompute, dikembangkan sebuah arsitektur penyimpanan dan pemrosesan data inkremental yang menyediakan solusi terintegrasi untuk pemrosesan data batch dan pemrosesan data inkremental near real-time. Arsitektur ini mempertahankan efisiensi biaya pemrosesan batch sekaligus memenuhi kebutuhan bisnis terkait pembacaan, penulisan, dan pemrosesan data inkremental tingkat menit. Arsitektur ini juga menyediakan fitur praktis seperti operasi UPSERT dan fitur time travel untuk memperluas skenario bisnis, sehingga membantu mengurangi biaya komputasi, penyimpanan, dan migrasi data serta meningkatkan pengalaman pengguna.
Arsitektur near real-time MaxCompute
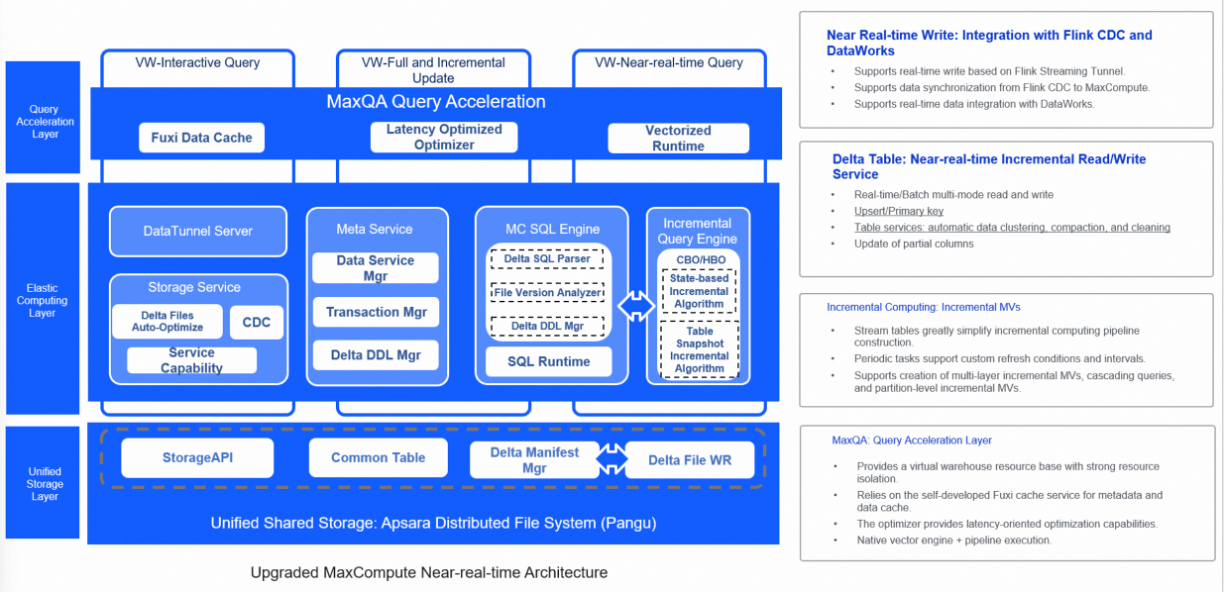
Gambar di atas menunjukkan arsitektur baru di mana MaxCompute secara efisien mendukung skenario bisnis komprehensif tersebut. Dalam arsitektur baru ini, MaxCompute mendukung berbagai sumber data sehingga Anda dapat dengan mudah mengimpor data inkremental dan data penuh ke sistem penyimpanan terpadu menggunakan alat akses khusus. Layanan manajemen data latar belakang secara otomatis mengoptimalkan struktur penyimpanan data. Mesin komputasi terpadu digunakan untuk mendukung pemrosesan data inkremental near real-time dan pemrosesan batch data berskala besar. Layanan metadata terpadu digunakan untuk mendukung manajemen transaksi dan manajemen metadata file. Arsitektur baru ini memberikan berbagai manfaat, termasuk mengatasi masalah yang muncul saat hanya menggunakan sistem pemrosesan batch—seperti komputasi dan penyimpanan redundan serta ketepatan waktu rendah—mencegah konsumsi sumber daya tinggi pada sistem pemrosesan data real-time atau sistem streaming, menghilangkan inkonsistensi data antara beberapa set sistem dalam arsitektur Lambda, serta mengurangi biaya penyimpanan redundan dari beberapa salinan data dan biaya migrasi data antar sistem.
Arsitektur terintegrasi end-to-end ini dapat memenuhi kebutuhan bisnis terkait optimasi komputasi dan penyimpanan untuk pemrosesan data inkremental serta ketepatan waktu tingkat menit, menjamin efisiensi keseluruhan pemrosesan batch, dan secara efektif mengurangi biaya sumber daya.
Fitur inti
Gudang data near real-time MaxCompute terutama menyediakan tiga fungsionalitas utama: MC Delta Table yang mendukung impor data tingkat menit, kemampuan komputasi inkremental yang lebih menyeimbangkan latensi dan throughput, serta MCQA2.0 yang baru ditingkatkan untuk menghadirkan respons kueri tingkat detik.
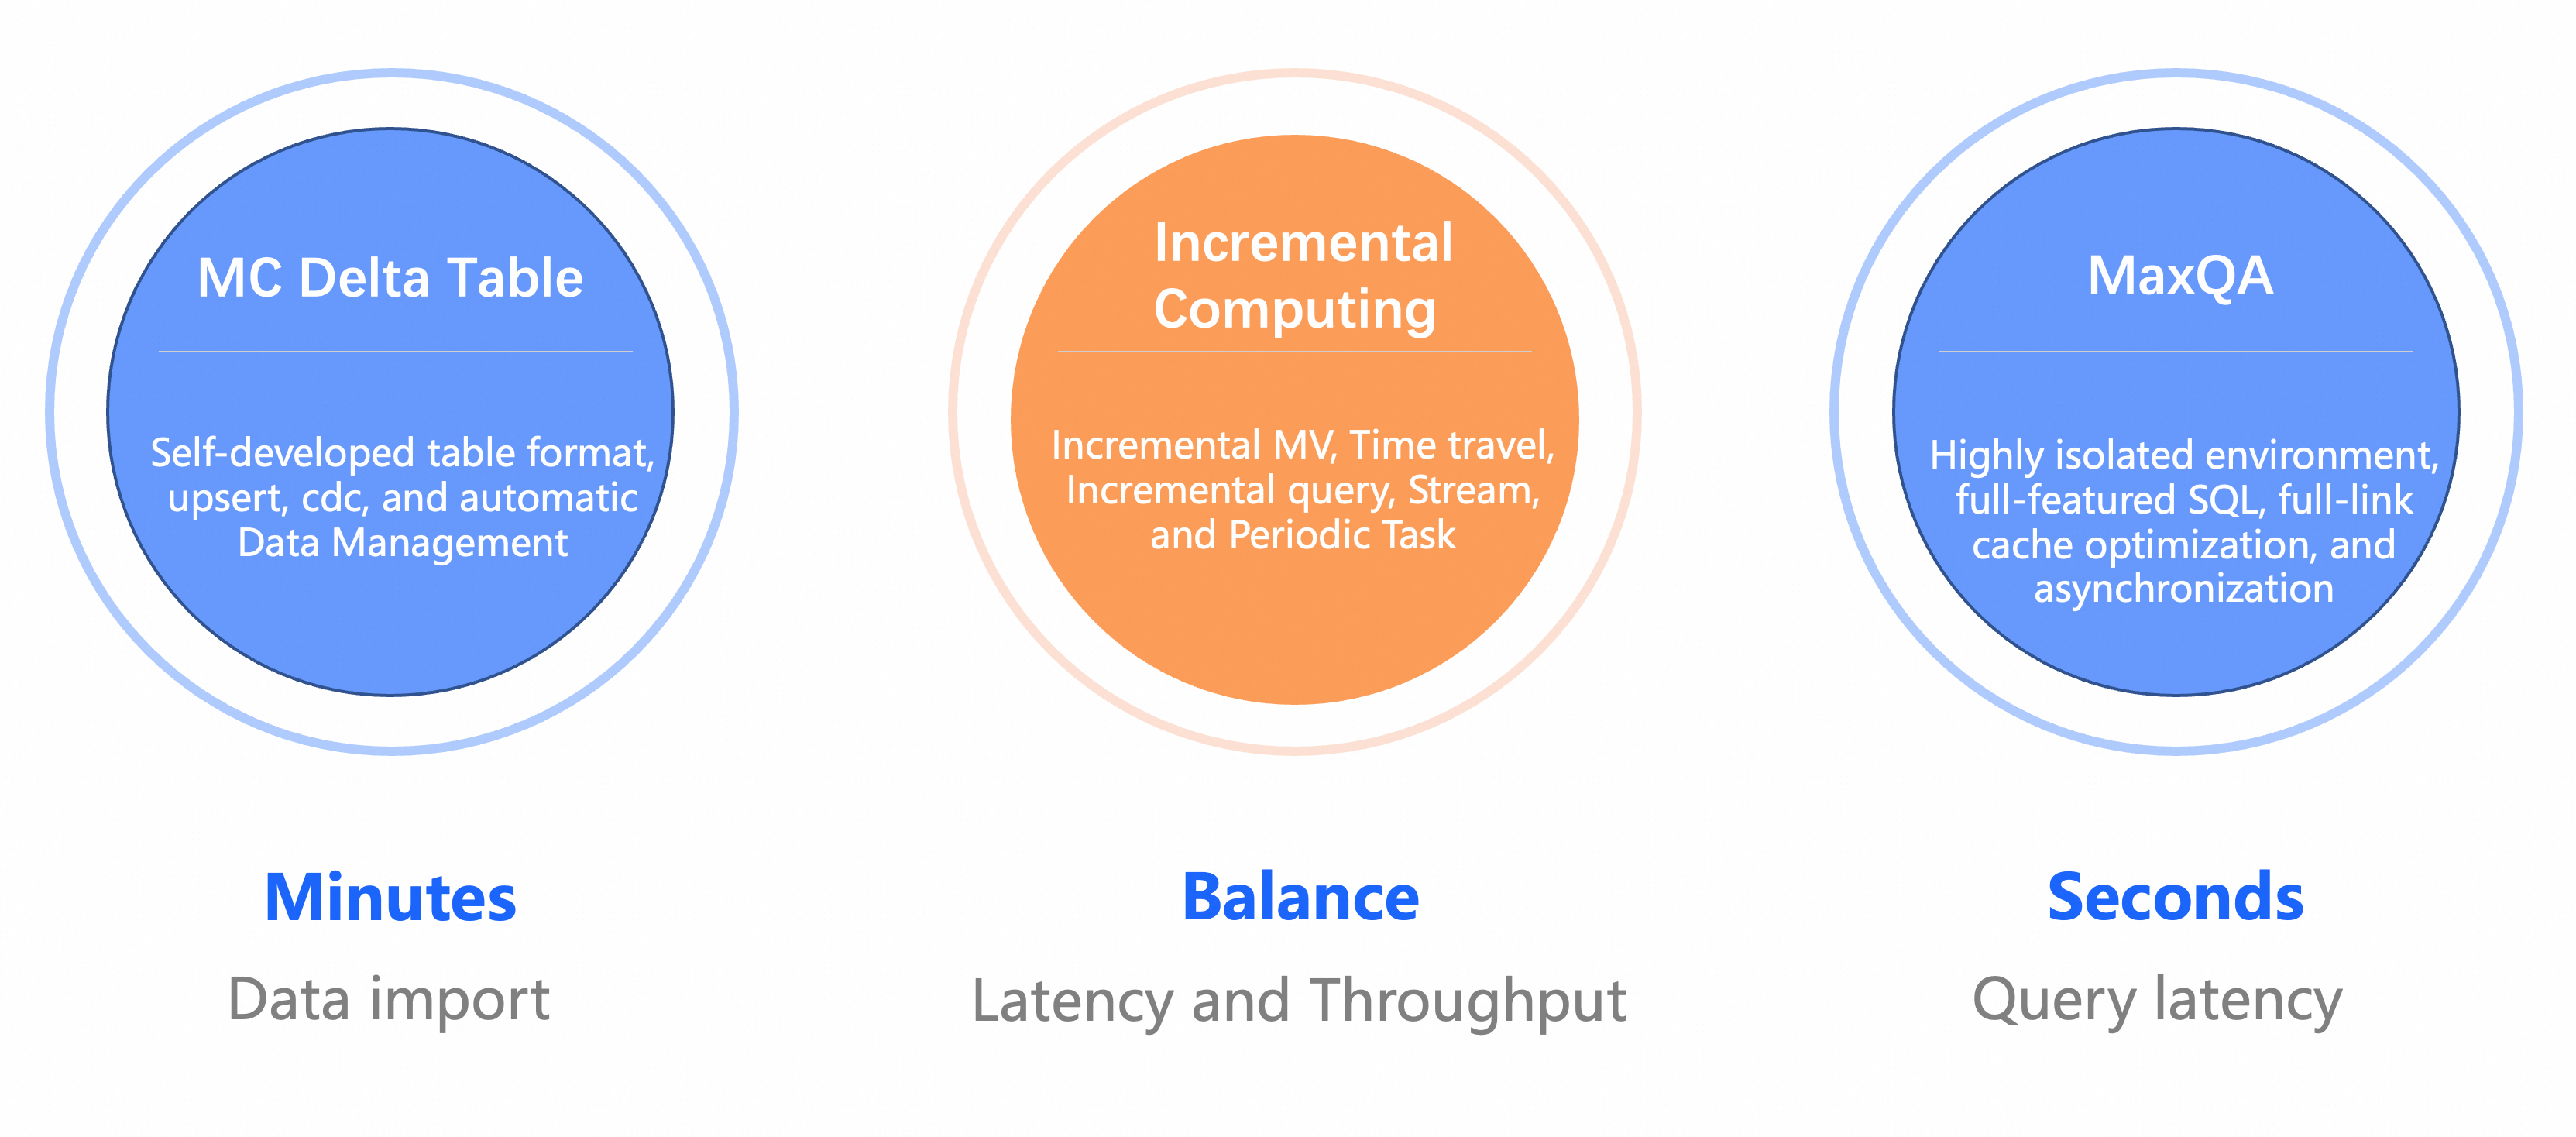
Ketiga fitur inti tersebut adalah sebagai berikut:
Format Delta Table: Mendukung impor data tingkat menit. Format tabel ini menggunakan AliORC sebagai format file dasar, mendukung semantik UPSERT, dan menyediakan metode CDC (Change Data Capture) standar untuk membaca dan menulis data inkremental. Format ini bergantung pada layanan penyimpanan MaxCompute dan layanan meta global untuk manajemen data otomatis.
Komputasi inkremental: Berdasarkan format Delta Table, MaxCompute telah menambahkan serangkaian kemampuan komputasi inkremental seperti materialized view inkremental, Time Travel, dan Stream Table. Selain itu, materialized view inkremental dan tugas terjadwal periodik menyediakan frekuensi pemicu yang berbeda, memberi pengguna lebih banyak opsi untuk menyeimbangkan latensi dan throughput.
Akselerasi kueri MCQA2.0: Ini merupakan peningkatan menyeluruh terhadap akselerasi kueri MaxCompute. Performa stabilitas ditingkatkan melalui lingkungan strongly fenced, serta dukungan MCQA 1.0 diperluas dari hanya kueri DQL SELECT menjadi fungsionalitas SQL lengkap, termasuk DDL dan DML. Performa lebih ditingkatkan lagi melalui metode cache end-to-end dan optimasi seperti pemrosesan asinkron multi-langkah dalam pipeline pengiriman pekerjaan.
Yang paling penting, kemampuan baru ini dibangun dan diimplementasikan berdasarkan mesin SQL MaxCompute yang asli. Pengguna MaxCompute dapat menganalisis data dalam jumlah besar dengan efisiensi biaya lebih tinggi tanpa mengubah kebiasaan pengembangan mereka.
Manfaat
Untuk mendukung skenario bisnis dan migrasi bisnis dari data lake open source Hudi dan Iceberg, arsitektur baru ini menyediakan fitur-fitur umum tertentu. Arsitektur baru yang dikembangkan sendiri ini juga memberikan manfaat berikut dalam hal fitur, performa, stabilitas, dan integrasi:
-
Menyediakan desain terpadu untuk penyimpanan, metadata, dan mesin komputasi guna mencapai integrasi mesin yang mendalam dan efisien. Arsitektur baru ini memberikan manfaat berikut: biaya penyimpanan rendah, manajemen file data yang efisien, dan efisiensi kueri tinggi. Selain itu, sejumlah besar aturan optimasi untuk kueri batch MaxCompute dapat digunakan kembali oleh kueri time travel dan kueri inkremental.
-
Menyediakan sintaks SQL terpadu lengkap untuk mendukung semua fitur arsitektur baru ini. Hal ini mempermudah operasi pengguna.
-
Menyediakan alat impor data yang dikustomisasi dan dioptimalkan secara mendalam untuk mendukung berbagai skenario bisnis kompleks.
-
Terpasang secara mulus dengan skenario bisnis MaxCompute yang sudah ada untuk mengurangi biaya migrasi, penyimpanan, dan komputasi.
-
Mendukung manajemen otomatis file data untuk menjamin stabilitas baca-tulis yang lebih baik serta mendukung optimasi otomatis terhadap efisiensi dan biaya penyimpanan.
-
Dikelola sepenuhnya di atas MaxCompute. Anda dapat langsung menggunakan arsitektur baru ini tanpa biaya akses tambahan. Cukup buat tabel Delta untuk menggunakan fitur-fitur arsitektur baru ini.
-
Merupakan arsitektur hasil pengembangan mandiri. Anda dapat mengelola pengembangan data sesuai kebutuhan bisnis berdasarkan arsitektur baru ini.