PyODPS adalah software development kit (SDK) MaxCompute untuk Python yang menyediakan antarmuka pemrograman sederhana untuk menulis pekerjaan MaxCompute, melakukan kueri terhadap tabel dan tampilan, serta mengelola resource menggunakan Python. PyODPS menawarkan fitur-fitur serupa dengan antarmuka baris perintah ODPS, seperti mengunggah dan mengunduh file, membuat tabel, serta menjalankan kueri SQL ODPS. SDK ini juga mencakup fitur lanjutan, seperti mengirimkan pekerjaan MapReduce dan menggunakan user-defined function (UDF) MaxCompute. Topik ini menjelaskan skenario penggunaan, tool yang didukung, serta pertimbangan penting dalam memanfaatkan PyODPS.
Pengenalan Fungsi
PyODPS digunakan dalam skenario berikut:
Tool yang Didukung
PyODPS dapat dijalankan di lingkungan lokal, DataWorks, dan PAI Notebook.
Terlepas dari tool yang Anda gunakan, hindari mengunduh seluruh data ke mesin lokal untuk menjalankan pekerjaan PyODPS. Pendekatan ini dapat mengonsumsi memori dalam jumlah besar dan menyebabkan error kehabisan memori (OOM). Sebagai gantinya, kirimkan pekerjaan ke MaxCompute untuk eksekusi terdistribusi. Untuk perbandingan lebih lanjut, lihat Catatan: Jangan unduh seluruh data ke mesin lokal dan jalankan PyODPS.
-
Lingkungan lokal: Anda dapat menginstal dan menggunakan PyODPS di lingkungan lokal. Untuk informasi selengkapnya, lihat Menggunakan PyODPS di lingkungan lokal.
-
DataWorks: PyODPS telah dipra-instal pada node PyODPS di DataWorks. Anda dapat langsung mengembangkan dan menjalankan pekerjaan PyODPS secara berkala di node tersebut. Untuk informasi selengkapnya, lihat Menggunakan PyODPS di DataWorks.
-
PAI Notebook: Anda dapat menginstal dan menjalankan PyODPS di lingkungan Python PAI. PyODPS telah dipra-instal dalam image PAI bawaan, seperti komponen Python kustom di PAI-Designer, dan siap digunakan. Penggunaan PyODPS di PAI Notebook mirip dengan penggunaan standarnya. Untuk informasi selengkapnya, lihat Ikhtisar operasi dasar dan DataFrame (tidak direkomendasikan).
Catatan: Jangan unduh seluruh data ke mesin lokal dan jalankan PyODPS
PyODPS adalah SDK yang berjalan di berbagai klien, termasuk PC, node PyODPS DataWorks di Data Studio, dan lingkungan PAI Notebook.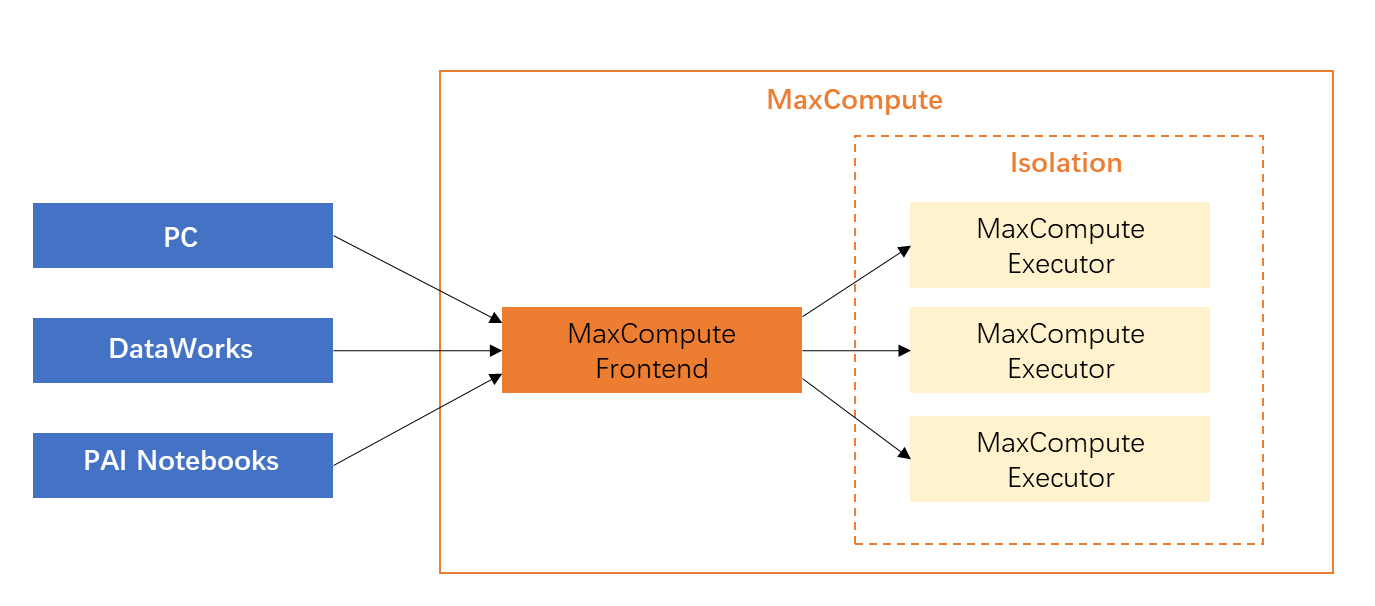 PyODPS menyediakan beberapa operasi praktis untuk menarik data ke mesin lokal, seperti operasi unduh saluran data (tunnel download), operasi execute, dan operasi to_pandas. Akibatnya, banyak pengguna baru mencoba menarik data secara lokal, memprosesnya, lalu mengunggahnya kembali ke MaxCompute. Namun, metode ini sering kali sangat tidak efisien karena mencegah pemanfaatan kemampuan komputasi paralel berskala besar dari MaxCompute.
|
Metode pemrosesan data |
Deskripsi |
Skenario contoh |
|
Menarik data ke mesin lokal untuk diproses (Tidak direkomendasikan. Dapat menyebabkan error OOM.) |
Misalnya, node PyODPS di DataWorks mencakup paket PyODPS bawaan dan lingkungan Python yang diperlukan. Node ini merupakan kontainer waktu proses klien dengan sumber daya terbatas. Node ini tidak menggunakan sumber daya komputasi MaxCompute dan memiliki batasan memori yang ketat. |
PyODPS menyediakan antarmuka |
|
Mengirimkan pekerjaan ke MaxCompute untuk eksekusi terdistribusi (Direkomendasikan) |
Gunakan fitur DataFrame terdistribusi PyODPS. Kirimkan komputasi utama ke MaxCompute untuk eksekusi terdistribusi, bukan mengunduh dan memproses data di node klien PyODPS. Inilah kunci penggunaan PyODPS yang benar. Catatan
Jika Anda ingin mengonversi hasil eksekusi SQL menjadi DataFrame, pertama-tama gunakan pernyataan
|
Gunakan antarmuka DataFrame PyODPS untuk pemrosesan data. Untuk tugas umum, seperti memproses setiap baris dan menuliskannya kembali ke tabel atau membagi satu baris menjadi beberapa baris, gunakan metode Antarmuka-antarmuka ini menerjemahkan kode Anda menjadi SQL untuk eksekusi terdistribusi di kluster komputasi MaxCompute. Hal ini hampir tidak mengonsumsi memori lokal dan meningkatkan performa secara signifikan dibandingkan komputasi mesin tunggal. |
Contoh tokenisasi berikut membandingkan kode untuk kedua metode tersebut.
-
Skenario contoh
Anda perlu mengekstraksi informasi dengan menganalisis string log harian. Anda memiliki tabel yang berisi satu kolom bertipe string. Anda harus menggunakan library jieba untuk melakukan tokenisasi teks Tionghoa, menemukan kata kunci yang diinginkan, lalu menyimpan kata kunci tersebut ke tabel informasi.
-
Demo kode pemrosesan tidak efisien
import jieba
t = o.get_table('word_split')
out = []
with t.open_reader() as reader:
    for r in reader:
        words = list(jieba.cut(r[0]))
        #
        # Logika pemrosesan untuk menghasilkan processed_data
        #
        out.append(processed_data)
out_t = o.get_table('words')
with out_t.open_writer() as writer:
    writer.write(out)
Pendekatan ini mengikuti pola pemrosesan mesin tunggal: membaca data baris demi baris, memprosesnya baris demi baris, lalu menuliskannya ke tabel tujuan baris demi baris. Seluruh proses ini menghabiskan banyak waktu untuk unduhan dan unggahan data. Mesin yang menjalankan skrip ini juga memerlukan memori dalam jumlah besar untuk memproses seluruh data. Bagi pengguna node DataWorks, pendekatan ini dapat dengan mudah menyebabkan error OOM karena melebihi alokasi memori default.
-
Demo kode pemrosesan efisien
from odps.df import output
out_table = o.get_table('words')
df = o.get_table('word_split').to_df()

# Asumsikan bidang dan tipe berikut perlu dikembalikan
out_names = ["word", "count"]
out_types = ["string", "int"]

@output(out_names, out_types)
def handle(row):
    import jieba
    words = list(jieba.cut(row[0]))
    #
    # Logika pemrosesan untuk menghasilkan processed_data
    #
    yield processed_data
df.apply(handle, axis=1).persist(out_table.name)
Gunakan metode apply untuk eksekusi terdistribusi:
-
Logika kompleks ditempatkan dalam fungsi handle. Fungsi ini secara otomatis diserialisasi ke sisi server untuk digunakan sebagai UDF, tempat fungsi tersebut dipanggil dan dieksekusi. Karena fungsi handle juga memproses data baris demi baris selama eksekusi di sisi server, logikanya identik. Perbedaannya adalah ketika program ini dikirimkan ke MaxCompute untuk dieksekusi, beberapa mesin memproses data secara simultan. Hal ini menghemat banyak waktu.
-
Memanggil antarmuka persist menuliskan data yang dihasilkan langsung ke tabel MaxCompute lain. Seluruh proses pembuatan dan konsumsi data terjadi di dalam kluster MaxCompute. Hal ini menghemat sumber daya jaringan dan memori lokal.
-
Contoh ini juga menggunakan paket pihak ketiga. MaxCompute mendukung paket pihak ketiga, seperti
jiebadalam contoh ini, dalam UDF. Oleh karena itu, Anda tidak perlu khawatir tentang biaya perubahan kode. Anda dapat memanfaatkan kemampuan komputasi skala besar MaxCompute dengan hampir tanpa perubahan pada logika utama Anda.
-
Batasan
-
Karena adanya pembatasan sandbox, beberapa program yang Anda debug secara lokal menggunakan backend komputasi pandas tidak dapat di-debug di MaxCompute.