Topik ini menjelaskan cara membuat, membaca dari, dan menulis ke tabel eksternal Parquet di Object Storage Service (OSS).
Lingkup
Tabel eksternal OSS tidak mendukung properti cluster.
Ukuran file tunggal tidak boleh melebihi 2 GB. File yang lebih besar dari 2 GB harus dibagi.
MaxCompute dan OSS harus berada di wilayah yang sama.
Deskripsi izin
Saat mengakses tabel eksternal OSS, data diakses melalui role yang ditentukan dalam parameter
odps.properties.rolearn, terlepas dari apakah Anda menggunakan Akun Alibaba Cloud, Pengguna RAM, atau Peran RAM. Oleh karena itu, Anda harus membuat Peran RAM dan memberikan izin untuk mengakses bucket OSS target, lalu mengonfigurasi ARN role tersebut dalam parameterodps.properties.rolearn. Untuk informasi selengkapnya, lihat Parameter.Anda dapat mengotorisasi akses dalam akun yang sama atau akses lintas akun sesuai kebutuhan bisnis Anda. Kami merekomendasikan penggunaan kebijakan otorisasi kustom untuk kontrol akses detail halus. Untuk informasi selengkapnya, lihat Otorisasi untuk sumber data eksternal.
Buat tabel eksternal
Sintaks
Saat skema file Parquet berbeda dengan skema tabel eksternal:
Ketidaksesuaian jumlah kolom: Jika file Parquet memiliki lebih sedikit kolom daripada yang didefinisikan dalam DDL tabel eksternal, kolom yang hilang mengembalikan NULL. Jika file memiliki lebih banyak kolom, kolom tambahan diabaikan.
Ketidaksesuaian tipe kolom: Jika tipe kolom dalam file Parquet tidak sesuai dengan tipe yang sesuai dalam DDL, operasi baca gagal. Misalnya, error seperti
ODPS-0123131:User defined function exception - Traceback:xxxdilaporkan jika Anda mencoba membaca kolom INT sebagai bidang STRING.
Sintaks sederhana
CREATE EXTERNAL TABLE [IF NOT EXISTS] <mc_oss_extable_name>
(
  <col_name> <data_type>,
  ...
)
[COMMENT <table_comment>]
[PARTITIONED BY (<col_name> <data_type>, ...)]
STORED AS parquet
LOCATION '<oss_location>'
[tblproperties ('<tbproperty_name>'='<tbproperty_value>',...)];
Sintaks lengkap
CREATE EXTERNAL TABLE [IF NOT EXISTS] <mc_oss_extable_name>
(
  <col_name> <data_type>,
  ...
)
[COMMENT <table_comment>]
[PARTITIONED BY (<col_name> <data_type>, ...)]
ROW FORMAT SERDE 'org.apache.hadoop.hive.ql.io.parquet.serde.ParquetHiveSerDe'
WITH serdeproperties(
    'odps.properties.rolearn'='acs:ram::<uid>:role/<role_name>',
    'mcfed.parquet.compression'='ZSTD/SNAPPY/GZIP'
)
STORED AS parquet
LOCATION '<oss_location>'
;
Parameter umum
Untuk informasi selengkapnya tentang parameter umum, lihat Parameter sintaks dasar.
Parameter unik
Parameter with serdeproperties
property_name | Kapan digunakan | Deskripsi | property_value | Default |
mcfed.parquet.compression | Tambahkan properti ini untuk menulis data Parquet ke OSS dalam format terkompresi. | Properti kompresi Parquet. Data Parquet tidak dikompresi secara default. |
| None |
mcfed.parquet.compression.codec.zstd.level | Tambahkan properti ini saat | Tingkat yang lebih tinggi meningkatkan rasio kompresi. Namun, pengujian menunjukkan bahwa tingkat tinggi memberikan keuntungan minimal dalam pengurangan ukuran data sementara secara signifikan meningkatkan waktu dan konsumsi resource. Untuk skenario data besar, tingkat ZSTD rendah (3 hingga 5) memberikan keseimbangan terbaik antara performa dan kompresi. Contoh: | Nilainya dapat berkisar dari 1 hingga 22. | 3 |
parquet.file.cache.size | Tambahkan properti ini untuk meningkatkan performa membaca file data OSS saat memproses data Parquet. | Menentukan jumlah data yang dapat di-cache saat membaca file data OSS. Satuan: KB. | 1024 | None |
parquet.io.buffer.size | Tambahkan properti ini untuk meningkatkan performa membaca file data OSS saat memproses data Parquet. | Menentukan jumlah data yang dapat di-cache saat ukuran file data OSS melebihi 1024 KB. Satuan: KB. | 4096 | None |
Parameter tblproperties
property_name | Kapan digunakan | Deskripsi | property_value | Default |
io.compression.codecs | Tambahkan properti ini jika file data OSS Anda dalam format Raw-Snappy. | Mengaktifkan parser open source bawaan untuk format SNAPPY. Jika Anda mengatur parameter ini ke True, MaxCompute dapat membaca data terkompresi. Jika tidak, operasi baca gagal. | com.aliyun.odps.io.compress.SnappyRawCodec. | None |
odps.external.data.output.prefix (Kompatibel dengan odps.external.data.prefix) | Tambahkan properti ini untuk menentukan awalan kustom untuk file output. |
| Kombinasi karakter yang valid, seperti 'mc_'. | None |
odps.external.data.enable.extension | Tambahkan properti ini untuk menampilkan ekstensi file output. | Atur ke True untuk menampilkan ekstensi file. Jika tidak, ekstensi disembunyikan. |
| False |
odps.external.data.output.suffix | Tambahkan properti ini untuk menentukan akhiran kustom untuk file output. | Hanya boleh berisi huruf, angka, dan garis bawah (a-z, A-Z, 0-9, _). | Kombinasi karakter yang valid, seperti '_hangzhou'. | None |
odps.external.data.output.explicit.extension | Tambahkan properti ini untuk menentukan ekstensi kustom untuk file output. |
| Kombinasi karakter yang valid, seperti "jsonl". | None |
odps.ext.column.mapping | Tambahkan properti ini saat nama bidang dalam file data OSS mengandung karakter khusus. | Properti ini mendefinisikan pemetaan nama kolom kustom. Misalnya, jika bidang file OSS adalah id BIGINT, $_test DOUBLE, dan =name STRING, atur nilai parameter menjadi t_test:$_test,t_name:=_name saat membuat tabel eksternal. Anda hanya perlu menentukan pemetaan untuk bidang yang mengandung karakter khusus. | Tidak ada nilai tetap | None |
odps.ext.column.mapping.delimiters (Gunakan hanya ketika karakter dalam nama kolom bertentangan dengan delimiter default dalam pemetaan nama kolom. Umumnya tidak direkomendasikan.) | Tambahkan properti ini saat nama kolom mengandung karakter khusus | Properti ini menyesuaikan delimiter intra-grup dan antar-grup untuk pasangan kunci-nilai. Nilainya harus berisi tepat dua karakter: karakter pertama berfungsi sebagai delimiter kunci-nilai, dan karakter kedua berfungsi sebagai delimiter antara pasangan kunci-nilai yang berbeda. | Tidak ada nilai tetap. Contoh: | Nilai default:
|
mcfed.parquet.compression | Tambahkan properti ini untuk menulis data Parquet ke OSS dalam format terkompresi. Tidak diperlukan parameter tambahan untuk membaca file terkompresi. | Properti kompresi Parquet. Data Parquet tidak dikompresi secara default. |
| None |
mcfed.parquet.block.size | Mengontrol ukuran blok file Parquet, yang memengaruhi efisiensi penyimpanan dan performa baca. | Properti tuning Parquet. Menentukan ukuran blok Parquet dalam byte. | Bilangan bulat non-negatif | 134217728 (128 MB) |
mcfed.parquet.block.row.count.limit | Saat menulis data ke tabel eksternal Parquet, membatasi jumlah record dalam setiap grup baris untuk mencegah error kehabisan memori (OOM). | Properti tuning Parquet. Mengontrol jumlah maksimum record per grup baris. Jika terjadi error OOM, kurangi nilai parameter ini. Saran:
| Bilangan bulat non-negatif | 2147483647 (Integer.MAX_VALUE) |
mcfed.parquet.page.size.row.check.min | Saat menulis data ke tabel eksternal Parquet, mengontrol frekuensi pemeriksaan memori untuk mencegah error OOM. | Properti tuning Parquet. Membatasi jumlah minimum record antara pemeriksaan memori. Jika terjadi error OOM, kurangi nilai parameter ini. | Bilangan bulat non-negatif | 100 |
mcfed.parquet.page.size.row.check.max | Saat menulis data ke tabel eksternal Parquet, mengontrol frekuensi pemeriksaan memori untuk mencegah error OOM. | Properti tuning Parquet. Membatasi jumlah minimum record antara pemeriksaan memori. Jika terjadi error OOM, kurangi nilai parameter ini. Karena pemeriksaan memori yang sering menambah overhead, menyesuaikan parameter ini dapat memengaruhi performa. Saran parameter:
| Bilangan bulat non-negatif | 1000 |
mcfed.parquet.compression.codec.zstd.level | Tambahkan properti ini untuk menentukan tingkat kompresi algoritma ZSTD saat menulis data Parquet ke OSS dengan kompresi ZSTD. | Properti kompresi Parquet. Menentukan tingkat kompresi algoritma ZSTD. Nilainya dapat berkisar dari 1 hingga 22. | Bilangan bulat non-negatif | 3 |
Daftar putih dan blacklist
Tabel eksternal OSS MaxCompute mendukung penyaringan daftar putih dan blacklist. Dengan mengatur parameter daftar putih dan blacklist dalam tblproperties, Anda dapat menyaring file mana yang akan dibaca dari direktori. Untuk detailnya, lihat Daftar putih dan blacklist.
Menulis data
Untuk detail tentang sintaks penulisan di MaxCompute, lihat Sintaks penulisan.
Kueri dan analisis
Lihat Sintaks kueri untuk detail tentang sintaks SELECT.
Lihat Optimasi kueri untuk detail tentang mengoptimalkan rencana kueri.
Untuk informasi selengkapnya tentang membaca file LOCATION secara langsung, lihat Kueri tanpa skema.
Optimasi kueri: Tabel eksternal Parquet mendukung optimasi kueri dengan mengaktifkan Predicate Push Down (PPD). Untuk hasil performa, lihat Dukungan Predicate Push Down (Parquet PPD).
Tambahkan parameter berikut sebelum pernyataan SQL Anda untuk mengaktifkan PPD:
-- Parameter PPD harus digunakan dalam mode Native, artinya switch Native harus diatur ke true.
-- Aktifkan pembaca native Parquet.
SET odps.ext.parquet.native = true;
-- Aktifkan Parquet PPD.
SET odps.sql.parquet.use.predicate.pushdown = true;
Dukungan Predicate Push Down (Parquet PPD)
Secara default, tabel eksternal Parquet tidak mendukung Predicate Push Down (PPD). Saat Anda menjalankan kueri dengan kondisi filter WHERE, MaxCompute memindai semua data. Hal ini menyebabkan I/O yang tidak perlu, konsumsi resource, dan latensi kueri. Untuk mengatasi masalah ini, Anda dapat mengaktifkan PPD menggunakan parameter. Fitur ini menggunakan metadata dalam file Parquet untuk menyaring data pada tingkat grup baris selama fase pemindaian, yang meningkatkan performa kueri serta mengurangi konsumsi resource dan biaya.
Penggunaan
Aktifkan Predicate Push Down (PPD)
Sebelum menjalankan kueri SQL, gunakan perintah
setuntuk mengatur dua parameter tingkat sesi berikut guna mengaktifkan Parquet PPD.-- Aktifkan pembaca native Parquet. set odps.ext.parquet.native = true; -- Aktifkan Parquet PPD. set odps.sql.parquet.use.predicate.pushdown = true;Contoh
Contoh ini menggunakan set data uji TPC-DS 1 TB dan tabel eksternal Parquet
tpcds_1t_store_sales. Dalam contoh ini, PPD diaktifkan dan kueri filter dijalankan. Volume data total adalah2.879.987.999baris.-- Buat tabel eksternal tpcds_1t_store_sales. CREATE EXTERNAL TABLE IF NOT EXISTS tpcds_1t_store_sales ( ss_sold_date_sk BIGINT, ss_sold_time_sk BIGINT, ss_item_sk BIGINT, ss_customer_sk BIGINT, ss_cdemo_sk BIGINT, ss_hdemo_sk BIGINT, ss_addr_sk BIGINT, ss_store_sk BIGINT, ss_promo_sk BIGINT, ss_ticket_number BIGINT, ss_quantity BIGINT, ss_wholesale_cost DECIMAL(7,2), ss_list_price DECIMAL(7,2), ss_sales_price DECIMAL(7,2), ss_ext_discount_amt DECIMAL(7,2), ss_ext_sales_price DECIMAL(7,2), ss_ext_wholesale_cost DECIMAL(7,2), ss_ext_list_price DECIMAL(7,2), ss_ext_tax DECIMAL(7,2), ss_coupon_amt DECIMAL(7,2), ss_net_paid DECIMAL(7,2), ss_net_paid_inc_tax DECIMAL(7,2), ss_net_profit DECIMAL(7,2) ) ROW FORMAT SERDE 'org.apache.hadoop.hive.ql.io.parquet.serde.ParquetHiveSerDe' WITH serdeproperties( 'odps.properties.rolearn'='acs:ram::<uid>:role/<role_name>', 'mcfed.parquet.compression'='zstd' ) STORED AS parquet LOCATION 'oss://oss-cn-hangzhou-internal.aliyuncs.com/oss_bucket_path/'; -- Gunakan set data uji TPC-DS 1 TB. INSERT OVERWRITE TABLE tpcds_1t_store_sales SELECT ss_sold_date_sk, ss_sold_time_sk, ss_item_sk, ss_customer_sk, ss_cdemo_sk, ss_hdemo_sk, ss_addr_sk, ss_store_sk, ss_promo_sk, ss_ticket_number, ss_quantity, ss_wholesale_cost, ss_list_price, ss_sales_price, ss_ext_discount_amt, ss_ext_sales_price, ss_ext_wholesale_cost, ss_ext_list_price, ss_ext_tax, ss_coupon_amt, ss_net_paid, ss_net_paid_inc_tax, ss_net_profit FROM bigdata_public_dataset.tpcds_1t.store_sales; -- Jalankan kueri. SELECT SUM(ss_sold_date_sk) FROM tpcds_1t_store_sales WHERE ss_sold_date_sk >= 2451871 AND ss_sold_date_sk <= 2451880;
Perbandingan performa
Mengaktifkan PPD mengurangi jumlah data yang dipindai, sehingga menurunkan latensi kueri dan konsumsi resource.
Mode | Total baris dalam tabel | Baris yang dipindai | Byte yang dipindai | Waktu mapper | Total konsumsi resource | Deskripsi |
Tabel eksternal Parquet tanpa PPD | 2.879.987.999 | 2.879.987.999 (100%) | 19386793984 (100%) | 18s | CPU 19,25 Core-menit, Memori 24,07 GB-menit 100% | |
Tabel eksternal Parquet dengan PPD | 2.879.987.999 | 762.366.649 (26,47%) | 3.339.386.880 (17,22%) | 12s | cpu 11,47 Core × Min, memory 14,33 GB × Min ~59,58% | Pemindaian data yang berkurang secara signifikan menurunkan latensi dan konsumsi resource. |
Tabel internal dengan PPD | 2.879.987.999 | 32.830.000 (1,14%) | 1.633.880.386 (8,43%) | 9s | cpu 5,62 Core × Min, memory 7,02 GB × Min ~29,19% | PPD lebih efektif pada tabel internal karena datanya diurutkan. |
Detail pengujian
Tabel eksternal Parquet tanpa PPD
SET odps.ext.parquet.native = true;
SET odps.sql.parquet.use.predicate.pushdown = false;
SELECT SUM(ss_sold_date_sk) FROM tpcds_1t_store_sales
  WHERE ss_store_sk = 2 AND ss_sold_date_sk >= 2451871 AND ss_sold_date_sk <= 2451880;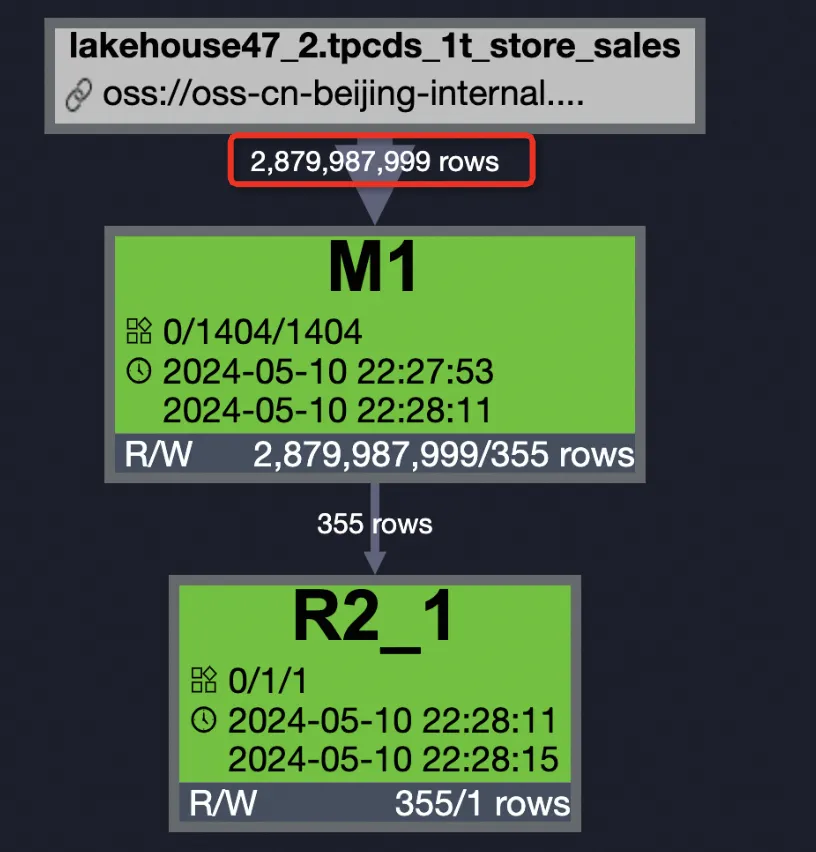
Hasil menunjukkan bahwa untuk tugas M1 dalam Fuxi Jobs, IO Records Input adalah 2,9 G, IO Bytes Input adalah 18,06 GB, dan Latency adalah 00:00:18,000.
Tab Summary hasil eksekusi menunjukkan bahwa konsumsi resource adalah cpu
19,25 Core × Mindan memori24,07 GB × Min. Waktu proses job adalah23,000detik, dan mode proses adalahfuxi job 2.0. Tugas M1 memiliki 1.404 instans, waktu proses18,000detik, 2.879.987.999 record input, dan 355 record output. Tugas R2_1 memiliki 1 instans, waktu proses4,000detik, dan 1 record output.Tabel eksternal Parquet dengan PPD
SET odps.ext.parquet.native = true;
SET odps.sql.parquet.use.predicate.pushdown = true;
SELECT SUM(ss_sold_date_sk) FROM tpcds_1t_store_sales
  WHERE ss_store_sk = 2 AND ss_sold_date_sk >= 2451871 AND ss_sold_date_sk <= 2451880;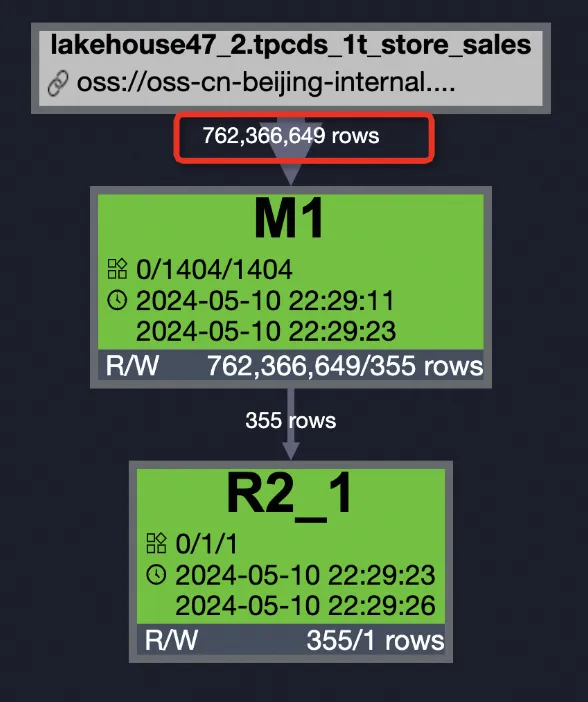
Setelah menjalankan kueri ini, ringkasan job menunjukkan bahwa konsumsi resource adalah
cpu 11,47 Core × Min, memory 14,33 GB × Min, dengan total waktu proses 15 detik. Tahap M1 memiliki 1.404 instans, waktu proses 12 detik, dan 762.366.649 record input (sekitar 3.339.386.880 byte). Tahap R2_1 memiliki 1 instans dan waktu proses 3 detik.Banyak mapper kosong dan tidak perlu membaca data:
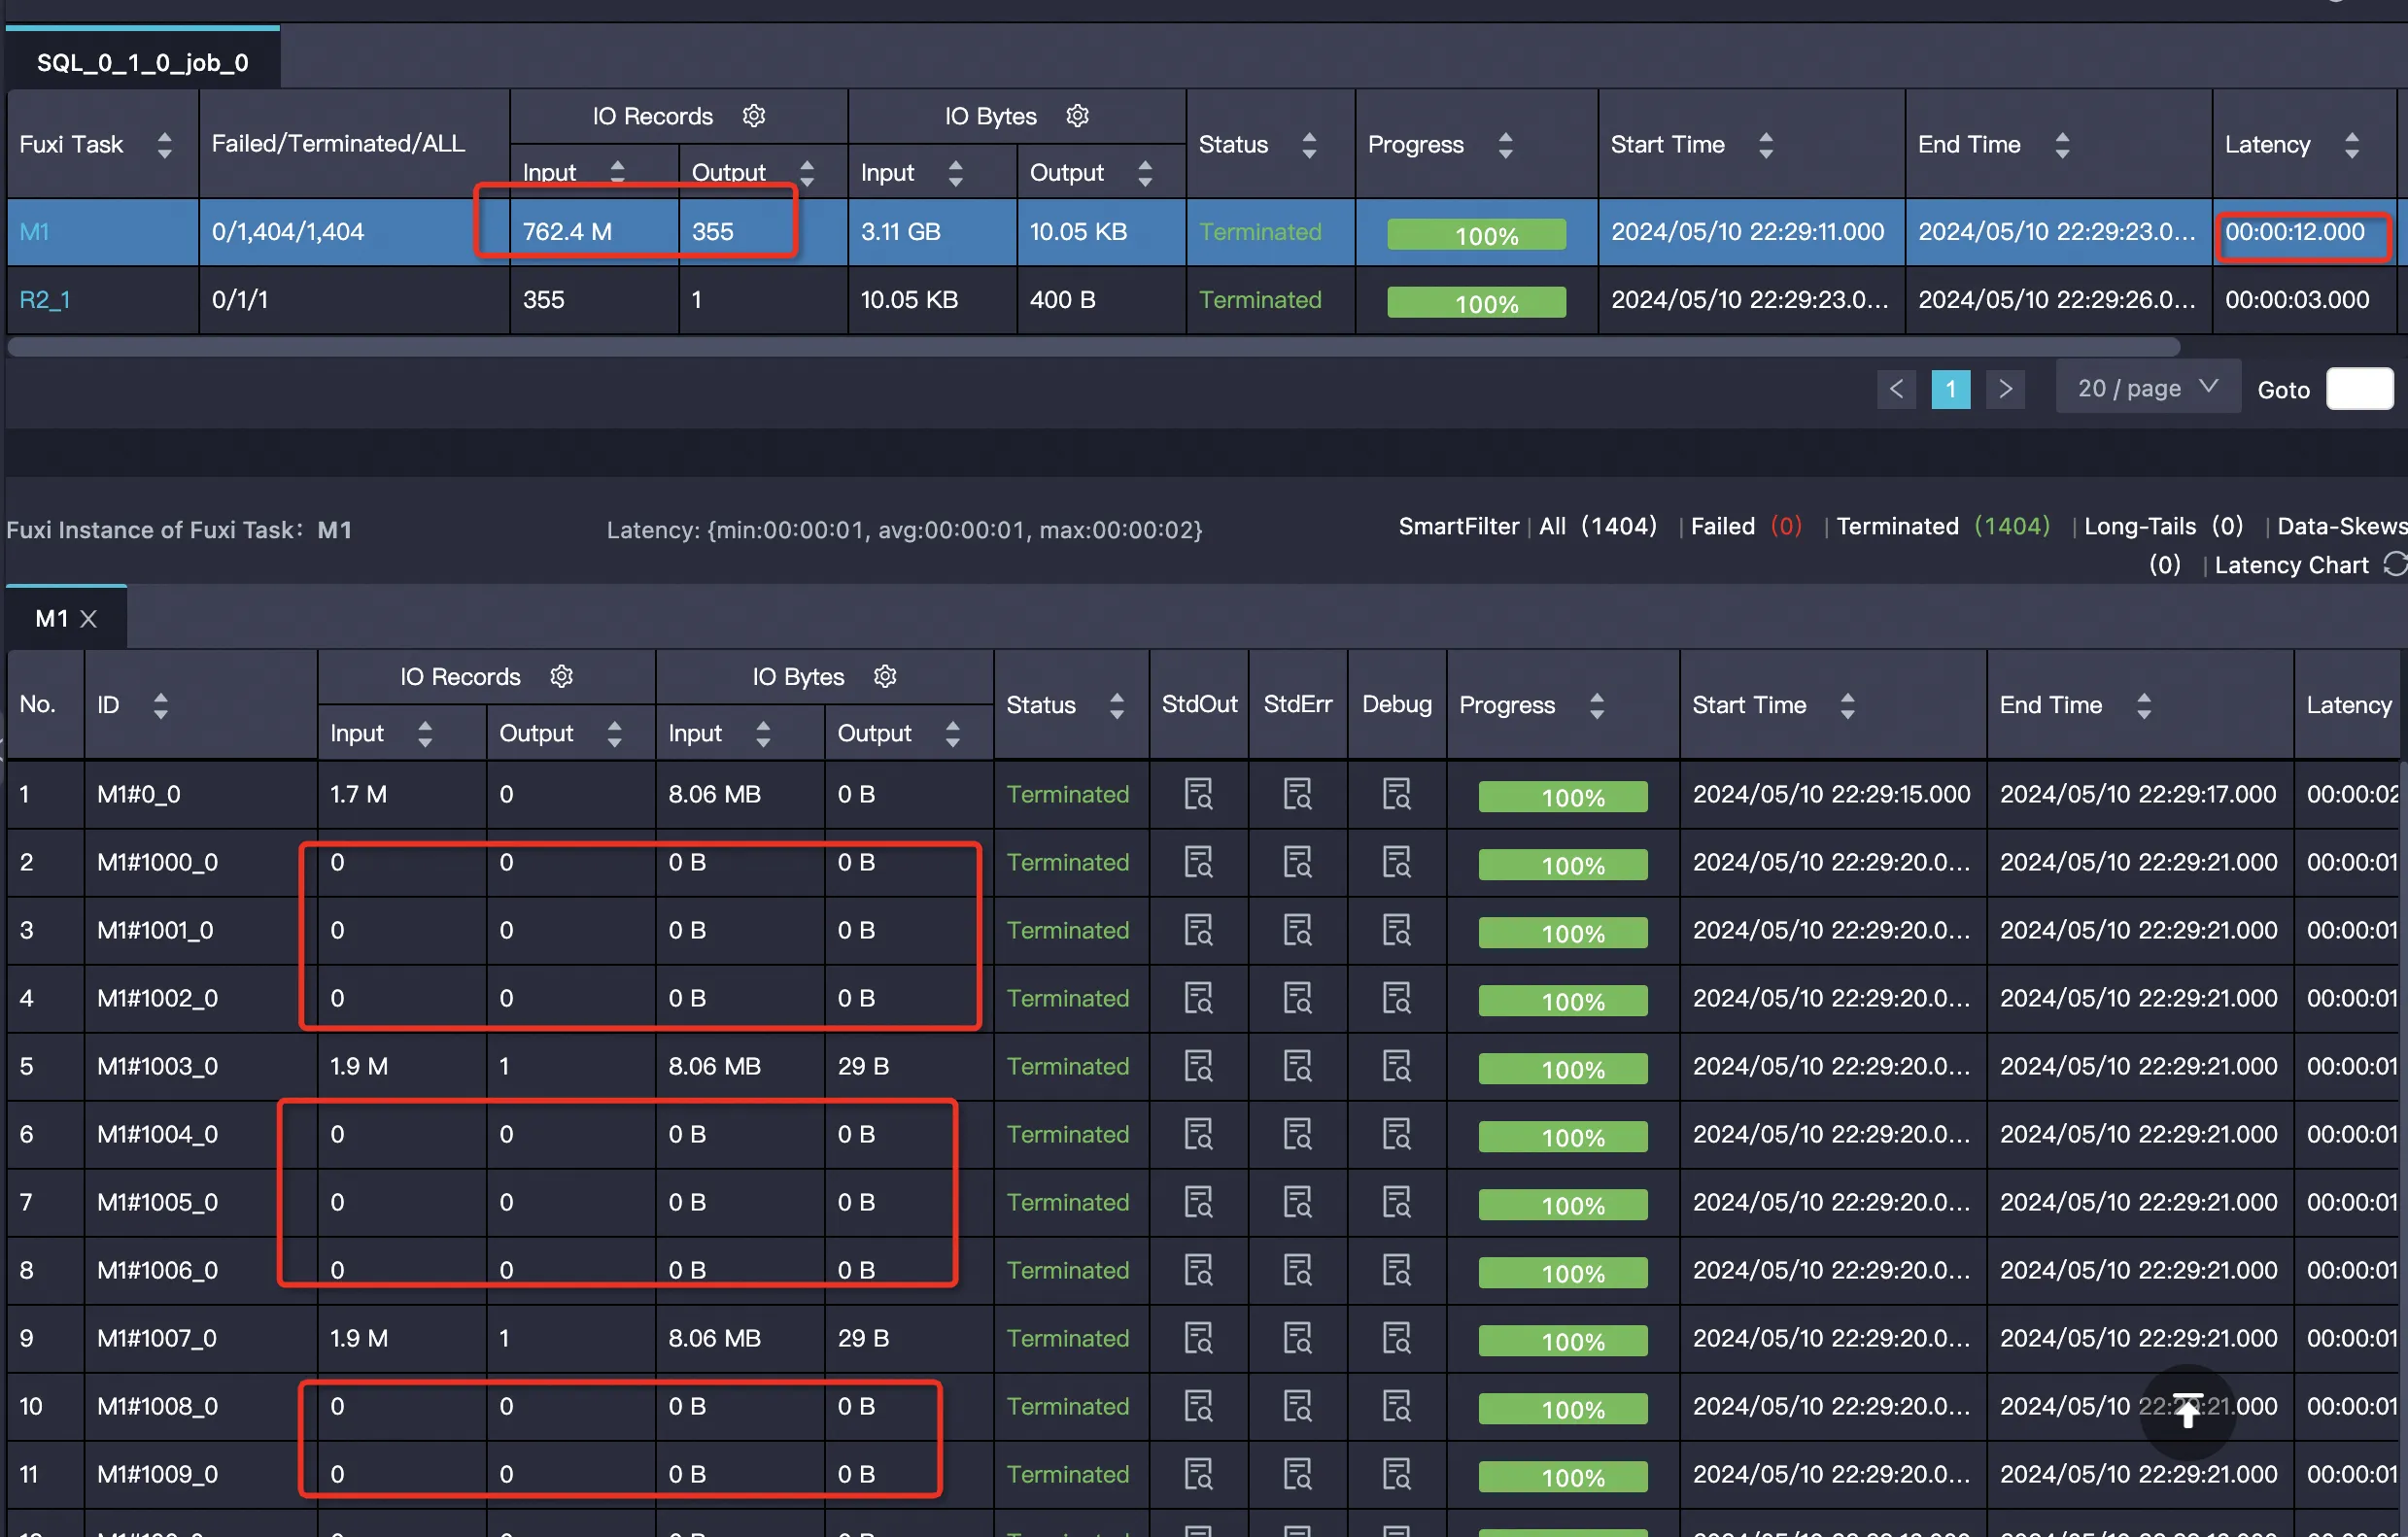
Log pemangkasan grup baris aktual:
[2024-05-10 22:29:22.692182]    [INFO]   [239551]    [/home/admin/odps_build/workspace/IRDS_CMK_7u/jenkins-IRDS_CMK_7u-70
16/common/table/file_formats/parquet/parquet_row_group_pruner.cpp:100]    The expression to prune row groups:(((ss_store_s
k == 2:int64) and (ss_sold_date_sk >= 2451871:int64)) and (ss_sold_date_sk <= 2451880:int64))
[2024-05-10 22:29:22.705508]    [INFO]   [239551]    [/home/admin/odps_build/workspace/IRDS_CMK_7u/jenkins-IRDS_CMK_7u-70
16/common/table/file_formats/parquet/parquet_reader_factory.cpp:136]    Parquet row group pruning is enabled, millisecon
ds elapsed:13    Total row group count:1 Pruned row group count:1    The first several row group indexes:
[2024-05-10 22:29:22.705532]    [INFO]   [239551]    [/home/admin/odps_build/workspace/IRDS_CMK_7u/jenkins-IRDS_CMK_7u-70
16/common/table/file_formats/parquet/parquet_reader_factory.cpp:60]  total feasible parquet row group count:0]
Tabel internal dengan PPD
Efek pemangkasan lebih signifikan karena data dalam tabel internal diurutkan.
SELECT SUM(ss_sold_date_sk) FROM bigdata_public_dataset.tpcds_1t.store_sales
  WHERE ss_store_sk = 2 AND ss_sold_date_sk >= 2451871 AND ss_sold_date_sk <= 2451880;
Setelah menjalankan kueri ini, DAG job menunjukkan bahwa jumlah total baris dalam sumber data adalah 2.879.987.999, tetapi jumlah baris yang benar-benar dipindai hanya 32.830.000. Tahap M1 (703 instans) membaca 32.830.000 baris dan menghasilkan 323 baris. Tahap R2_1 menerima 323 baris dan menghasilkan 1 baris. Hal ini menunjukkan bahwa efek pemangkasan sangat signifikan saat PPD diaktifkan untuk tabel internal dengan data terurut.
Pemantauan Fuxi Jobs menunjukkan bahwa job
SQL_0_1_0_job_0selesai. Job ini mencakup dua Tugas Fuxi, M1 dan R2_1, keduanya dengan status Terminated. M1 memiliki 703 instans, input 32,8 juta record (1,52 GB), output 323 record, dan latensi 00:00:09,375. R2_1 memiliki 1 instans, input 323 record, output 1 record, dan latensi 00:00:03,873. Detail instans M1 menunjukkan 4 instans Data-Skew. Instans sepertiM1#101_0,M1#103_0, danM1#105_0memiliki 0 untuk Input dan Output. Hal ini menunjukkan bahwa instans tersebut adalah instans dry-run dan kueri ini memiliki masalah kesenjangan data.resource cost: cpu 5,62 Core * Min, memory 7,02 GB * Min inputs: lakehouse47_2.default.tpcds_1t_store_sales2: 32830000 (1633880386 bytes) outputs: Job run time: 14,000 Job run mode: fuxi job 2.0 Job run engine: execution engine M1: instance count: 703 run time: 9,000 instance time: min: 0,000, max: 2,000, avg: 0,000 input records: TableScan1: 32830000 (min: 0, max: 210000, avg: 46699) output records: StreamLineWrite1: 323 (min: 0, max: 1, avg: 0) metrics_output_count: Calc1: 58025 (min: 0, max: 461, avg: 82) HashAgg1: 323 (min: 0, max: 1, avg: 0) StreamLineWrite1: 323 (min: 0, max: 1, avg: 0) TableScan1: 32830000 (min: 0, max: 210000, avg: 46699) metrics_inner_time_ms: Calc1: 4 (min: 0, max: 2, avg: 0) MaxInstance: 21 GlobalInit: 57752 (min: 60, max: 386, avg: 82) MaxInstance: 17 HashAgg1: 0 (min: 0, max: 0, avg: 0) MaxInstance: 2 StreamLineWrite1: 20469 (min: 5, max: 899, avg: 29) MaxInstance: 400 TableScan1: 131977 (min: 51, max: 1417, avg: 187) MaxInstance: 301 R2_1: instance count: 1 run time: 4,000 instance time: min: 0,000, max: 0,000, avg: 0,000 input records: StreamLineRead1: 323 (min: 323, max: 323, avg: 323) output records: AdhocSink1: 1 (min: 1, max: 1, avg: 1) metrics_output_count: AdhocSink1: 1 (min: 1, max: 1, avg: 1)
Perbandingan performa Parquet dan ZSTD
Bagian berikut membandingkan performa format kompresi yang berbeda untuk tabel eksternal Parquet.
Catatan: Hasil pengujian hanya sebagai referensi. Performa dapat bervariasi berdasarkan skenario bisnis. Kami merekomendasikan Anda melakukan pengujian dan evaluasi lebih lanjut untuk kasus penggunaan spesifik Anda.
Performa kueri
Set data: TPC-DS 1 TB
Resource: 900+ CU
Metode pengujian: ETL
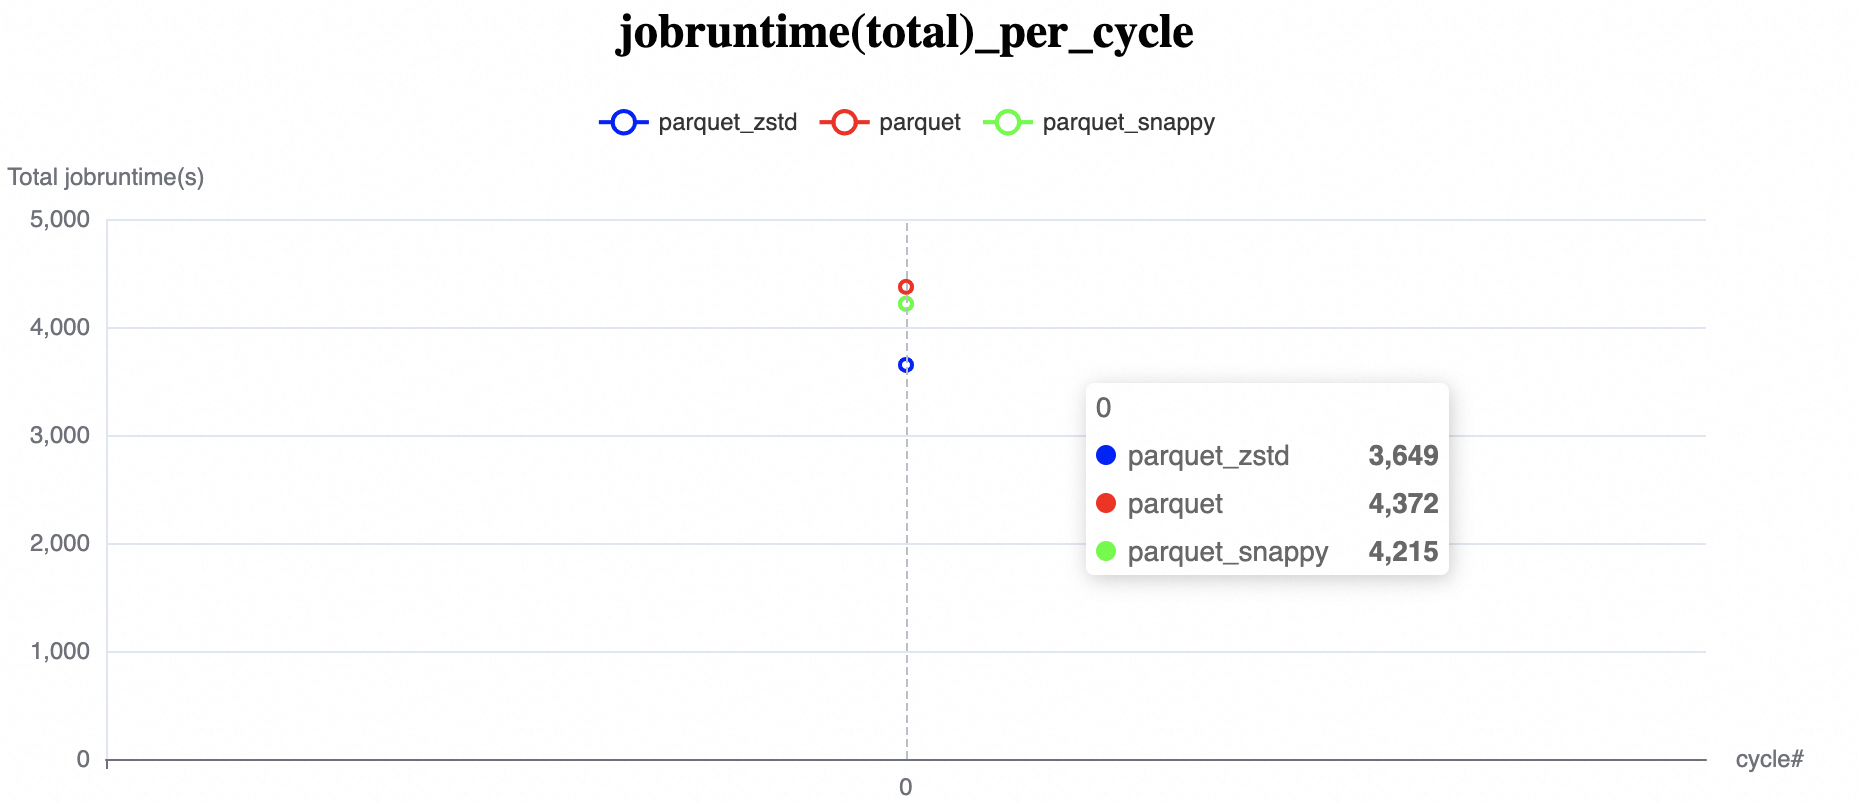
Metrik | Parquet tidak terkompresi | Parquet-Snappy | Parquet-ZSTD |
job runtime (s) | 4372 | 4215 | 3649 |
CPU cost | 14211,89 | 10131,36 | 6004,26 |
Memory cost | 26852,91 | 19323,27 | 11778,06 |
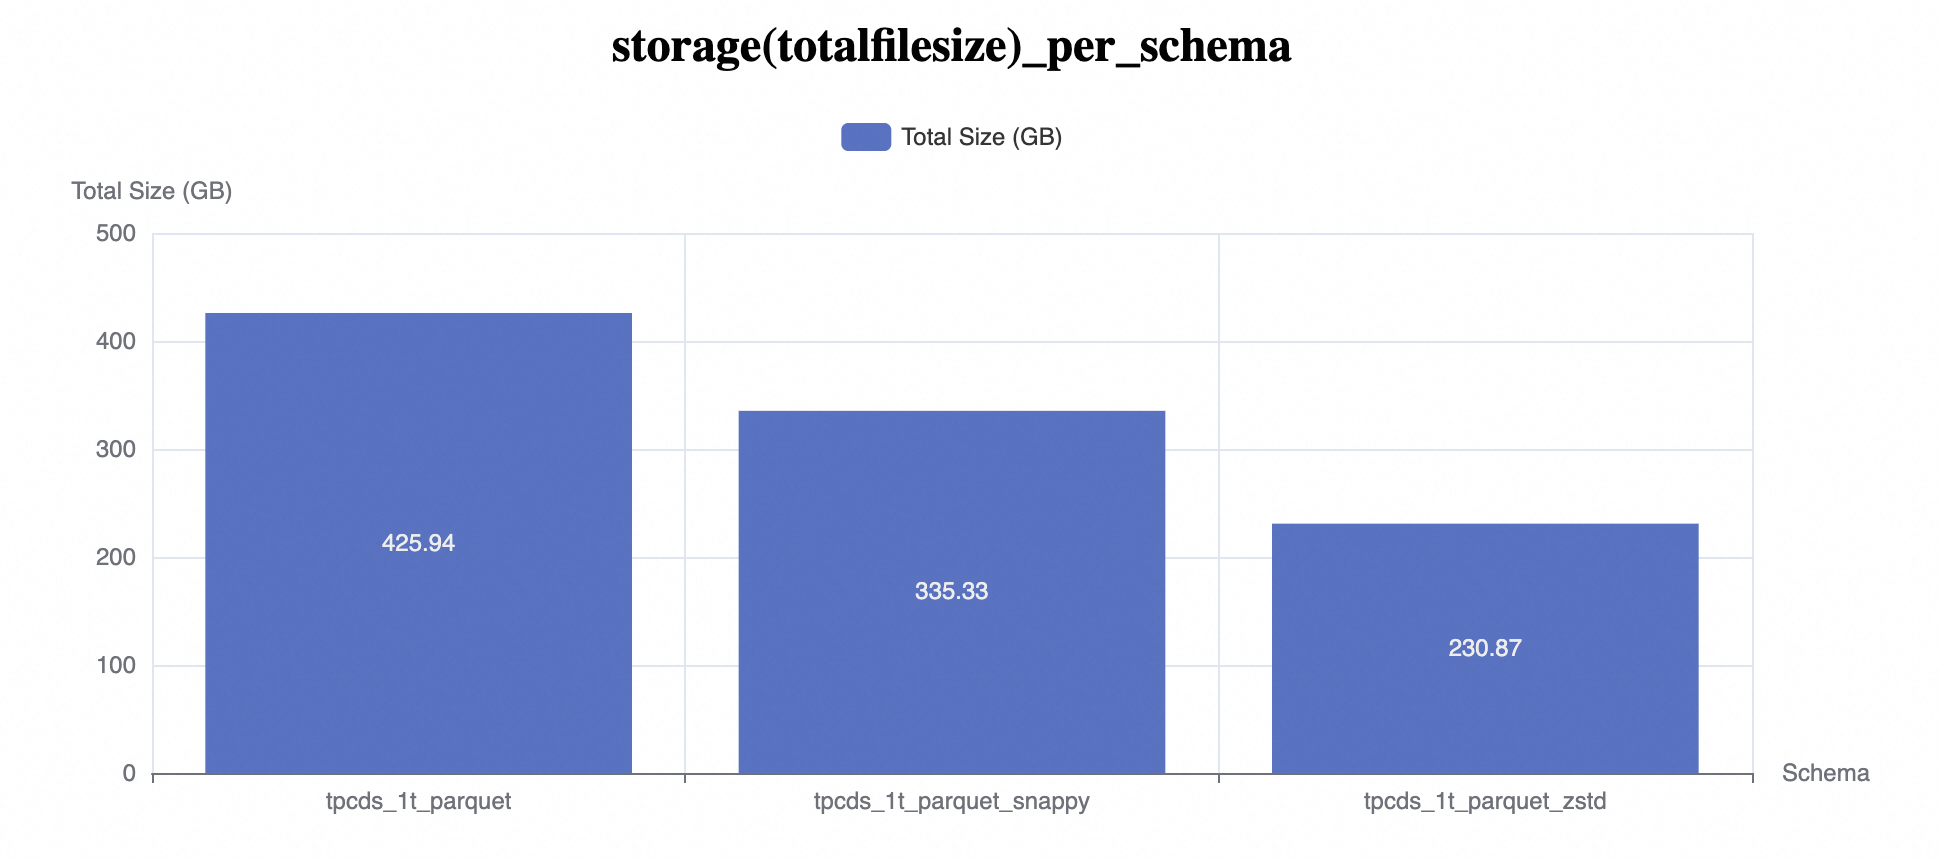
Storage (GB) | 425,94 | 335,33 | 230,87 |
Latensi: ZSTD 13,4% lebih cepat daripada Snappy dan 16,5% lebih cepat daripada tidak terkompresi.
CPU: ZSTD menggunakan 40,7% lebih sedikit CPU daripada Snappy dan 57,75% lebih sedikit daripada tidak terkompresi.
Memori: ZSTD menggunakan 39,04% lebih sedikit memori daripada Snappy dan 56,13% lebih sedikit daripada tidak terkompresi.
Storage: ZSTD menggunakan 31,15% lebih sedikit ruang penyimpanan daripada Snappy dan 45,8% lebih sedikit daripada tidak terkompresi.
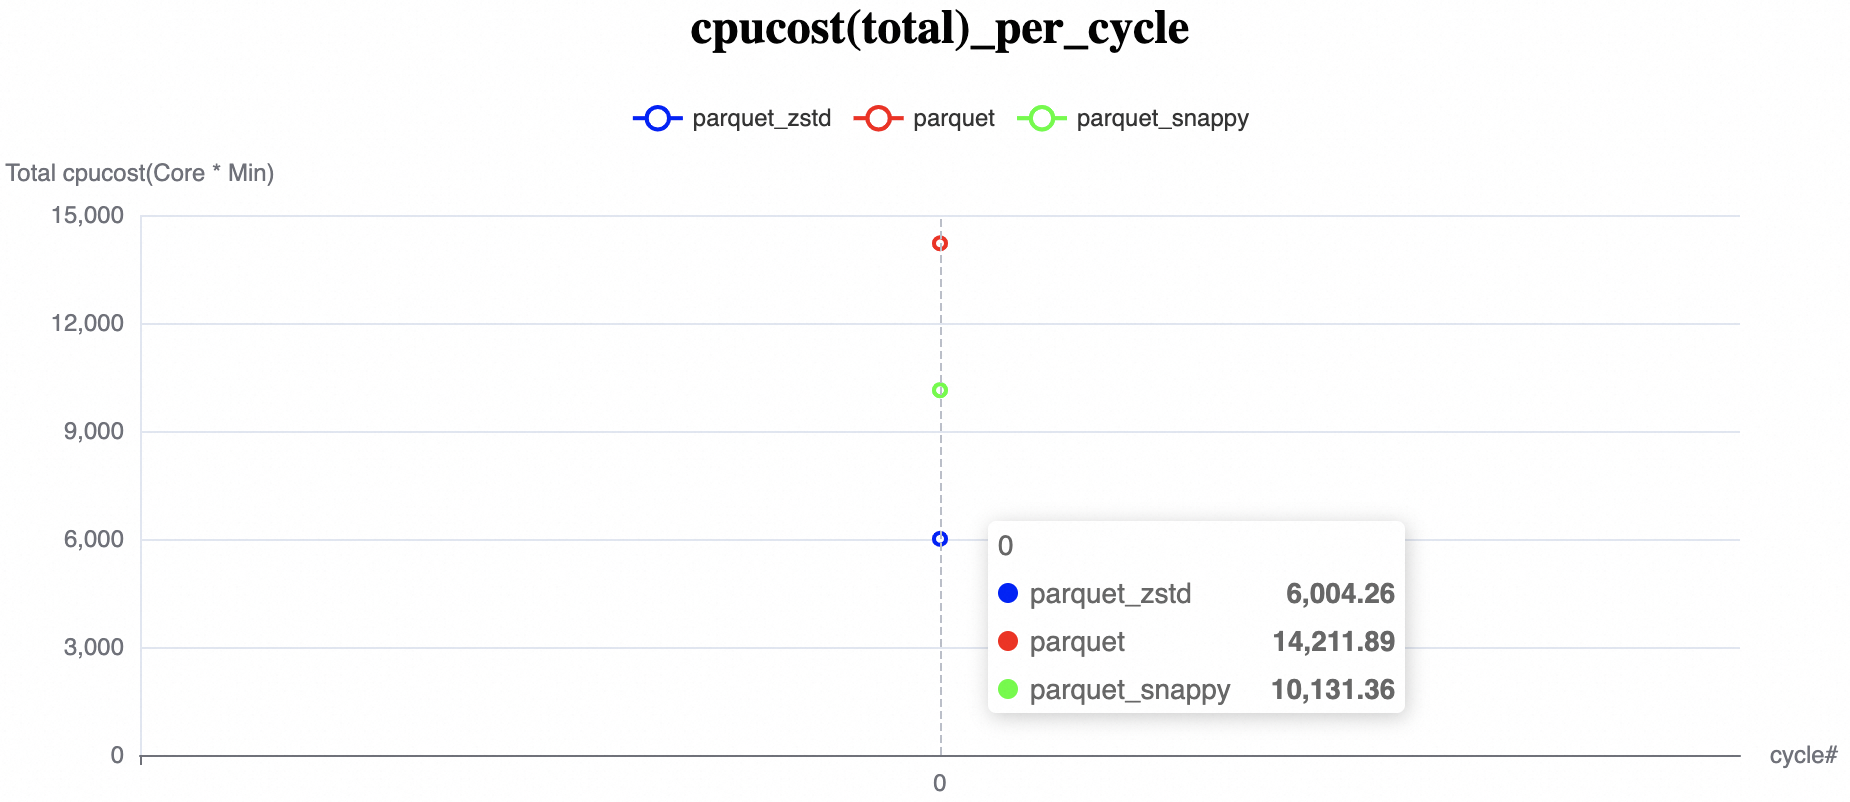
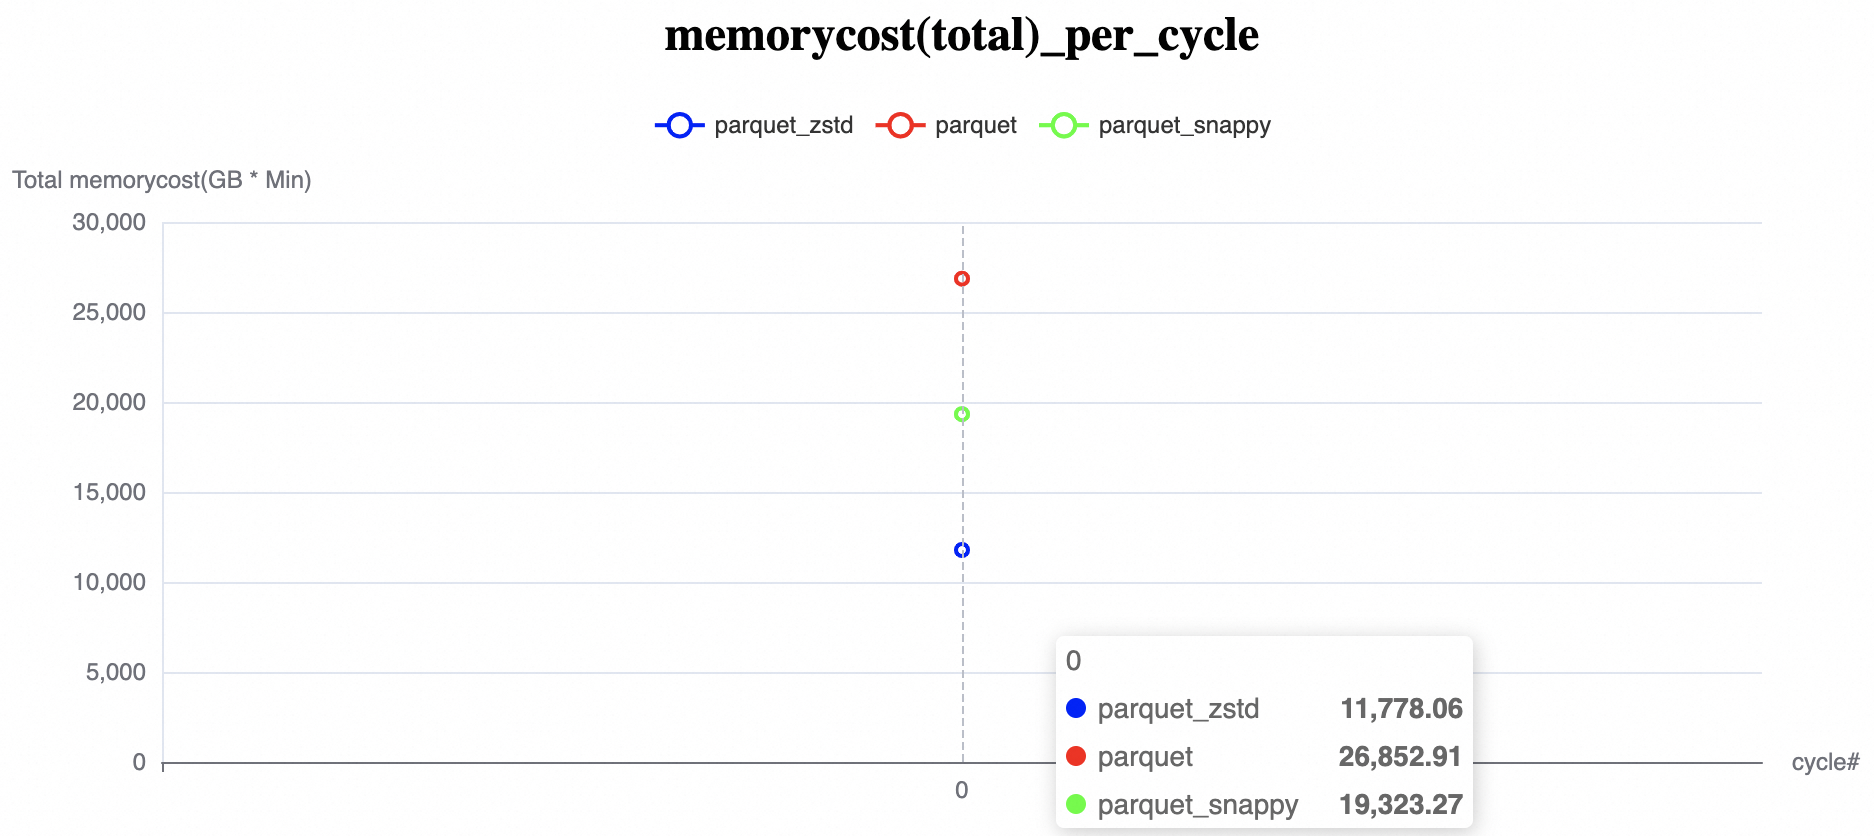
Efisiensi penyimpanan
Set data: TPC-DS 1 TB
Resource: 900+ CU
Metode pengujian: ETL
tidak terkompresi: Meskipun format ini tidak dikompresi, menghasilkan volume data yang lebih besar dan overhead I/O yang lebih tinggi, yang menyebabkan performa keseluruhan buruk.
snappy: Kecepatan kompresi tidak lebih cepat daripada ZSTD tingkat rendah, tetapi rasio kompresinya lebih tinggi. Hal ini menghasilkan performa keseluruhan lebih buruk daripada ZSTD tingkat rendah.
zstd: Ukuran data output konvergen dengan cepat. Tingkat yang lebih tinggi memberikan kompresi tambahan minimal (hanya 13,87% lebih banyak) tetapi menyebabkan peningkatan cepat dalam waktu dan konsumsi resource, yang secara drastis mengurangi efektivitas biaya. Untuk skenario ini, ZSTD tingkat rendah (level 3 hingga 5) memberikan hasil terbaik. Level 3 adalah default.
Pada set data TPC-DS 1 TB, ZSTD menggunakan 31,1% lebih sedikit ruang penyimpanan daripada Snappy dan 45,8% lebih sedikit daripada tidak terkompresi.
Format kompresi | Ukuran data output (GB / Rasio kompresi) | Waktu proses job (s) | Waktu TableSink (s, % dari waktu proses job) | CPU (Core × Min) | Memori (GB × Min) |
tidak terkompresi | 486,67 (100%) | 256,406 | ~ 134,61 (52,5%) | 2353,19 | 3361,71 |
snappy | 238,33 (48,97%) | 239,087 | ~ 73,88 (30,9%) | 2110,31 | 3014,73 |
zstd (level 1, min) | 164,71 (33,84%) | 233,170 | ~ 65,75 (28,2%) | 2110,23 | 3014,61 |
zstd (level 2) | 165,3 (33,97%) | 231,226 | ~ 64,51 (27,9%) | 2100,79 | 3001,13 |
zstd (level 3, default) | 158,9 (32,65%) | 236,985 | ~ 67,07 (28,3%) | 2115,10 | 3021,57 |
zstd (level 4) | 159,52 (32,77%) | 232,477 | ~ 67,65 (29,1%) | 2100,13 | 3000,19 |
zstd (level 5) | 157,89 (32,44%) | 232,248 | ~ 71,07 (30,6%) | 2103,96 | 3005,66 |
zstd (level 6) | 160,47 (32,97%) | 236,669 | ~ 78,10 (33,0%) | 2137,63 | 3053,75 |
zstd (level 9) | 152,00 (31,23%) | 254,073 | ~ 100,36 (39,5%) | 2287,61 | 3268,01 |
zstd (level 14) | 144,63 (29,72%) | 455,019 | ~ 341,26 (75,5%) | 4076,00 | 5822,86 |
zstd (level 19) | 150,87 (31,00%) | 727,841 | ~ 614,30 (84,4%) | 6933,10 | 9904,43 |
zstd (level 22, max) | 150,81 (30,99%) | 5381,359 | ~ 5.257,59 (97,7%) | 42848,13 | 61211,62 |
Contoh skenario
Contoh ini menunjukkan cara membuat tabel eksternal Parquet partisi dengan kompresi ZSTD, lalu membaca dari dan menulis ke tabel tersebut.
Prasyarat
Anda telah membuat proyek MaxCompute.
Anda telah menyiapkan bucket dan direktori OSS. Untuk informasi selengkapnya, lihat Buat bucket dan Kelola direktori.
Pastikan bucket Anda berada di wilayah yang sama dengan proyek MaxCompute Anda.
Berikan izin.
Anda memiliki izin untuk mengakses OSS. Anda dapat mengakses tabel eksternal OSS dengan menggunakan Akun Alibaba Cloud, Pengguna RAM, atau Peran RAM. Untuk informasi selengkapnya tentang cara memberikan izin, lihat Otorisasi mode STS untuk OSS.
Anda memiliki izin CreateTable di proyek MaxCompute. Untuk informasi selengkapnya tentang izin terkait tabel, lihat Izin MaxCompute.
Siapkan file data dalam format ZSTD.
Dalam bucket
oss-mc-testuntuk data sampel, buat folderparquet_zstd_jni/dt=20230418dan simpan file data di folder partisidt=20230418.Buat tabel eksternal Parquet yang menggunakan format kompresi ZSTD.
CREATE EXTERNAL TABLE IF NOT EXISTS mc_oss_parquet_data_type_zstd (
    vehicleId INT,
    recordId INT,
    patientId INT,
    calls INT,
    locationLatitute DOUBLE,
    locationLongtitue DOUBLE,
    recordTime STRING,
    direction STRING
)
PARTITIONED BY (dt STRING )
ROW FORMAT SERDE 'org.apache.hadoop.hive.ql.io.parquet.serde.ParquetHiveSerDe'
WITH serdeproperties(
  'odps.properties.rolearn'='acs:ram::<uid>:role/<role_name>',
  'mcfed.parquet.compression'='zstd'
)
STORED AS parquet
LOCATION 'oss://oss-cn-hangzhou-internal.aliyuncs.com/oss-mc-test/parquet_zstd_jni/';
Impor data partisi. Jika tabel eksternal OSS adalah tabel partisi, Anda juga harus mengimpor data partisi. Untuk informasi selengkapnya, lihat Tabel eksternal OSS.
-- Impor data partisi.
MSCK REPAIR TABLE mc_oss_parquet_data_type_zstd ADD PARTITIONS;
Baca data dari tabel eksternal Parquet.
SELECT * FROM mc_oss_parquet_data_type_zstd WHERE dt='20230418' LIMIT 10;Output sampel berikut dikembalikan:
+------------+------------+------------+------------+------------------+-------------------+----------------+------------+------------+
| vehicleid  | recordid   | patientid  | calls      | locationlatitute | locationlongtitue | recordtime     | direction  | dt         |
+------------+------------+------------+------------+------------------+-------------------+----------------+------------+------------+
| 1          | 12         | 76         | 1          | 46.81006         | -92.08174         | 9/14/2014 0:10 | SW         | 20230418   |
| 1          | 1          | 51         | 1          | 46.81006         | -92.08174         | 9/14/2014 0:00 | S          | 20230418   |
| 1          | 2          | 13         | 1          | 46.81006         | -92.08174         | 9/14/2014 0:01 | NE         | 20230418   |
| 1          | 3          | 48         | 1          | 46.81006         | -92.08174         | 9/14/2014 0:02 | NE         | 20230418   |
| 1          | 4          | 30         | 1          | 46.81006         | -92.08174         | 9/14/2014 0:03 | W          | 20230418   |
| 1          | 5          | 47         | 1          | 46.81006         | -92.08174         | 9/14/2014 0:04 | S          | 20230418   |
| 1          | 6          | 9          | 1          | 46.81006         | -92.08174         | 9/14/2014 0:05 | S          | 20230418   |
| 1          | 7          | 53         | 1          | 46.81006         | -92.08174         | 9/14/2014 0:06 | N          | 20230418   |
| 1          | 8          | 63         | 1          | 46.81006         | -92.08174         | 9/14/2014 0:07 | SW         | 20230418   |
| 1          | 9          | 4          | 1          | 46.81006         | -92.08174         | 9/14/2014 0:08 | NE         | 20230418   |
| 1          | 10         | 31         | 1          | 46.81006         | -92.08174         | 9/14/2014 0:09 | N          | 20230418   |
+------------+------------+------------+------------+------------------+-------------------+----------------+------------+------------+
Tulis data ke tabel eksternal Parquet.
INSERT INTO mc_oss_parquet_data_type_zstd PARTITION ( dt = '20230418')
  VALUES  (1,16,76,1,46.81006,-92.08174,'9/14/2014 0:10','SW');
-- Kueri data yang baru ditulis
SELECT * FROM mc_oss_parquet_data_type_zstd WHERE dt = '20230418' AND recordid=16;
Hasilnya sebagai berikut:
+------------+------------+------------+------------+------------------+-------------------+----------------+------------+------------+
| vehicleid  | recordid   | patientid  | calls      | locationlatitute | locationlongtitue | recordtime     | direction  | dt         |
+------------+------------+------------+------------+------------------+-------------------+----------------+------------+------------+
| 1          | 16         | 76         | 1          | 46.81006         | -92.08174         | 9/14/2014 0:10 | SW         | 20230418   |
+------------+------------+------------+------------+------------------+-------------------+----------------+------------+------------+
Tipe data yang didukung
Untuk informasi selengkapnya tentang tipe data MaxCompute, lihat Tipe data (versi 1.0) dan Tipe data (versi 2.0).
Mode Java Native Interface (JNI):
set odps.ext.parquet.native=false. Mode ini menggunakan implementasi berbasis Java open source asli untuk mengurai file data Parquet saat Anda membaca dari tabel eksternal. Mode ini mendukung operasi baca dan tulis.Mode Native:
set odps.ext.parquet.native=true. Mode ini menggunakan implementasi native berbasis C++ baru untuk mengurai file data Parquet saat Anda membaca dari tabel eksternal. Mode ini hanya mendukung operasi baca.Mode
Mode Java (baca/tulis)
Mode Native (read-only)
TINYINT
SMALLINT
INT
BIGINT
BINARY
FLOAT
DOUBLE
DECIMAL(precision,scale)
VARCHAR(n)
CHAR(n)
STRING
DATE
DATETIME
TIMESTAMP
TIMESTAMP_NTZ
BOOLEAN
ARRAY
MAP
STRUCT
JSON
Format kompresi yang didukung
Untuk membaca atau menulis file OSS terkompresi, Anda dapat menambahkan konfigurasi properti with serdeproperties ke pernyataan pembuatan tabel. Untuk informasi selengkapnya, lihat parameter properti with serdeproperties.
Properti kompresi | Baca | Tulis |
Gzip | ||
ZSTD | ||
SNAPPY (SnappyRawCodec) | ||
SNAPPY (SnappyCodec) |
Dukungan untuk evolusi skema
Tabel eksternal Parquet memetakan nilai kolom antara skema dan kolom file berdasarkan nama.
Kolom Masalah kompatibilitas data dalam tabel berikut menjelaskan apakah data dapat dibaca dengan benar setelah operasi evolusi skema. Hal ini berlaku baik untuk data baru yang sesuai dengan skema yang dimodifikasi maupun data historis yang menggunakan skema lama.
Jenis operasi | Didukung | Deskripsi | Masalah kompatibilitas data |
Tambah kolom |
|
| |
Hapus kolom | Tabel eksternal Parquet memetakan nilai kolom berdasarkan nama. | Kompatibel | |
Ubah urutan kolom | Tabel eksternal Parquet memetakan nilai kolom berdasarkan nama. | Kompatibel | |
Ubah tipe data kolom | Operasi ini tidak didukung. Format Parquet memiliki validasi skema yang ketat. Mengubah tipe data dapat membuat data tidak dapat dibaca. | Tidak berlaku | |
Ubah nama kolom | Operasi ini tidak didukung. Format Parquet memiliki validasi skema yang ketat, yang dapat menyebabkan tipe yang sebelumnya kompatibel menjadi tidak dapat dibaca setelah modifikasi. | Tidak berlaku | |
Ubah komentar kolom | Komentar harus berupa string yang valid dengan panjang maksimal 1024 byte. Jika tidak, terjadi error. | Kompatibel | |
Ubah properti non-null kolom | Operasi ini tidak didukung. Kolom bersifat nullable secara default. | Tidak berlaku |
FAQ
Ketidaksesuaian tipe kolom antara file Parquet dan DDL tabel eksternal
Pesan error
ODPS-0123131:User defined function exception - Traceback:
java.lang.ClassCastException: org.apache.hadoop.io.LongWritable cannot be cast to org.apache.hadoop.io.IntWritable
   at org.apache.hadoop.hive.serde2.objectinspector.primitive.WritableIntObjectInspector.getPrimitiveJavaObject(WritableIntObjectInspector.java:46)
Deskripsi error
Tipe bidang LongWritable dari file Parquet tidak sesuai dengan tipe INT dalam DDL tabel eksternal.
Solusi
Ubah tipe INT dalam DDL tabel eksternal menjadi BIGINT.
Error saat menulis ke tabel eksternal: java.lang.OutOfMemoryError
Pesan error
ODPS-0123131:User defined function exception - Traceback:
java.lang.OutOfMemoryError: Java heap space
	at java.io.ByteArrayOutputStream.<init>(ByteArrayOutputStream.java:77)
	at org.apache.parquet.bytes.BytesInput$BAOS.<init>(BytesInput.java:175)
	at org.apache.parquet.bytes.BytesInput$BAOS.<init>(BytesInput.java:173)
	at org.apache.parquet.bytes.BytesInput.toByteArray(BytesInput.java:161)
Deskripsi error
Terjadi error kehabisan memori (OOM) saat Anda menulis volume data besar ke tabel eksternal Parquet.
Solusi
Saat membuat tabel eksternal, pertama-tama kurangi parameter
mcfed.parquet.block.row.count.limit. Jika error OOM masih terjadi atau file output terlalu besar, kurangi parametermcfed.parquet.page.size.row.check.maxuntuk memeriksa memori lebih sering. Untuk informasi selengkapnya, lihat Parameter unik.Sebelum menulis data ke tabel eksternal Parquet, tambahkan parameter berikut.
-- Atur ukuran memori maksimum untuk heap JVM UDF.
SET odps.sql.udf.jvm.memory=12288;
-- Kontrol ukuran batch di sisi waktu proses.
SET odps.sql.executionengine.batch.rowcount =64;
-- Atur ukuran memori untuk setiap pekerja Map.
SET odps.stage.mapper.mem=12288;
-- Atur volume data input untuk setiap pekerja Map (ukuran shard file input) untuk secara tidak langsung mengontrol jumlah pekerja per tahap Map.
SET odps.stage.mapper.split.size=64;