Topik ini menjelaskan antarmuka pemrograman MapReduce yang didukung oleh MaxCompute beserta batasannya.
Apa itu MapReduce
MapReduce adalah framework komputasi terdistribusi yang umum digunakan. Framework ini menggunakan pendekatan divide-and-conquer untuk memecah masalah besar atau kompleks menjadi submasalah yang lebih kecil dan mudah dikelola. MapReduce menyelesaikan submasalah tersebut, lalu menggabungkan hasilnya untuk mendapatkan solusi akhir. Dibandingkan dengan framework pemrograman paralel tradisional, MapReduce menawarkan keunggulan seperti Toleransi kesalahan yang tinggi, kemudahan penggunaan, dan ekstensibilitas yang baik. Saat mengimplementasikan program paralel di MapReduce, Anda tidak perlu mengelola detail mendasar kluster terdistribusi, seperti penyimpanan data atau mekanisme komunikasi antar-node, sehingga menyederhanakan pemrograman terdistribusi.
Gambar berikut menunjukkan Alur kerja MapReduce.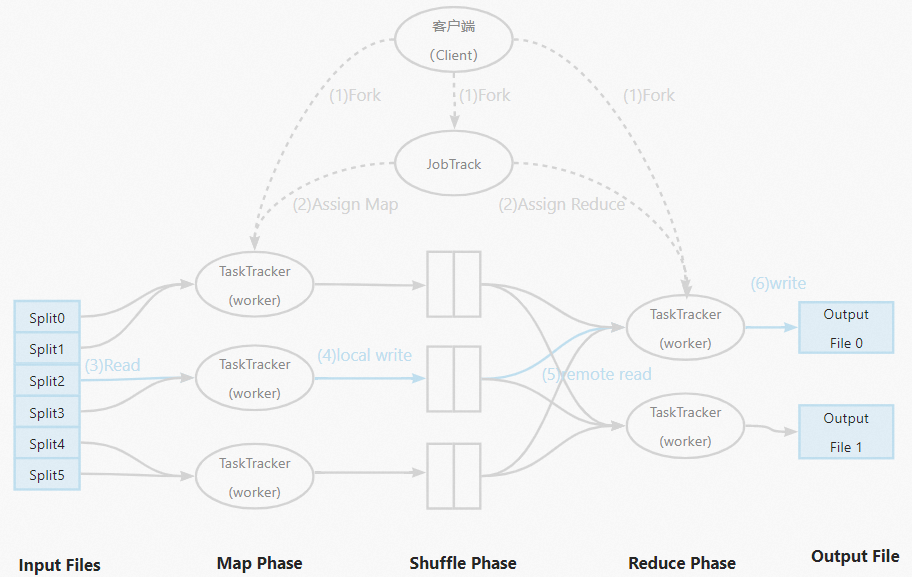
MaxCompute menyediakan dua antarmuka pemrograman MapReduce:
MaxCompute MapReduce: API asli MaxCompute. Versi ini memiliki performa cepat dan menyederhanakan pengembangan karena tidak mengekspos sistem file.
MaxCompute extended MapReduce (MR2): Versi ini mendukung logika penjadwalan Pekerjaan yang lebih kompleks, dengan implementasi yang konsisten terhadap antarmuka asli MaxCompute. Dibandingkan dengan MapReduce tradisional, model yang diperluas ini mengubah model penjadwalan dan I/O yang mendasarinya untuk menghindari operasi I/O yang redundan selama eksekusi Pekerjaan.
Kedua versi ini sebagian besar konsisten dalam hal Kata kunci, Pengiriman Pekerjaan, Input dan Output, serta Penggunaan Sumber Daya, namun Java SDK-nya berbeda. Untuk informasi selengkapnya, lihat Tutorial Hadoop Map/Reduce.
Anda tidak dapat menggunakan MapReduce untuk membaca atau menulis data dalam tabel eksternal.
MapReduce
Skenario
MapReduce mendukung skenario berikut:
Pencarian: Web crawling, Indeks terbalik, dan PageRank.
Analisis Log akses web:
Menganalisis dan menambang perilaku pengguna, seperti penjelajahan dan belanja, untuk memberikan rekomendasi personalisasi.
Menganalisis pola akses pengguna.
Analisis statistik teks:
Penghitungan kata dan analisis term frequency-inverse document frequency (TF-IDF) pada novel populer.
Analisis statistik dan sitasi makalah akademis serta dokumen paten.
Analisis data Wikipedia.
Penambangan data dalam jumlah besar, seperti data tidak terstruktur, data spatio-temporal, dan data gambar.
Machine learning: Supervised Learning, Unsupervised Learning, dan algoritma Klasifikasi, seperti Pohon keputusan dan support vector machine (SVM).
Natural Language Processing:
Pelatihan dan prediksi berbasis data besar.
Membangun matriks ko-okurensi kata, menambang itemset yang sering muncul, dan mendeteksi duplikat dokumen berdasarkan korpus.
Rekomendasi iklan: prediksi click-through rate (CTR) dan conversion rate (CVR).
Deskripsi proses MapReduce
Program MapReduce memproses data dalam dua tahap utama: tahap map diikuti oleh tahap reduce. Anda dapat menentukan logika pemrosesan untuk tahap-tahap ini, namun harus mengikuti konvensi framework MapReduce. Alur Pemrosesan data lengkap MapReduce adalah sebagai berikut:
Data masukan: Sebelum operasi map, data masukan dipartisi menjadi Blok data berukuran sama. Setiap Blok data digunakan sebagai input untuk map worker, memungkinkan beberapa map worker berjalan secara konkuren.
Tahap map: Setiap map worker membaca dan memproses Blok data yang ditugaskan kepadanya. Kemudian, worker menetapkan kunci untuk setiap Catatan output. Kunci ini menentukan reduce worker mana yang akan menerima Catatan tersebut.
CatatanCatatan data dengan kunci yang sama dikirim ke reduce worker yang sama. Satu reduce worker dapat menerima Catatan data dengan kunci yang berbeda.
Fase shuffle: Sebelum fase Reduce, framework MapReduce mengurutkan data berdasarkan Kunci, yang mengelompokkan data dengan Kunci yang sama. Jika Anda menentukan Combine Operation (Combiner), framework memanggil Combiner untuk mengagregasi data dengan Kunci yang sama. Anda dapat menyesuaikan logika Combiner. Di MaxCompute, berbeda dengan protokol framework MapReduce klasik, parameter input dan output Combiner harus konsisten dengan parameter pada fase Reduce. Bagian dari proses ini juga sering disebut Shuffle.
Tahap reduce: Catatan data dengan kunci yang sama dikirim ke reduce worker yang sama. Satu reduce worker dapat menerima data dari beberapa map worker. Setiap reduce worker melakukan operasi reduce pada Catatan data dengan kunci yang sama, lalu mengubahnya menjadi satu nilai tunggal.
Data keluaran: Hasil akhir dihasilkan.
Bagian ini memberikan pengantar singkat tentang framework MapReduce. Untuk informasi selengkapnya, lihat Pengantar Fungsi.
Bagian berikut menggunakan contoh WordCount untuk menjelaskan konsep setiap tahap dalam MaxCompute MapReduce.
Misalkan terdapat sebuah file bernama a.txt dan setiap baris file tersebut berisi satu digit angka. Tujuannya adalah menghitung frekuensi kemunculan setiap digit. Dalam konteks ini, setiap digit adalah 'kata', dan jumlah kemunculannya adalah 'hitungan'. Untuk mencapai hal ini, MaxCompute MapReduce mengikuti proses yang ditunjukkan pada gambar di bawah ini.
Procedure
Data masukan: File teks dipartisi. Data di setiap partisi digunakan sebagai input untuk map worker.
Tahap map: Map worker memproses input. Untuk setiap digit yang diterima, worker menetapkan hitungan menjadi 1 dan mengeluarkan pasangan <Word, Count>. Kata tersebut digunakan sebagai kunci untuk data output.
Shuffle > Combine dan urutkan: Pada tahap awal shuffle, output dari setiap map worker pertama-tama diurutkan berdasarkan kunci (kata). Setelah pengurutan, operasi combiner dilakukan. Hitungan untuk kunci (kata) yang sama diagregasi untuk membentuk pasangan <Word, Count> baru. Proses ini disebut combine dan sort.
Shuffle > Tetapkan ke reducer: Pada tahap akhir shuffle, data dikirim ke reducer. Setelah reduce worker menerima data, worker mengurutkan kembali data tersebut berdasarkan kunci.
Tahap reduce: Setiap reduce worker memproses data menggunakan logika yang sama dengan combiner. Worker mengagregasi hitungan untuk kunci (kata) yang sama untuk mendapatkan hasil akhir.
Data keluaran.
Semua data MaxCompute disimpan dalam tabel. Oleh karena itu, input dan output MaxCompute MapReduce harus berupa tabel. Anda tidak dapat menentukan format output, dan tidak ada antarmuka mirip sistem file yang disediakan.
Batasan
Untuk batasan MapReduce, lihat Ringkasan batasan.
Untuk batasan menjalankan MapReduce secara lokal, lihat Perbedaan antara menjalankan secara lokal dan di lingkungan terdistribusi.
Extended MapReduce (MR2)
Dibandingkan dengan MaxCompute MapReduce asli, cara penulisan fungsi seperti Map dan Reduce di MR2 sebagian besar sama. Perbedaan utamanya terletak pada cara Pekerjaan dieksekusi. Sebagai contoh, lihat Contoh Pipeline.
Latar belakang model MR2
Model MapReduce tradisional mengharuskan data hasil setiap putaran operasi MapReduce disimpan dalam sistem file terdistribusi, seperti Hadoop Distributed File System (HDFS) atau tabel MaxCompute. Alur kerja MapReduce biasanya terdiri dari beberapa Pekerjaan MapReduce. Setelah setiap Pekerjaan selesai, data perantaranya harus ditulis ke disk. Namun, task map berikutnya mungkin hanya perlu membaca data ini sekali sebelum tahap shuffle berikutnya, sehingga menciptakan operasi I/O disk yang redundan.
Logika komputasi dan penjadwalan MaxCompute mendukung model pemrograman yang lebih kompleks. Untuk mengatasi situasi ini, MaxCompute memungkinkan Anda menjalankan operasi reduce langsung setelah operasi reduce lainnya tanpa operasi map perantara. Oleh karena itu, MaxCompute menyediakan model MapReduce yang diperluas yang mendukung perantaian beberapa operasi reduce setelah operasi map, seperti Map > Reduce > Reduce.
Perbandingan dengan Hadoop Chain Mapper dan ChainReducer
Hadoop Chain Mapper dan ChainReducer juga mendukung operasi map atau reduce berseri yang serupa. Namun, keduanya berbeda secara mendasar dari model extended MapReduce (MR2) milik MaxCompute.
Chain Mapper dan ChainReducer didasarkan pada model MapReduce tradisional. Keduanya hanya memungkinkan Anda menambahkan satu atau lebih operasi map setelah operasi map atau reduce awal, tetapi tidak memungkinkan penambahan operasi reduce. Keuntungan pendekatan ini adalah Anda dapat menggunakan kembali logika bisnis mapper yang ada untuk memecah operasi map atau reduce menjadi beberapa tahap mapper. Namun, hal ini tidak mengubah model penjadwalan dan I/O yang mendasarinya secara fundamental.