Bloom filter adalah struktur data probabilistik yang efisien. MaxCompute memungkinkan pengguna menggunakan indeks Bloom filter untuk menjalankan kueri titik berskala besar, mengurangi pemindaian data yang tidak perlu selama kueri, serta meningkatkan efisiensi dan performa keseluruhan. Topik ini menjelaskan cara menggunakan indeks Bloom filter dan menyertakan contoh.
Informasi latar belakang
Kueri titik berskala besar sering digunakan dalam skenario gudang data. Saat pengguna menjalankan kueri titik berskala besar, mereka dapat menentukan kondisi filter berdasarkan kolom acak untuk mendapatkan data yang sesuai dengan kondisi tersebut. Dalam skenario big data, hasil data mungkin tersebar di banyak file, sehingga kueri titik berskala besar yang berperforma tinggi memerlukan kemampuan pencarian yang kuat.
MaxCompute membaca data berdasarkan tabel atau partisi. Penurunan predikat pada lapisan penyimpanan menyaring data berdasarkan metadata lokal file dalam tabel atau partisi. Anda dapat menjalankan pernyataan ANALYZE untuk mendapatkan metadata lokal. Jika data berasal dari beberapa file, penyaringan data berdasarkan metadata lokal, seperti nilai minimum atau maksimum dalam kolom tertentu, tidak memberikan efek yang signifikan.
Jika kolom yang akan dikueri tetap, Anda dapat menggunakan tabel terkluster untuk penyaringan. Anda dapat menggunakan kunci kluster sebagai kondisi filter untuk dengan cepat menyaring bucket dan data dalam bucket yang tidak perlu dibaca, sehingga mempercepat kueri. Jika Anda melakukan operasi seperti agregasi berdasarkan bidang kondisi atau asosiasi dengan tabel lain, Anda dapat memanfaatkan kemampuan penghapusan shuffle yang disediakan oleh klustering untuk lebih memaksimalkan keuntungan tabel terkluster. Namun, tabel terkluster memiliki kelemahan berikut:
Untuk tabel hash-clustered, Anda hanya dapat menyaring data jika kondisi kueri mencakup semua kunci kluster. Untuk tabel range-clustered, efek penyaringan data hanya jelas jika kondisi kueri mencakup awalan kunci kluster dan kunci kluster cocok dari kiri ke kanan. Jika kondisi kueri tidak mencakup awalan kunci kluster, efek penyaringan data tidak signifikan.
Jika kondisi kueri tidak mencakup kunci kluster, data tidak dapat disaring. Oleh karena itu, tabel terkluster tidak berguna untuk kueri tanpa kondisi tetap.
Saat menulis data, Anda harus mengocok data berdasarkan bidang tertentu, yang meningkatkan biaya. Jika Anda menghadapi kunci yang condong, ekor panjang mungkin terjadi dalam tugas.
Untuk mengatasi kelemahan tersebut, MaxCompute memperkenalkan indeks Bloom filter untuk skenario kueri titik berskala besar.
Prasyarat
Proyek MaxCompute telah dibuat. Untuk informasi lebih lanjut, lihat Buat proyek MaxCompute.
Evolusi skema diaktifkan untuk proyek. Jika evolusi skema tidak diaktifkan untuk proyek Anda, jalankan perintah
setproject odps.schema.evolution.enable=true;di tingkat proyek untuk memastikan operasi berikutnya dapat dieksekusi dengan sukses. Jika tidak, kesalahan sepertiFailed to run ddltask - Schema evolution DDLs is not enabled in project:defaultakan dilaporkan.
Deskripsi fitur
Kueri titik pada dasarnya bertujuan untuk memeriksa apakah elemen ada dalam satu set. Anda dapat menggunakan Bloom filter untuk menjalankan kueri titik secara efisien. Oleh karena itu, indeks Bloom filter diperkenalkan dalam teknologi database dan data lake untuk mendukung pemangkasan data atau file yang lebih halus.
Indeks database, seperti indeks BTree atau RTree, digunakan untuk menemukan baris data. Dalam skenario big data, indeks yang lebih ringan diperlukan untuk mengurangi beban kerja pembuatan dan pemeliharaan indeks. Indeks Bloom filter yang hemat ruang dan efisien kueri cocok untuk pemangkasan file dalam skenario kueri titik. Oleh karena itu, MaxCompute memperkenalkan indeks Bloom filter.
Dibandingkan dengan tabel terkluster, indeks Bloom filter memiliki keuntungan berikut:
Keefisienan tinggi: Indeks Bloom filter dapat menyaring data yang tidak perlu dengan biaya minimal.
Ekstensibilitas tinggi: Anda dapat membuat indeks Bloom filter pada satu atau lebih kolom tabel. Anda juga dapat membuat indeks Bloom filter untuk kunci non-klustering dan menggunakannya bersama dengan indeks terkluster.
Efek penyaringan yang jelas: Indeks Bloom filter memberikan efek penyaringan data yang signifikan dalam skenario kardinalitas tinggi dan intensif data.
Kelebihan dan kekurangan
Kelebihan
Keefisienan tinggi: Konsumsi sumber daya untuk operasi insert dan query lebih rendah daripada indeks biasa.
Hemat ruang: Array bit digunakan. 232 = 4294967296, artinya array bit dengan 4,2 miliar bit hanya membutuhkan 512 MB ruang memori.
CatatanRuang memori yang ditempati oleh array bit dihitung menggunakan rumus berikut:
4294967296/8/1024/1024 = 512 MB
Kekurangan
Terdapat probabilitas positif palsu (FPP) tertentu. Elemen di luar set mungkin salah dianggap sebagai elemen dalam set. Namun, dalam sebagian besar skenario, konsumsi sumber daya untuk membaca file kosong tidak memengaruhi efisiensi keseluruhan, dan hasilnya tidak memengaruhi akurasi bisnis akhir.
Skenario
Jika Anda menggunakan satu atau lebih kolom dalam tabel sebagai kondisi untuk melakukan penyaringan kueri titik, Anda dapat membuat indeks Bloom filter pada kolom kueri yang memiliki efek penyaringan yang jelas.
Jika Anda melakukan penyaringan kueri titik pada bidang dalam tabel terkluster kecuali kunci kluster, Anda dapat membuat indeks Bloom filter pada kolom kueri.
Setelah data dalam tabel terkluster diurutkan menggunakan kunci kluster, kunci terurut, atau fungsi Zorder, Anda dapat membuat indeks Bloom filter pada kolom yang dimasukkan untuk menyaring data lebih lanjut.
Batasan
Indeks Bloom filter cocok untuk operator perbandingan kesetaraan, seperti
=danin. Indeks Bloom filter tidak didukung untuk kueri rentang yang melibatkan operator seperti>, >=, <, and <=dan kueri yang melibatkanIS NULL and IS NOT NULL.Efek penyaringan bergantung pada distribusi data. Jika distribusi data diskrit, efek penyaringan data tidak signifikan meskipun Anda menggunakan indeks Bloom filter.
Indeks Bloom filter tidak didukung pada DECIMAL, INTERVAL_DAY_TIME, INTERVAL_YEAR_MONTH, atau tipe kompleks seperti STRUCT, MAP, ARRAY, dan JSON.
Penagihan
Setelah indeks Bloom filter dibuat, indeks tersebut menempati ruang penyimpanan. Penyimpanan indeks ditagih untuk penggunaan penyimpanan pada Apsara Distributed File System (Pangu). Oleh karena itu, penyimpanan indeks ditagih sebagai penyimpanan standar.
Pembuatan dan penggunaan indeks memicu beban kerja komputasi tambahan. Untuk kueri, sistem menghitung informasi tentang file tempat data yang akan dikueri disimpan berdasarkan file indeks. Kemudian, sistem lebih lanjut menyaring data masukan berdasarkan hasil perhitungan indeks pada tahap perencanaan eksekusi kueri untuk mengurangi jumlah data masukan, dan mendapatkan hasil perhitungan akhir. Baik perhitungan indeks maupun kueri menimbulkan biaya komputasi.
Indeks Bloom filter dapat mempercepat eksekusi pekerjaan yang mengonsumsi sumber daya langganan. Sumber daya yang digunakan untuk membuat indeks dan menjalankan perhitungan indeks semuanya adalah sumber daya langganan. Oleh karena itu, komersialisasi tidak meningkatkan biaya pekerjaan langganan.
Operasi SQL memicu tugas terkait indeks. Tabel berikut menjelaskan tugas terkait indeks yang dipicu oleh operasi SQL.
Operasi SQL
Tugas yang Dipicu
Jumlah Data Masukan Terkait Tugas Terkait Indeks
Penagihan
CREATE
Operasi DDL tidak memicu tugas pembuatan indeks.
N/A.
Tidak ada biaya yang dikenakan.
REBUILD
Indeks dibuat atau dibangun ulang.
Jika indeks ada, operasi REBUILD memicu pembangunan ulang indeks.
Jika tidak ada indeks, operasi REBUILD memicu pembuatan indeks.
Saat Anda membangun ulang indeks, operasi baca dan tulis dilakukan pada kolom indeks dan kolom lainnya secara bersamaan. Oleh karena itu, jumlah data masukan adalah jumlah data penuh setelah data difilter berdasarkan kondisi kueri indeks yang dibangun ulang.
Rumus penagihan indeks:
Harga satuan pekerjaan SQL bayar sesuai pemakaian × Kompleksitas 1 × Jumlah data masukan terkait tugas terkait indeksMetode penagihan untuk kueri SQL: Aturan penagihan bayar sesuai pemakaian untuk pekerjaan SQL umum diterapkan.
INSERT
Indeks dibuat untuk data yang dimasukkan.
Pernyataan SELECT dijalankan untuk kueri.
Jumlah data kolom indeks dalam tabel yang akan dikueri menggunakan pernyataan SELECT.
SELECT
Tugas kueri yang menggunakan perhitungan indeks menghasilkan informasi yang digunakan untuk menyaring data dalam pernyataan SELECT berikutnya.
Pernyataan SELECT dijalankan berdasarkan indeks yang dibuat.
Jumlah data file indeks.
Petunjuk
Bagian ini menjelaskan cara menghasilkan, menggunakan, menanyakan, dan menghapus indeks Bloom filter, serta cara memodifikasi properti indeks Bloom filter.
Menghasilkan indeks Bloom filter
Buat indeks Bloom filter
Sintaks:
CREATE BLOOMFILTER INDEX <index_name>
ON TABLE <table_name>
FOR COLUMNS(<column_name>)
IDXPROPERTIES('numitems'='xxx', 'fpp' = 'xx')
[COMMENT 'idxcomment']
;
Tabel berikut menjelaskan parameter.
Parameter | Deskripsi |
index_name | Nama indeks yang ditentukan. |
table_name | Nama tabel tempat indeks berada. |
column_name | Nama kolom tempat Anda ingin membuat indeks. |
numitems | Perkiraan jumlah elemen yang disimpan dalam Bloom filter. Perkiraan jumlah mencerminkan kapasitas Bloom filter. Ini memastikan bahwa ruang memori yang cukup dialokasikan untuk menyimpan jumlah elemen yang diharapkan selama pembuatan. Parameter ini memengaruhi jumlah total bit yang digunakan dalam Bloom filter dan sangat penting untuk kualitas filter.
Nilai harus lebih besar dari 0. Anda dapat melakukan estimasi berdasarkan jumlah nilai unik dalam kolom indeks. Nilai maksimum tidak boleh melebihi 10000000. |
fpp | FPP. Nilai valid: |
Anda hanya dapat membuat indeks Bloom filter untuk satu kolom dalam tabel pada satu waktu. Anda dapat secara terpisah membuat indeks Bloom filter untuk beberapa kolom dalam tabel.
Gabungkan indeks Bloom filter
Anda tidak perlu melakukan operasi tambahan apa pun pada data tambahan. Anda hanya perlu mengeksekusi pernyataan penyisipan data untuk menggabungkan indeks Bloom filter.
Sintaks:
INSERT OVERWRITE TABLE <table_name> [PARTITION <partition_spec>]
SELECT ......
Parameter:
table_name: nama tabel tempat indeks berada.
pt_spec: informasi tentang partisi tempat Anda ingin memasukkan data. Hanya konstanta yang didukung. Ekspresi, seperti fungsi, tidak didukung. Format:
(partition_col1 = partition_col_value1, partition_col2 = partition_col_value2, ...).
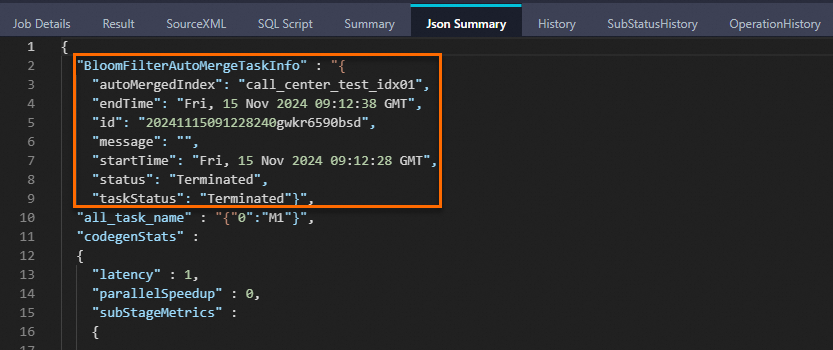
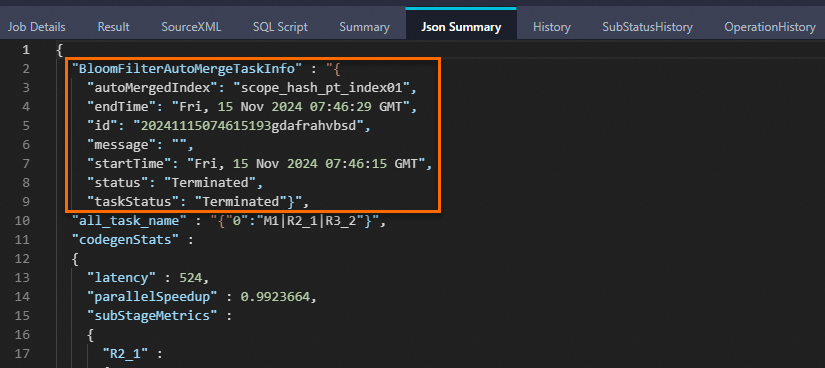
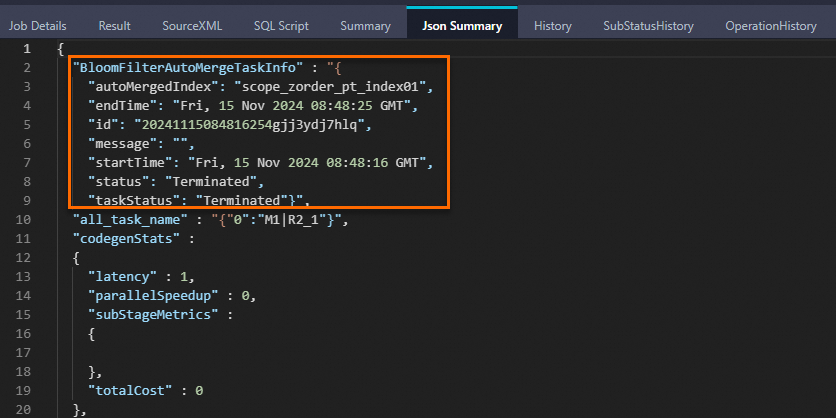
Jika Anda memasukkan data ke tabel yang memiliki indeks Bloom filter, sistem secara bertahap menghasilkan data indeks Bloom filter lokal dari file data, dan mendukung penurunan predikat pada lapisan penyimpanan. Kemudian, sistem memulai BloomfilterAutoMergeTask untuk secara otomatis menggabungkan indeks Bloom filter menjadi file indeks Bloom filter baru. Dengan cara ini, sistem dapat menyaring data pada tahap perencanaan untuk lebih tepat memulai sumber daya yang diperlukan untuk tugas. Jika kata kunci berikut muncul pada tab Json Summary di LogView, indeks Bloom filter berhasil digabungkan.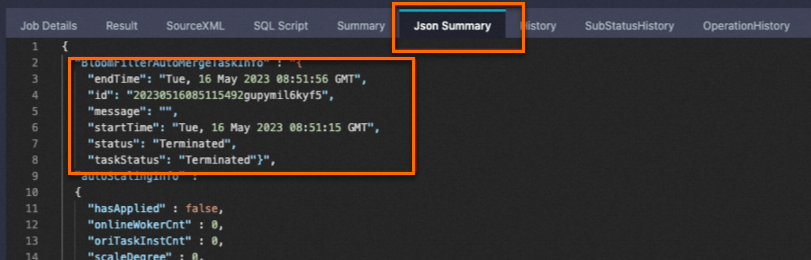
Anda dapat melihat waktu yang diperlukan untuk menggabungkan indeks Bloom filter pada tab SubStatusHistory di LogView.
Tugas penulisan data selesai sesuai harapan terlepas dari apakah operasi penggabungan berhasil.
Jika indeks Bloom filter gagal digabungkan karena alasan sistem, data baru tidak dapat disaring selama tahap perencanaan. Data indeks Bloom filter lokal dari data baru masih dapat mendukung penurunan predikat pada lapisan penyimpanan untuk menyaring data. Anda dapat menggunakan rencana eksekusi untuk menentukan apakah indeks Bloom filter digunakan. Jika indeks Bloom filter tidak digunakan, Anda dapat membangun ulang indeks partisi yang tidak valid selama kueri.
Partisi dinamis tidak mendukung penggabungan otomatis. Anda perlu membangun ulang indeks secara manual pada partisi yang diperbarui setelah data ditulis.
Jika status tugas penggabungan otomatis yang ditunjukkan pada gambar sebelumnya adalah Gagal, Anda perlu secara eksplisit mengeksekusi pernyataan penggabungan berikut. Perhatikan bahwa Anda hanya dapat membangun ulang satu indeks partisi pada satu waktu.
ALTERTABLE <table_name> [PARTITION <partition_spec>] REBUILD BLOOMFILTER INDEX;
Gunakan indeks Bloom filter
Sebelum Anda menanyakan data, jalankan perintah berikut untuk mengaktifkan fitur indeks Bloom filter:
SET odps.sql.enable.bloom.filter.index=true;Setelah fitur indeks Bloom filter diaktifkan, pekerjaan ditambahkan untuk pemangkasan file selama kueri. File yang dipangkas berisi data yang perlu dibaca oleh tugas.
Jika Anda tidak menentukan parameter odps.sql.enable.bloom.filter.index, pemangkasan file tidak dapat dilakukan pada tahap perencanaan. Namun, sistem masih dapat menggunakan penurunan predikat pada lapisan penyimpanan untuk menyaring data berdasarkan data indeks Bloom filter lokal. Selama rilis beta, nilai default parameter odps.sql.enable.bloom.filter.index adalah false. Setelah rilis beta, nilai default mungkin diubah menjadi true berdasarkan situasi penggunaan online.
Dalam beberapa kasus, penyaringan data berdasarkan indeks Bloom filter tidak memiliki efek yang jelas. Misalnya, jika data hasil tersebar di beberapa file hasil, Anda tidak dapat secara efektif menyaring file dengan melakukan pemangkasan file. Dalam hal ini, jika Anda menetapkan parameter ini ke true, tugas pencarian indeks tambahan dijalankan. Ini dapat mengakibatkan penurunan performa tugas. Dalam situasi ini, Anda dapat menetapkan parameter ini ke false.
Kode berikut menunjukkan contoh cara membuat indeks Bloom filter berfungsi.
SET odps.sql.enable.bloom.filter.index=true;
SELECT * FROM bloomfilter_index_test WHERE key=392 AND value="val_392";
Snapshot LogView berikut menunjukkan bahwa job_1 adalah pekerjaan indeks yang menggunakan indeks Bloom filter untuk pemangkasan file.
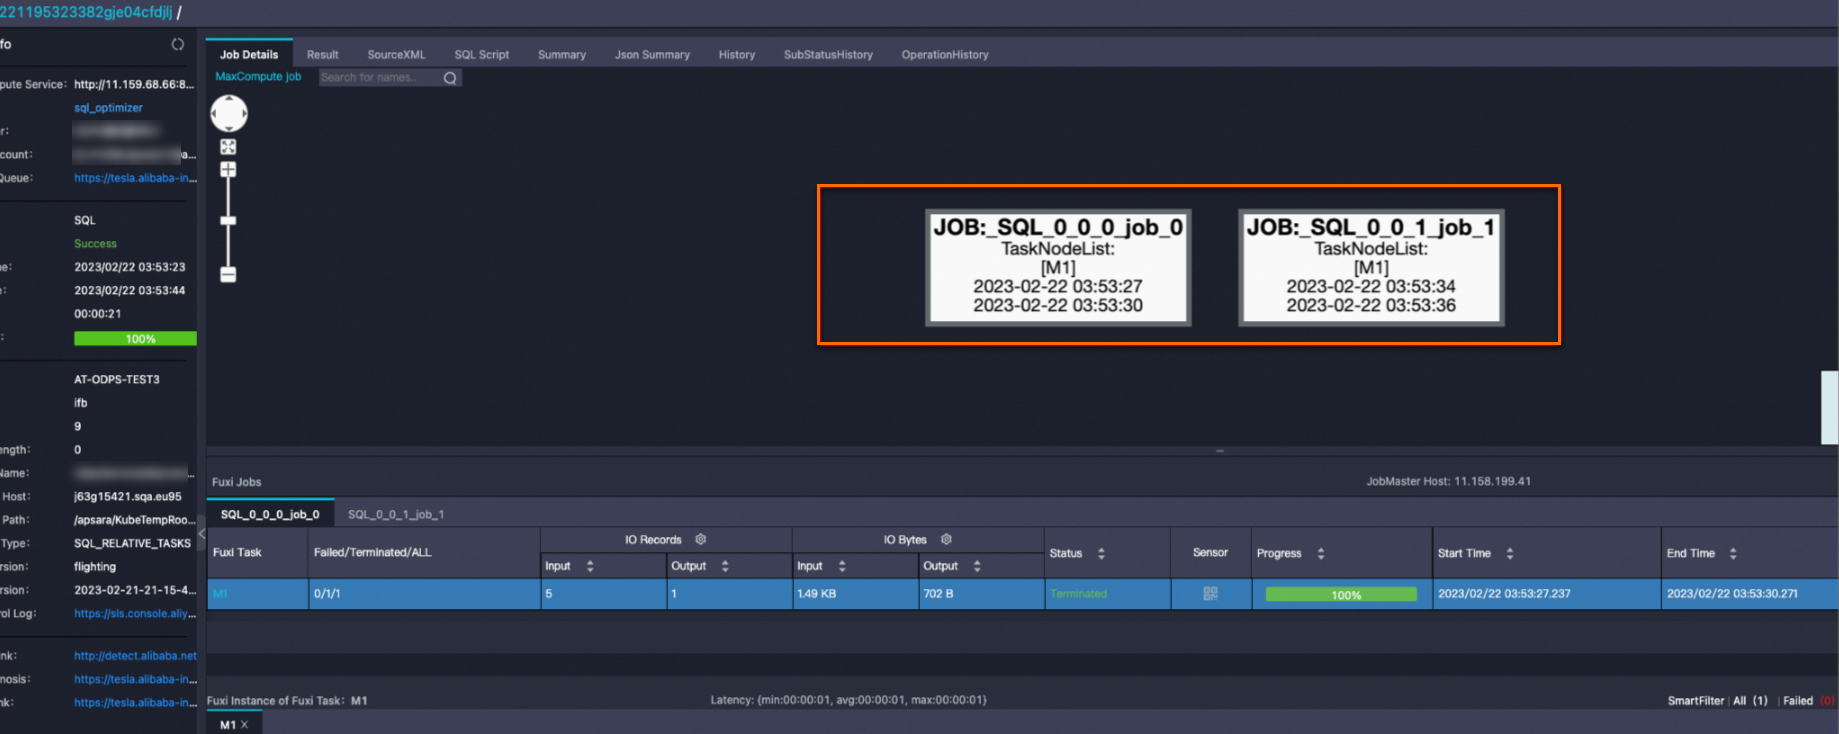
Di tab Ringkasan, tabel yang namanya diakhiri dengan bf adalah tabel virtual yang sesuai dengan file indeks Bloom filter.
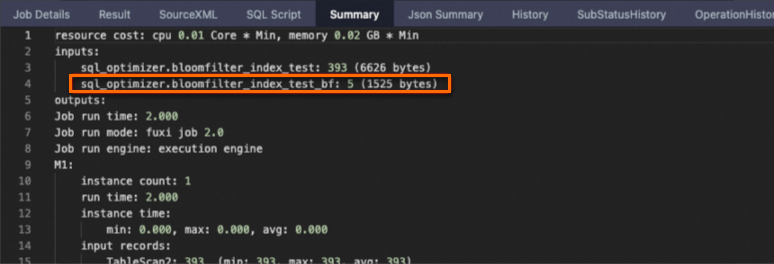
Jika jumlah data besar, ukuran file indeks Bloom filter yang dihasilkan mungkin terlalu besar. Dalam hal ini, MaxCompute memulai pekerjaan terdistribusi untuk pemangkasan file.
Tanyakan indeks Bloom filter tabel
SHOW INDEXES ON <table_name>;Parameter:
table_name: nama tabel tempat indeks berada.
Hapus indeks Bloom filter
DROP INDEX [IF EXISTS] <idx_name> ON TABLE <table_name>;Parameter:
idx_name: nama indeks.
table_name: nama tabel tempat indeks berada.
Modifikasi properti indeks Bloom filter
ALTER INDEX <idx_name> ON <table_name>
SET IDXPROPERTIES(['comment' = 'a'], ['fpp' = '0.01']);
Parameter:
idx_name: nama indeks.
table_name: nama tabel tempat indeks berada.
Contoh
Contoh 1: Buat indeks Bloom filter berdasarkan tabel partisi umum
Siapkan data.
SET odps.namespace.schema=true;
SELECT * FROM bigdata_public_dataset.TPCDS_10G.call_center;
Buat tabel partisi bernama call_center_test.
CREATE TABLE IF NOT EXISTS call_center_test(
    cc_call_center_sk BIGINT NOT NULL, cc_call_center_id CHAR(16) NOT NULL,
    cc_rec_start_date DATE, cc_rec_end_date DATE,
    cc_closed_date_sk BIGINT, cc_open_date_sk BIGINT,
    cc_name VARCHAR(50), cc_class VARCHAR(50),
    cc_employees BIGINT, cc_sq_ft BIGINT,
    cc_hours CHAR(20), cc_manager VARCHAR(40),
    cc_mkt_id BIGINT, cc_mkt_class CHAR(50),
    cc_mkt_desc VARCHAR(100), cc_market_manager VARCHAR(40),
    cc_division BIGINT, cc_division_name VARCHAR(50),
    cc_company BIGINT, cc_company_name CHAR(50),
    cc_street_number CHAR(10), cc_street_name VARCHAR(60),
    cc_street_type CHAR(15), cc_suite_number CHAR(10),
    cc_city VARCHAR(60), cc_county VARCHAR(30),
    cc_state CHAR(2), cc_zip CHAR(10),
    cc_country VARCHAR(20), cc_gmt_offset DECIMAL(5,2),
    cc_tax_percentage DECIMAL(5,2)
)
PARTITIONED BY (ds STRING )
;
Buat indeks.
CREATE BLOOMFILTER INDEX call_center_test_idx01
ON table call_center_test
FOR columns(cc_call_center_sk)
IDXPROPERTIES('fpp' = '0.03', 'numitems'='1000000')
COMMENT 'cc_call_center_sk index';
Impor data.
Impor data dalam tabel
bigdata_public_dataset.TPCDS_10G.call_centerdataset publik ke tabel call_center_test.SET odps.namespace.schema=true; INSERT OVERWRITE TABLE call_center_test PARTITION (ds='20241115') SELECT * FROM bigdata_public_dataset.TPCDS_10G.call_center LIMIT 10000;Jika kata kunci berikut muncul pada tab Json Summary di LogView, indeks Bloom filter berhasil digabungkan.
Tanyakan data.
SET odps.sql.enable.bloom.filter.index=true;
SELECT * FROM call_center_test WHERE cc_call_center_sk =10 AND ds='20241115';
Hasil berikut dikembalikan:
+-------------------+-------------------+-------------------+-----------------+-------------------+-----------------+---------------+------------+--------------+------------+------------+----------------+------------+----------------------------+---------------------------------------------------------------------------------------+-------------------+-------------+------------------+------------+-----------------+------------------+----------------+----------------+-----------------+------------+---------------+------------+------------+---------------+---------------+-------------------+------------+
| cc_call_center_sk | cc_call_center_id | cc_rec_start_date | cc_rec_end_date | cc_closed_date_sk | cc_open_date_sk | cc_name       | cc_class   | cc_employees | cc_sq_ft   | cc_hours   | cc_manager     | cc_mkt_id  | cc_mkt_class               | cc_mkt_desc                                                                           | cc_market_manager | cc_division | cc_division_name | cc_company | cc_company_name | cc_street_number | cc_street_name | cc_street_type | cc_suite_number | cc_city    | cc_county     | cc_state   | cc_zip     | cc_country    | cc_gmt_offset | cc_tax_percentage | ds         |
+-------------------+-------------------+-------------------+-----------------+-------------------+-----------------+---------------+------------+--------------+------------+------------+----------------+------------+--------------+-------------+---------------------------------------------------------------------------------------+-------------------+-------------+------------------+------------+-----------------+------------------+----------------+----------------+-----------------+------------+---------------+------------+------------+---------------+---------------+-------------------+------------+
| 10                | AAAAAAAAKAAAAAAA  | 1998-01-01        | 2000-01-01      | NULL              | 2451050         | Hawaii/Alaska | large      | 187          | 95744      | 8AM-8AM    | Gregory Altman | 2          | Just back responses ought  | As existing eyebrows miss as the matters. Realistic stories may not face almost by a  | James Mcdonald    | 3           | pri              | 3          | pri             | 457              | 1st            | Boulevard      | Suite B         | Midway     | Walker County | AL         | 31904      | United States | -6            | 0.02              | 20241115   |
+-------------------+-------------------+-------------------+-----------------+-------------------+-----------------+---------------+------------+--------------+------------+------------+----------------+------------+----------------------------+---------------------------------------------------------------------------------------+-------------------+-------------+------------------+------------+-----------------+------------------+----------------+----------------+-----------------+------------+---------------+------------+------------+---------------+---------------+-------------------+------------+
Snapshot LogView berikut menunjukkan bahwa indeks Bloom filter telah berfungsi. Tabel yang namanya diakhiri dengan
bfadalah tabel virtual yang sesuai dengan file indeks Bloom filter.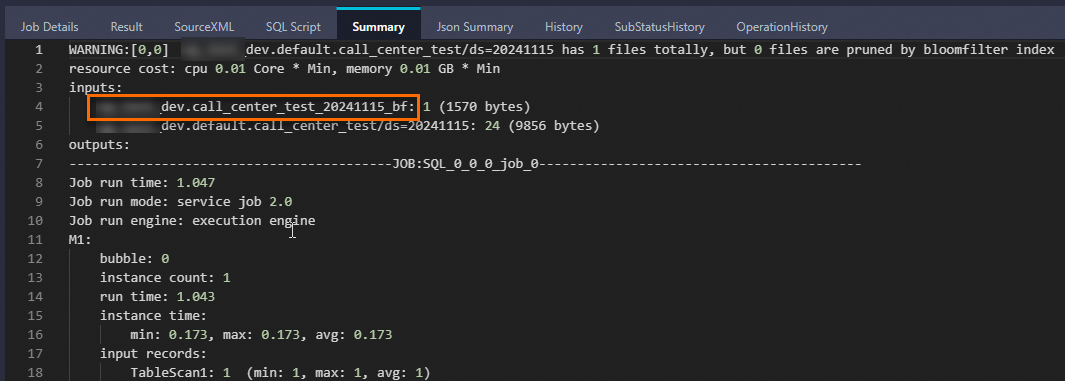
Tanyakan indeks Bloom filter dari tabel.
SHOW INDEXES ON call_center_test;Hasil berikut dikembalikan:
ID = 20241115093930589g9biyii****
{"Indexes": [{
            "id": "aabdaeb10a7b4e99a94716dabad8****",
            "indexColumns": [{"name": "cc_call_center_sk"}],
            "name": "call_center_test_idx01",
            "properties": {
                "comment": "cc_call_center_sk index",
                "fpp": "0.03",
                "numitems": "1000000"},
            "type": "BLOOMFILTER"}]}

OK
Modifikasi properti indeks Bloom filter.
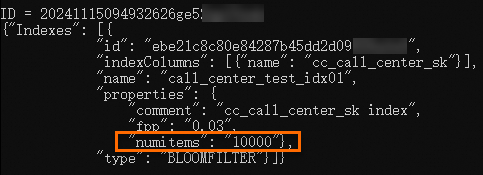
Berdasarkan informasi yang dikembalikan pada langkah sebelumnya, nilai properti asli
numitemsadalah1000000. Jalankan pernyataan berikut untuk mengubah nilai propertinya menjadi10000dan lihat hasil perubahan.-- Ubah nilai properti. ALTER INDEX call_center_test_idx01 ON call_center_test SET IDXPROPERTIES('fpp' = '0.03', 'numitems'='10000'); -- Lihat properti. SHOW INDEXES ON call_center_test;Hasil berikut dikembalikan.
Contoh 2: Buat indeks Bloom filter berdasarkan tabel partisi hash-clustered
Siapkan data.
Buat tabel bernama scope_tmp.
CREATE TABLE if NOT EXISTS scope_tmp(
    phone STRING,
    card STRING,
    machine STRING,
    geohash STRING);
Jalankan perintah Tunnel di klien MaxCompute (odpscmd) untuk mengunggah data ke tabel scope_tmp. Perintah sampel berikut digunakan untuk mengunggah file scope2.csv dalam direktori
bindi klien MaxCompute.Tunnel upload scope2.csv scope_tmp;
Buat tabel partisi bernama scope_hash_pt.
CREATE TABLE scope_hash_pt (
    phone STRING,
    card STRING,
    machine STRING,
    geohash STRING
)
PARTITIONED BY (ds STRING)
clustered by (phone)
sorted by (card)
into 512 buckets;
Buat indeks untuk tabel partisi scope_hash_pt.
CREATE BLOOMFILTER INDEX scope_hash_pt_index01
ON TABLE scope_hash_pt
FOR columns(card)
IDXPROPERTIES('fpp' = '0.03', 'numitems'='1000000')
COMMENT 'card index';
Impor data.
INSERT OVERWRITE TABLE scope_hash_pt PARTITION (ds='20241115') SELECT * FROM scope_tmp;Jika kata kunci berikut muncul pada tab Json Summary di LogView, indeks Bloom filter berhasil digabungkan.
Tanyakan data tabel scope_hash_pt.
SET odps.sql.enable.bloom.filter.index=true;
SELECT * FROM scope_hash_pt WHERE card='073415764266290' and ds='20241115';
Hasil berikut dikembalikan:
+-------------+-----------------+----------------+------------+------------+
| phone       | card            | machine        | geohash    | ds         |
+-------------+-----------------+----------------+------------+------------+
| 1576426**** | 073415764266290 | 51133960245770 | fWbDDsf    | 20241115   |
+-------------+-----------------+----------------+------------+------------+
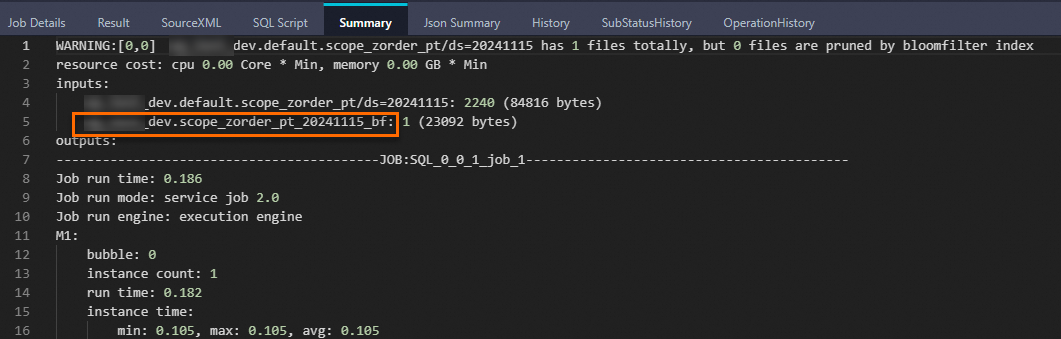
Snapshot LogView berikut menunjukkan bahwa indeks Bloom filter telah berfungsi. Tabel yang namanya diakhiri dengan
bfadalah tabel virtual yang sesuai dengan file indeks Bloom filter.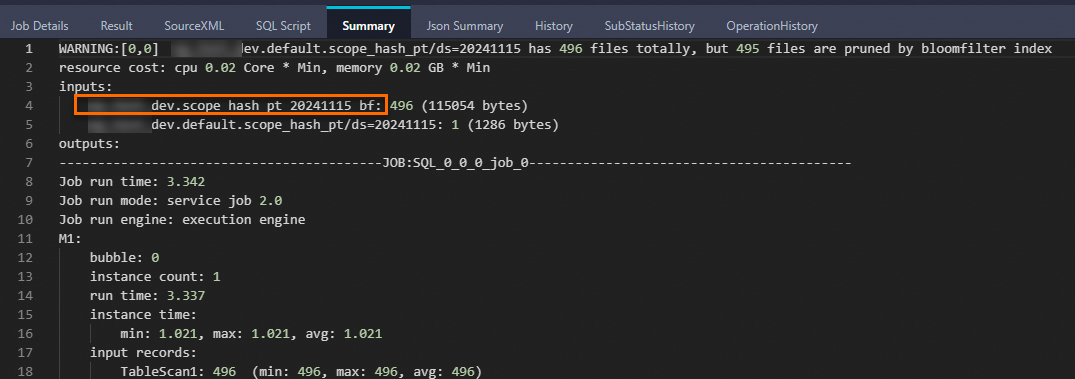
Contoh 3: Buat indeks Bloom filter berdasarkan pengurutan data Zorder dari tabel partisi
Siapkan data. Untuk informasi lebih lanjut, lihat Langkah 1 di Contoh 2: Buat Indeks Bloom Filter Berdasarkan Tabel Partisi Hash-Clustered.
Buat tabel partisi bernama scope_zorder_pt.
CREATE TABLE scope_zorder_pt(
    phone STRING,
    card STRING,
    machine STRING,
    geohash STRING,
    zvalue BIGINT
)
PARTITIONED BY (ds STRING)
;
Buat indeks.
CREATE BLOOMFILTER INDEX scope_zorder_pt_index01
ON TABLE scope_zorder_pt
FOR COLUMNS (card)
IDXPROPERTIES('fpp' = '0.05', 'numitems'='1000000')
COMMENT 'idxcomment';
Impor data.
Unduh paket JAR berikut dan simpan paket tersebut ke
D:\di komputer Anda.Jalankan perintah berikut untuk mengunggah dua paket JAR sebagai sumber daya:
-- Tambahkan sumber daya.
ADD JAR D:\odps-zorder-1.0-SNAPSHOT.jar;
ADD JAR D:\odps-zorder-1.0-SNAPSHOT-jar-with-dependencies.jar;
Eksekusi pernyataan berikut untuk membuat fungsi:
CREATE FUNCTION zorder AS 'com.aliyun.odps.zorder.evaluateZValue2WithSize' USING ' odps-zorder-1.0-SNAPSHOT-jar-with-dependencies.jar';Gunakan fungsi untuk menulis data ke tabel partisi scope_zorder_pt.
-- Setel parameter odps.sql.validate.orderby.limit ke false.
SET odps.sql.validate.orderby.limit=false;

-- Tulis data.
INSERT OVERWRITE TABLE scope_zorder_pt PARTITION (ds='20241115') SELECT *,zorder(HASH(phone), 100000000, HASH(card), 100000000) AS zvalue FROM scope_tmp ORDER BY zvalue;
Jika kata kunci berikut muncul pada tab Json Summary di LogView, indeks Bloom filter berhasil digabungkan.
Tanyakan data.
SET odps.sql.enable.bloom.filter.index=true;
SELECT * FROM scope_zorder_pt WHERE card='073415764266290' AND ds='20241115';
Hasil berikut dikembalikan:
+-------------+-----------------+----------------+------------+---------------------+------------+
| phone       | card            | machine        | geohash    | zvalue              | ds         |
+-------------+-----------------+----------------+------------+---------------------+------------+
| 1576426**** | 073415764266290 | 51133960245770 | fWbDDsf    | 3590549286038929408 | 20241115   |
+-------------+-----------------+----------------+------------+---------------------+------------+
Snapshot LogView berikut menunjukkan bahwa indeks Bloom filter telah berfungsi. Tabel yang namanya diakhiri dengan
bfadalah tabel virtual yang sesuai dengan file indeks Bloom filter.