Hologres terintegrasi dengan CloudMonitor untuk memberikan visibilitas terhadap pemanfaatan sumber daya, status operasional, dan kesehatan instans Anda. Anda dapat memantau metrik utama serta mengonfigurasi aturan peringatan guna mendeteksi anomali dan merespons secara cepat.
Prasyarat
Anda telah membeli instans Hologres.
Rekomendasi
CloudMonitor mendukung metrik berdasarkan tipe instans Hologres, termasuk Hologres follower instance, Hologres acceleration instance, Hologres standard instance, dan Hologres warehouse instance. Setiap tipe memiliki metrik khusus untuk pemantauan dan troubleshooting. Kami merekomendasikan agar Anda memantau berdasarkan tipe instans tertentu. Di halaman Hologres pada Konsol CloudMonitor, gunakan pemilih wilayah di bagian atas dan beralih antar tipe instans melalui bilah tab. Anda dapat mengklik Create Alert Rule atau View Alert Rules untuk mengelola peringatan.
Metrik CloudMonitor
Untuk informasi lebih lanjut mengenai metrik instans Hologres yang didukung oleh CloudMonitor, lihat Metrik di Konsol Hologres.
Definisi metrik dan event sistem
CloudMonitor menerbitkan metadata pemantauan setiap layanan cloud di halaman khusus Metric List. Halaman Metric List Hologres mencantumkan setiap time series metric dan system event yang dilaporkan Hologres ke CloudMonitor. Setiap entri time series metric menampilkan ID Metrik, deskripsi, satuan, dimensi, dan periode statistik minimum (Min Periods). Setiap entri system event menampilkan nama, deskripsi, status, dan tingkat keparahan.
Namespace Hologres di CloudMonitor adalah acs_hologres. Setiap tipe instans melaporkan kumpulan metriknya sendiri, sehingga Anda dapat menjelajahi metrik berdasarkan tipe instans.
|
Tipe instans |
Halaman Daftar Metrik |
|
Semua tipe instans (namespace |
|
|
Instans tujuan umum |
|
|
Instans gudang virtual |
|
|
Instans Shared Cluster (Lakehouse Acceleration Edition) |
|
|
Follower instance |
-
Untuk membuka halaman Metric List, login dengan Akun Alibaba Cloud. Pengguna RAM juga harus memiliki izin baca pada CloudMonitor. Untuk informasi lebih lanjut, lihat Berikan izin kepada pengguna RAM.
-
Halaman Metric List mencerminkan metrik dan event yang saat ini diterima CloudMonitor. Jika halaman tersebut berbeda dari topik ini atau dari Metrik di Konsol Hologres, ikuti halaman Metric List.
-
Saat Anda melakukan kueri data pemantauan melalui API CloudMonitor, namespace, nama metrik, dimensi, dan periode semuanya berasal dari halaman ini. Untuk informasi lebih lanjut, lihat Akses metrik menggunakan API.
Lihat metrik
Lihat metrik di Konsol CloudMonitor.
-
Login ke Konsol CloudMonitor.
-
Di panel navigasi sebelah kiri, klik Cloud Service Monitoring.
-
Di bagian Big Data, klik tipe instans target, seperti Hologres follower instance, Hologres acceleration instance, Hologres standard instance, atau Hologres warehouse instance, untuk membuka dasbor pemantauan Hologres.
-
Klik ikon
 di samping wilayah dan pilih wilayah Anda.
-
Klik Instance ID atau klik Monitoring Chart di kolom Actions untuk melihat metrik instans.
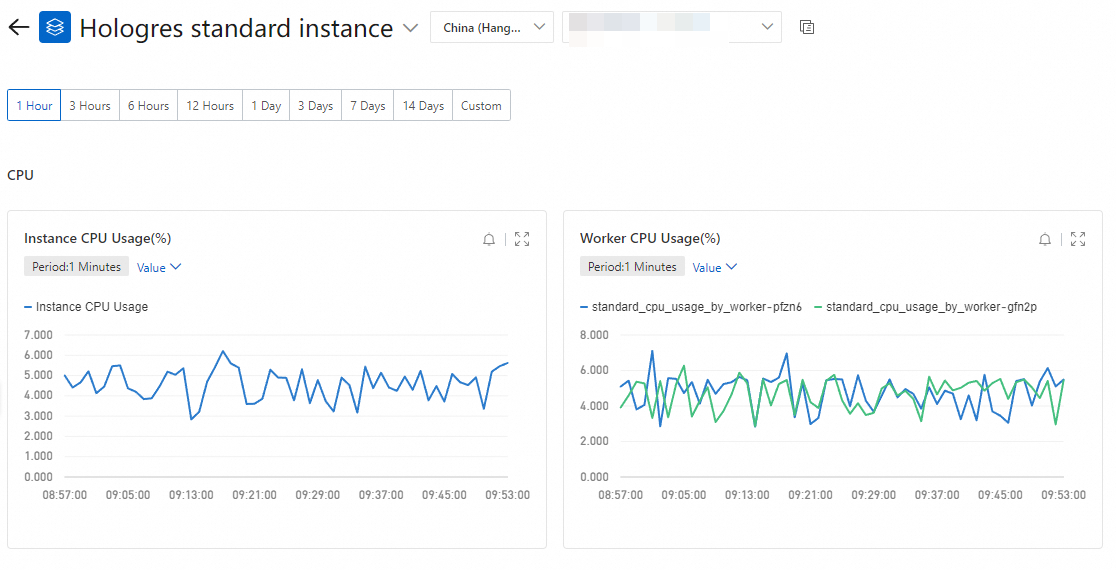 Catatan
Anda dapat menentukan rentang waktu untuk melihat metrik instans. Data pemantauan disimpan hingga 30 hari.
Praktik pemantauan dan peringatan
Peringatan inisiatif
Anda dapat mengaktifkan initiative alert di CloudMonitor untuk menerapkan aturan peringatan default ke semua instans Anda. Setelah fitur ini diaktifkan, aturan peringatan dibuat untuk metrik seperti penggunaan CPU, penggunaan disk, penggunaan memori, dan jumlah koneksi. Aturan ini berlaku untuk semua instans Hologres di bawah Akun Alibaba Cloud Anda (akun utama). Aturan peringatan default adalah:
-
Jika rata-rata penggunaan koneksi (Info) lebih besar dari atau sama dengan 95% selama tiga siklus berturut-turut, CloudMonitor mengirim notifikasi ke alert contact group.
-
Jika rata-rata penggunaan penyimpanan (Warn) lebih besar dari 90% selama tiga siklus berturut-turut, CloudMonitor mengirim notifikasi ke alert contact group.
-
Jika rata-rata penggunaan memori (Warn) lebih besar dari atau sama dengan 90% selama tiga siklus berturut-turut, CloudMonitor mengirim notifikasi ke alert contact group.
-
Jika rata-rata penggunaan CPU (Info) lebih besar dari atau sama dengan 99% selama tiga siklus berturut-turut, CloudMonitor mengirim notifikasi ke alert contact group.
Secara default, siklus peringatan adalah 5 menit. Anda dapat menyesuaikan pengaturan ini.
Buat aturan peringatan
Selain aturan peringatan inisiatif default, Anda dapat membuat aturan peringatan kustom untuk metrik lainnya. Untuk membuat aturan peringatan:
-
Login ke Konsol CloudMonitor.
-
Di panel navigasi sebelah kiri, pilih .
-
Di halaman Alert Rule, klik Create Alert Rules dan konfigurasikan informasi peringatan sesuai petunjuk. Untuk informasi lebih lanjut, lihat Buat aturan peringatan.
Praktik terbaik pengaturan peringatan
Penggunaan CPU instans (%)
Menunjukkan apakah sumber daya Hologres Anda mengalami bottleneck atau telah dimanfaatkan sepenuhnya. Aturan peringatan yang direkomendasikan:
-
Aturan peringatan:
-
Critical: Picu peringatan jika penggunaan CPU instans mencapai 99% atau lebih selama 60 periode 1 menit berturut-turut. Jika penggunaan tetap tinggi secara konsisten, lakukan scale out.
-
Warn: Picu peringatan jika penggunaan CPU instans mencapai 99% atau lebih selama 10 periode 1 menit berturut-turut. Periksa apakah penggunaan CPU tinggi disebabkan oleh perubahan bisnis.
-
-
Jangan picu peringatan hanya karena satu kali terjadi penggunaan CPU 100%. Lonjakan singkat tidak selalu menandakan overload — hal ini bisa merepresentasikan pemanfaatan sumber daya yang efisien.
-
Jangan atur ambang batas peringatan CPU terlalu rendah. Komponen sistem dapat mengonsumsi sumber daya meskipun tidak ada tugas yang sedang berjalan.
Penggunaan CPU worker (%)
Menunjukkan apakah terdapat bottleneck sumber daya pada node pekerja mana pun dan seberapa penuh sumber daya tersebut digunakan. Aturan peringatan yang direkomendasikan:
-
Aturan peringatan:
-
Critical: Picu peringatan jika penggunaan CPU node pekerja mencapai 99% atau lebih selama 60 periode 1 menit berturut-turut. Jika penggunaan tetap tinggi secara konsisten, lakukan scale out.
-
Warn: Picu peringatan jika penggunaan CPU node pekerja mencapai 99% atau lebih selama 10 periode 1 menit berturut-turut. Periksa apakah penggunaan CPU tinggi disebabkan oleh perubahan bisnis.
-
-
Jangan picu peringatan hanya karena satu kali terjadi penggunaan CPU 100% pada node pekerja. Lonjakan singkat tidak selalu menandakan overload — hal ini bisa merepresentasikan pemanfaatan sumber daya yang efisien.
-
Jangan atur ambang batas peringatan CPU terlalu rendah. Komponen sistem dapat mengonsumsi sumber daya meskipun tidak ada tugas yang sedang berjalan.
Penggunaan memori instans (%)
Mencerminkan penggunaan memori keseluruhan instans. Aturan peringatan yang direkomendasikan:
-
Aturan peringatan:
-
Critical: Picu peringatan jika penggunaan memori instans mencapai 99% atau lebih selama 60 periode 1 menit berturut-turut. Jika penggunaan tetap tinggi secara konsisten, lakukan scale out.
-
Warn: Picu peringatan jika penggunaan memori instans mencapai 99% atau lebih selama 10 periode 1 menit berturut-turut. Periksa apakah penggunaan memori tinggi disebabkan oleh perubahan bisnis.
-
-
Jangan atur ambang batas peringatan memori terlalu rendah. Memori digunakan untuk kueri, metadata, dan cache, sehingga sebagian memori dikonsumsi meskipun instans dalam keadaan idle.
Penggunaan memori worker (%)
Mencerminkan penggunaan memori pada masing-masing node pekerja. Aturan peringatan yang direkomendasikan:
-
Aturan peringatan:
-
Critical: Picu peringatan jika penggunaan memori node pekerja mencapai 99% atau lebih selama 60 periode 1 menit berturut-turut. Jika penggunaan tetap tinggi secara konsisten, lakukan scale out.
-
Warn: Picu peringatan jika penggunaan memori node pekerja mencapai 99% atau lebih selama 10 periode 1 menit berturut-turut. Periksa apakah penggunaan memori tinggi disebabkan oleh perubahan bisnis.
-
-
Jangan atur ambang batas peringatan memori terlalu rendah. Memori digunakan untuk kueri, metadata, dan cache, sehingga sebagian memori dikonsumsi meskipun instans dalam keadaan idle.
Penggunaan koneksi FE maksimum (%)
Warn: Picu peringatan jika penggunaan koneksi FE maksimum mencapai 95% atau lebih selama 5 periode 1 menit berturut-turut. Hal ini membantu Anda memantau penggunaan koneksi dan segera membersihkan koneksi idle.
Penggunaan maksimum FE binlog WAL sender (%)
Mencerminkan penggunaan WAL sender maksimum di seluruh FE. Aturan peringatan yang direkomendasikan:
Warn: Picu peringatan jika penggunaan maksimum FE WAL sender mencapai 95% atau lebih selama 5 periode 1 menit berturut-turut.
Waktu kueri aktif terlama (milidetik)
Memantau kueri berdurasi panjang pada instans Anda. Aturan peringatan yang direkomendasikan:
Warn: Picu peringatan jika waktu kueri aktif terlama mencapai 3.600.000 milidetik atau lebih selama 10 periode 1 menit berturut-turut.
Waktu kueri komputasi tanpa server aktif terlama (milidetik)
Memantau tugas komputasi tanpa server. Jika suatu tugas berjalan terlalu lama, Anda dapat menghentikannya. Aturan peringatan yang direkomendasikan:
Warn: Picu peringatan jika waktu kueri aktif terlama dalam komputasi tanpa server mencapai 3.600.000 milidetik atau lebih selama 10 periode 1 menit berturut-turut.
QPS kueri gagal (count/s)
Menunjukkan jumlah kueri gagal pada instans. Aturan peringatan yang direkomendasikan:
Warn: Picu peringatan jika QPS Kueri Gagal mencapai 10 count/s atau lebih selama 10 periode 1 menit berturut-turut. Jika banyak kueri gagal, periksa detail kegagalan di log kueri lambat dan lakukan optimasi sesuai kebutuhan.
Waktu replay FE (milidetik)
Menunjukkan waktu replay untuk setiap FE. Waktu replay yang berlebihan mengindikasikan FE yang lambat atau hang, yang dapat menyebabkan kueri macet. Aturan peringatan yang direkomendasikan:
-
Aturan peringatan:
Warn: Picu peringatan jika Waktu Replay FE Berjalan mencapai 300.000 milidetik atau lebih selama 10 periode 1 menit berturut-turut. Periksa halaman Active Queries di Konsol HoloWeb untuk kueri berdurasi panjang dan coba hentikan kueri tersebut.
-
Jangan atur ambang batas waktu replay FE terlalu rendah. Replay FE terjadi setiap kali metadata instans dimodifikasi, dan waktu replay beberapa detik merupakan hal yang normal.
Keterlambatan sinkronisasi instans (milidetik)
Hanya ditampilkan untuk follower instance. Menunjukkan latensi sinkronisasi data antara instans primary dan follower. Aturan peringatan yang direkomendasikan:
Warn: Picu peringatan jika keterlambatan sinkronisasi instans mencapai 600.000 milidetik atau lebih selama 10 periode 1 menit berturut-turut.
Tabel dengan statistik hilang per DB (count/s)
Mencerminkan kualitas fitur auto-analyze. Jika suatu tabel tidak memiliki statistik dalam periode yang lama, jalankan perintah ANALYZE secara manual pada tabel tersebut. Untuk informasi lebih lanjut, lihat ANALYZE dan AUTO ANALYZE. Aturan peringatan yang direkomendasikan:
-
Aturan peringatan:
Warn: Picu peringatan jika jumlah tabel yang tidak memiliki statistik di setiap database mencapai 10 atau lebih selama 60 periode 1 menit berturut-turut.
-
Jangan atur ambang batas peringatan terlalu rendah. Jika suatu instans memiliki banyak tabel, proses auto-analyze mungkin berjalan lambat.
Berlangganan event sistem
Selain metrik deret waktu, Hologres melaporkan operasi O&M tertentu ke CloudMonitor sebagai system events. Berlangganan event ini untuk menerima notifikasi melalui SMS atau email dan tetap mengetahui operasi O&M yang berjalan pada instans Anda. Event sistem berikut tersedia:
|
Fitur |
Event sistem |
|
Elastisitas berbasis waktu untuk kelompok komputasi |
Konfigurasi elastisitas berbasis waktu dimulai untuk kelompok komputasi, Konfigurasi elastisitas berbasis waktu selesai untuk kelompok komputasi, Skalabilitas elastis terjadwal untuk kelompok komputasi gagal |
|
Event O&M |
Event terjadwal dibuat, Eksekusi event terjadwal dimulai, Eksekusi event terjadwal berhasil, Eksekusi event terjadwal gagal, Event terjadwal dibatalkan, Waktu eksekusi event terjadwal diubah |
-
Lihat event: Login ke Konsol CloudMonitor. Di panel navigasi sebelah kiri, pilih . Di tab Event Monitoring, filter event berdasarkan produk, tingkat keparahan, nama event, dan rentang waktu, lalu atur Product menjadi Hologres. Untuk informasi lebih lanjut, lihat Lihat event sistem.
-
Berlangganan event: Di halaman System Events, klik Create Now. Atur Subscription Type menjadi System Event dan Product menjadi Hologres. Untuk prosedur lengkap, lihat Siapkan peringatan event.
-
Untuk definisi lengkap setiap event sistem, termasuk nama, deskripsi, status, dan tingkat keparahan, lihat halaman Metric List Hologres.
-
Fitur aturan peringatan event sistem lama tidak lagi diperbarui dan akan dihentikan secara bertahap. Gunakan langganan event sebagai gantinya.
Penyelesaian masalah pemantauan umum
Jika suatu metrik berfluktuasi secara tidak terduga atau peringatan dipicu, lihat FAQ tentang metrik pemantauan untuk panduan troubleshooting.
Akses metrik menggunakan API
CloudMonitor juga menyediakan dasbor kustom dan API untuk akses metrik yang lebih fleksibel.
-
Untuk mengakses CloudMonitor menggunakan API, lihat Cloud Service Monitoring.
-
Untuk menggunakan dasbor pemantauan kustom, lihat Kelola dasbor kustom.
-
Untuk mengakses pemantauan Hologres menggunakan Application Real-Time Monitoring Service (ARMS), lihat Panduan integrasi.
Sebelum memanggil API, buka halaman Metric List Hologres untuk mencari nilai yang Anda butuhkan. Atur namespace menjadi acs_hologres, ambil nama metrik dari kolom Metric ID, periode dari kolom Min Periods, dan dimensi dari kolom Dimensions. Anda tidak perlu menyediakan userId. CloudMonitor secara otomatis mengisi ID akun saat ini. Untuk detail cara nilai-nilai ini dibentuk, lihat Lampiran 1: Metrik untuk produk Alibaba Cloud.
Berikan izin kepada pengguna RAM
Secara default, pengguna RAM tidak dapat melihat metrik di CloudMonitor. Anda harus memberikan izin yang diperlukan.
Login ke Resource Access Management (RAM) console dengan Akun Alibaba Cloud Anda (akun utama) dan berikan salah satu kebijakan berikut kepada pengguna RAM. Untuk informasi lebih lanjut, lihat Berikan izin kepada pengguna RAM.
Anda juga dapat memilih kebijakan berdasarkan kebutuhan bisnis Anda.
|
Nama kebijakan |
Deskripsi |
|
AliyunCloudMonitorFullAccess |
Izin untuk mengelola CloudMonitor secara penuh. |
|
AliyunCloudMonitorReadOnlyAccess |
Izin baca saja pada CloudMonitor. |
|
AliyunCloudMonitorMetricDataReadOnlyAccess |
Izin untuk membaca data metrik deret waktu di CloudMonitor. |