Lake-stream integration adalah arsitektur data baru yang menggabungkan data lake dengan aliran real-time.
Lake-stream integration
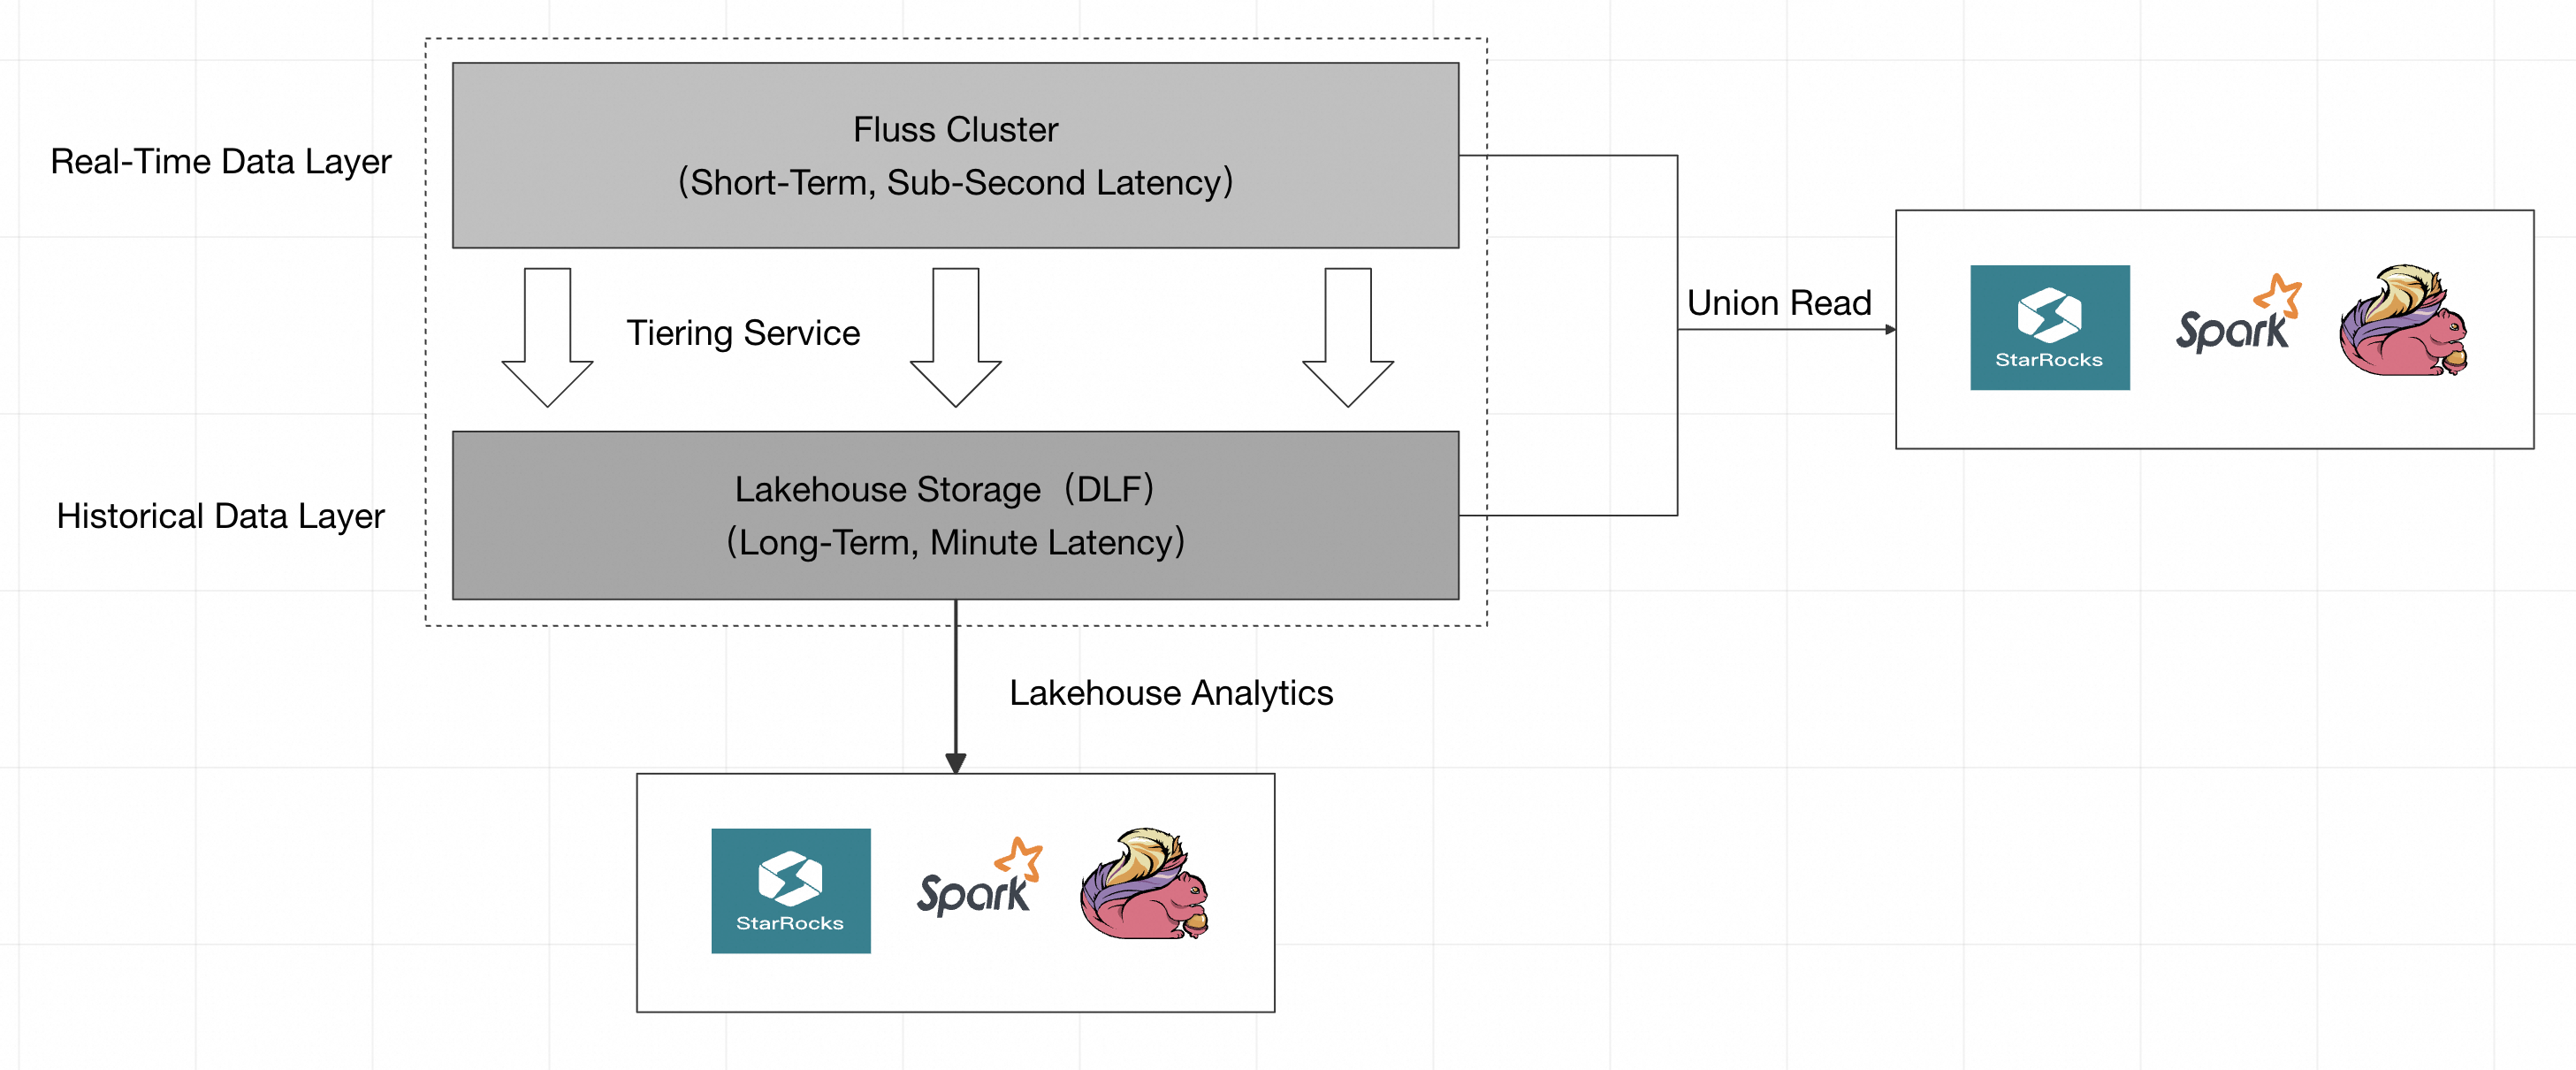
Permasalahan pada lakehouse dan pemrosesan aliran tradisional
-
Silo penyimpanan: Satu lapisan penyimpanan tidak dapat memenuhi kebutuhan kinerja real-time sekaligus biaya rendah.
-
Arsitektur kompleks: Arsitektur Lambda mengharuskan pengembang memelihara dua sistem yang sepenuhnya terpisah.
-
Redundansi penyimpanan: Data disimpan secara redundan di berbagai sistem, yang menghabiskan sumber daya penyimpanan maupun komputasi.
-
Kueri terfragmentasi: Tanpa tampilan data terpadu, berbagai mesin komputasi dan logika pemrosesan dapat dengan mudah menghasilkan semantik data yang ambigu.
Konsep inti dan nilai lake-stream integration
Lake-stream integration adalah arsitektur data baru yang menggabungkan data lake dengan aliran real-time. Arsitektur ini bertujuan menghilangkan batas antara pemrosesan batch dan aliran tradisional, memungkinkan pemrosesan data real-time dan batch secara terpadu dengan satu sumber untuk penyimpanan, metadata, dan akses. Pendekatan ini sering digunakan untuk mengatasi masalah ketepatan waktu data di data lake, seperti mengurangi latensi dari menit menjadi milidetik, serta menyediakan kemampuan Online Analytical Processing (OLAP) untuk aliran data.
Arsitektur ini mengintegrasikan secara mendalam penyimpanan aliran real-time (Fluss) dengan data lake berbasis Paimon, dengan metadata dikelola oleh DLF. Integrasi ini menciptakan 'satu copy data, dua tampilan'. Satu tabel logis menyediakan akses berlatensi rendah ke data real-time sekaligus analitik throughput tinggi untuk data historis.
Prinsip inti
-
Sinkronisasi otomatis: Saat fitur ini diaktifkan pada kluster Fluss, sistem secara otomatis membuat Pekerjaan sinkronisasi Flink yang terus-menerus menulis aliran event real-time dari Fluss ke tabel Paimon.
-
Union read: Saat kueri dijalankan pada tabel, mesin kueri Flink secara otomatis menggabungkan data real-time dari Fluss dengan data historis dari Paimon, lalu menghapus duplikat data berdasarkan primary key dan menampilkan satu tabel yang konsisten serta mutakhir.
-
Metadata terpadu: DLF berperan sebagai layanan metadata terpadu yang mengelola informasi tabel Paimon, seperti skema tabel, partisi, dan izin, sehingga memastikan data dapat diakses secara mulus oleh berbagai mesin komputasi, seperti Flink, Spark, dan Presto.
-
Berbagi data: Fluss dan Paimon bekerja sama menciptakan arsitektur penyimpanan stream-batch terintegrasi. Fluss berfungsi sebagai lapisan data real-time yang menyediakan penulisan dan akses data hot dengan latensi milidetik, sedangkan Paimon berfungsi sebagai lapisan data historis yang menangani penyimpanan jangka panjang hemat biaya. Data dibagikan antara kedua lapisan untuk mencegah penyimpanan redundan.
Kemampuan utama
-
Mengurangi kompleksitas arsitektur: Menghilangkan jalur pengembangan ganda, penyimpanan duplikat, serta biaya Operasi dan Pemeliharaan (O&M) yang berlipat dari sistem aliran dan batch terpisah tradisional.
-
Menjamin konsistensi data: Memastikan hasil yang konsisten untuk analitik real-time maupun batch menggunakan model data dan mesin komputasi yang terpadu.
-
Menyederhanakan O&M: Menyediakan Dasbor pemantauan end-to-end yang menampilkan metrik seperti latensi sinkronisasi, status Pekerjaan, dan skor kesehatan, serta mengintegrasikan fungsi O&M seperti start/stop satu klik dan pengaturan alert.
-
Meningkatkan kelincahan: Pengembang dapat fokus pada logika bisnis tanpa perlu khawatir tentang lokasi fisik data dasar, sehingga memungkinkan mereka dengan cepat membangun aplikasi untuk skenario seperti gudang data real-time, laporan real-time, dan rekayasa fitur AI.